Быстрый старт с dbt Semantic Layer
Введение
Semantic Layer, работающий на базе MetricFlow, упрощает настройку ключевых бизнес-метрик. Он централизует определения, исключает дублирование кода и обеспечивает удобный доступ к метрикам в инструментах, использующих эти данные. MetricFlow упрощает управление метриками компании, позволяя определять метрики в проекте dbt и запрашивать их в dbt с помощью команд MetricFlow.
📹 Узнайте о семантическом слое dbt с помощью видеокурсов по запросу!
Изучите наш курс по семантическому слою dbt, чтобы узнать, как определять и запрашивать метрики в вашем проекте dbt.
Кроме того, погрузитесь в мини-курсы по запросам к семантическому слою dbt в ваших любимых инструментах: Tableau, Excel, Hex и Mode.
Инструменты ИИ, такие как Claude и ChatGPT, могут подключаться к Semantic Layer через сервер dbt MCP, чтобы использовать в ответах ваши централизованно управляемые метрики, а не строить догадки на основе необработанных таблиц.
Это краткое руководство предназначено для пользователей dbt на платформе dbt platform. Вы создадите и определите метрики, настроите Semantic Layer в проекте dbt и выполните запросы к этим метрикам в Google Sheets.
Руководство подходит для любой поддерживаемой платформы данных. Используйте вкладки в разделе Настройка хранилища, чтобы создать учетную запись, загрузить демонстрационные данные и подключить dbt. На последующих шагах предусмотрены отдельные вкладки для случаев, когда SQL или YAML отличается для вашей платформы.
Предварительные требования
-
Для всех развертываний необходима учетная запись dbt с тарифным планом Trial, Starter или Enterprise.
-
У вас должны быть соответствующие лицензия dbt и разрешения в зависимости от вашего тарифного плана:
Подробнее о лицензии и разрешениях -
Учетная запись в хранилище данных и образец данных Jaffle Shop. Следуйте инструкциям на вкладке вашей платформы в разделе Настройка хранилища данных.
-
Базовое понимание SQL и dbt. Например, вы уже использовали dbt или прошли курс dbt Fundamentals.
Настройка хранилища
Откройте вкладку вашей платформы данных, чтобы создать учетную запись, загрузить образцы данных и подключить dbt. Выполните только шаги, перечисленные на вкладке, а затем вернитесь сюда. Не переходите к настройке проекта или созданию моделей в другом руководстве. Эти шаги описаны далее в этом руководстве.
Semantic Layer в настоящее время поддерживает Snowflake, BigQuery, Databricks, Redshift, Postgres и Trino (включая Starburst Galaxy). Microsoft Fabric не поддерживается. Полный список приведен в разделе Какие платформы данных поддерживаются.
- Snowflake
- BigQuery
- Databricks
- Redshift
- Starburst Galaxy
Создайте пробный аккаунт Snowflake:
- Выберите редакцию Enterprise Snowflake с правами доступа ACCOUNTADMIN. При выборе облачного провайдера учитывайте потребности вашей организации и ознакомьтесь с разделом Введение в облачные платформы в документации Snowflake.
- Выберите облачного провайдера и регион. Подойдут любые облачные провайдеры и регионы, поэтому выбирайте те, которые вам удобнее.
Вы также можете сначала пройти руководство по быстрому старту с dbt и Snowflake, если предпочитаете более подробное пошаговое руководство, посвящённое только Snowflake.
Создание SQL-файла Snowflake
- Войдите в свою пробную учетную запись Snowflake.
- В интерфейсе Snowflake нажмите значок создания + в левом верхнем углу (под логотипом Snowflake), чтобы открыть раскрывающееся меню.
- Выберите первый пункт — SQL File.
Настройка и загрузка данных в Snowflake
Данные хранятся в CSV-файлах в публичном бакете S3. Подготовьте аккаунт Snowflake и загрузите данные по инструкции ниже.
-
Создайте виртуальное хранилище, две базы данных (для сырых данных и для разработки в dbt) и две схемы (для данных
jaffle_shopиstripe).Введите следующие SQL-команды в редакторе нового SQL-файла Snowflake и нажмите Run:
create warehouse transforming;
create database raw;
create database analytics;
create schema raw.jaffle_shop;
create schema raw.stripe; -
В базе данных
rawи схемахjaffle_shopиstripeсоздайте три таблицы и загрузите в них данные:-
Очистите редактор SQL-файла Snowflake и выполните команду создания таблицы
customers:create table raw.jaffle_shop.customers
( id integer,
first_name varchar,
last_name varchar
); -
Очистите редактор и выполните команду загрузки данных в таблицу
customers:copy into raw.jaffle_shop.customers (id, first_name, last_name)
from 's3://dbt-tutorial-public/jaffle_shop_customers.csv'
file_format = (
type = 'CSV'
field_delimiter = ','
skip_header = 1
); -
Очистите редактор и выполните команду создания таблицы
orders:create table raw.jaffle_shop.orders
( id integer,
user_id integer,
order_date date,
status varchar,
_etl_loaded_at timestamp default current_timestamp
); -
Очистите редактор и выполните команду загрузки данных в таблицу
orders:copy into raw.jaffle_shop.orders (id, user_id, order_date, status)
from 's3://dbt-tutorial-public/jaffle_shop_orders.csv'
file_format = (
type = 'CSV'
field_delimiter = ','
skip_header = 1
); -
Очистите редактор и выполните команду создания таблицы
payment:create table raw.stripe.payment
( id integer,
orderid integer,
paymentmethod varchar,
status varchar,
amount integer,
created date,
_batched_at timestamp default current_timestamp
); -
Очистите редактор и выполните команду загрузки данных в таблицу
payment:copy into raw.stripe.payment (id, orderid, paymentmethod, status, amount, created)
from 's3://dbt-tutorial-public/stripe_payments.csv'
file_format = (
type = 'CSV'
field_delimiter = ','
skip_header = 1
);
-
-
Убедитесь, что данные загружены. Выполните следующие запросы и проверьте, что каждый возвращает строки:
select * from raw.jaffle_shop.customers;
select * from raw.jaffle_shop.orders;
select * from raw.stripe.payment;
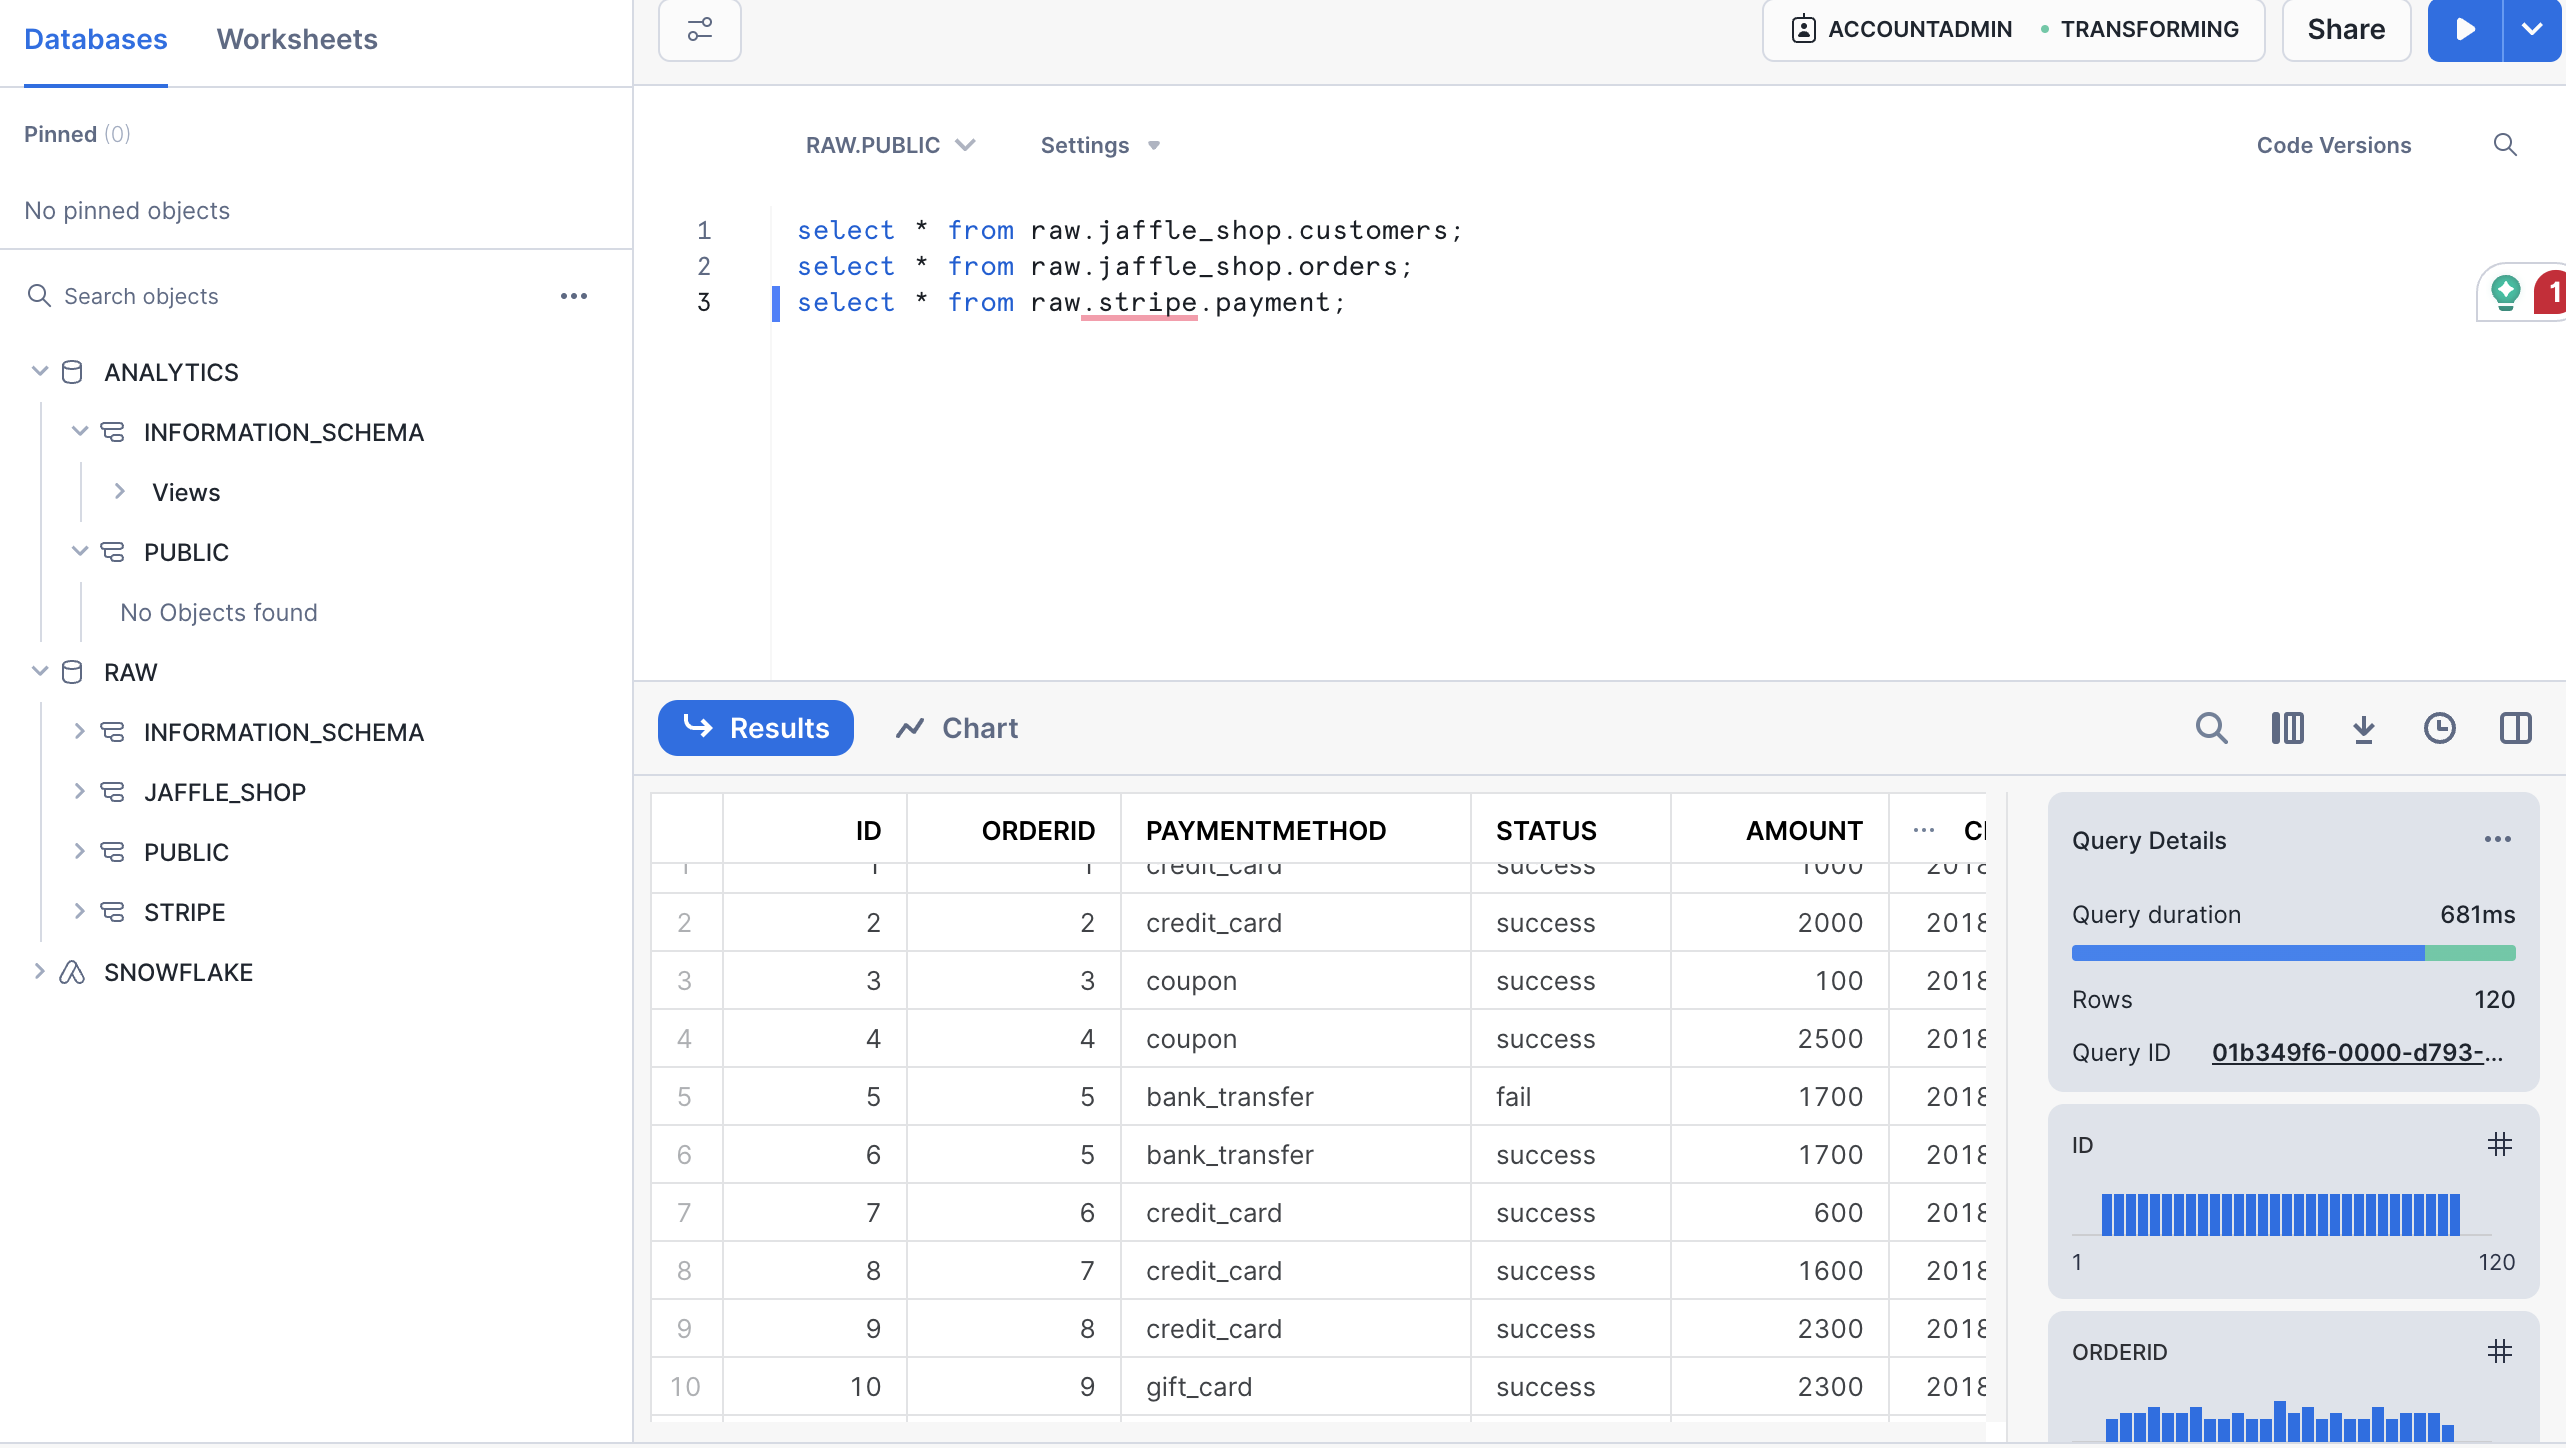 На изображении показано подтверждение Snowflake об успешной загрузке данных в редакторе.
Подключение dbt к Snowflake
Есть два способа подключить dbt к Snowflake. Первый — Partner Connect, который упрощает настройку и позволяет создать учетную запись dbt непосредственно из вашей новой пробной учетной записи Snowflake. Второй — создать учетную запись dbt отдельно и самостоятельно настроить подключение к Snowflake (подключиться вручную). Если вы хотите быстро приступить к работе, dbt Labs рекомендует использовать Partner Connect. Если вы хотите с самого начала настроить всё под свои требования и ознакомиться с процессом настройки dbt, dbt Labs рекомендует подключиться вручную.
- Использовать Partner Connect
- Подключить вручную
С помощью Partner Connect вы можете создать полноценный аккаунт dbt с подключением к Snowflake, управляемым репозиторием, окружениями и учетными данными.
-
На левой боковой панели интерфейса Snowflake перейдите в Admin > Partner Connect. Найдите плитку dbt в разделе Data Integration или воспользуйтесь строкой поиска, чтобы найти dbt. Нажмите на плитку, чтобы подключиться к dbt.
 Окно Snowflake Partner Connect
Если вы используете классическую версию интерфейса Snowflake, вы можете нажать кнопку Partner Connect в верхней панели аккаунта. Затем нажмите плитку dbt, чтобы открыть окно подключения.
 Классический интерфейс Snowflake — Partner Connect
-
Во всплывающем окне Connect to dbt найдите опцию Optional Grant и выберите базы данных RAW и ANALYTICS. Это предоставит доступ новой роли пользователя dbt к каждой выбранной базе данных. Затем нажмите Connect.
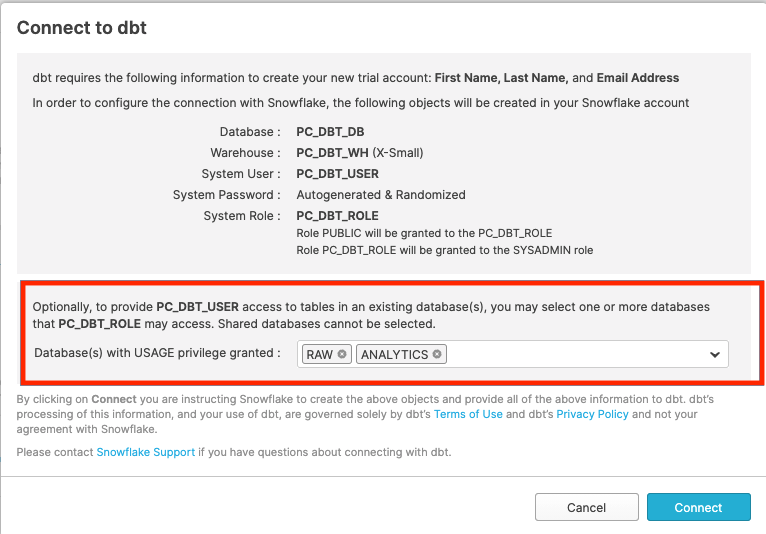 Классический интерфейс Snowflake — окно подключения
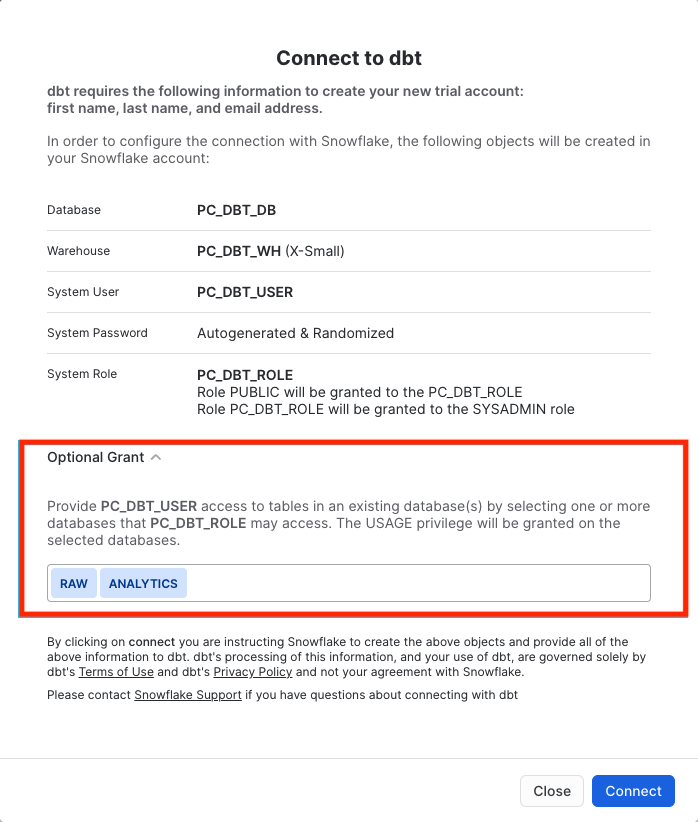 Новый интерфейс Snowflake — окно подключения
- Нажмите Activate, когда появится всплывающее окно:
 Классический интерфейс Snowflake — окно активации
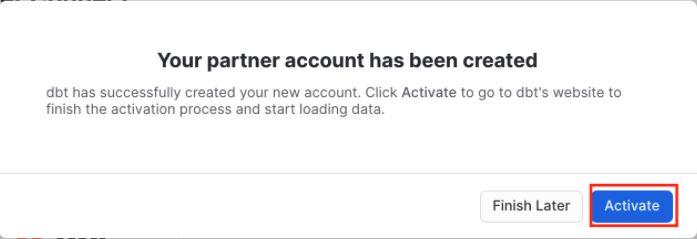 Новый интерфейс Snowflake — окно активации
-
После загрузки новой вкладки вы увидите форму. Если вы уже создали учетную запись dbt, вам будет предложено указать имя учетной записи. Если вы еще не создали учетную запись, вам будет предложено указать имя учетной записи и пароль.
-
После того как вы заполните форму и нажмете Complete Registration, вы автоматически войдете в dbt.
-
Нажмите на имя аккаунта в левом меню и выберите Account settings, выберите проект "Partner Connect Trial" и в таблице overview выберите snowflake. Нажмите Edit и обновите поле Database на
analytics, а поле Warehouse наtransforming.
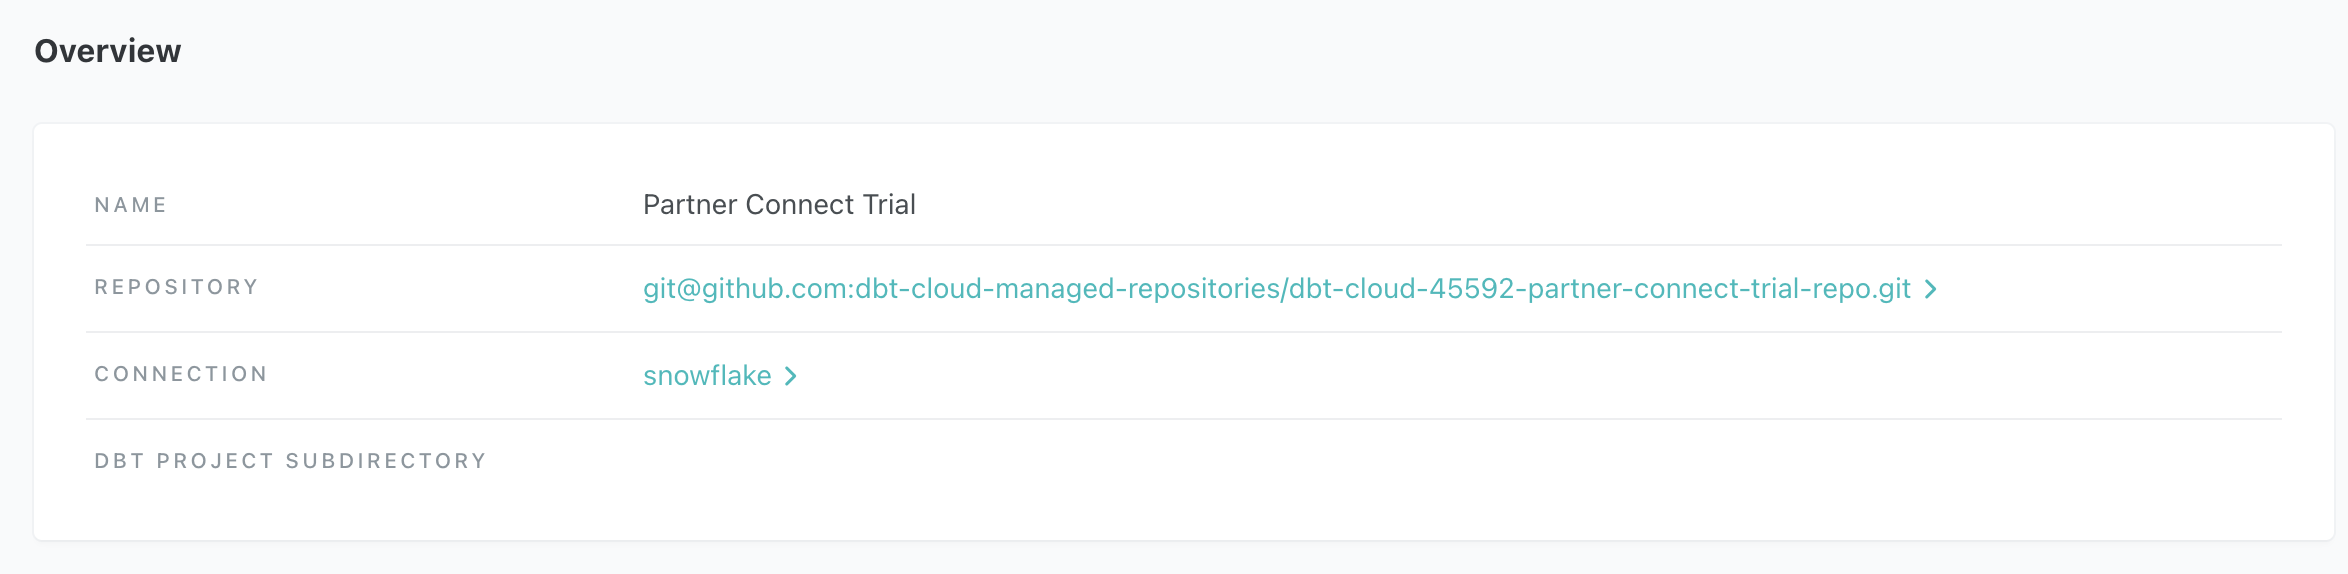 dbt — обзор проекта Snowflake
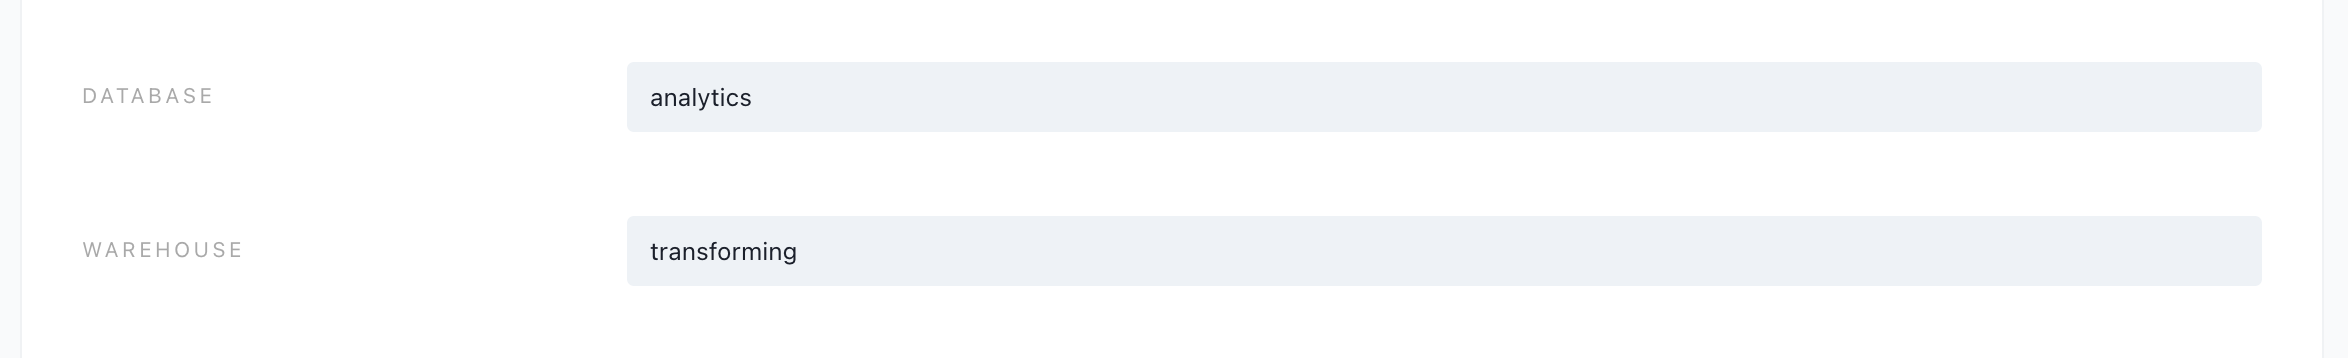 dbt — Обновление базы данных и warehouse
-
Создайте новый проект в dbt. Перейдите в Account settings (нажав на название своего аккаунта в меню слева) и нажмите + New Project.
-
Введите название проекта и нажмите Continue.
-
В разделе Configure your development environment откройте раскрывающееся меню Connection и выберите Add new connection. Вы перейдёте к настройкам подключения.
-
В разделе Type выберите Snowflake.
 dbt — Выбор подключения Snowflake
-
Укажите параметры подключения к Snowflake в разделе Settings:
-
Account: Определите идентификатор аккаунта по URL пробного аккаунта Snowflake, удалив
snowflakecomputing.com. Порядок компонентов идентификатора аккаунта зависит от версии Snowflake. Например, URL классической консоли Snowflake может выглядеть так:oq65696.west-us-2.azure.snowflakecomputing.com. URL AppUI или Snowsight может выглядеть так:snowflakecomputing.com/west-us-2.azure/oq65696. В обоих примерах идентификатор вашего аккаунта будет таким:oq65696.west-us-2.azure. Подробнее см. в разделе Идентификаторы аккаунтов документации Snowflake.✅ db5261993илиdb5261993.east-us-2.azure
❌ db5261993.eu-central-1.snowflakecomputing.com -
Role: Пока оставьте поле пустым. Позже вы сможете указать здесь роль Snowflake по умолчанию.
-
Database:
analytics. Этот параметр указывает dbt создавать новые модели в базе данных analytics. -
Warehouse:
transforming. Этот параметр указывает dbt использовать виртуальный склад transforming, созданный ранее.
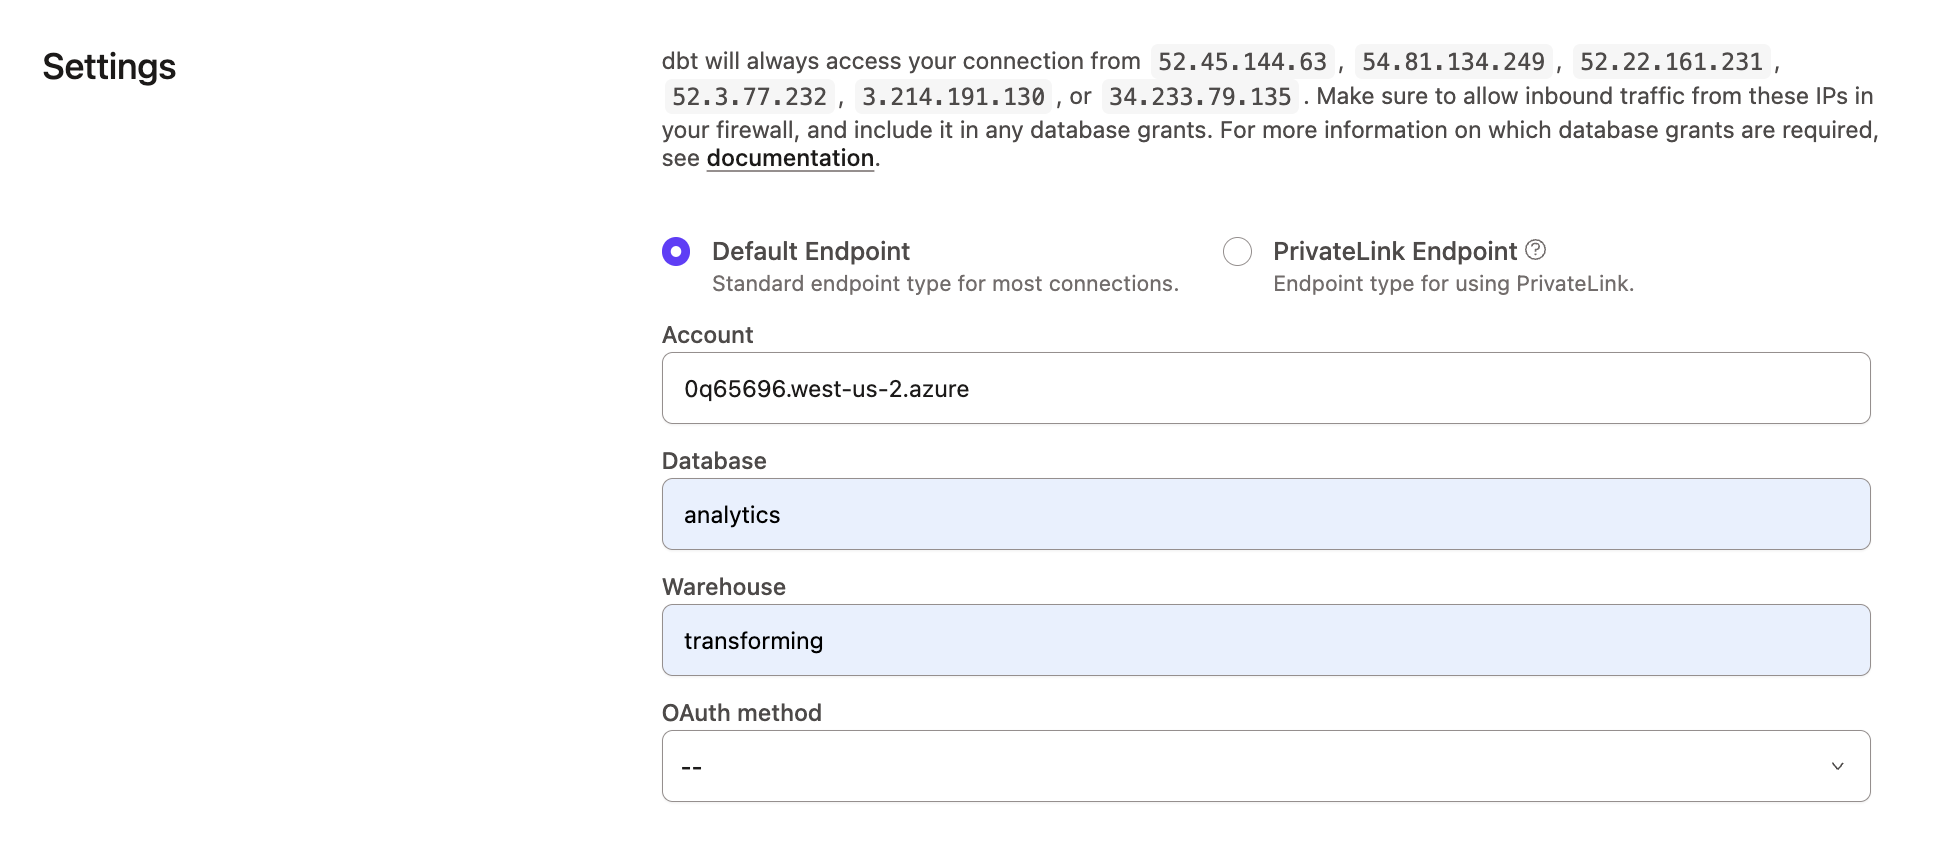 dbt — Настройки аккаунта Snowflake
-
-
Нажмите Save.
-
Настройте свои личные учетные данные пользователя, перейдя в Your profile > Credentials.
-
Выберите проект, использующий подключение к Snowflake.
-
Нажмите ссылку configure your development environment and add a connection. Откроется страница, на которой можно ввести свои личные учетные данные пользователя.
-
Введите свои учетные данные для Snowflake в разделе User credentials:
- Username: Имя пользователя, которое вы создали для Snowflake. Это не ваш адрес электронной почты; обычно оно состоит из вашего имени и фамилии, записанных слитно.
- Password: Пароль, который вы задали при создании учетной записи Snowflake.
- Schema: Обратите внимание, что имя схемы уже создано автоматически. По принятому соглашению оно имеет вид
dbt_<first-initial><last-name>. Эта схема напрямую связана с вашей средой разработки, и именно в ней будут создаваться ваши модели при запуске dbt в Studio IDE. - Target name: Оставьте значение по умолчанию.
- Threads: Оставьте значение 4. Это количество одновременных подключений, которые dbt будет устанавливать для параллельного построения моделей.
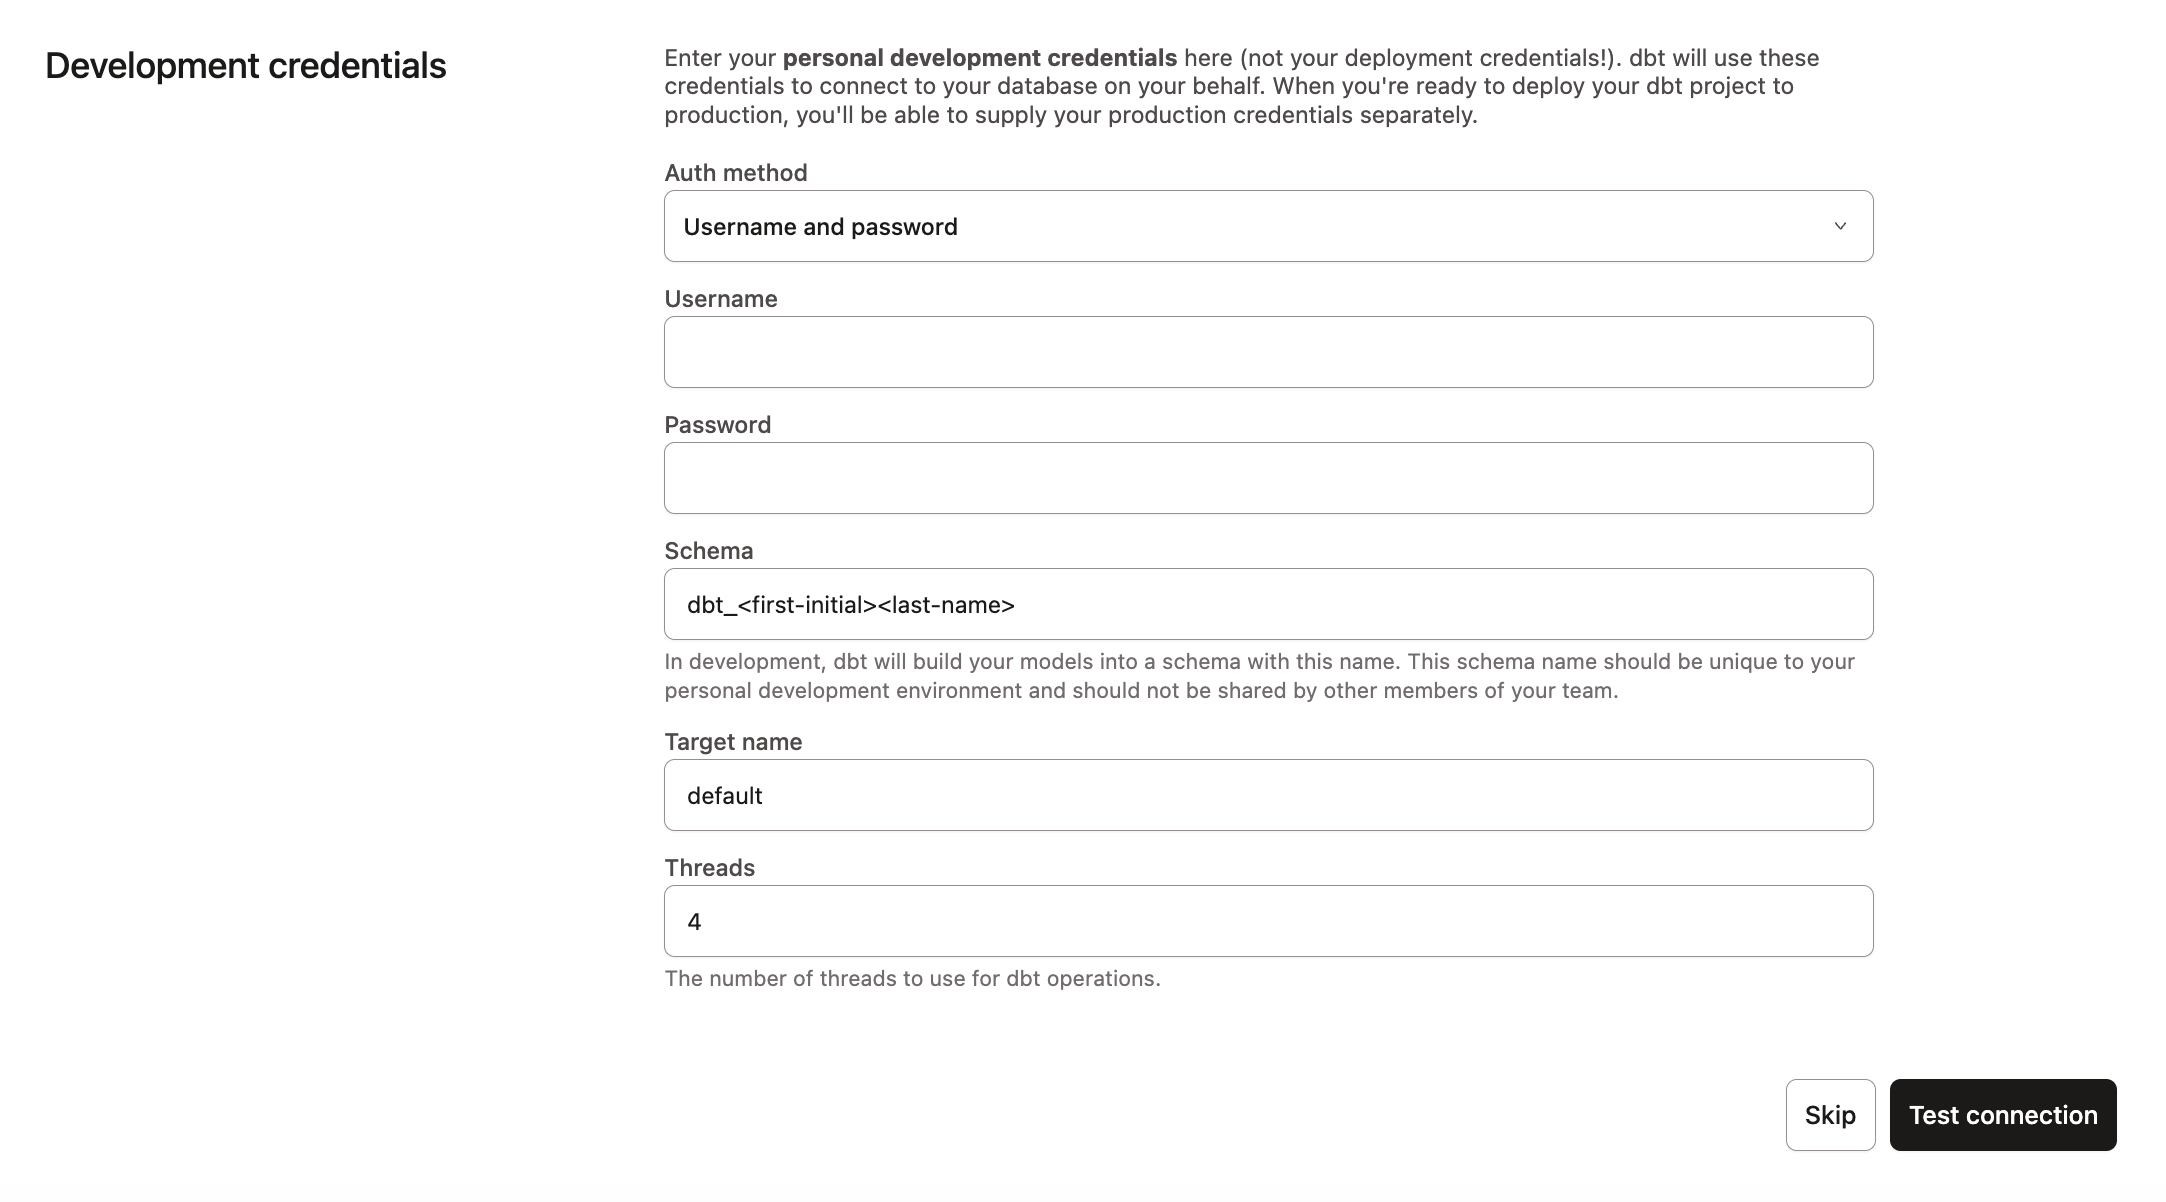 dbt — учетные данные пользователя Snowflake
-
Нажмите Test connection. Это позволит проверить, что dbt может получить доступ к вашей учетной записи Snowflake.
-
Если проверка прошла успешно, нажмите Save, чтобы завершить настройку. Если проверка завершилась ошибкой, вам может потребоваться проверить настройки Snowflake и учетные данные.
Откройте новую вкладку и выполните следующие шаги, чтобы настроить учетную запись, подготовить примеры данных и подключить dbt:
- Шаг 2: Создание нового проекта GCP
- Шаг 3: Создание наборов данных BigQuery
- Шаг 4: Создание учетных данных BigQuery
- Шаг 5: Подключение dbt к BigQuery
На шаге 3 создайте в своем проекте оба набора данных: jaffle_shop и stripe. Таблицы с примерами данных, к которым вы будете обращаться в запросах, находятся в общедоступном проекте dbt-tutorial.
Откройте новую вкладку и выполните следующие шаги, чтобы настроить учетную запись, подготовить примеры данных и подключить dbt:
- Шаг 2: Создание рабочего пространства Databricks
- Шаг 3: Загрузка данных
- Шаг 4: Подключение dbt к Databricks
- Шаг 5: Настройка интеграции через Partner Connect
На шаге 4 объясняются различия между подключением через Partner Connect и подключением вручную. Шаг 5 посвящен Partner Connect. Если вы подключаетесь вручную, воспользуйтесь документацией Databricks, ссылка на которую приведена на этом шаге.
Откройте новую вкладку и выполните следующие шаги, чтобы настроить учетную запись, подготовить примеры данных и подключить dbt:
Откройте новую вкладку и выполните следующие шаги, чтобы настроить учетную запись, подготовить примеры данных и подключить dbt:
Настройка проекта dbt
В этом разделе вы настроите репозиторий, управляемый dbt, и инициализируете свой проект dbt, чтобы приступить к разработке.
Настройка репозитория, управляемого dbt
Если вы использовали Partner Connect в Snowflake или Databricks, можете перейти к инициализации проекта dbt. Partner Connect предоставляет управляемый репозиторий. В противном случае вам потребуется настроить подключение к репозиторию.
При разработке в dbt вы можете использовать Git для управления версиями кода.
Чтобы подключиться к репозиторию, вы можете настроить управляемый репозиторий, размещённый на стороне dbt, или напрямую подключиться к поддерживаемому Git-провайдеру. Управляемые репозитории — отличный способ попробовать dbt без необходимости создавать новый репозиторий. В долгосрочной перспективе лучше подключиться к поддерживаемому Git-провайдеру, чтобы использовать такие возможности, как автоматизация и непрерывная интеграция.
Чтобы настроить управляемый репозиторий:
- В разделе "Настроить репозиторий" выберите Управляемый.
- Введите имя для вашего репозитория, например,
bbaggins-dbt-quickstart. - Нажмите Создать. Создание и импорт вашего репозитория займет несколько секунд.
- Как только вы увидите сообщение "Репозиторий успешно импортирован", нажмите Продолжить.
Инициализация проекта dbt
В этом руководстве предполагается, что вы используете Studio IDE для разработки проекта dbt, определения метрик, а также выполнения запросов к метрикам и предварительного просмотра результатов с помощью команд MetricFlow.
Теперь, когда репозиторий настроен, вы можете инициализировать проект и начать разработку в dbt с помощью Studio IDE:
- Нажмите Start developing in the Studio IDE. Первый запуск проекта может занять несколько минут: за это время устанавливается подключение к git, клонируется репозиторий и проверяется подключение к хранилищу данных.
- Над деревом файлов слева нажмите Initialize your project. Это создаст структуру папок с примерами моделей.
- Создайте первый коммит, нажав Commit and sync. Используйте сообщение коммита
initial commit. Это создаст первый коммит в управляемом репозитории и позволит создать ветку, в которой вы сможете добавлять новый код dbt. - Теперь вы можете напрямую выполнять запросы к данным в хранилище и запускать
dbt run. Попробуйте сделать это сейчас:- Удалите папку models/examples в File Catalog.
- Нажмите + Create new file, добавьте в новый файл запрос для своего хранилища данных и нажмите Save as, чтобы сохранить новый файл:
- Snowflake
- BigQuery
- Databricks
- Redshift
- Starburst Galaxy
select * from raw.jaffle_shop.customers
select * from `dbt-tutorial.jaffle_shop.customers`
select * from default.jaffle_shop_customers
select * from jaffle_shop.customers
select * from dbt_quickstart.jaffle_shop.jaffle_shop_customers
- В строке команд внизу введите dbt run и нажмите Enter. Должно появиться сообщение dbt run succeeded.
Сборка dbt-проекта
Следующий шаг — собрать ваш проект. Это включает добавление sources, staging-моделей, бизнес-определенных сущностей и пакетов в проект.
Добавьте источники
Sources в dbt — это таблицы с сырыми данными, которые вы будете преобразовывать. Организуя определения sources, вы документируете происхождение данных. Это также делает проект и трансформации более надежными, структурированными и понятными.
В Studio IDE есть два варианта работы с файлами:
- Создать новую ветку (рекомендуется): Создайте новую ветку для редактирования файлов и фиксации изменений. Перейдите в раздел Version Control на левой боковой панели и нажмите Create branch.
- Редактировать файлы в защищённой основной ветке: Выберите этот вариант, если предпочитаете редактировать, форматировать файлы, проверять их линтером и выполнять команды dbt непосредственно в основной ветке git. Studio IDE не позволяет фиксировать изменения в защищённой ветке, поэтому вам будет предложено зафиксировать изменения в новой ветке.
Назовите новую ветку build-project.
- Наведите курсор на директорию
modelsи нажмите меню с тремя точками (...), затем выберите Create file. - Назовите файл
staging/jaffle_shop/src_jaffle_shop.yml, затем нажмите Create. - Скопируйте следующий текст в файл и нажмите Save.
- Snowflake
- BigQuery
- Redshift
- Databricks
- Starburst Galaxy
sources:
  - name: jaffle_shop
    database: raw
    schema: jaffle_shop
    tables:
      - name: customers
      - name: orders
sources:
  - name: jaffle_shop
    database: dbt-tutorial
    schema: jaffle_shop
    tables:
      - name: customers
      - name: orders
sources:
  - name: jaffle_shop
    schema: jaffle_shop
    tables:
      - name: customers
      - name: orders
sources:
  - name: jaffle_shop
    schema: default
    tables:
      - name: customers
        identifier: jaffle_shop_customers
      - name: orders
        identifier: jaffle_shop_orders
sources:
  - name: jaffle_shop
    database: dbt_quickstart
    schema: jaffle_shop
    tables:
      - name: customers
        identifier: jaffle_shop_customers
      - name: orders
        identifier: jaffle_shop_orders
В source-файле вы также можете использовать кнопку Generate model, чтобы создать отдельный файл модели для каждого source. Это создаст новый файл в директории models с указанным именем source и заполнит его SQL-кодом определения source.
- Наведите курсор на директорию
modelsи нажмите меню с тремя точками (...), затем выберите Create file. - Назовите файл
staging/stripe/src_stripe.yml, затем нажмите Create. - Скопируйте следующий текст в файл и нажмите Save.
- Snowflake
- BigQuery
- Redshift
- Databricks
- Starburst Galaxy
sources:
  - name: stripe
    database: raw
    schema: stripe
    tables:
      - name: payment
sources:
  - name: stripe
    database: dbt-tutorial
    schema: stripe
    tables:
      - name: payment
sources:
  - name: stripe
    schema: stripe
    tables:
      - name: payment
sources:
  - name: stripe
    schema: default
    tables:
      - name: payment
        identifier: stripe_payments
sources:
  - name: stripe
    database: dbt_quickstart
    schema: jaffle_shop
    tables:
      - name: payment
        identifier: stripe_payments
Добавьте модели слоя staging
Модели слоя staging — это первый этап преобразования данных в dbt. Они очищают и подготавливают исходные данные для более сложных преобразований и анализа.
SQL-код моделей слоя staging использует source(), поэтому в нём используются имена из только что добавленного YAML-файла. Например, в BigQuery это указывает на dbt-tutorial.jaffle_shop.customers. В Snowflake — на raw.jaffle_shop.customers. Если на вашей платформе используется другое имя таблицы, оно уже указано в YAML-файле.
Выполните следующие шаги, чтобы добавить модели слоя staging в свой проект.
- В подкаталоге
jaffle_shopсоздайте файлstg_customers.sql. Либо вы можете использовать кнопку Generate model, чтобы создать отдельный файл модели для каждого source. - Скопируйте следующий запрос в файл и нажмите Save.
  select
   id as customer_id,
   first_name,
   last_name
  from {{ source('jaffle_shop', 'customers') }}
- В том же подкаталоге
jaffle_shopсоздайте файлstg_orders.sql. - Скопируйте следующий запрос в файл и нажмите Save.
  select
    id as order_id,
    user_id as customer_id,
    order_date,
    status
  from {{ source('jaffle_shop', 'orders') }}
- В подкаталоге
stripeсоздайте файлstg_payments.sql. - Скопируйте следующий запрос в файл и нажмите Save.
- Snowflake
- BigQuery
- Redshift
- Databricks
- Starburst Galaxy
select
   id as payment_id,
   orderid as order_id,
   paymentmethod as payment_method,
   status,
   -- amount is stored in cents, convert it to dollars
   amount / 100 as amount,
   created as created_at
from {{ source('stripe', 'payment') }}
select
   id as payment_id,
   orderid as order_id,
   paymentmethod as payment_method,
   status,
   -- сумма хранится в центах, преобразуем её в доллары
   amount / 100 as amount,
   created as created_at
from {{ source('stripe', 'payment') }}
select
   id as payment_id,
   orderid as order_id,
   paymentmethod as payment_method,
   status,
   -- сумма хранится в центах, преобразуем её в доллары
   amount / 100 as amount,
   created as created_at
from {{ source('stripe', 'payment') }}
select
   id as payment_id,
   orderid as order_id,
   paymentmethod as payment_method,
   status,
   -- сумма хранится в центах, преобразуем её в доллары
   amount / 100 as amount,
   created as created_at
from {{ source('stripe', 'payment') }}
select
   id as payment_id,
   order_id,
   paymentmethod as payment_method,
   status,
   -- сумма хранится в центах, преобразуем её в доллары
   amount / 100 as amount,
   created as created_at
from {{ source('stripe', 'payment') }}
- Введите
dbt runв командной строке в нижней части экрана. Команда должна выполниться успешно, и вы увидите три модели.
Добавьте бизнес-определенные сущности
Этот этап включает создание моделей, которые служат entity layer (слоем сущностей) или concept layer (концептуальным слоем) вашего dbt-проекта, подготавливая данные для отчетности и анализа. Также он включает добавление пакетов и time spine MetricFlow, которые расширяют функциональность dbt.
Этот этап — слой marts, который объединяет модульные части в широкое, насыщенное представление сущностей, важных для организации.
- Создайте файл
models/marts/fct_orders.sql. - Скопируйте следующий запрос в файл и нажмите Save.
with orders as  (
   select * from {{ ref('stg_orders' )}}
),


payments as (
   select * from {{ ref('stg_payments') }}
),


order_payments as (
   select
       order_id,
       sum(case when status = 'success' then amount end) as amount


   from payments
   group by 1
),


final as (


   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       coalesce(order_payments.amount, 0) as amount


   from orders
   left join order_payments using (order_id)
)


select * from final
- В директории
models/martsсоздайте файлdim_customers.sql. - Скопируйте следующий запрос в файл и нажмите Save.
with customers as (
   select * from {{ ref('stg_customers')}}
),
orders as (
   select * from {{ ref('fct_orders')}}
),
customer_orders as (
   select
       customer_id,
       min(order_date) as first_order_date,
       max(order_date) as most_recent_order_date,
       count(order_id) as number_of_orders,
       sum(amount) as lifetime_value
   from orders
   group by 1
),
final as (
   select
       customers.customer_id,
       customers.first_name,
       customers.last_name,
       customer_orders.first_order_date,
       customer_orders.most_recent_order_date,
       coalesce(customer_orders.number_of_orders, 0) as number_of_orders,
       customer_orders.lifetime_value
   from customers
   left join customer_orders using (customer_id)
)
select * from final
-
Создайте модель time spine для MetricFlow, следуя руководству MetricFlow time spine guide. В этом руководстве показано, как создать и SQL-модель, и YAML-конфигурацию, необходимые для вычисления метрик на основе времени.
-
Введите
dbt runв командной строке внизу экрана. Вы должны увидеть сообщение об успешном выполнении, а в деталях запуска — что dbt успешно собрал ваши модели.
Создайте семантические модели
В этом разделе вы узнаете о семантических моделях, их компонентах и о том, как настроить временную шкалу (time spine).
О семантических моделях
(Версии dbt: v1.12 и новее)Семантические модели содержат множество типов объектов (таких как сущности, простые метрики и измерения), которые позволяют MetricFlow формировать запросы на основе определений метрик.
- Каждая семантическая модель соответствует одной SQL-модели dbt (связь 1:1).
- Каждая семантическая модель содержит не более одной первичной или естественной сущности.
- Каждая семантическая модель содержит ноль, одну или несколько внешних или уникальных сущностей, используемых для связи с другими сущностями.
- Каждая семантическая модель также может содержать измерения, простые метрики и метрики. Именно эти объекты передаются в ваш BI-инструмент и используются им для выполнения запросов.
В следующих шагах семантические модели позволят вам определить, как интерпретировать данные о заказах. Они включают сущности (например, столбцы идентификаторов, служащие ключами для объединения данных), измерения (для группировки или фильтрации данных) и простые метрики (для агрегации данных).
- В каталоге
modelsсоздайте новый файлfct_orders.yml.
Обязательно сохраняйте все семантические модели и метрики в каталоге, указанном в model-paths (или в его подкаталоге, например models/semantic_models/). Если сохранить их за пределами этого пути, файл semantic_manifest.json окажется пустым, а ваши семантические модели или метрики не будут распознаны.
- Добавьте следующий код в только что созданный файл:
models:
  - name: fct_orders
    description: |
      Таблица фактов заказов. Уровень детализации этой таблицы — одна строка на заказ.
    semantic_model:
      enabled: true
      name: orders

    agg_time_dimension: order_date
Компоненты семантической модели
(Версии dbt: v1.12 и новее)В следующих разделах объясняется роль измерений, сущностей и простых метрик в семантических моделях.
- Сущности служат уникальными идентификаторами, например столбцами ID, и связывают данные из разных таблиц.
- Измерения позволяют группировать и фильтровать данные.
- Простые метрики вычисляют значения с помощью функций агрегирования.
Сущности
Сущности — это понятия реального бизнеса, которые служат основой вашей семантической модели. В наших semantic models это будут ID-колонки (например, order_id). Они будут выступать ключами для join с другими semantic models.
Добавьте entities в файл семантической модели fct_orders.yml:
models:
  - name: fct_orders
    semantic_model:
      enabled: true
      name: orders

    agg_time_dimension: order_date

    columns:
      # Сущности
      - name: order_id
        entity:
          type: primary
          name: order_id
      - name: customer_id
        entity:
          name: customer
          type: foreign
Измерения
Измерения — это способ группировать или фильтровать информацию по категориям или времени.
Добавьте dimensions в файл семантической модели fct_orders.yml:
models:
  - name: fct_orders
    semantic_model:
      enabled: true
      name: orders

    agg_time_dimension: order_date

    columns:
      # Сущности
      - name: order_id
        entity:
          type: primary
          name: order_id
      - name: customer_id
        entity:
          name: customer
          type: foreign
      # Недавно добавлено — измерения
      - name: order_date
        granularity: day
        dimension:
          type: time
Простые метрики
Простые метрики выполняют агрегацию (например, sum, count, average и т. д.) по одному полю вашей модели. Они заменяют понятие «меры» из предыдущих версий. Чтобы определить более сложные метрики, обратитесь к разделу Определение метрик и добавление второй семантической модели.
Добавьте простые метрики в файл модели fct_orders.yml:
models:
  - name: fct_orders
    semantic_model:
      enabled: true
      name: orders

    agg_time_dimension: order_date

    columns:
      # Сущности
      - name: order_id
        entity:
          type: primary
          name: order_id
      - name: customer_id
        entity:
          name: customer
          type: foreign
      # Измерения
      - name: order_date
        granularity: day
        dimension:
          type: time
      - name: amount
        dimension:
          type: categorical

    # Добавлено — простые метрики
    metrics:
      - name: order_total
        description: Общая сумма каждого заказа с учётом налогов
        type: simple
        label: Общая сумма заказа
        agg: sum
        expr: amount
      - name: order_count
        type: simple
        label: Количество заказов
        agg: sum
        expr: 1
      - name: customers_with_orders
        description: Количество уникальных клиентов, размещающих заказы
        type: simple
        label: Клиенты с заказами
        agg: count_distinct
        expr: customer_id
      - name: order_value_p99
        type: simple
        label: 99-й процентиль стоимости заказа
        agg: percentile
        expr: amount
        percentile: 99.0
        percentile_type: discrete
Настройка временной оси
Чтобы обеспечить точные агрегации по времени, необходимо настроить time spine. Time spine позволяет корректно рассчитывать метрики на разных временных гранулярностях.
Следуйте руководству MetricFlow time spine guide с полными пошаговыми инструкциями по созданию и настройке модели time spine. В этом руководстве приведены актуальные best practices и исключены устаревшие конфигурации.
Определите метрики и добавьте вторую семантическую модель
В этом разделе вы определите метрики и добавите в проект вторую семантическую модель.
Определите метрики
Метрики — это язык, на котором говорят бизнес-пользователи, и способ измерять эффективность бизнеса. Метрика — это агрегация над колонкой в вашем warehouse, которую вы обогащаете измерениями (dimensional cuts).
Существует несколько типов метрик, которые можно настроить:
- Метрики конверсии — Отслеживают, когда для сущности происходят базовое событие и последующее событие конверсии в пределах заданного периода времени.
- Накопительные метрики — Агрегируют меру в пределах заданного окна. Если окно не указано, мера накапливается за весь период, за который записаны данные. Обратите внимание: перед добавлением накопительных метрик необходимо создать модель временной оси (time spine).
- Производные метрики — Позволяют выполнять вычисления на основе метрик.
- Простые метрики — Напрямую ссылаются на выражение для одного столбца в семантической модели, без участия дополнительных столбцов. Они представляют собой агрегации по столбцу в вашей платформе данных и могут фильтроваться по одному или нескольким измерениям.
- Метрики отношений — Используют метрику в числителе и метрику в знаменателе. Строку ограничения можно применить как к числителю и знаменателю одновременно, так и отдельно к числителю или знаменателю.
После создания семантических моделей можно приступить к созданию метрик, ссылаясь на уже созданные (Версии dbt: v1.12 и новее) простые метрики:
- Добавьте метрики в файл
fct_orders.yml:
Убедитесь, что вы сохраняете все semantic models и метрики в директории, указанной в model-paths (или в её поддиректории, например models/semantic_models/). Если сохранить их вне этого пути, файл semantic_manifest.json окажется пустым, и ваши semantic models или метрики не будут распознаны.
models:
  - name: fct_orders
    semantic_model:
      enabled: true
      name: orders

    agg_time_dimension: order_date

    columns:
      - name: order_id
        entity:
          type: primary
          name: order_id
      - name: customer_id
        entity:
          name: customer
          type: foreign
      - name: order_date
        granularity: day
        dimension:
          type: time
      - name: amount
        dimension:
          type: categorical

    metrics:
      # Метрики типа simple
      - name: order_total
        description: Суммарная стоимость заказов
        type: simple
        label: Общая стоимость заказов
        agg: sum
        expr: amount
      - name: order_count
        description: Количество заказов
        type: simple
        label: Количество заказов
        agg: sum
        expr: 1
      - name: customers_with_orders
        description: Количество уникальных клиентов, разместивших заказы
        type: simple
        label: Клиенты с заказами
        agg: count_distinct
        expr: customer_id
      - name: large_orders
        description: Количество заказов с общей стоимостью более 20
        type: simple
        label: Крупные заказы
        agg: sum
        expr: 1
        filter: |
          {{ Dimension('order_id__amount') }} >= 20
      # Метрика типа ratio
      - name: avg_order_value
        label: Средняя стоимость заказа
        description: Средняя стоимость одного заказа
        type: ratio
        numerator: order_total
        denominator: order_count
      # Метрики типа cumulative
      - name: cumulative_order_amount_mtd
        label: Накопленная сумма заказов с начала месяца
        description: Стоимость всех заказов с начала текущего месяца
        type: cumulative
        grain_to_date: month
        input_metric: order_total
      # Производная метрика
      - name: pct_of_orders_that_are_large
        label: Процент крупных заказов
        description: Процент заказов, относящихся к крупным
        type: derived
        expr: large_orders / order_count
        input_metrics:
          - name: large_orders
          - name: order_count
Добавьте вторую семантическую модель в свой проект
(Версии dbt: v1.12 и новее)Отличная работа, вы успешно создали свою первую семантическую модель! В ней есть все необходимые элементы: сущности, измерения и метрики.
Давайте расширим аналитические возможности вашего проекта, добавив ещё одну семантическую модель в другую модель витрины данных, например в dim_customers.yml.
После настройки модели orders:
- Создайте файл
dim_customers.yml. - Скопируйте следующий код в файл и нажмите Сохранить.
models:
  - name: dim_customers
    semantic_model:
      enabled: true
      name: customers

    agg_time_dimension: most_recent_order_date

    columns:
      # Entities
      - name: customer_id
        entity:
          name: customer
          type: primary
      # Dimensions
      - name: first_name
        dimension:
          name: customer_name
          type: categorical
      - name: first_order_date
        granularity: day
        dimension:
          type: time
      - name: most_recent_order_date
        granularity: day
        dimension:
          type: time
      - name: number_of_orders
        dimension:
          type: categorical
      - name: lifetime_value
        dimension:
          type: categorical

    # Metrics
    metrics:
      - name: customers_with_orders
        label: Customers with orders
        description: Unique count of customers placing orders
        type: simple
        agg: count_distinct
        expr: customer_id
      - name: count_lifetime_orders
        description: Total count of orders per customer
        type: simple
        label: Lifetime orders
        agg: sum
        expr: number_of_orders
      - name: lifetime_spend
        description: Gross customer lifetime spend inclusive of taxes
        type: simple
        label: Lifetime spend
        agg: sum
        expr: lifetime_value
Эта семантическая модель использует простые метрики для анализа показателей клиентов и делает акцент на таких измерениях клиентов, как имя, тип и даты заказов. Её особенность — анализ поведения клиентов, их пожизненной ценности и закономерностей оформления заказов.
Тестируйте и запрашивайте метрики
Для работы с метриками в dbt у вас есть несколько инструментов для валидации или выполнения команд. Вот как вы можете тестировать и запрашивать метрики в зависимости от вашей настройки:
- Пользователи Studio IDE — Выполняйте команды MetricFlow непосредственно в Studio IDE, чтобы запрашивать и просматривать метрики. Просматривайте визуальное представление метрик на вкладке Lineage.
- Пользователи dbt platform CLI — dbt platform CLI позволяет выполнять команды MetricFlow для запроса и предварительного просмотра метрик непосредственно в интерфейсе командной строки.
- Пользователи dbt v1 — Используйте MetricFlow CLI для выполнения команд. Хотя это руководство предназначено прежде всего для пользователей dbt, пользователи dbt v1 могут найти подробные инструкции по настройке MetricFlow CLI на странице «Команды MetricFlow». Обратите внимание: для использования Semantic Layer необходима учётная запись с тарифом Starter или Enterprise.
Кроме того, вы можете выполнять команды с помощью SQL-клиентов, таких как DataGrip, DBeaver или RazorSQL.
Пользователи Studio IDE
Вы можете использовать префикс dbt sl перед именем команды, чтобы выполнять команды в dbt. Например, чтобы вывести список всех метрик, выполните dbt sl list metrics. Полный список команд MetricFlow, доступных в Studio IDE, приведён на странице Команды MetricFlow.
Кнопка статуса в Studio IDE (расположенная в правом нижнем углу редактора) отображает статус Error, если в определении метрики или семантической модели есть ошибка. Нажмите эту кнопку, чтобы узнать, в чём именно заключается проблема, и устранить её.
После просмотра убедитесь, что вы зафиксировали и объединили свои изменения в вашем проекте.
Пользователи dbt platform CLI
Этот раздел предназначен для пользователей dbt platform CLI. Команды MetricFlow интегрированы с dbt, поэтому вы можете выполнять команды MetricFlow сразу после установки dbt platform CLI. Управление версиями будет осуществляться автоматически в вашей учетной записи.
Следуйте следующим шагам, чтобы начать:
- Установите dbt platform CLI (если вы ещё этого не сделали). Затем перейдите в каталог вашего проекта dbt.
- Выполните команду dbt, например
dbt parse,dbt run,dbt compileилиdbt build. Если этого не сделать, вы получите сообщение об ошибке, которое начинается с: "ensure that you've ran an artifacts....". - MetricFlow строит семантический граф и создаёт в dbt файл
semantic_manifest.json, который сохраняется в каталоге/target. (Версии dbt: v1.12 и новее) Начиная с dbt v1.12, dbt также записывает файлosi_document.jsonв каталогtarget/на этапе разбора. Подробнее см. в разделе Семантический манифест. Если вы используете пример Jaffle Shop, выполнитеdbt seed && dbt run, чтобы перед продолжением убедиться, что необходимые данные есть на вашей платформе данных.
При изменении метрик обязательно выполняйте как минимум dbt parse, чтобы обновить Semantic Layer. Эта команда обновляет файл semantic_manifest.json(Версии dbt: v1.12 и новее) и osi_document.json, чтобы ваши изменения учитывались при запросах к метрикам. Выполняя dbt parse, вы избавляетесь от необходимости заново собирать все модели.
-
Выполните
dbt sl --help, чтобы подтвердить, что у вас установлен MetricFlow и что вы можете просмотреть доступные команды. -
Выполните
dbt sl query --metrics <metric_name> --group-by <dimension_name>, чтобы запросить метрики и измерения. Например, чтобы запроситьorder_totalиorder_count(обе метрики), а затем сгруппировать их поorder_date(измерение), выполните:dbt sl query --metrics order_total,order_count --group-by order_id__order_date -
Убедитесь, что значения метрик соответствуют вашим ожиданиям. Чтобы лучше понять, как генерируется метрика, вы можете просмотреть сгенерированный SQL, если введете
--compileв командной строке. -
Зафиксируйте и объедините изменения в коде, содержащие определения метрик.
Запустите production job
В этом разделе объясняется, как запустить задание в среде развертывания в dbt, чтобы материализовать и развернуть метрики. В настоящее время поддерживается только среда развертывания.
-
После того как вы определили семантические модели и метрики, создайте коммит с изменениями метрик и выполните слияние в своем проекте dbt.
-
В dbt создайте новую среду развертывания или используйте существующую среду с dbt версии 1.6 или выше.
- Примечание: в настоящее время поддерживается среда развертывания (поддержка среды разработки появится в ближайшее время)
-
Чтобы создать новую среду, перейдите в раздел Orchestration в меню навигации, выберите Environments, а затем — Create new environment.
-
Укажите имя пользователя и пароль для вашей платформы данных в учетных данных для развертывания. Схеме можно присвоить любое имя. Нажмите Save, чтобы создать новую производственную среду.
-
Создайте новое задание развертывания, которое будет выполняться в только что созданной среде. Вернитесь в меню Orchestration, выберите Jobs, затем Create job и нажмите Deploy job.
-
Настройте задание на выполнение команды
dbt parse, чтобы разобрать ваши проекты и сформировать файл артефактаsemantic_manifest.json(Версии dbt: v1.12 и новее) и артефактosi_document.json. Хотя выполнениеdbt buildне требуется, при необходимости вы можете запустить эту команду.примечаниеЕсли вы используете dbt v2, добавьте команду
dbt docs generateв свое задание, чтобы успешно развернуть метрики. -
Запустите job, нажав кнопку Run now. Отслеживайте прогресс выполнения в реальном времени на вкладке Run summary.
После успешного завершения задания ваш проект dbt, включая сгенерированную документацию, будет полностью развернут и доступен для использования в вашей производственной среде. Если возникнут какие-либо проблемы, просмотрите логи, чтобы диагностировать и устранить ошибки.
Что происходит внутри?
- Слияние кода с вашей основной веткой позволяет dbt получить эти изменения и сформировать определение в манифесте, созданном в результате запуска.
- Повторный запуск задания в среде развертывания помогает материализовать модели, от которых зависят метрики, на платформе данных. Это также обеспечивает актуальность манифеста.
- API семантического слоя получают самый свежий манифест и позволяют вашей интеграции извлекать из него метаданные.
Администрирование Semantic Layer
В этом разделе вы узнаете, как добавить учетные данные и создать service tokens, чтобы начать выполнять запросы к dbt Semantic Layer. Раздел охватывает следующие темы:
- Выбор окружения
- Настройка учетных данных и создание токенов
- Просмотр деталей подключения
- Добавление дополнительных учетных данных
- Удаление конфигурации
Вы должны входить в группу Owner и иметь соответствующую лицензию и права доступа, чтобы администрировать Semantic Layer на уровне среды и проекта.
- Тарифные планы Enterprise+ и Enterprise:
- Лицензия Developer с правами Account Admin или
- Роль Owner с лицензией Developer и назначенными правами Project Creator, Database Admin или Admin.
- Тарифный план Starter: роль Owner с лицензией Developer.
- Бесплатный пробный период: вы используете бесплатную пробную версию тарифного плана Starter в роли Owner, а значит, у вас есть доступ к dbt Semantic Layer.
1. Выберите окружение
Выберите окружение, в котором вы хотите включить Семантический слой:
- Откройте Account settings в меню навигации.
- В разделе Settings нажмите Projects и выберите проект.
- На странице Project details найдите раздел Semantic Layer и нажмите Configure Semantic Layer.
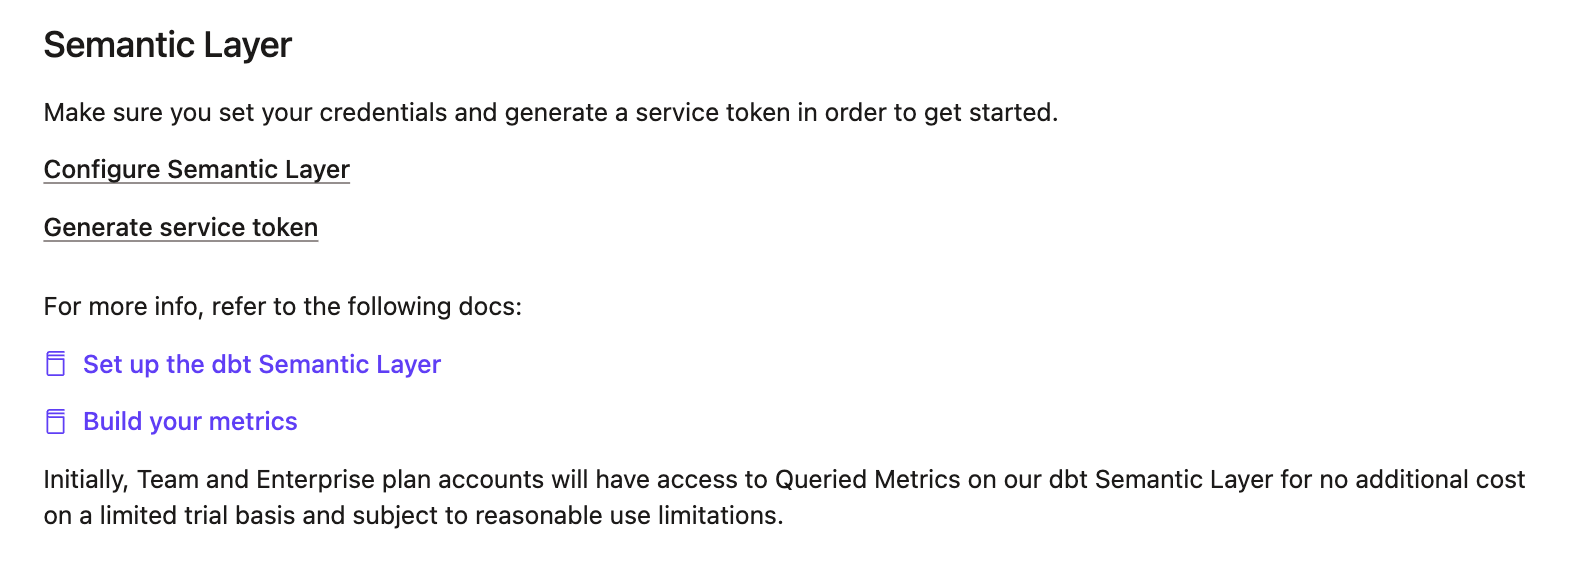 Раздел Semantic Layer на странице «Сведения о проекте»
- На странице Set Up Semantic Layer Configuration выберите окружение развёртывания для Semantic Layer и нажмите Save.
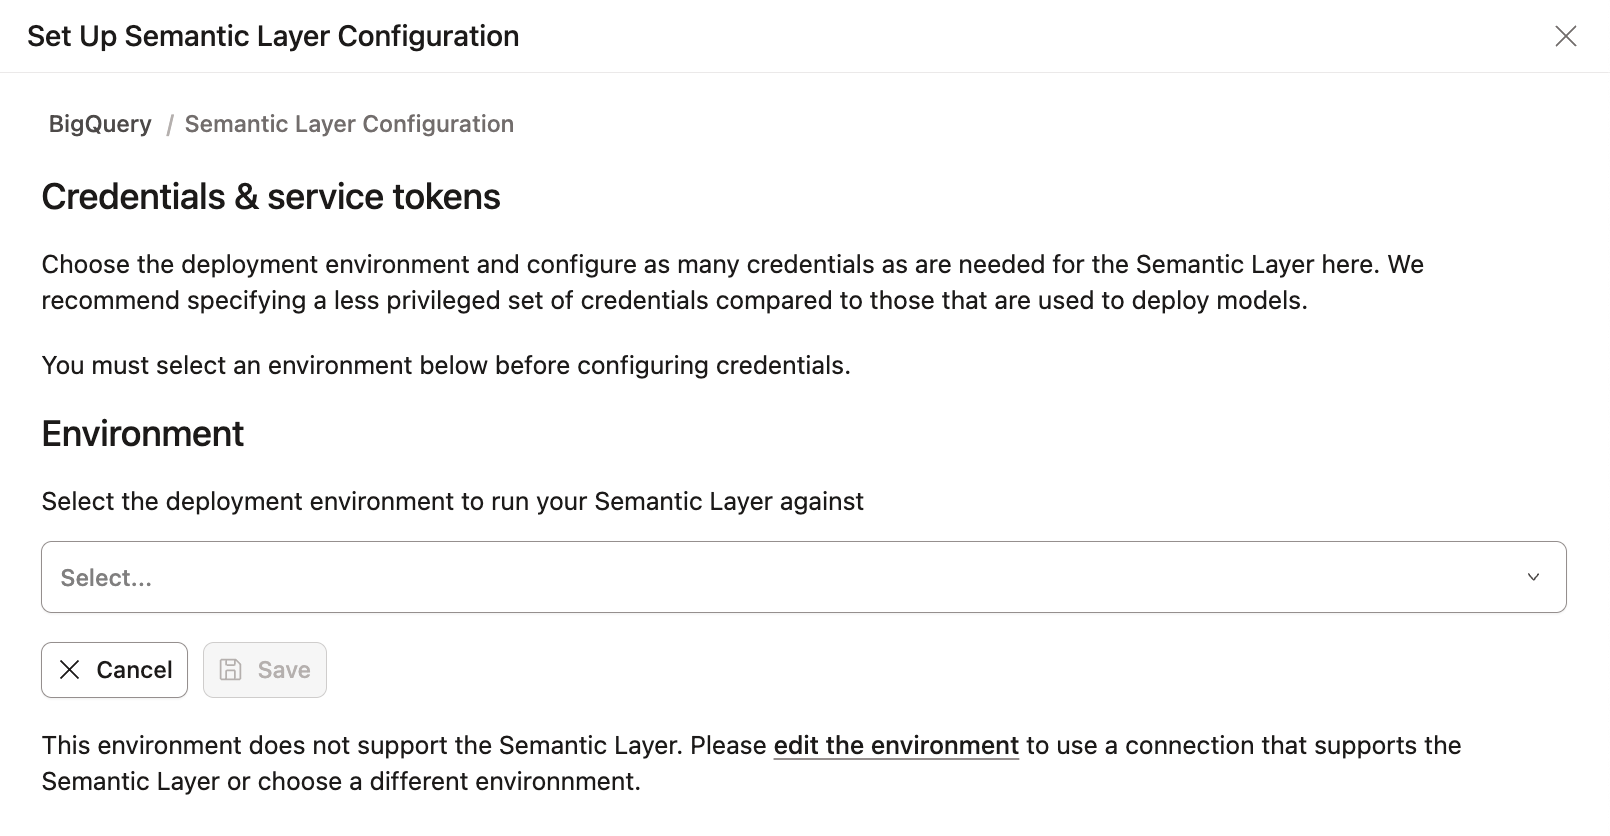 Выберите среду развертывания, в которой будет работать ваш семантический слой.
2. Настройка учетных данных и создание токенов
Для настройки Semantic Layer с токенами API есть два варианта:
- Добавить учетные данные и создать сервисные токены
- Настроить учетные данные для разработки и создать персональные токены
Добавление учётных данных и создание сервисных токенов
Первый вариант — использовать сервисные токены для аутентификации. Эти токены связаны с учетными данными платформы данных, которые вы предварительно настраиваете. Настроенные учетные данные используются для выполнения запросов, которые Semantic Layer отправляет к вашей платформе данных.
Эти учетные данные контролируют физический доступ к данным, к которым обращается Семантический слой, и все политики доступа, установленные на платформе данных для этих учетных данных, будут соблюдаться.
| Возможность | Тариф Starter | Тарифы Enterprise+ и Enterprise |
|---|---|---|
| Service tokens | Можно создать несколько service token, связанных с одними учётными данными (credential). | Можно использовать несколько credential и привязывать к каждому из них несколько service token. Обратите внимание, что один service token нельзя привязать более чем к одному credential. |
| Credentials per project | Один credential на проект. | Можно добавить несколько credential на проект. |
| Привязка нескольких сервисных токенов к одним учётным данным | ✅ | ✅ |
Если вы используете тариф Starter и вам нужно добавить больше credential, рассмотрите возможность перехода на Enterprise+ или Enterprise plan. Все пользователи Enterprise могут обратиться к разделу Add more credentials для получения подробных инструкций по добавлению нескольких credential.
1. Выберите среду развертывания
- После выбора deployment environment вы увидите страницу Credentials & service tokens.
- Нажмите кнопку Add Semantic Layer credential.
2. Настройте учетные данные
- В разделе 1. Add credentials введите учетные данные, специфичные для вашей data platform, которые Semantic Layer будет использовать.
- Используйте учетные данные с минимально необходимыми правами. Semantic Layer требует доступ на чтение к схемам, содержащим dbt models, используемые в ваших semantic models для downstream‑приложений.
-
Используйте расширенные атрибуты и переменные окружения при подключении к семантическому слою. Если задать значение непосредственно в учетных данных семантического слоя, оно будет иметь более высокий приоритет, чем значение в расширенных атрибутах. При использовании переменных окружения будет использоваться значение по умолчанию для данного окружения.
Например, задайте хранилище, используя
{{env_var('DBT_WAREHOUSE')}}в ваших учетных данных Семантического слоя.Аналогично, если вы задаете значение учетной записи с помощью
{{env_var('DBT_ACCOUNT')}}в Расширенных атрибутах, dbt проверит как Расширенные атрибуты, так и переменную окружения.
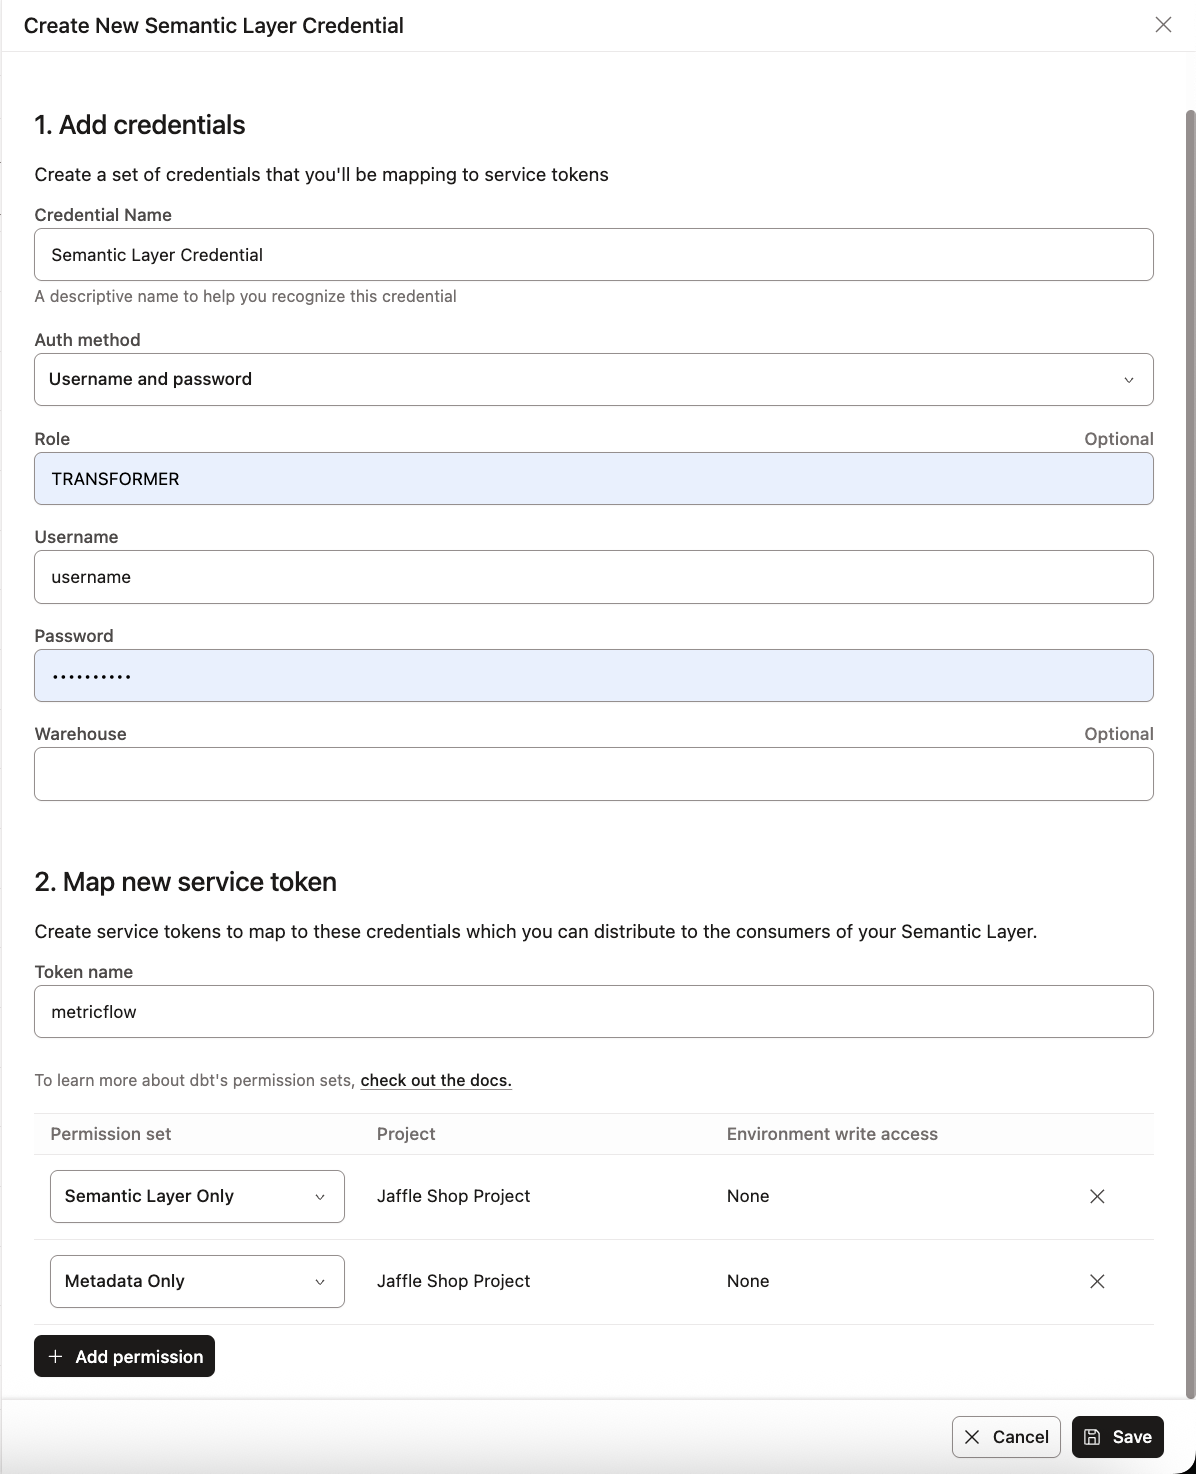 Добавьте учетные данные и свяжите их с сервисным токеном.
3. Создайте или привяжите сервисные токены
- Если у вас есть разрешение на создание сервисных токенов, после добавления учетных данных вы увидите опцию Map new service token. Укажите имя токена, задайте разрешения 'Semantic Layer Only' и 'Metadata Only' и нажмите Save.
- После создания токена вы больше не сможете его просмотреть, поэтому обязательно сохраните его в надежном месте.
- Если у вас нет прав на создание сервисных токенов, вы увидите сообщение с предложением обратиться к администратору, чтобы он создал токен для вас. Администраторы могут создавать и привязывать токены по мере необходимости.
 Если у вас нет прав на создание сервисных токенов, вы можете создать учетные данные и обратиться к администратору, чтобы он создал для вас токен.
- Тариф Starter позволяет создавать несколько service token, привязанных к одному базовому credential, однако в каждом проекте может быть только один credential.
- Все тарифы Enterprise позволяют добавлять несколько credential и связывать их с service token для более гибкого управления доступом.
Запишитесь на бесплатную демонстрацию в реальном времени, чтобы узнать обо всех возможностях тарифных планов dbt Enterprise и выше.
Настройте учетные данные для разработки и создайте персональный токен
Использование персональных токенов доступа (PAT) также поддерживается в качестве метода аутентификации в dbt Semantic Layer. Это обеспечивает аутентификацию на уровне пользователя, снижая необходимость совместного использования токенов несколькими пользователями. При аутентификации с помощью PAT запросы выполняются с использованием ваших личных учетных данных.
Чтобы использовать PAT в Semantic Layer:
- Настройте свои учетные данные.
- Нажмите на имя своей учетной записи в нижней части меню слева и перейдите в Account settings > Credentials.
- Выберите свой проект.
- Нажмите Edit.
- Перейдите в User credentials и введите свои данные.
- Нажмите Save.
- Создайте персональный токен доступа. Обязательно скопируйте токен.
Вы можете использовать созданный персональный токен доступа (PAT) для аутентификации при работе с API и интеграциями Semantic Layer.
3. Просмотрите сведения о подключении
- Вернитесь на страницу Project details, чтобы посмотреть параметры подключения для downstream‑инструментов.
- Скопируйте и передайте соответствующим командам Environment ID, service или personal token, Host, а также имя service или personal token для настройки подключения BI‑инструментов. Если ваш инструмент использует GraphQL API, сохраните информацию о GraphQL API host вместо JDBC URL.
Информацию о подключении к другим интеграциям см. в разделе Доступные интеграции.
 После настройки вы получите параметры подключения к инструментам, использующим данные семантического слоя.
4. Добавьте дополнительные учетные данные Enterprise +Enterprise
Во всех планах dbt Enterprise можно при необходимости добавить несколько наборов учетных данных и сопоставить их с сервисными токенами. Это позволяет более детально управлять доступом и настраивать его для разных команд. Затем эти учетные данные можно передать соответствующим командам для настройки подключения BI-инструментов. Эти учетные данные управляют физическим доступом к базовым данным, к которым обращается семантический слой.
Мы рекомендуем настраивать учетные данные и сервисные токены в соответствии с вашими командами и их ролями. Например, создавайте токены или учетные данные, которые соответствуют потребностям вашей команды, например, предоставляя доступ к схемам, связанным с финансами, для финансовой команды.
1. Добавьте дополнительные учетные данные
- После настройки окружения на странице Credentials & service tokens нажмите кнопку Add Semantic Layer credential, чтобы создать несколько наборов учетных данных и сопоставить их с сервисным токеном.
- В разделе 1. Add credentials заполните поля учетных данных платформы данных. Рекомендуем использовать учетные данные с доступом «только для чтения».
Добавьте учетные данные и сопоставьте их с сервисным токеном.
2. Сопоставьте сервисные токены с учетными данными
- В разделе 2. Map new service token сопоставьте сервисный токен с учетными данными, настроенными на предыдущем шаге. dbt автоматически выбирает необходимый набор разрешений для сервисного токена (Semantic Layer Only и Metadata Only).
- Чтобы добавить еще один сервисный токен во время настройки, нажмите Add Service Token.
- Позже вы сможете связать дополнительные сервисные токены с теми же учетными данными на странице Semantic Layer Configuration Details. Чтобы добавить еще один сервисный токен в существующую конфигурацию Semantic Layer, нажмите Add service token в разделе Linked service tokens.
- Нажмите Save, чтобы связать сервисный токен с учетными данными. Не забудьте скопировать сервисный токен и сохранить его в безопасном месте: после создания просмотреть его повторно будет невозможно.
 Используйте страницу настройки для управления несколькими наборами учетных данных, привязки и отвязки сервисных токенов, чтобы более точно управлять доступом.
3. Удалите учетные данные
-
Чтобы удалить учетные данные, вернитесь на страницу Учетные данные и сервисные токены.
-
В разделе Связанные сервисные токены нажмите Редактировать и выберите Удалить учетные данные, чтобы удалить учетные данные.
Когда вы удаляете учетные данные, любые сервисные токены, связанные с этими учетными данными в проекте, перестанут работать и будут недоступны для конечных пользователей.
Удаление конфигурации
Вы можете удалить всю конфигурацию Semantic Layer для проекта. Обратите внимание, что удаление конфигурации Semantic Layer приведёт к удалению всех учётных данных и отвязке всех service token от проекта. Также это приведёт к тому, что все запросы к Semantic Layer будут завершаться с ошибкой.
Следуйте этим шагам, чтобы удалить конфигурацию Семантического слоя для проекта:
- Перейдите на страницу Детали проекта.
- В разделе Семантический слой выберите Удалить Семантический слой.
- Подтвердите удаление, нажав Да, удалить семантический слой в всплывающем окне подтверждения.
Чтобы повторно включить настройку Семантического слоя dbt в будущем, вам нужно будет воссоздать ваши конфигурации, следуя предыдущим шагам. Если ваши семантические модели и метрики все еще находятся в вашем проекте, никаких изменений не требуется. Если вы их удалили, вам нужно будет снова настроить конфигурации YAML.
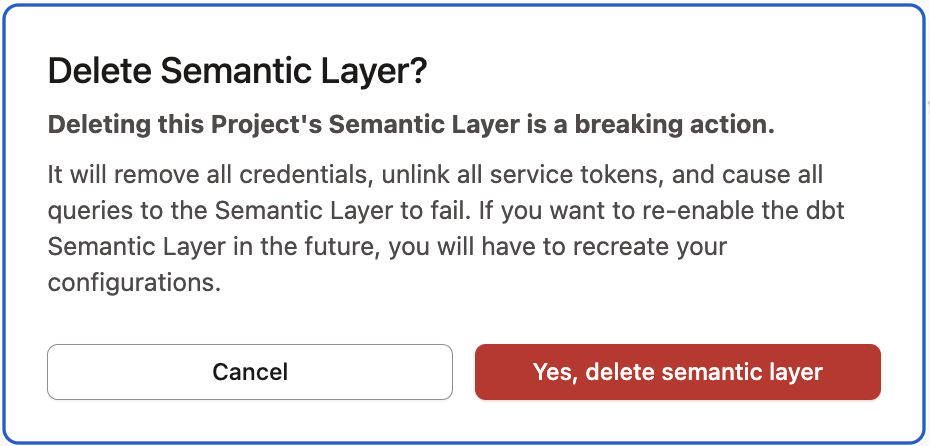 Удаление конфигурации Semantic Layer для проекта.
Дополнительная конфигурация
Следующие дополнительные гибкие конфигурации для учетных данных Семантического слоя.
Сопоставление сервисных токенов с учётными данными
- После настройки окружения вы можете сопоставить дополнительные сервисные токены с теми же учётными данными, если у вас есть необходимые разрешения.
- Перейдите на страницу Credentials & service tokens и нажмите кнопку +Add Service Token в разделе Linked Service Tokens.
- Введите имя сервисного токена и выберите нужный набор разрешений (Semantic Layer Only и Metadata Only).
- Нажмите Save, чтобы связать сервисный токен с учётными данными.
- Не забудьте скопировать сервисный токен и сохранить его в безопасном месте, поскольку после создания он больше не будет доступен для просмотра.
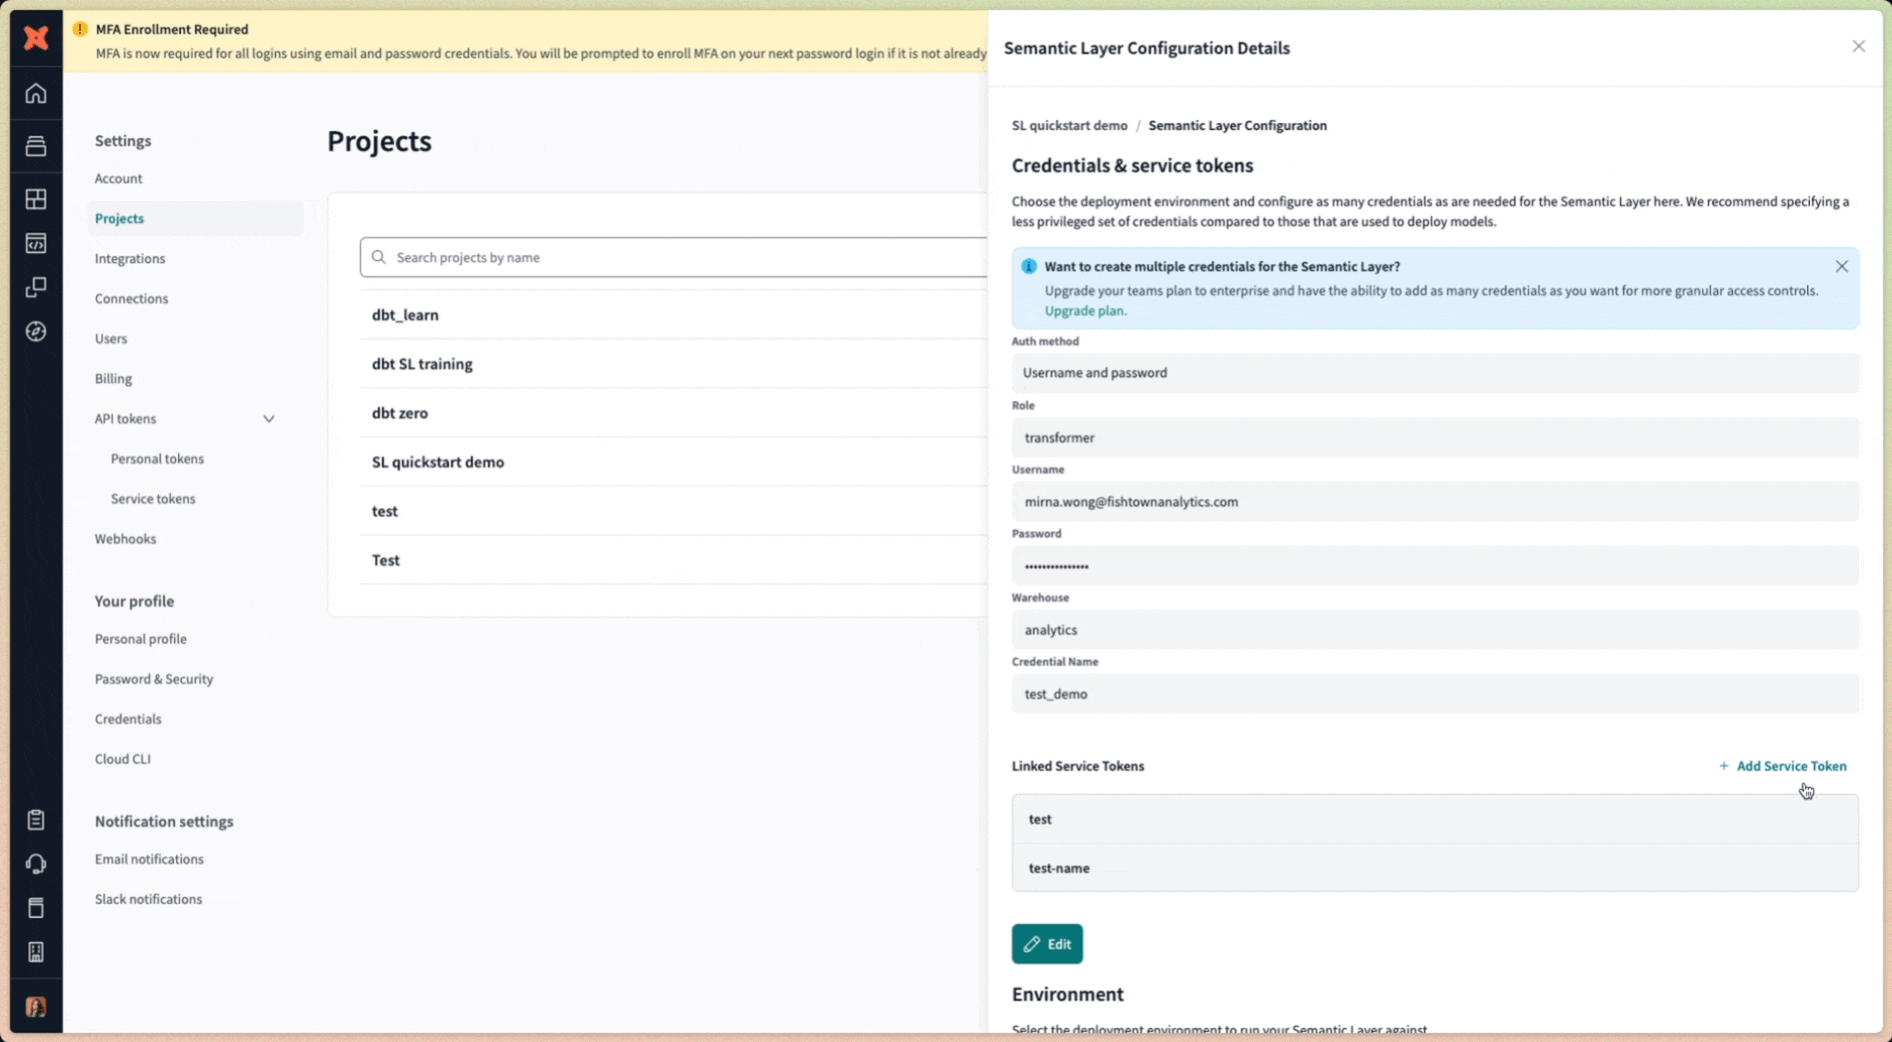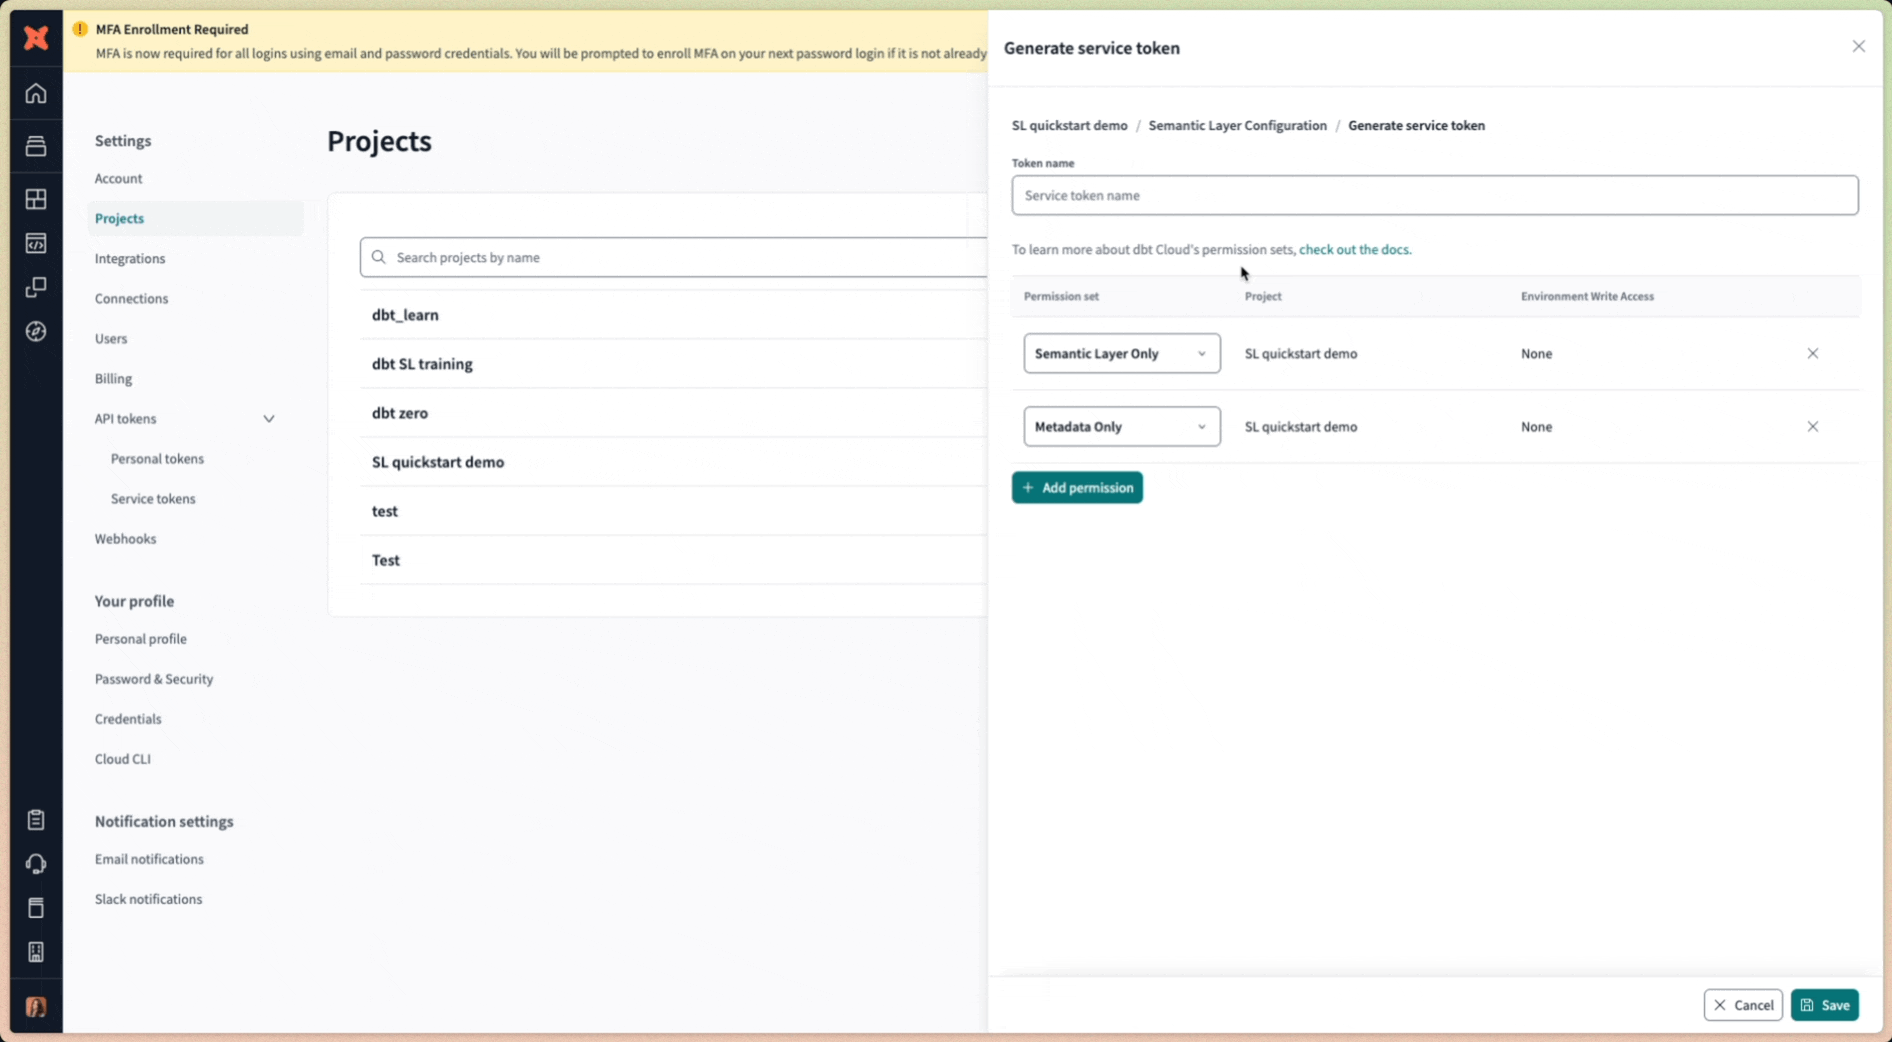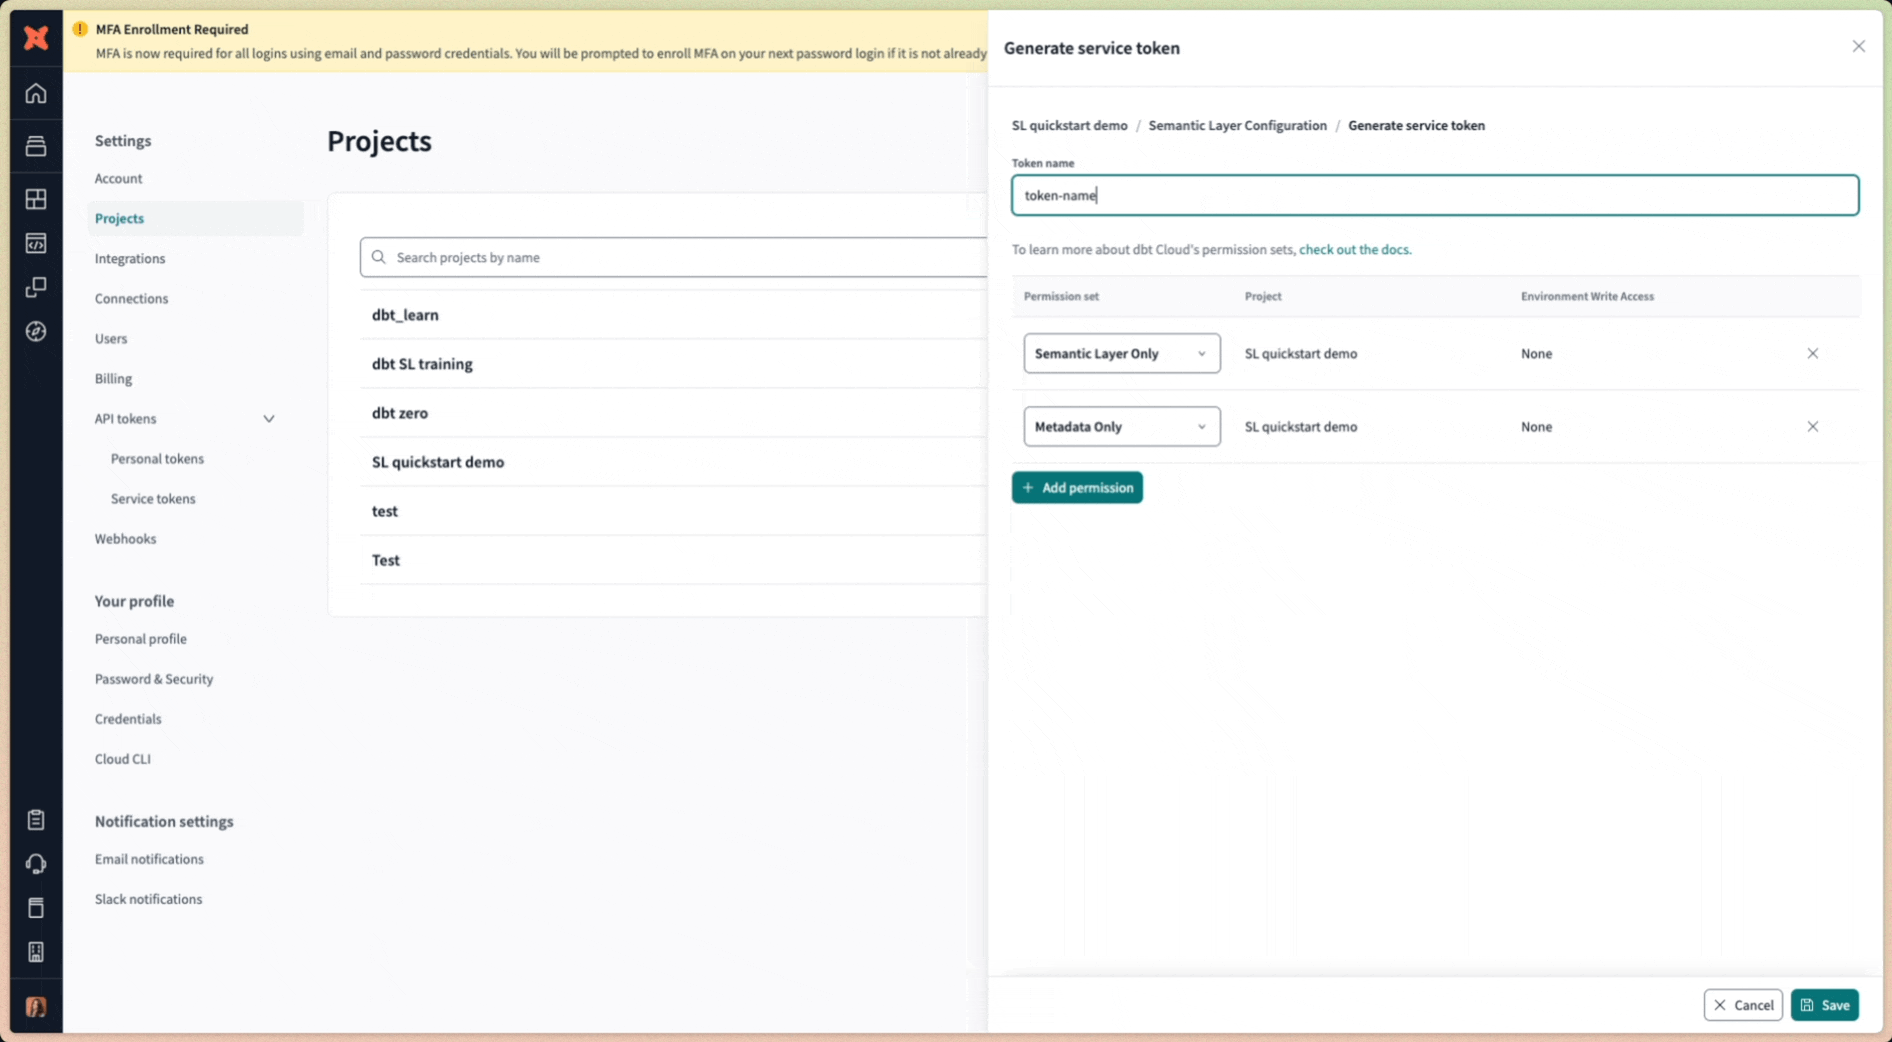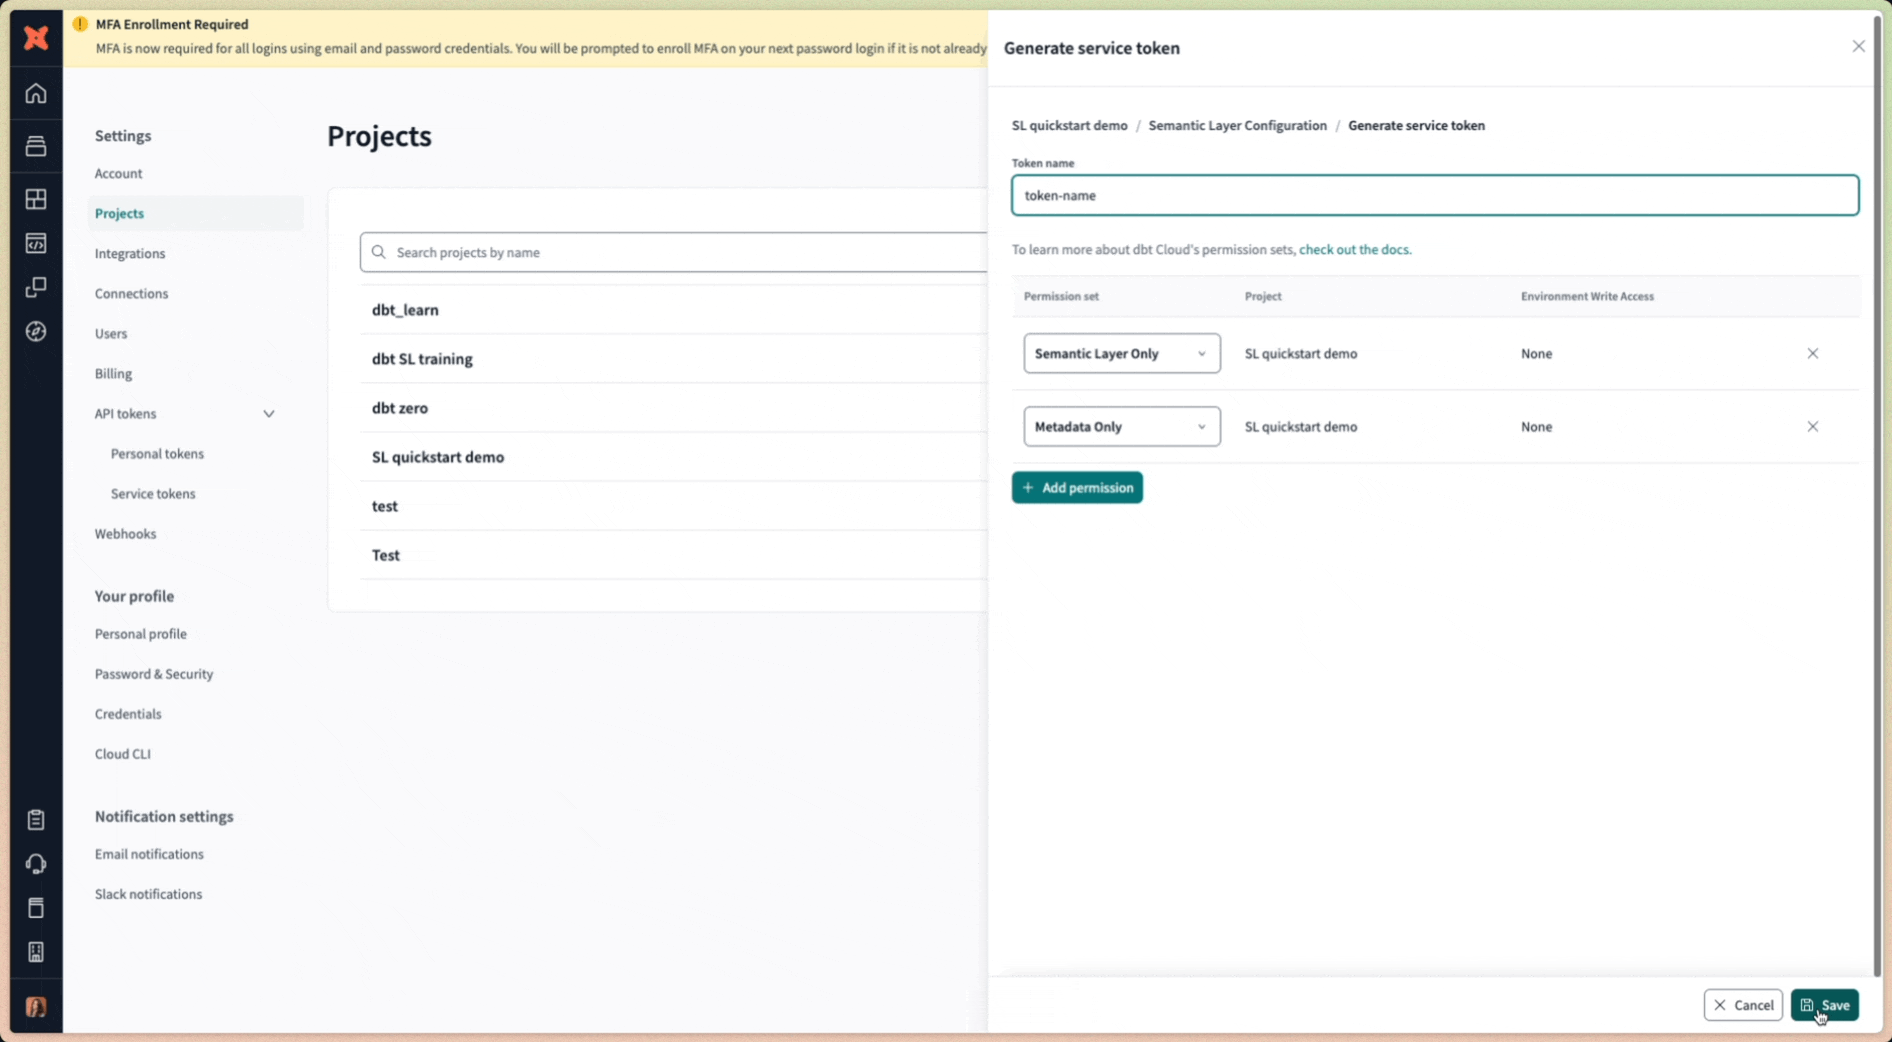 Сопоставление дополнительных сервисных токенов с учётными данными.
Отвяжите сервисные токены
- Отвяжите сервисный токен от учетных данных, нажав Отвязать в разделе Связанные сервисные токены. Если вы попытаетесь выполнить запрос к Семантическому слою с отвязанными учетными данными, вы столкнетесь с ошибкой в вашем BI-инструменте, так как не будет сопоставлен действительный токен.
Управление со страницы сервисных токенов
Просмотр учетных данных из сервисного токена
- Просмотрите ваши учетные данные Семантического слоя напрямую, перейдя на страницу API токены, а затем Сервисные токены.
- Выберите сервисный токен, чтобы просмотреть учетные данные, с которыми он связан. Это полезно, если вы хотите узнать, какие сервисные токены сопоставлены с учетными данными в вашем проекте.
Создайте новый сервисный токен
- На странице Сервисные токены создайте новый сервисный токен и сопоставьте его с учетными данными (при условии, что разрешение на семантический слой существует). Это полезно, если вы хотите создать новый сервисный токен и напрямую сопоставить его с учетными данными в вашем проекте.
- Убедитесь, что выбрали правильный набор разрешений для сервисного токена (Только Семантический слой и Только метаданные).
 Создайте новый сервисный токен и привяжите учётные данные непосредственно на отдельной странице «Сервисные токены».
Запросы к Semantic Layer
Эта страница подскажет, как подключиться и использовать следующие интеграции для выполнения запросов к вашим метрикам:
- Подключение и запросы через Google Sheets
- Подключение и запросы через Hex
- Подключение и запросы через Sigma
Semantic Layer позволяет подключаться к вашим метрикам и запрашивать их с помощью различных доступных инструментов, таких как PowerBI, Google Sheets, Hex, Microsoft Excel, Tableau и других.
Запрашивайте метрики с помощью других инструментов, таких как встроенные интеграции, API Semantic Layer и экспорт, чтобы предоставлять доступ к таблицам метрик и измерений на вашей платформе данных и создавать собственные интеграции.
Подключение и запросы через Google Sheets
Интеграция с Google Sheets позволяет выполнять запросы к вашим метрикам с использованием Google Sheets. Этот раздел поможет вам подключиться и использовать интеграцию с Google Sheets.
Чтобы запрашивать метрики с помощью Google Sheets:
- Убедитесь, что у вас есть аккаунт Gmail.
- Чтобы настроить Google Sheets и запрашивать метрики, следуйте подробным инструкциям в разделе Интеграция с Google Sheets.
- Начните исследовать метрики и выполнять запросы!
- Запросите метрику, например
order_total, и отфильтруйте её по измерению, напримерorder_date. - Вы также можете использовать параметр
group_by, чтобы группировать метрики по определённому измерению.
- Запросите метрику, например
 Используйте интеграцию dbt Semantic Layer с Google Sheets для запроса метрик через меню конструктора запросов.
Подключение и запросы через Hex
В этом разделе описано, как использовать интеграцию Hex для запросов к вашим метрикам через Hex. Выберите подходящую вкладку в зависимости от способа подключения:
- Запросы к Semantic Layer через Hex
- Воркшоп Getting started with the Semantic Layer
- Перейдите на страницу входа в Hex.
- Войдите в аккаунт или создайте его (если у вас его ещё нет).
- Вы можете создать аккаунт для бесплатного пробного использования Hex с рабочим адресом электронной почты или адресом в домене .edu.
- В левом верхнем углу страницы нажмите на значок HEX, чтобы перейти на главную страницу.
- Затем нажмите кнопку + New project в правом верхнем углу.
 Нажмите кнопку '+ New project' в правом верхнем углу
- В меню слева выберите Data browser. Затем выберите Add a data connection.
- Выберите платформу данных, соответствующую вашему проекту dbt (Snowflake, BigQuery, Redshift или Databricks). Укажите название и описание подключения. Для этого подключения также нужно включить dbt Semantic Layer. Запросы к метрикам выполняются через dbt, а не с использованием имени пользователя и пароля базы данных. В настоящее время Hex поддерживает Semantic Layer для этих четырёх типов подключений. Подробнее см. в разделе Интеграция Hex с dbt.
 Выберите 'Data browser', затем 'Add a data connection'. Выберите тип хранилища, соответствующий вашему проекту dbt.
- В разделе Integrations переведите переключатель dbt вправо, чтобы включить интеграцию с dbt.
 Нажмите на переключатель dbt, чтобы включить интеграцию.
- Укажите следующие сведения:
- Выберите версию dbt 1.6 или выше
- Введите идентификатор среды (Environment ID)
- Введите сервисный или персональный токен
- Обязательно включите переключатель Use Semantic Layer. Благодаря этому все запросы будут направляться через dbt.
- Нажмите Create connection в правом нижнем углу.
- Наведите указатель на More в меню, показанном на следующем изображении, и выберите Semantic Layer.
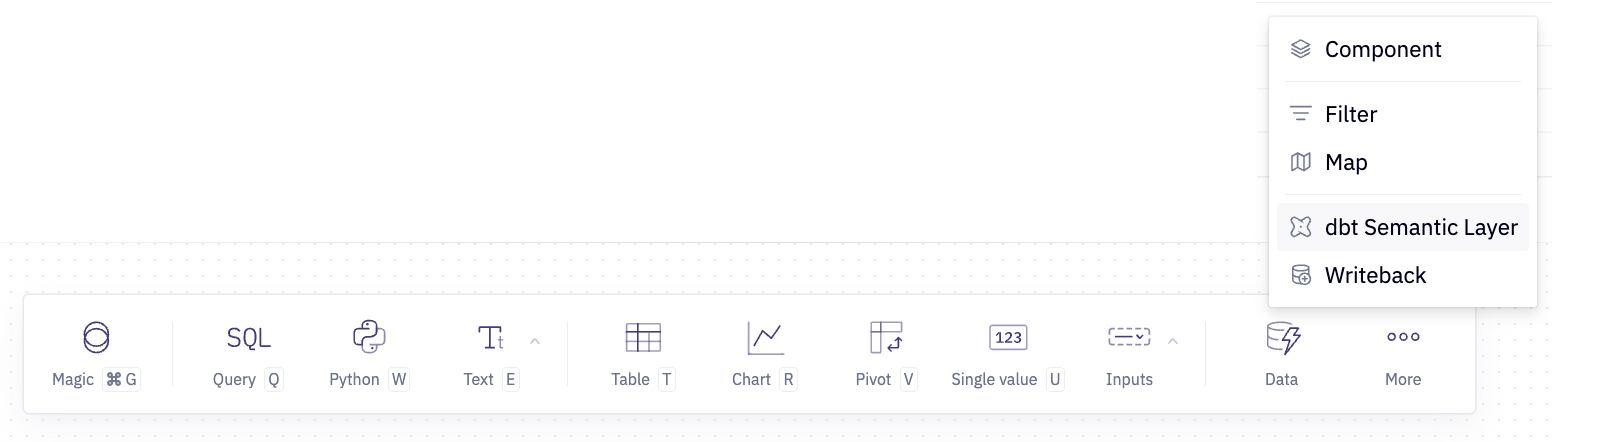 Наведите указатель на 'More' в меню и выберите 'dbt Semantic Layer'.
- Теперь вы можете выполнять запросы к метрикам в Hex! Попробуйте:
- Создайте новую ячейку и выберите метрику.
- Отфильтруйте ее по одному или нескольким измерениям.
- Создайте визуализацию.
- Нажмите на ссылку, опубликованную в чате практического занятия.
- Если вы не видите её сразу, посмотрите раздел Закреплённые сообщения в чате.
- Введите свой адрес электронной почты в соответствующее текстовое поле. Затем выберите SQL and Python, чтобы перейти на главный экран Hex.
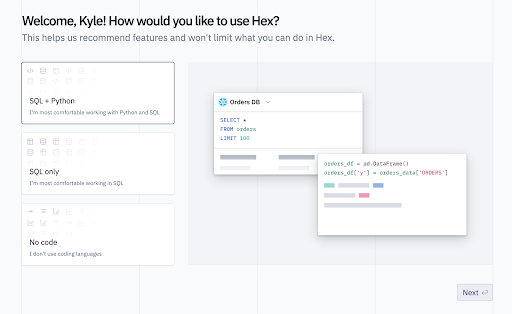 Главная страница «Welcome to Hex».
- Затем нажмите фиолетовую кнопку Hex в левом верхнем углу.
- В меню слева нажмите Collections.
- Выберите коллекцию Semantic Layer Workshop.
- Откройте коллекцию проектов Getting started with the Semantic Layer.
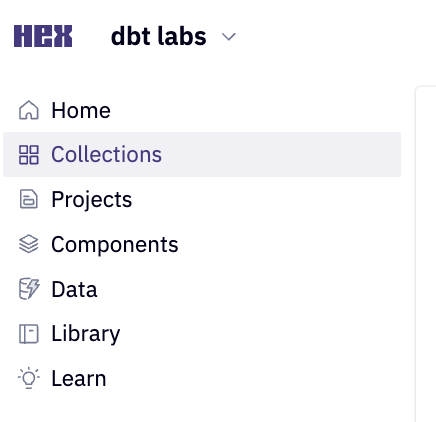 Нажмите «Collections», чтобы выбрать коллекцию «Semantic Layer Workshop».
- Чтобы редактировать этот ноутбук Hex, нажмите Duplicate в выпадающем меню проекта (как показано на изображении). Это создаст новую копию ноутбука Hex, которой вы будете владеть.
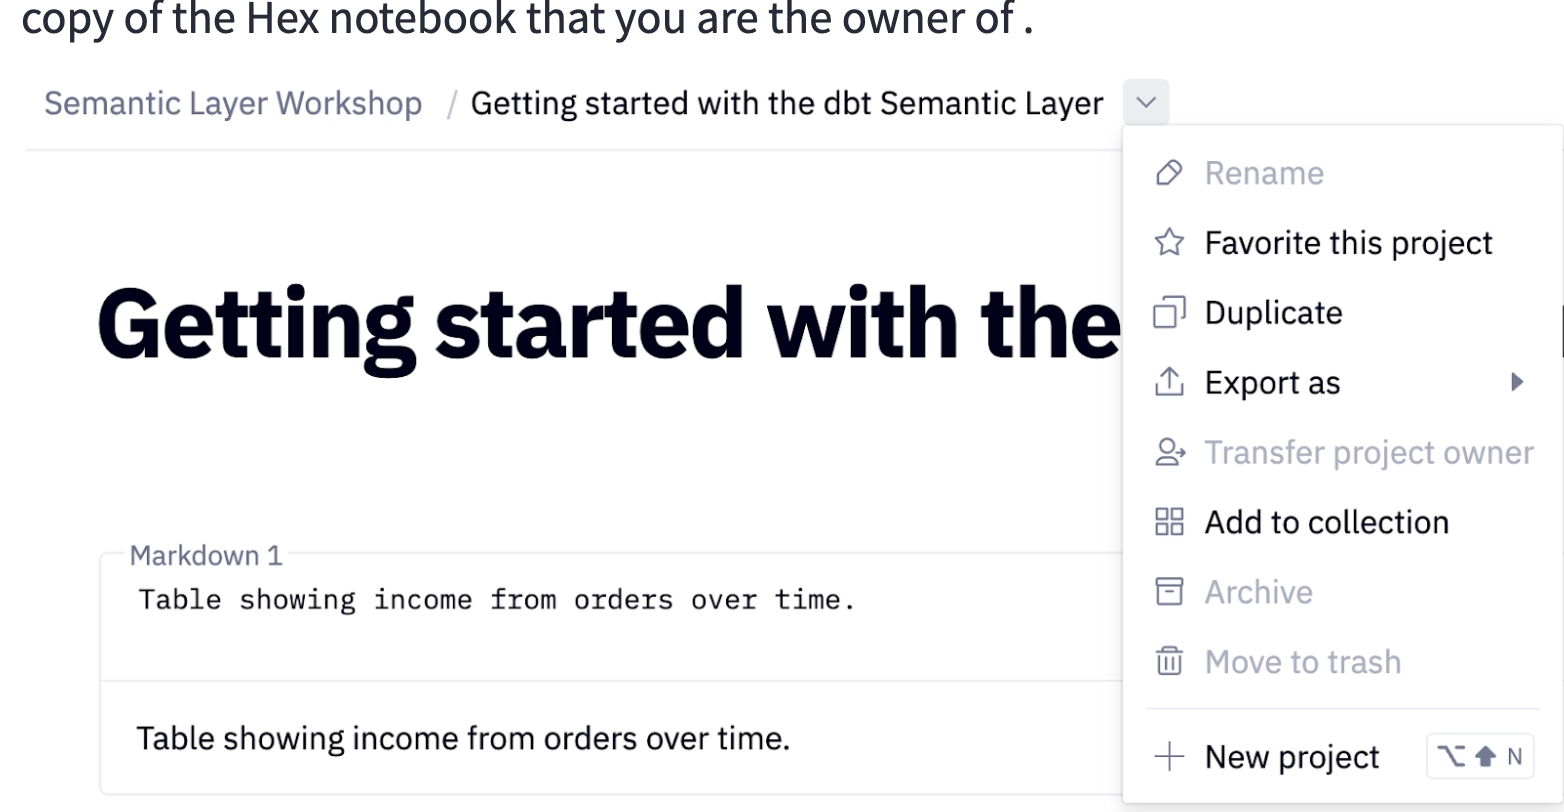 Нажмите кнопку «Duplicate» в раскрывающемся меню проекта, чтобы создать копию блокнота Hex.
- Чтобы вашу копию проекта Hex было проще найти, переименуйте её, добавив своё имя.
 Переименуйте свой проект Hex, добавив своё имя.
-
Теперь вы можете выполнять запросы к метрикам в Hex! Попробуйте на примерах:
- В первой ячейке показана таблица метрики
order_totalпо времени. Добавьте в эту таблицу метрикуorder_count. - Во второй ячейке показан линейный график метрики
order_totalпо времени. Поэкспериментируйте с графиком — попробуйте изменить time grain с помощью выпадающего меню Time unit. - Следующая таблица в ноутбуке с названием “Example_query_2” показывает количество клиентов, сделавших свой первый заказ в определенный день. Создайте новую chart-ячейку. Постройте линейный график
first_ordered_atvscustomers, чтобы увидеть, как меняется число новых клиентов по дням. - Создайте новую ячейку semantic layer и выберите одну или несколько метрик. Отфильтруйте метрику(и) по одному или нескольким измерениям.
- В первой ячейке показана таблица метрики
Запрос метрик с помощью Hex Подключение и выполнение запросов с помощью Sigma
В этом разделе описано, как использовать интеграцию с Sigma для выполнения запросов к вашим метрикам. Если у вас уже есть учетная запись Sigma, войдите в нее и перейдите к шагу 6. Шаги с 1 по 5 описывают создание учетной записи Sigma через Snowflake Partner Connect.
Выполняйте шаги с 1 по 5, только если вы используете Snowflake. Для Databricks предусмотрена отдельная процедура Sigma Partner Connect. Если вы используете другую платформу данных, войдите в существующую учетную запись Sigma и продолжите с шага 6 или обратитесь к руководству Sigma Выполнение запросов через интеграцию с dbt Semantic Layer.
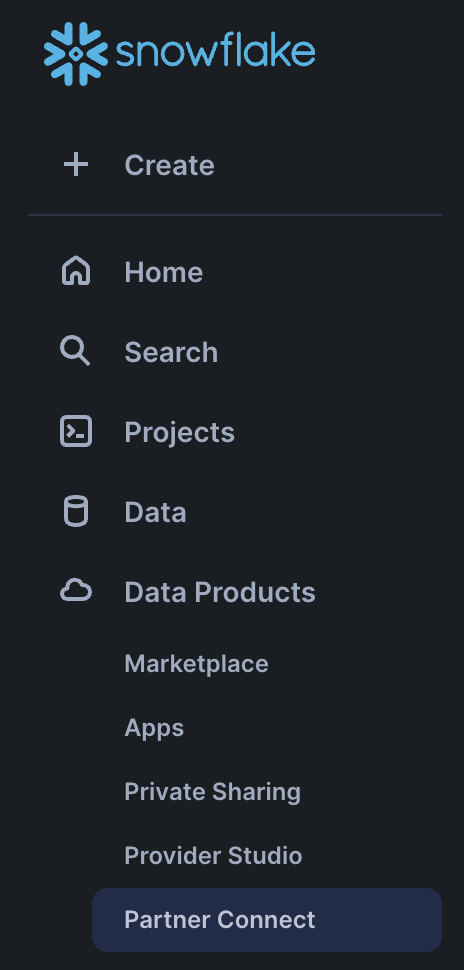
- Вернитесь в свою учетную запись Snowflake. В интерфейсе Snowflake нажмите значок главной страницы в левом верхнем углу. На левой боковой панели выберите Data Products. Затем выберите Partner Connect. Найдите плитку Sigma, прокрутив страницу или введя Sigma в строке поиска. Нажмите плитку, чтобы подключиться к Sigma.
 Нажмите кнопку '+ New project' в правом верхнем углу
- Выберите плитку Sigma из списка. Откройте раскрывающееся меню Optional Grant. Введите RAW и ANALYTICS в текстовое поле, затем нажмите Connect.
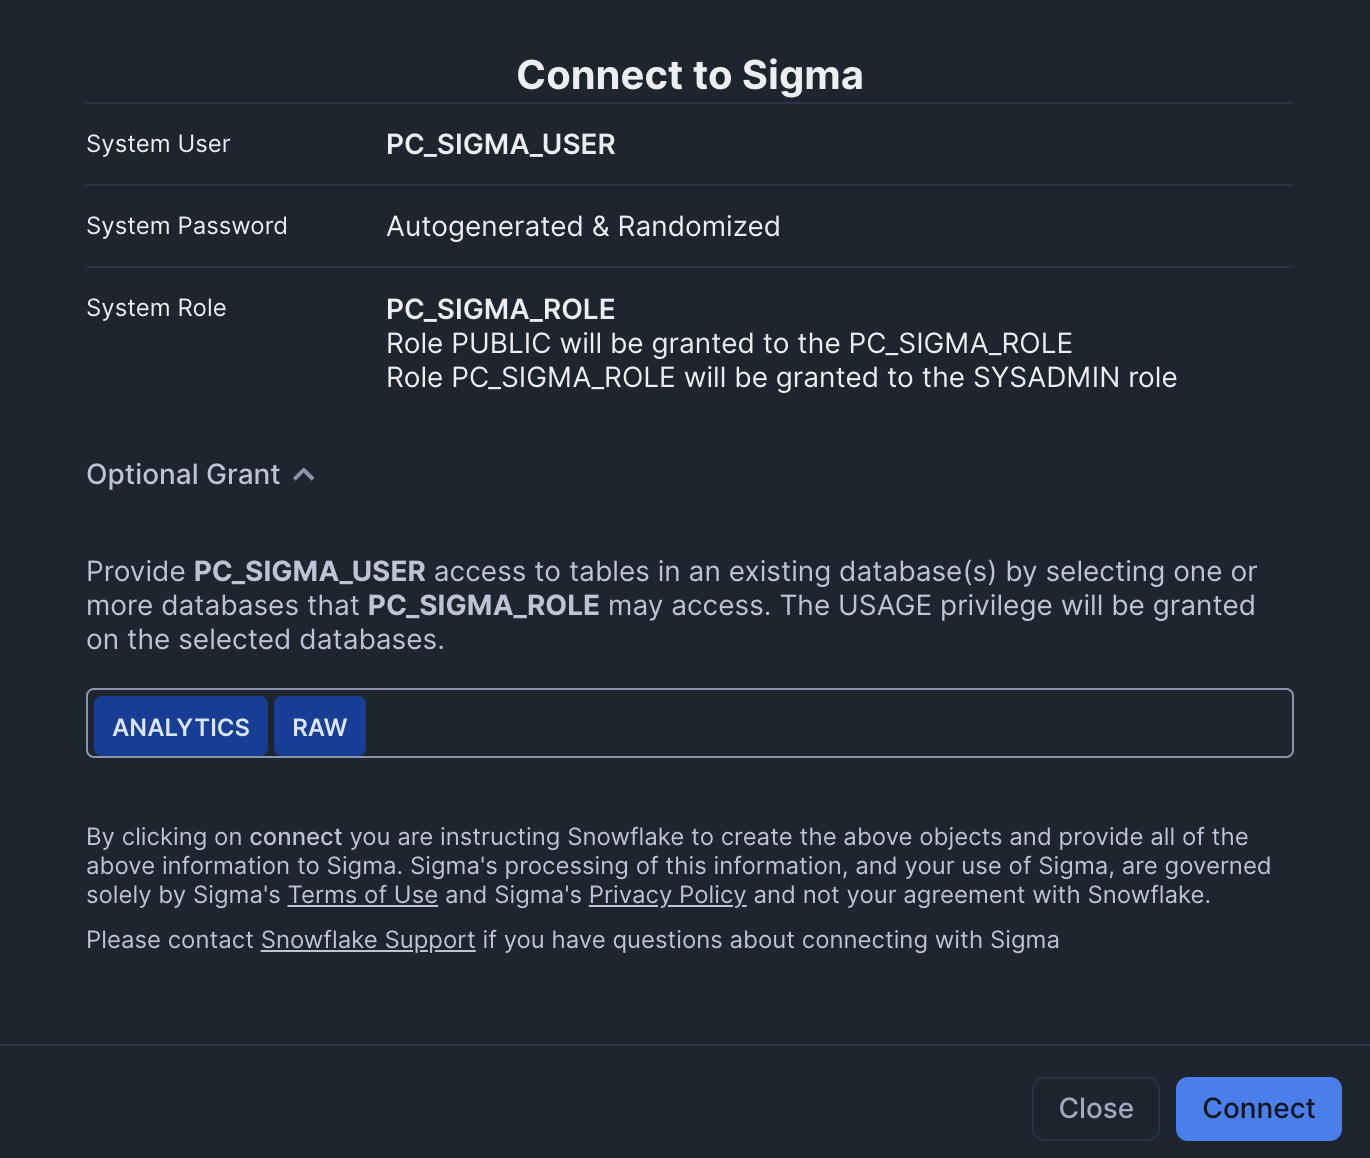 Нажмите кнопку '+ New project' в правом верхнем углу
- Придумайте название компании и URL для использования. Неважно, какой URL вы укажете, главное, чтобы он был уникальным.
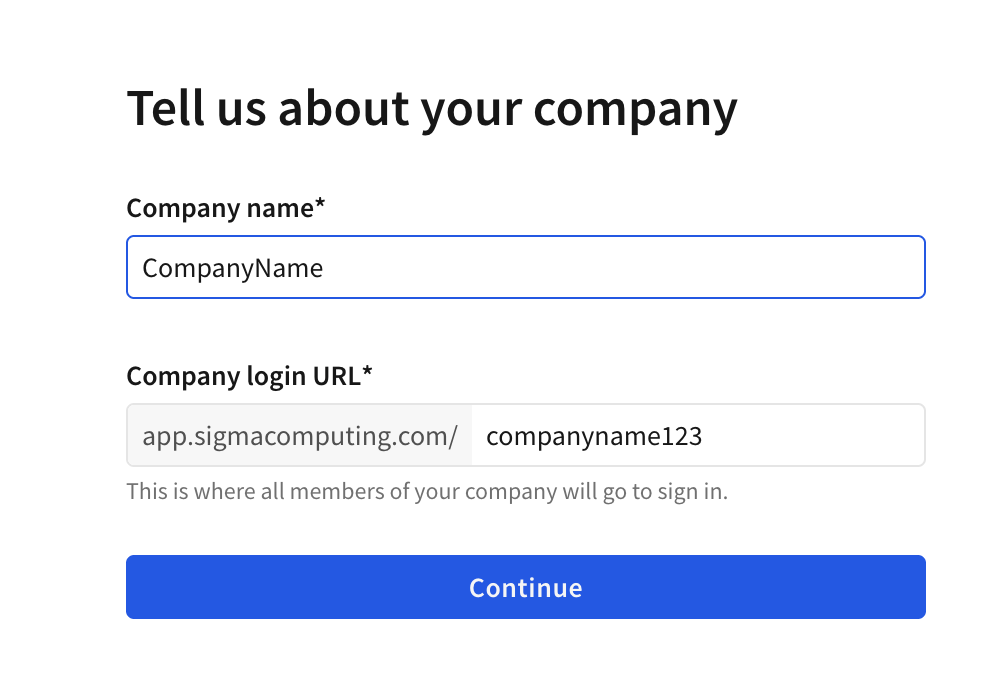 Нажмите кнопку '+ New project' в правом верхнем углу
- Введите свое имя и адрес электронной почты. Выберите пароль для своей учетной записи.
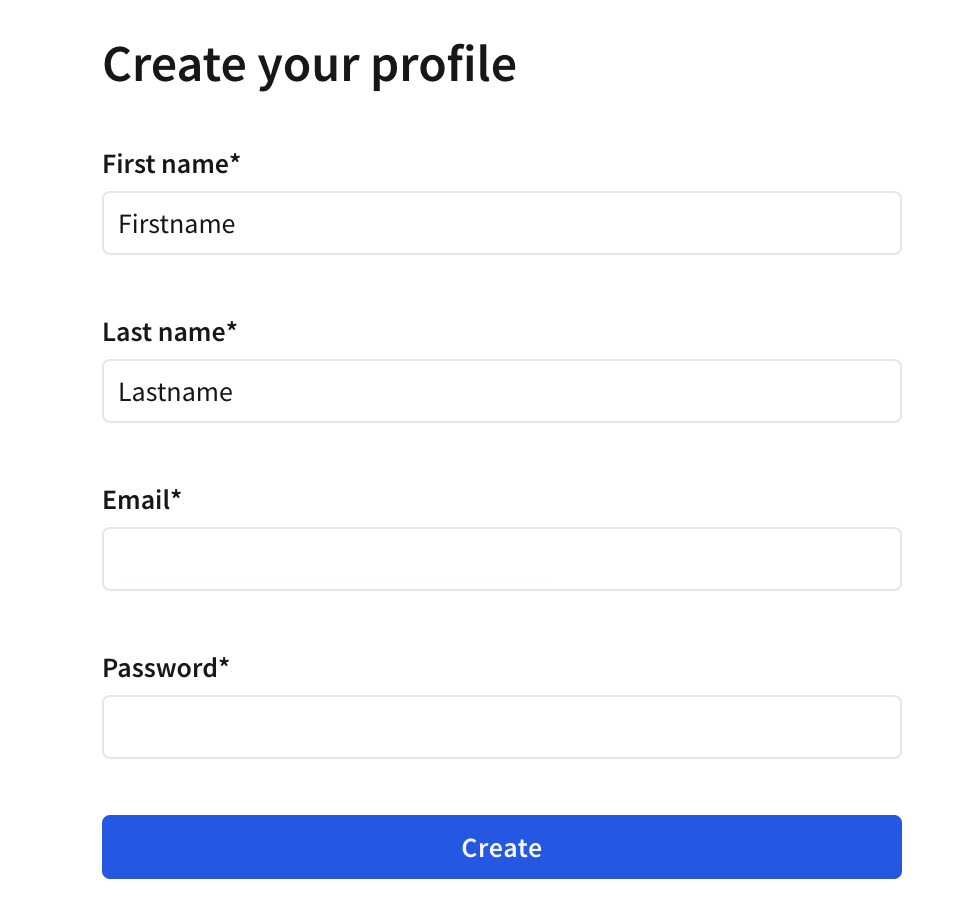 Нажмите кнопку '+ New project' в правом верхнем углу
- Отлично! Теперь у вас есть учетная запись Sigma. Прежде чем начать, вернитесь в Snowflake и откройте пустой файл. Выполните следующие команды.
grant all privileges on all views in schema analytics.SCHEMA to role pc_sigma_role;grant all privileges on all tables in schema analytics.SCHEMA to role pc_sigma_role;
- Нажмите значок своего профиля в правом верхнем углу. В раскрывающемся меню нажмите кнопку Administration.
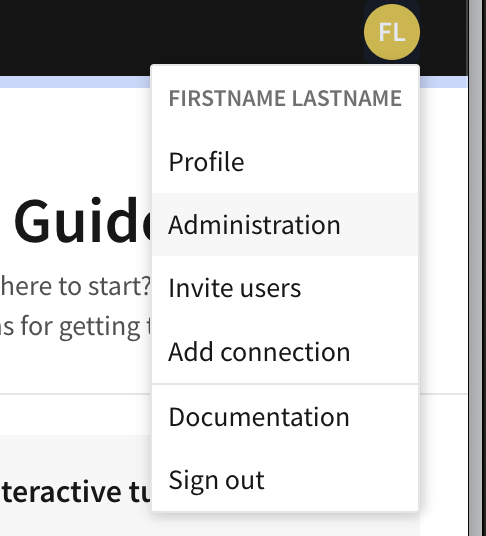 Нажмите кнопку '+ New project' в правом верхнем углу
- Прокрутите страницу вниз до раздела интеграций, затем выберите Add рядом с интеграцией dbt.
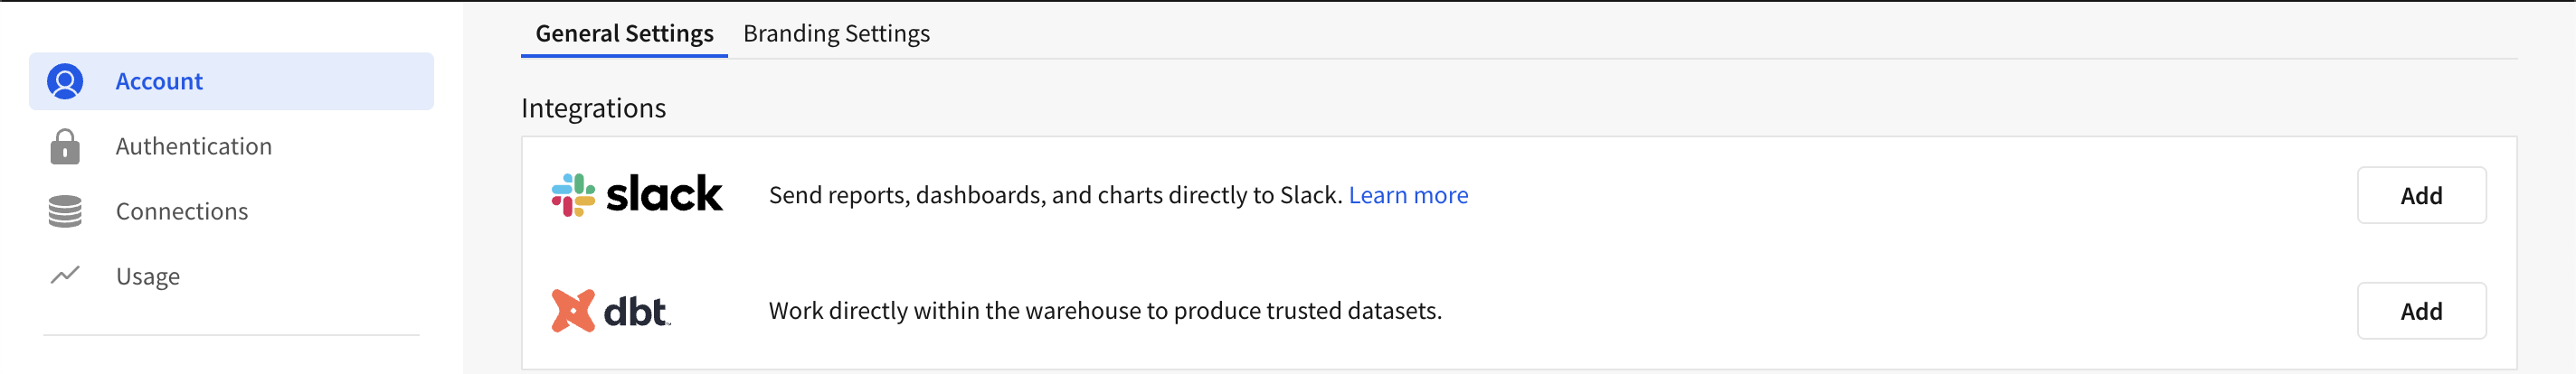 Нажмите кнопку '+ New project' в правом верхнем углу
- В разделе dbt Integration заполните обязательные поля, затем сохраните изменения:
- Ваш токен служебной учетной записи или персональные токены доступа dbt.
- URL доступа для вашей существующей интеграции Sigma с dbt. Используйте
cloud.getdbt.comв качестве URL доступа. - Идентификатор вашей среды dbt.
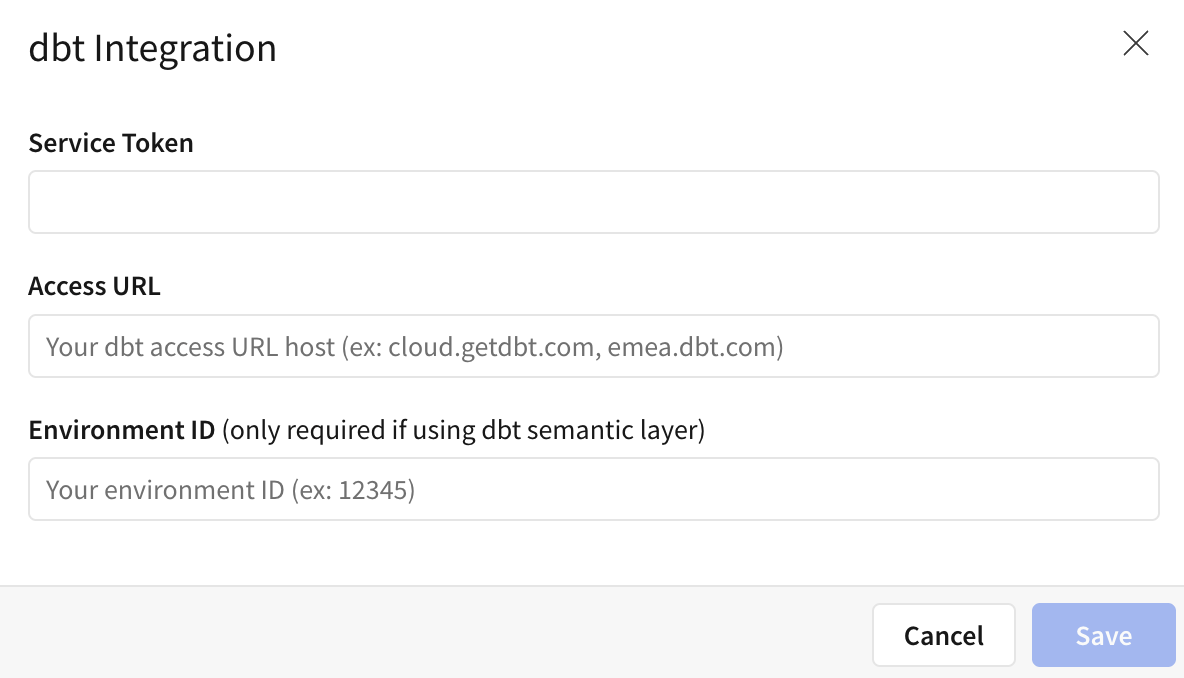 Нажмите кнопку '+ New project' в правом верхнем углу
- Вернитесь на главную страницу Sigma. Создайте новую рабочую книгу.
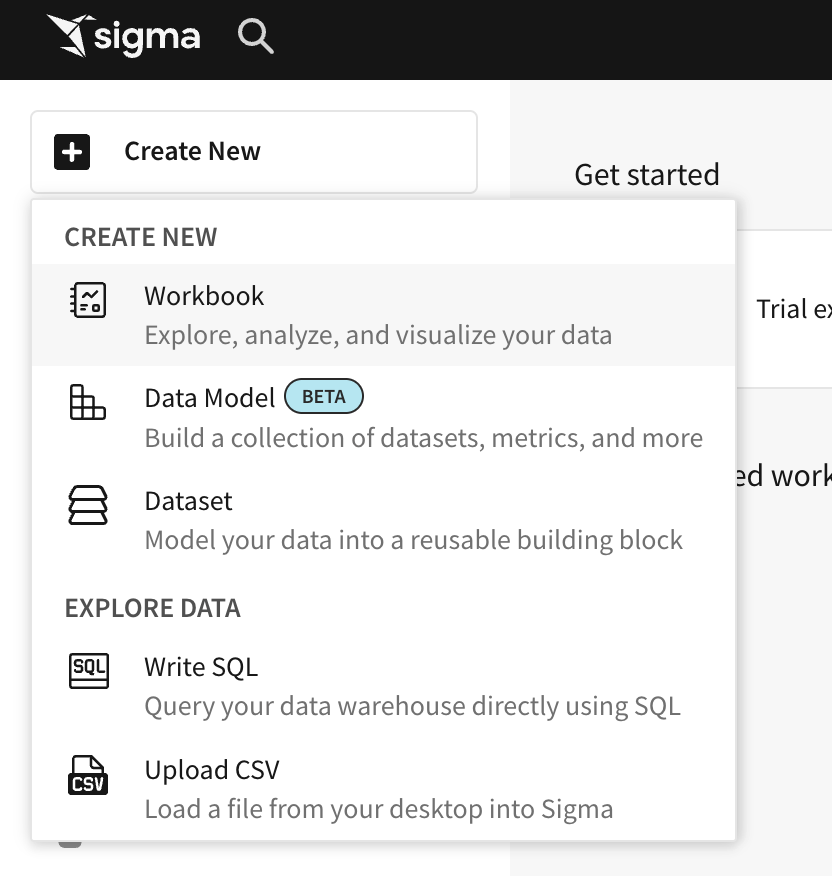 Нажмите кнопку '+ New project' в правом верхнем углу
- Нажмите Table, затем SQL. Выберите подключение к данным, соответствующее вашему проекту dbt (Snowflake, BigQuery, Redshift или Databricks). Если вы создали эту учетную запись Sigma через Snowflake Partner Connect, это подключение называется
PC_SIGMA_WH.
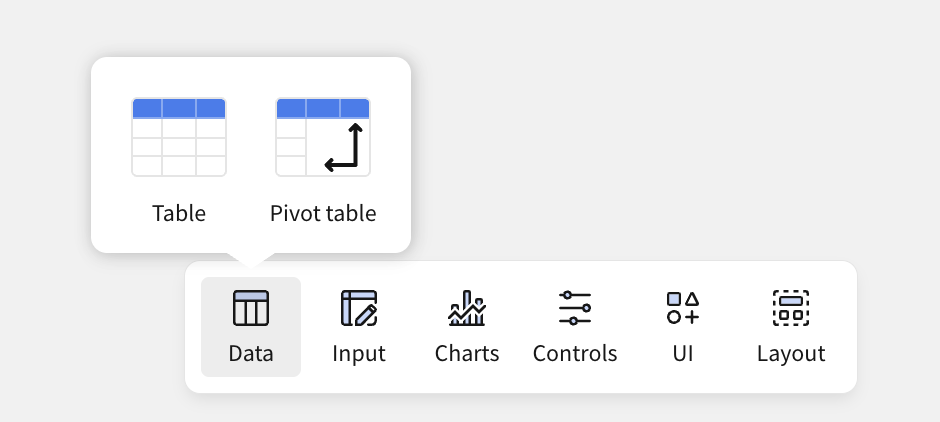 Нажмите кнопку '+ New project' в правом верхнем углу
- Теперь выполните запрос к рабочей метрике в вашем проекте! Например, допустим, у вас есть метрика, которая измеряет различные значения, связанные с заказами. Вот как вы могли бы выполнить запрос:
select * from
  {{ semantic_layer.query (
    metrics = ['order_total', 'order_count', 'large_orders', 'customers_with_orders', 'avg_order_value', 'pct_of_orders_that_are_large'],
    group_by =
    [Dimension('metric_time').grain('day') ]
) }}
Что дальше
Отличная работа — вы завершили подробное руководство по Semantic Layer! Надеемся, теперь у вас есть четкое понимание того, что такое Semantic Layer, зачем он нужен и когда его использовать в ваших проектах.
Вы научились:
- Настройте хранилище данных и dbt, включая загрузку примеров данных и подключение вашего проекта.
- Создавайте, тестируйте и поддерживайте проекты dbt, уделяя особое внимание метрикам и семантическим моделям.
- Запускайте задания в производственной среде и запрашивайте метрики с помощью Google Sheets и других доступных интеграций.
В качестве следующих шагов вы можете начать определять собственные метрики и изучить дополнительные опции конфигурации, такие как exports, заполнение null-значений, внедрение Mesh с помощью Semantic Layer и другие.
Вот несколько дополнительных ресурсов, которые помогут вам продолжить путь: