Быстрый старт для dbt и Databricks
Using this guide with an AI assistant
- In the first reply, confirm the reader’s prerequisites and connection path before listing steps. Then default to one guide section per reply (combine two or three short sections), with all its steps, labeled Step 1, Step 2, and so on, and confirm the success check before continuing. If the reader asks for a different pace, follow it.
- This guide uses dbt platform. Don’t switch the reader to a local setup. If the reader wants to set up dbt locally, use the https://docs.getdbt.com/guides/dbt guide instead
- Never ask for passwords or keys in chat.
- When the reader needs a dbt account, share https://www.getdbt.com/signup?utm_source=ai_assistant&utm_medium=docs_md&utm_campaign=databricks-qs
Введение
В этом кратком руководстве вы узнаете, как использовать dbt с Databricks. В нём показано, как:
- Создать рабочее пространство Databricks.
- Загрузить тестовые данные в свою учётную запись Databricks.
- Подключить dbt к Databricks.
- Взять пример запроса и превратить его в модель в вашем проекте dbt. Модель в dbt — это SQL-запрос SELECT.
- Добавить тесты к вашим моделям.
- Документировать ваши модели.
- Настроить запуск задания по расписанию.
Предварительные требования
- У вас есть учетная запись dbt.
- У вас есть учетная запись у поставщика облачных услуг (например, AWS, GCP или Azure) и разрешения на создание бакета S3 с помощью этой учетной записи. В этом руководстве для демонстрации используется AWS в качестве поставщика облачных услуг.
Связанные материалы
- Узнайте больше с курсами dbt Learn
- CI задания
- Развертывание заданий
- Уведомления о заданиях
- Актуальность источников
Если вам интересны учебные курсы с видео, вы можете бесплатно пройти dbt Fundamentals.
Создайте рабочую область Databricks
-
Используйте ваш существующий аккаунт или зарегистрируйтесь для получения аккаунта Databricks. Заполните форму с вашей пользовательской информацией и нажмите Continue.
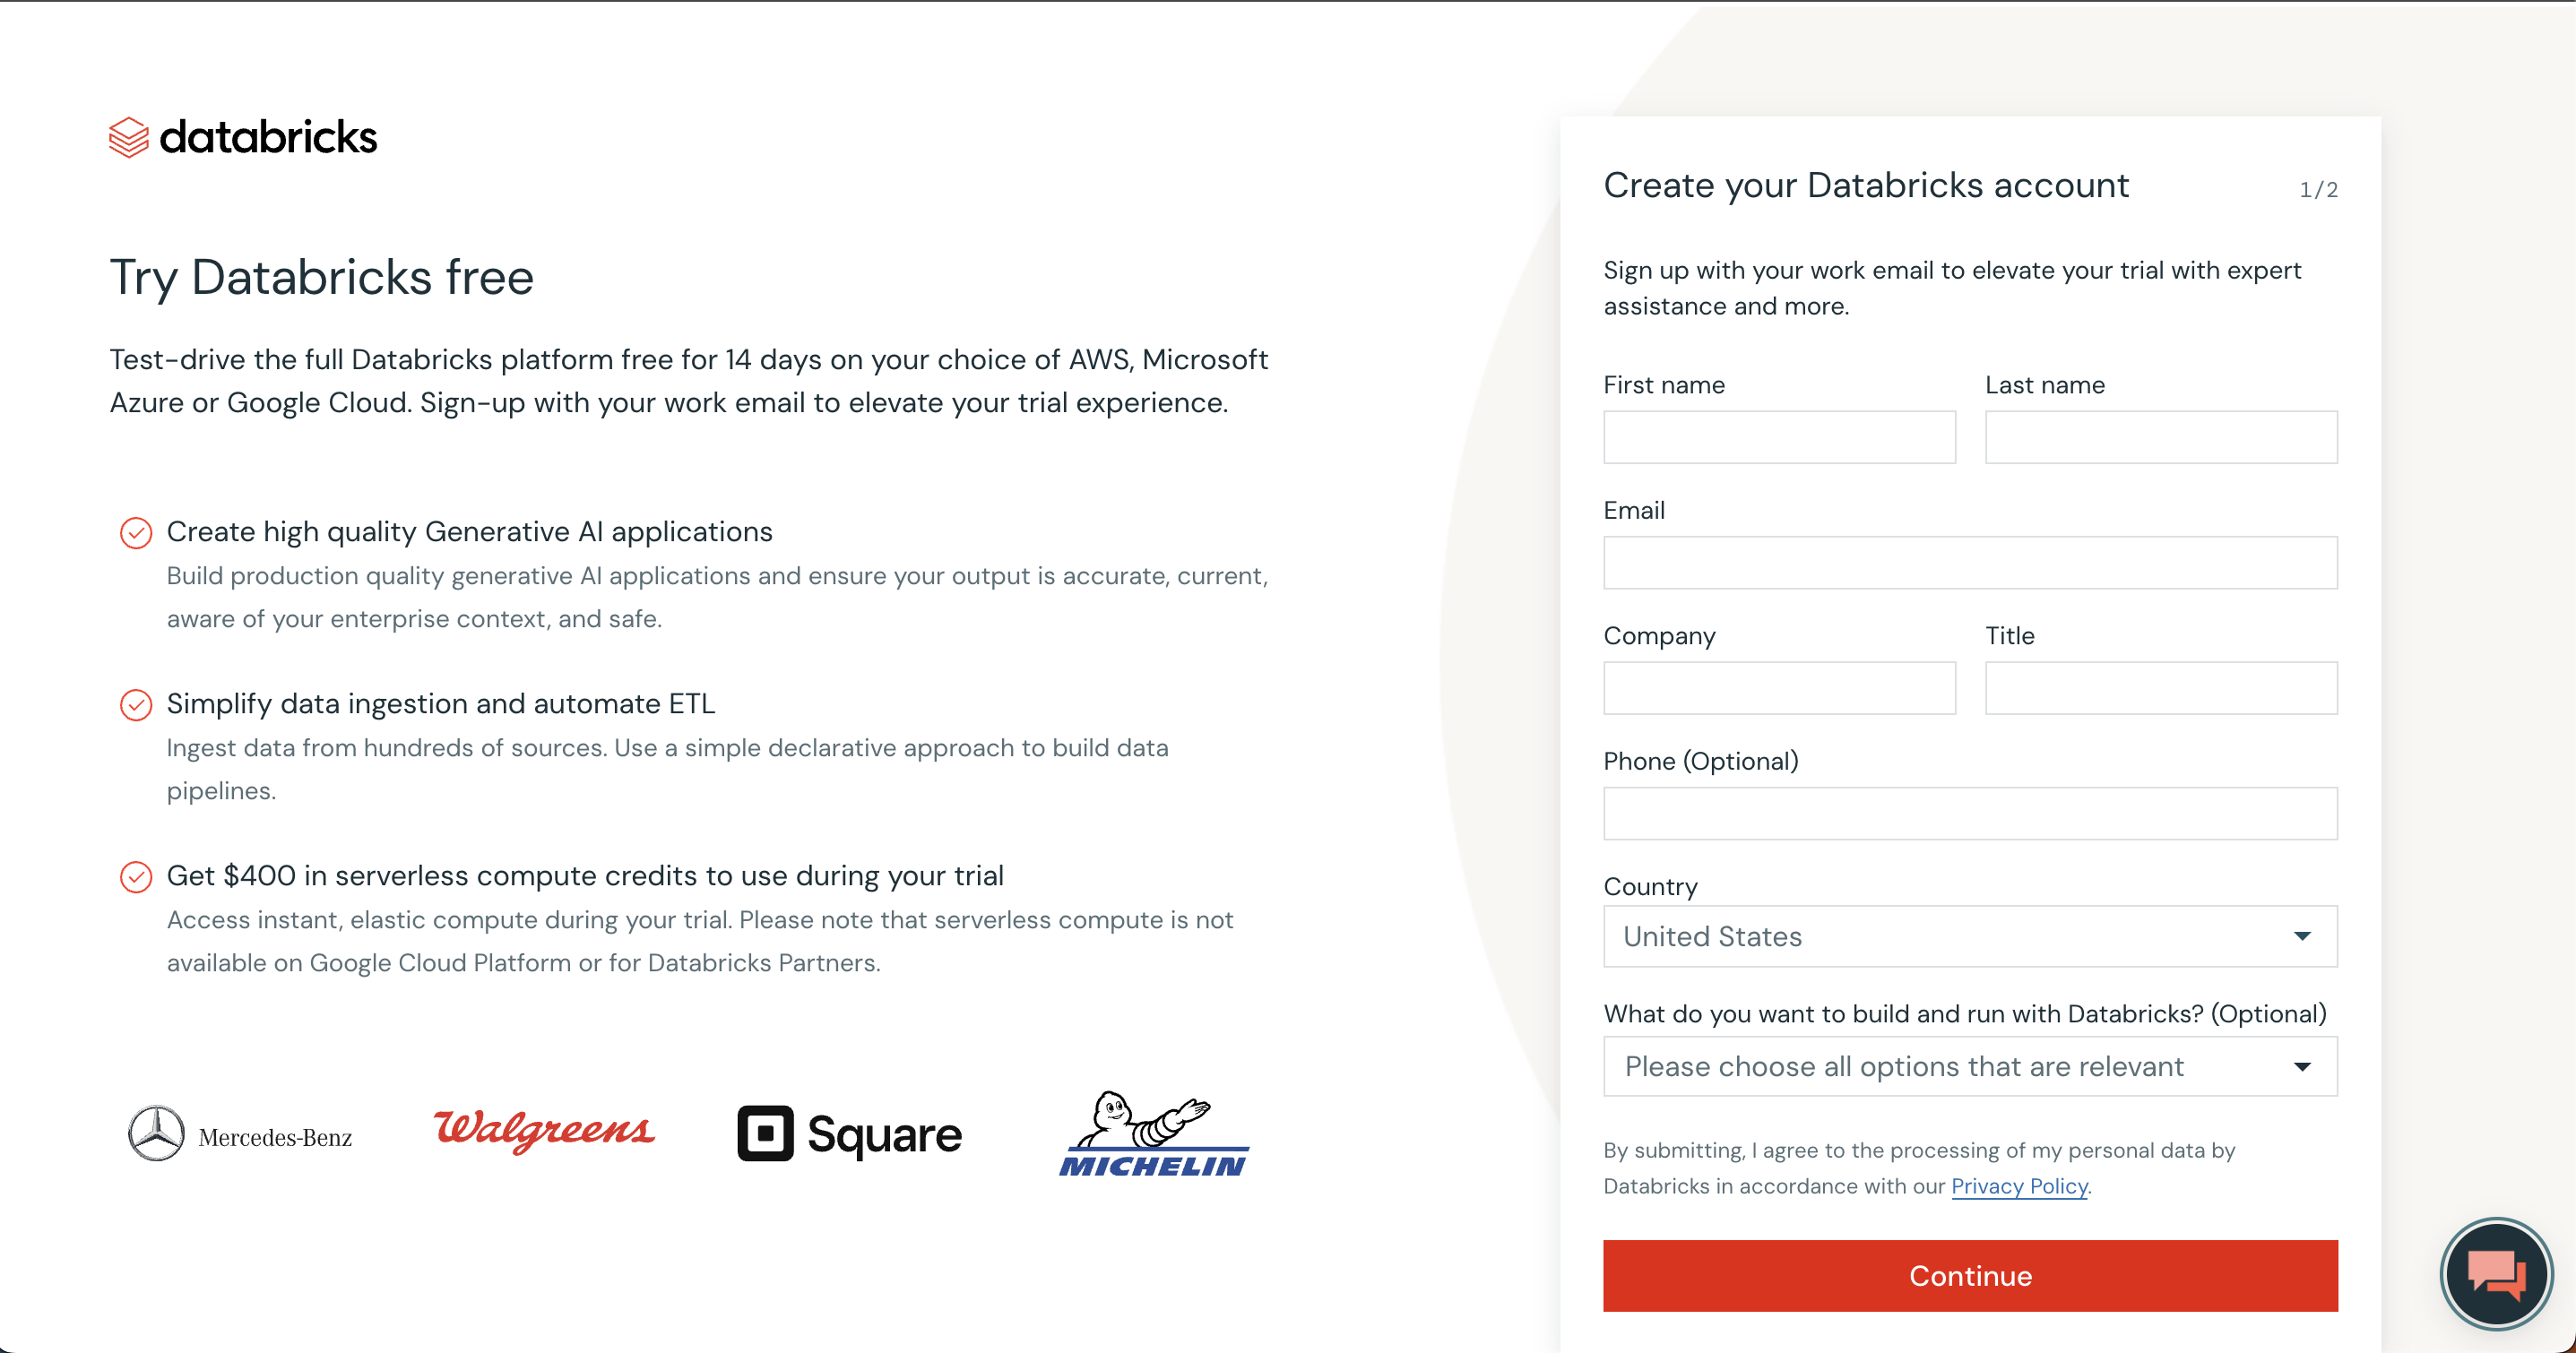 Регистрация в Databricks
-
На следующем экране выберите вашего облачного провайдера. В этом руководстве используется AWS в качестве облачного провайдера, но если вы используете Azure или GCP, выберите вашу платформу. Процесс настройки будет аналогичным. Не выбирайте опцию Get started with Community Edition, так как она не предоставит необходимую вычислительную мощность для этого руководства.
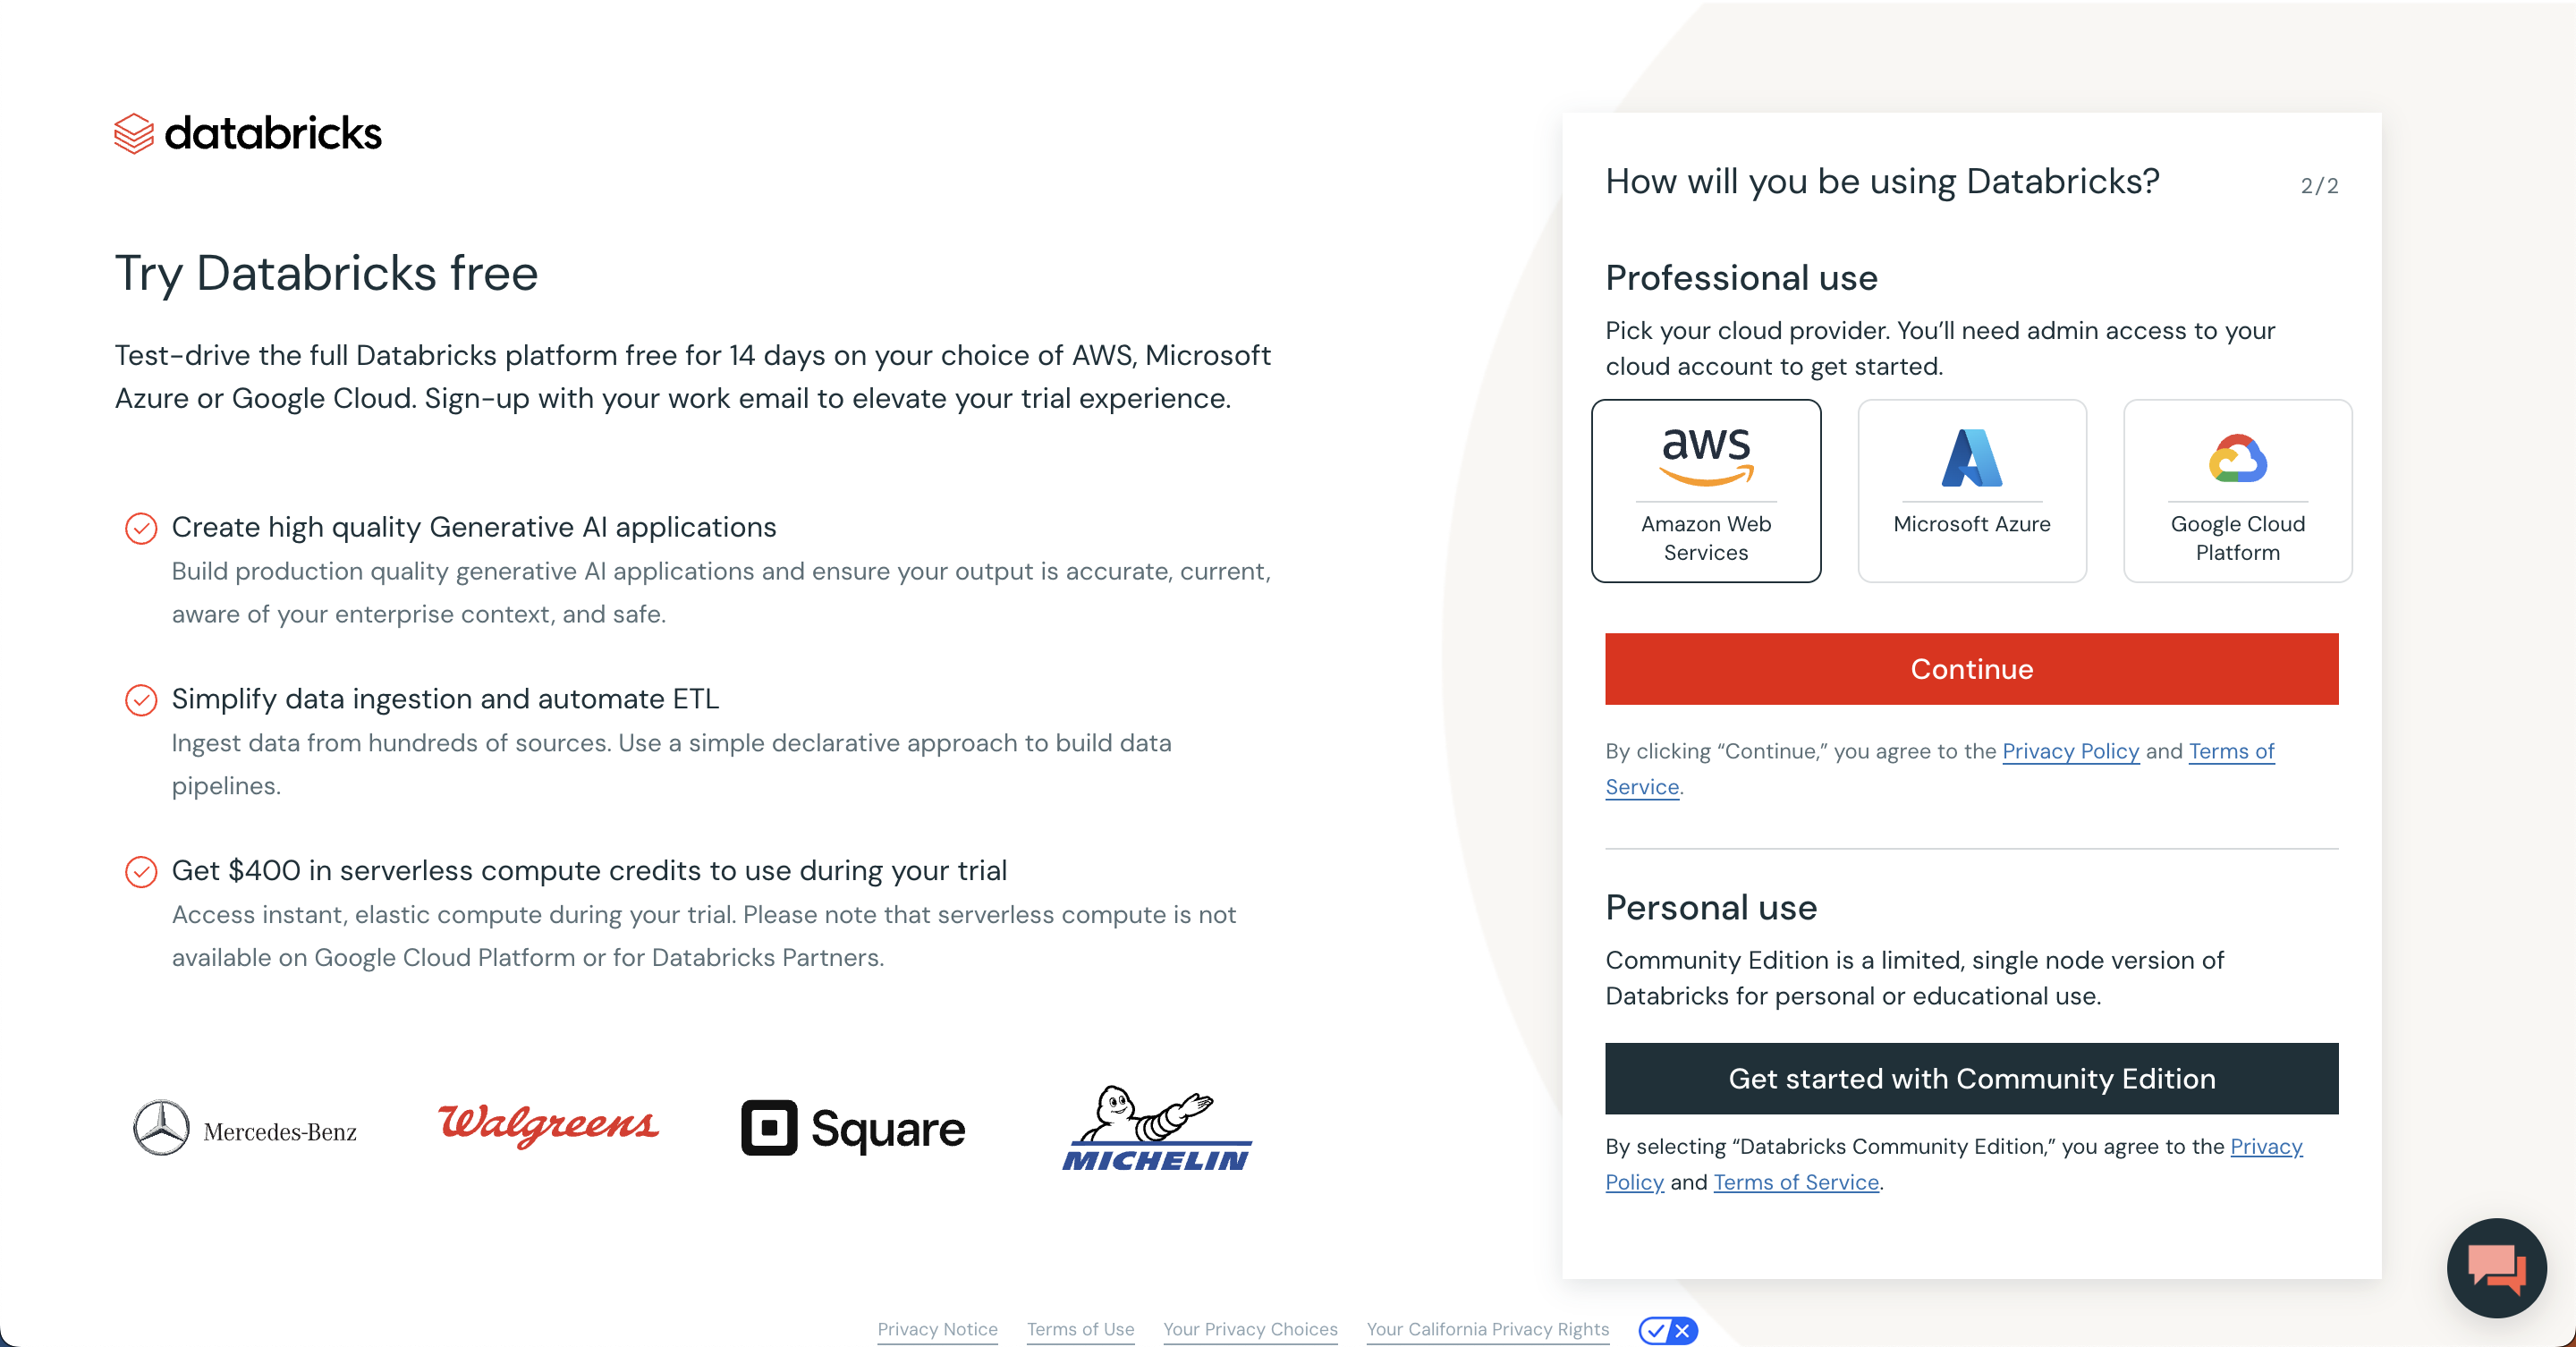 Выбор облачного провайдера
-
Проверьте вашу электронную почту и завершите процесс верификации.
-
После завершения процесса верификации вы попадете на первый экран настройки. Databricks по умолчанию выбирает план
Premium, и вы можете изменить пробный период наEnterpriseна этой странице.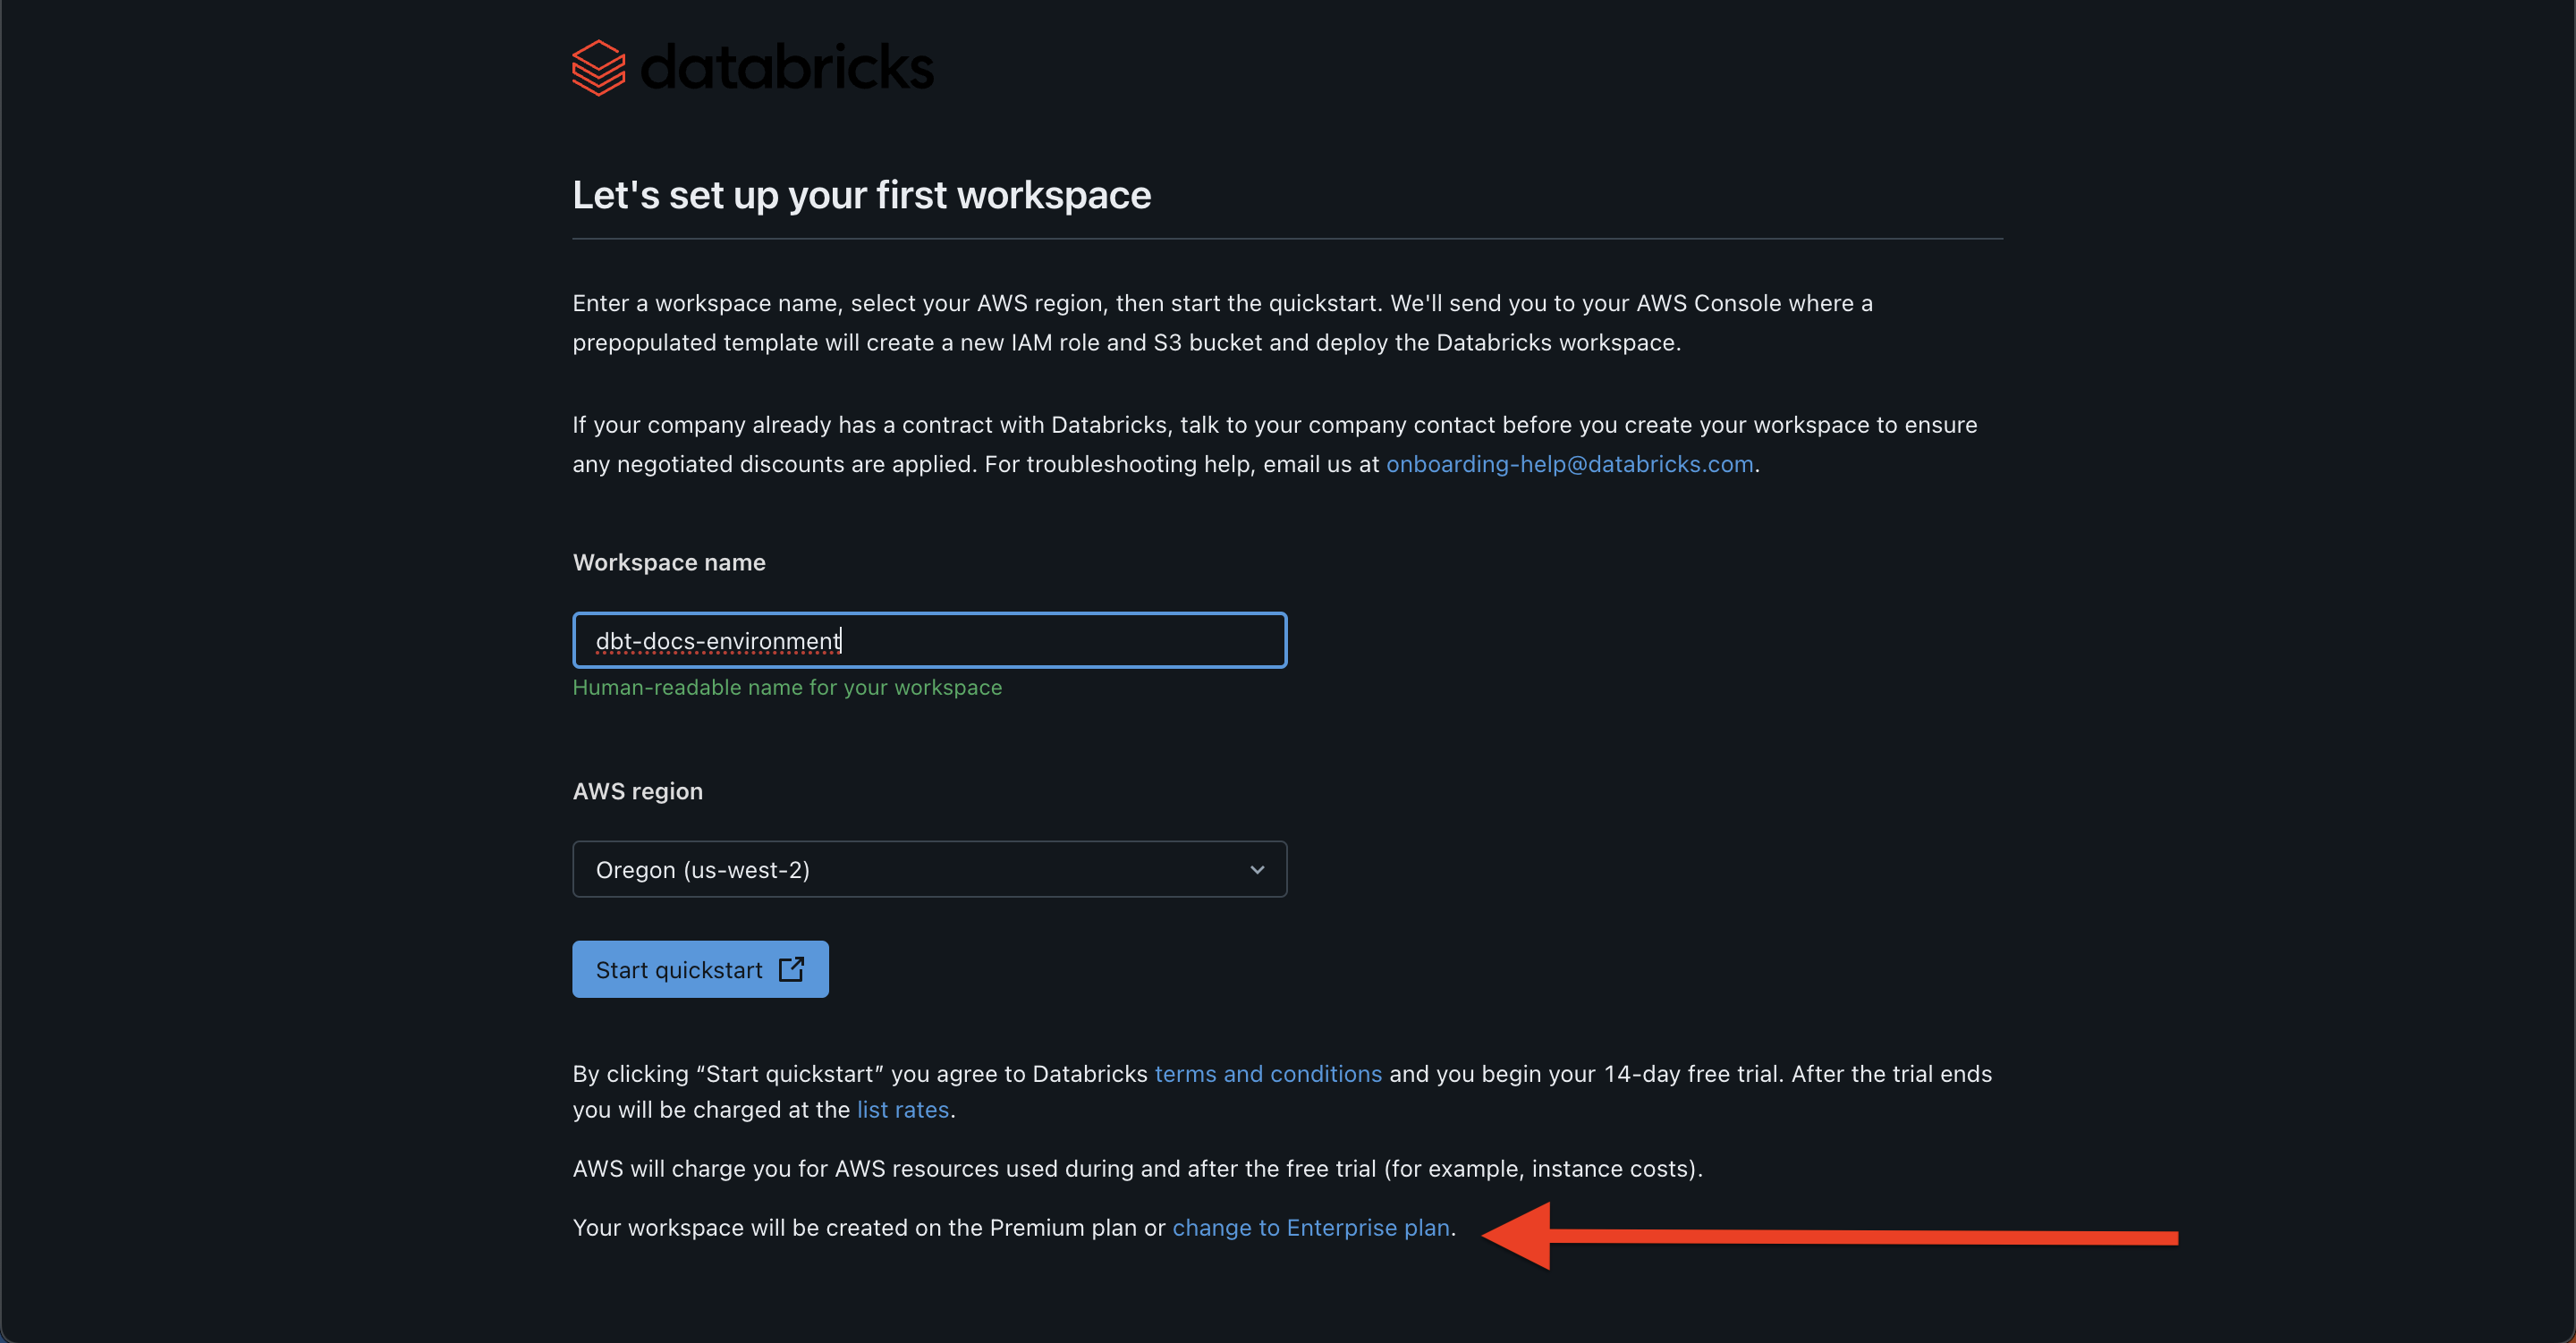 Выбор плана Databricks
-
Теперь пришло время создать ваше первое рабочее пространство. Рабочее пространство Databricks — это среда для доступа ко всем вашим ресурсам Databricks. Рабочее пространство организует такие объекты, как блокноты, SQL-склады, кластеры и многое другое, в одном месте. Укажите имя вашего рабочего пространства, выберите соответствующий регион AWS и нажмите Start Quickstart. Возможно, вы увидите флажок I have data in S3 that I want to query with Databricks. Вам не нужно отмечать его для этого руководства.
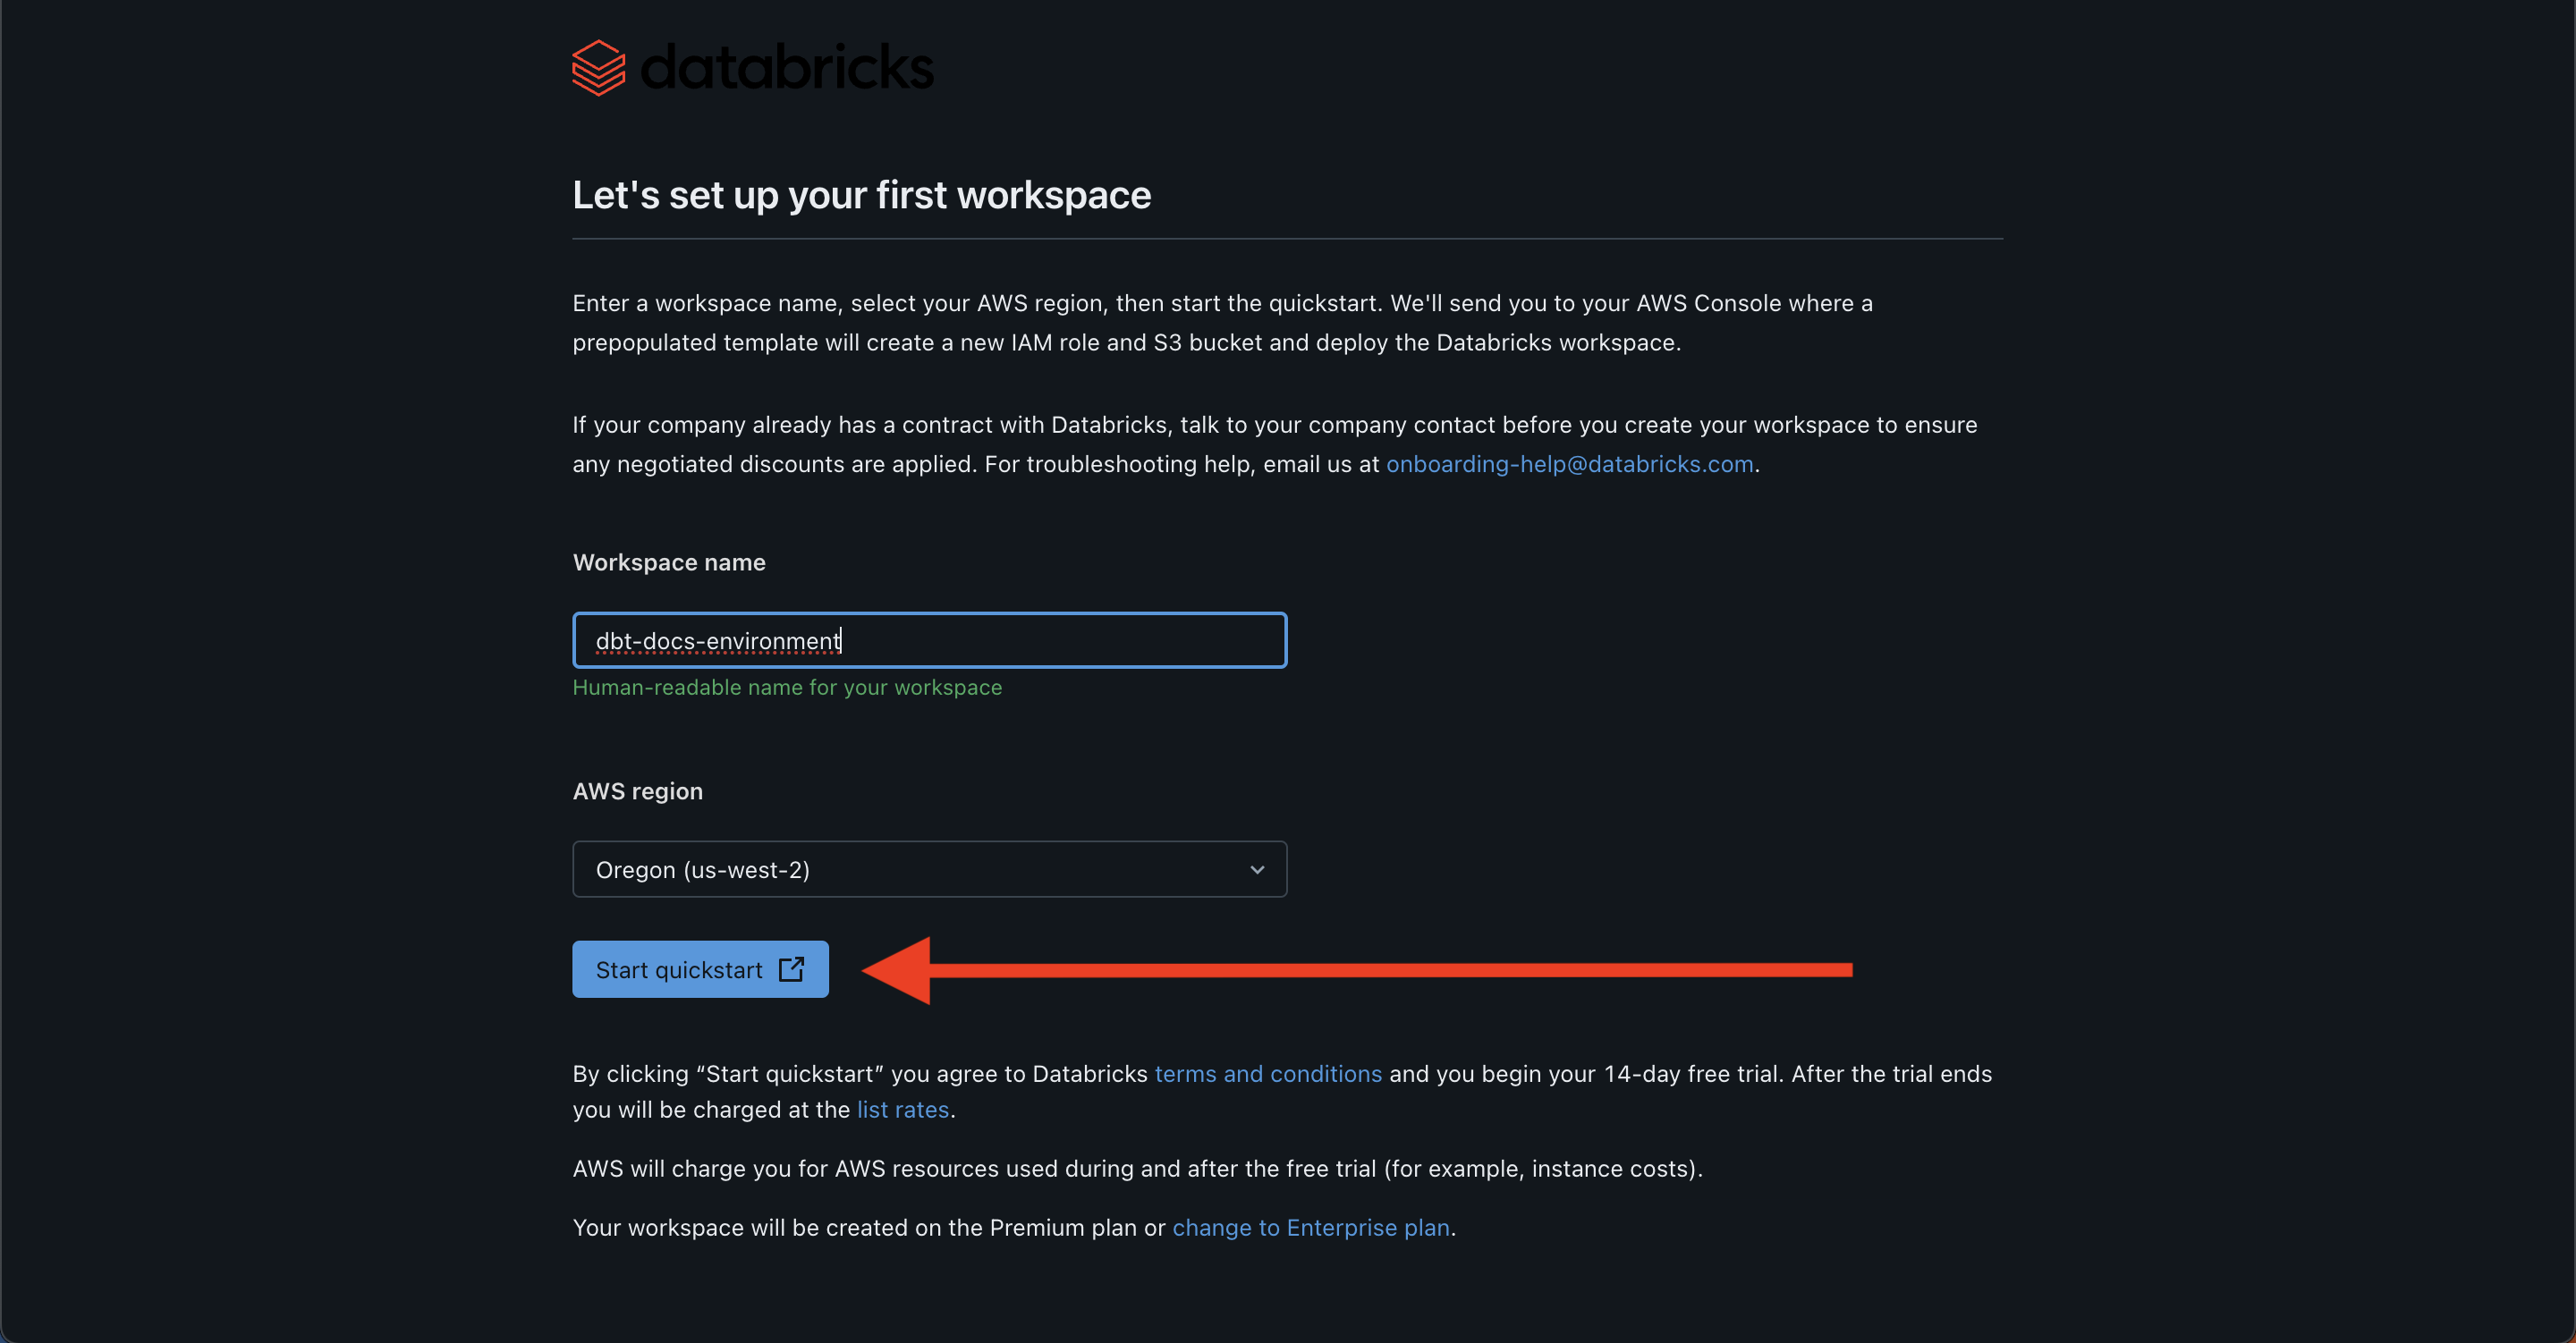 Создание ресурсов AWS
-
Нажав на
Start Quickstart, вы будете перенаправлены на AWS и вам будет предложено войти в систему, если вы еще этого не сделали. После входа в систему вы должны увидеть страницу, похожую на эту.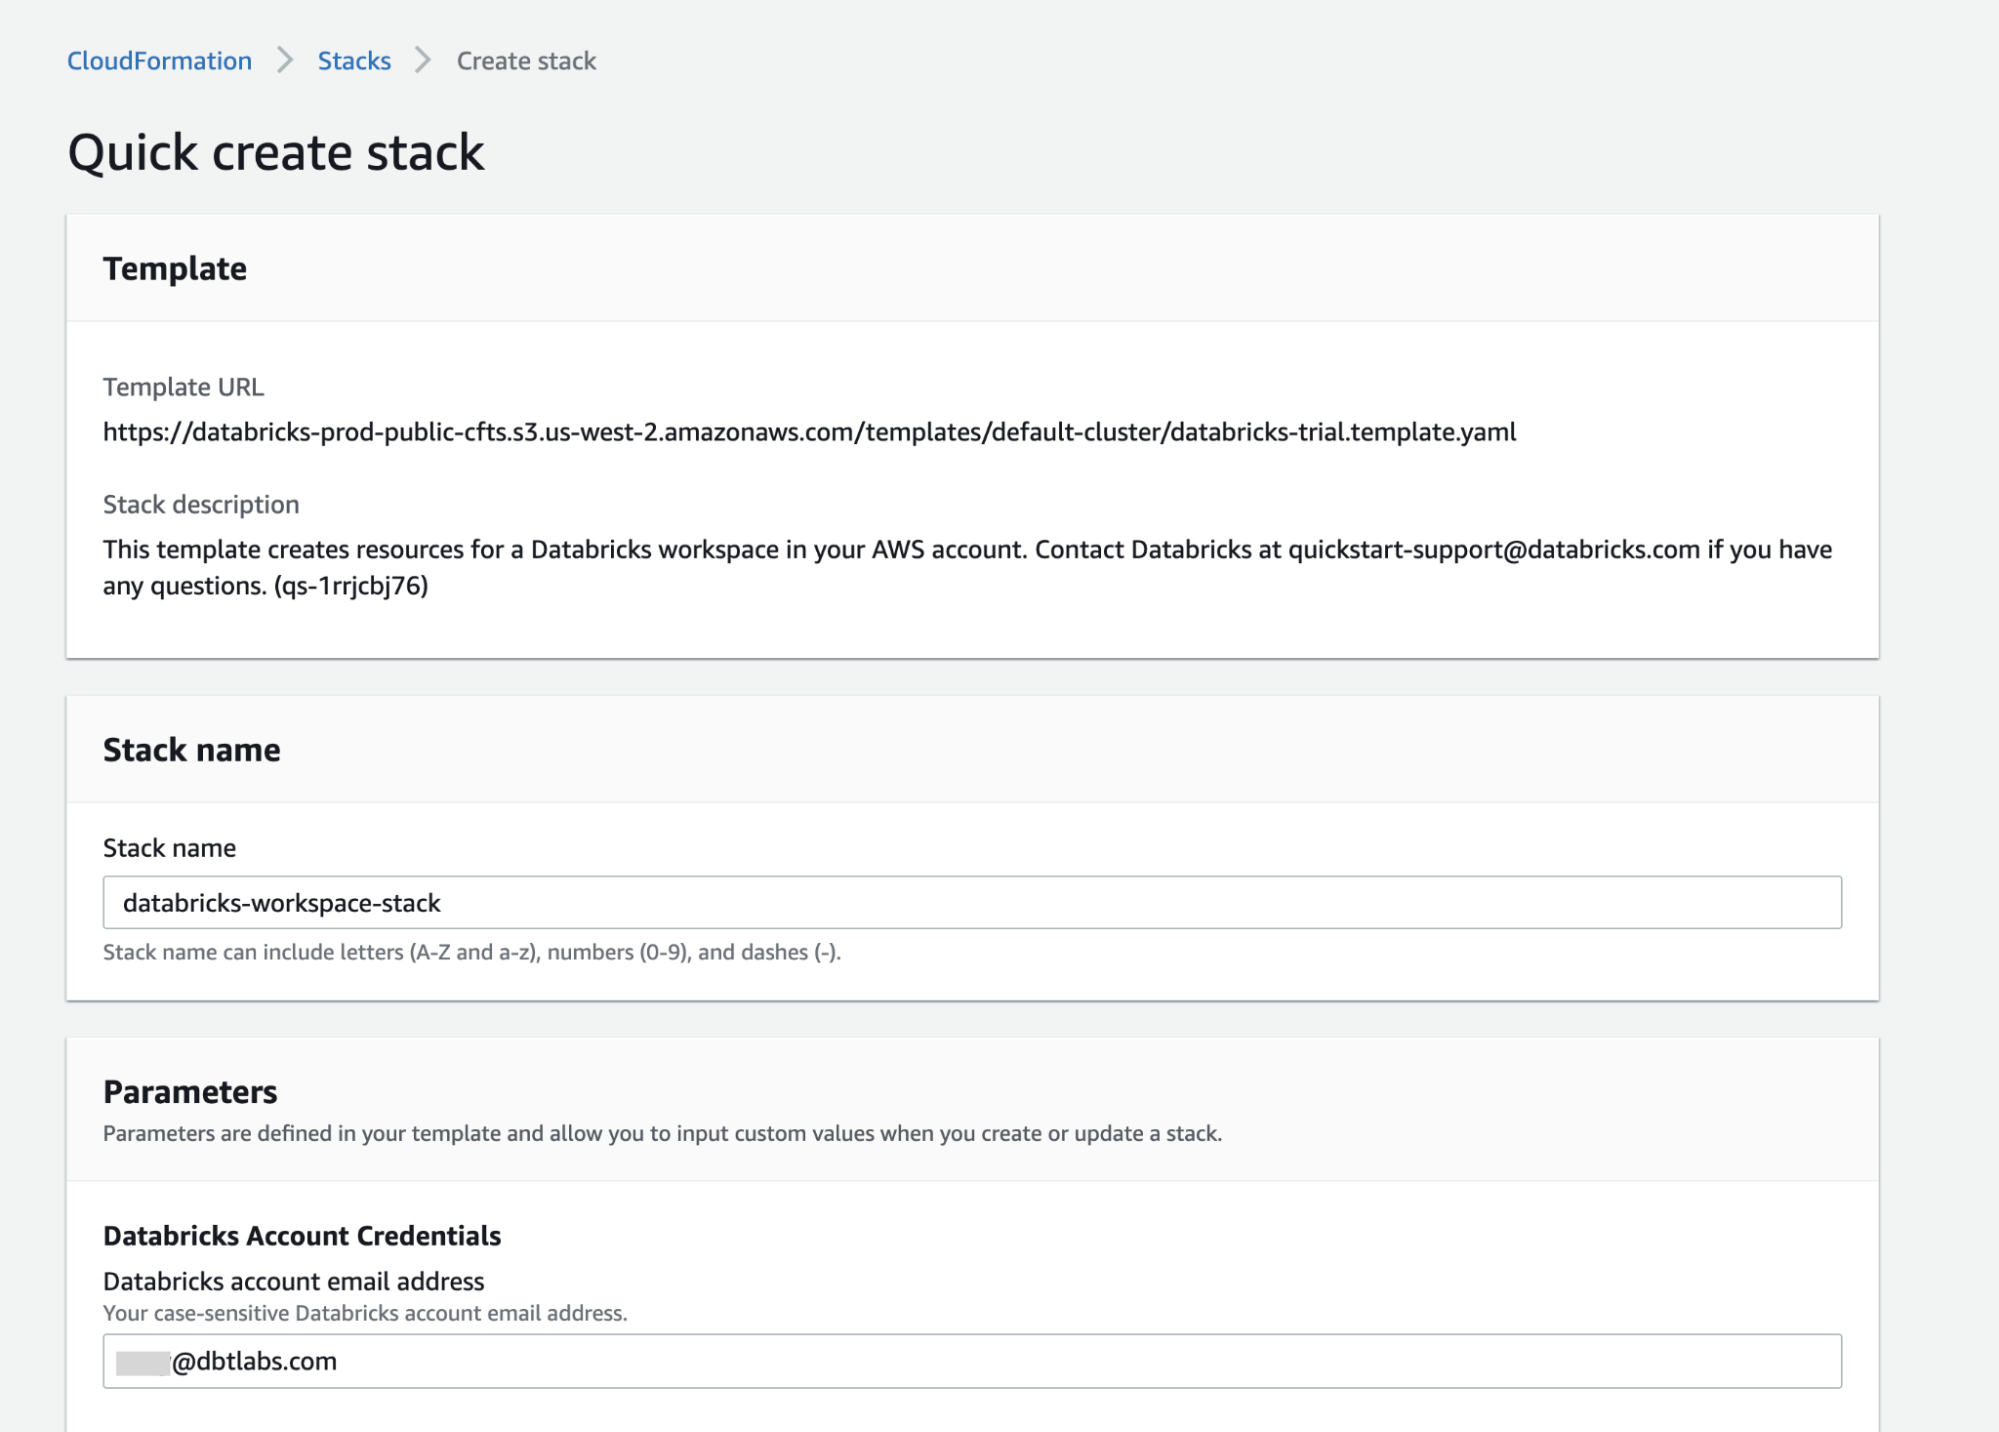 Создание ресурсов AWS
Если вы получаете ошибку сессии и не перенаправляетесь на эту страницу, вы можете вернуться в интерфейс Databricks и создать рабочее пространство из интерфейса. Все, что вам нужно сделать, это нажать create workspaces, выбрать quickstart, заполнить форму и нажать Start Quickstart.
-
Нет необходимости изменять какие-либо из предварительно заполненных полей в Параметрах. Просто добавьте ваш пароль Databricks в разделе Databricks Account Credentials. Отметьте Подтверждение и нажмите Create stack.
 Параметры
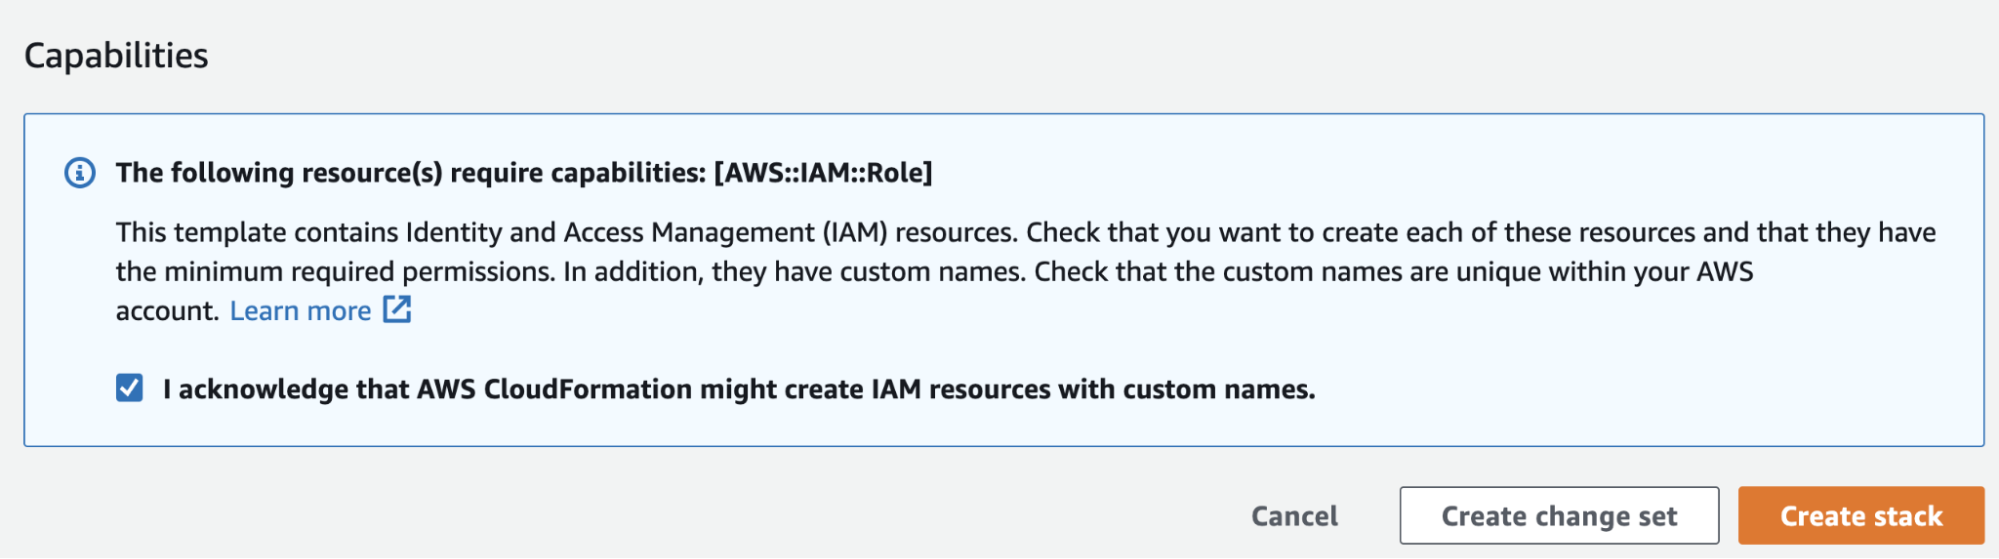 Возможности
-
Вернитесь на вкладку Databricks. Вы должны увидеть, что ваше рабочее пространство готово к использованию.
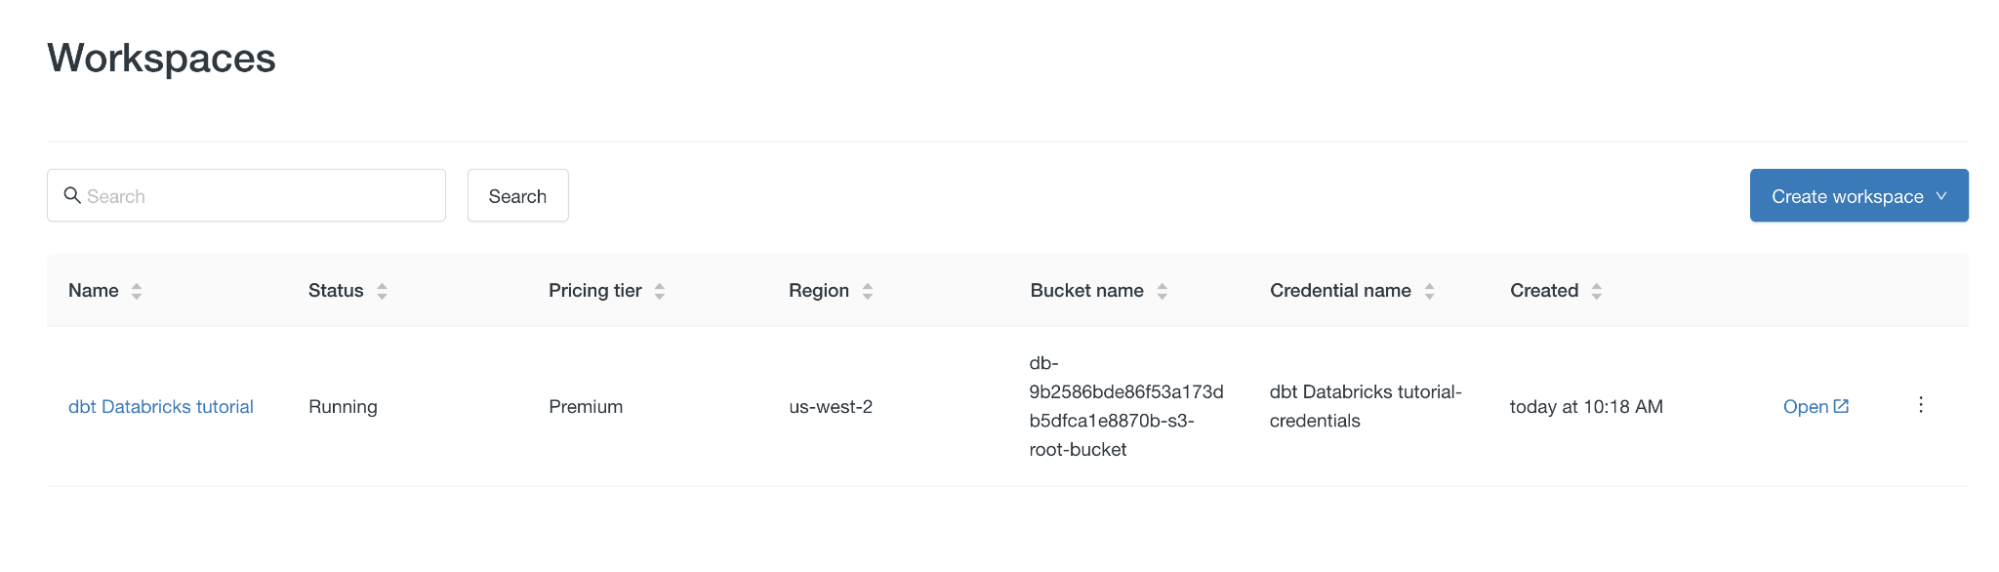 Рабочее пространство Databricks
-
Теперь давайте перейдем в рабочее пространство. Нажмите Open и войдите в рабочее пространство, используя те же данные для входа, что и для входа в аккаунт.
Загрузка данных
-
Скачайте эти CSV-файлы (пример данных Jaffle Shop), которые вам понадобятся для этого руководства:
-
Сначала нам нужен SQL-склад. Найдите выпадающее меню и переключитесь в пространство SQL.
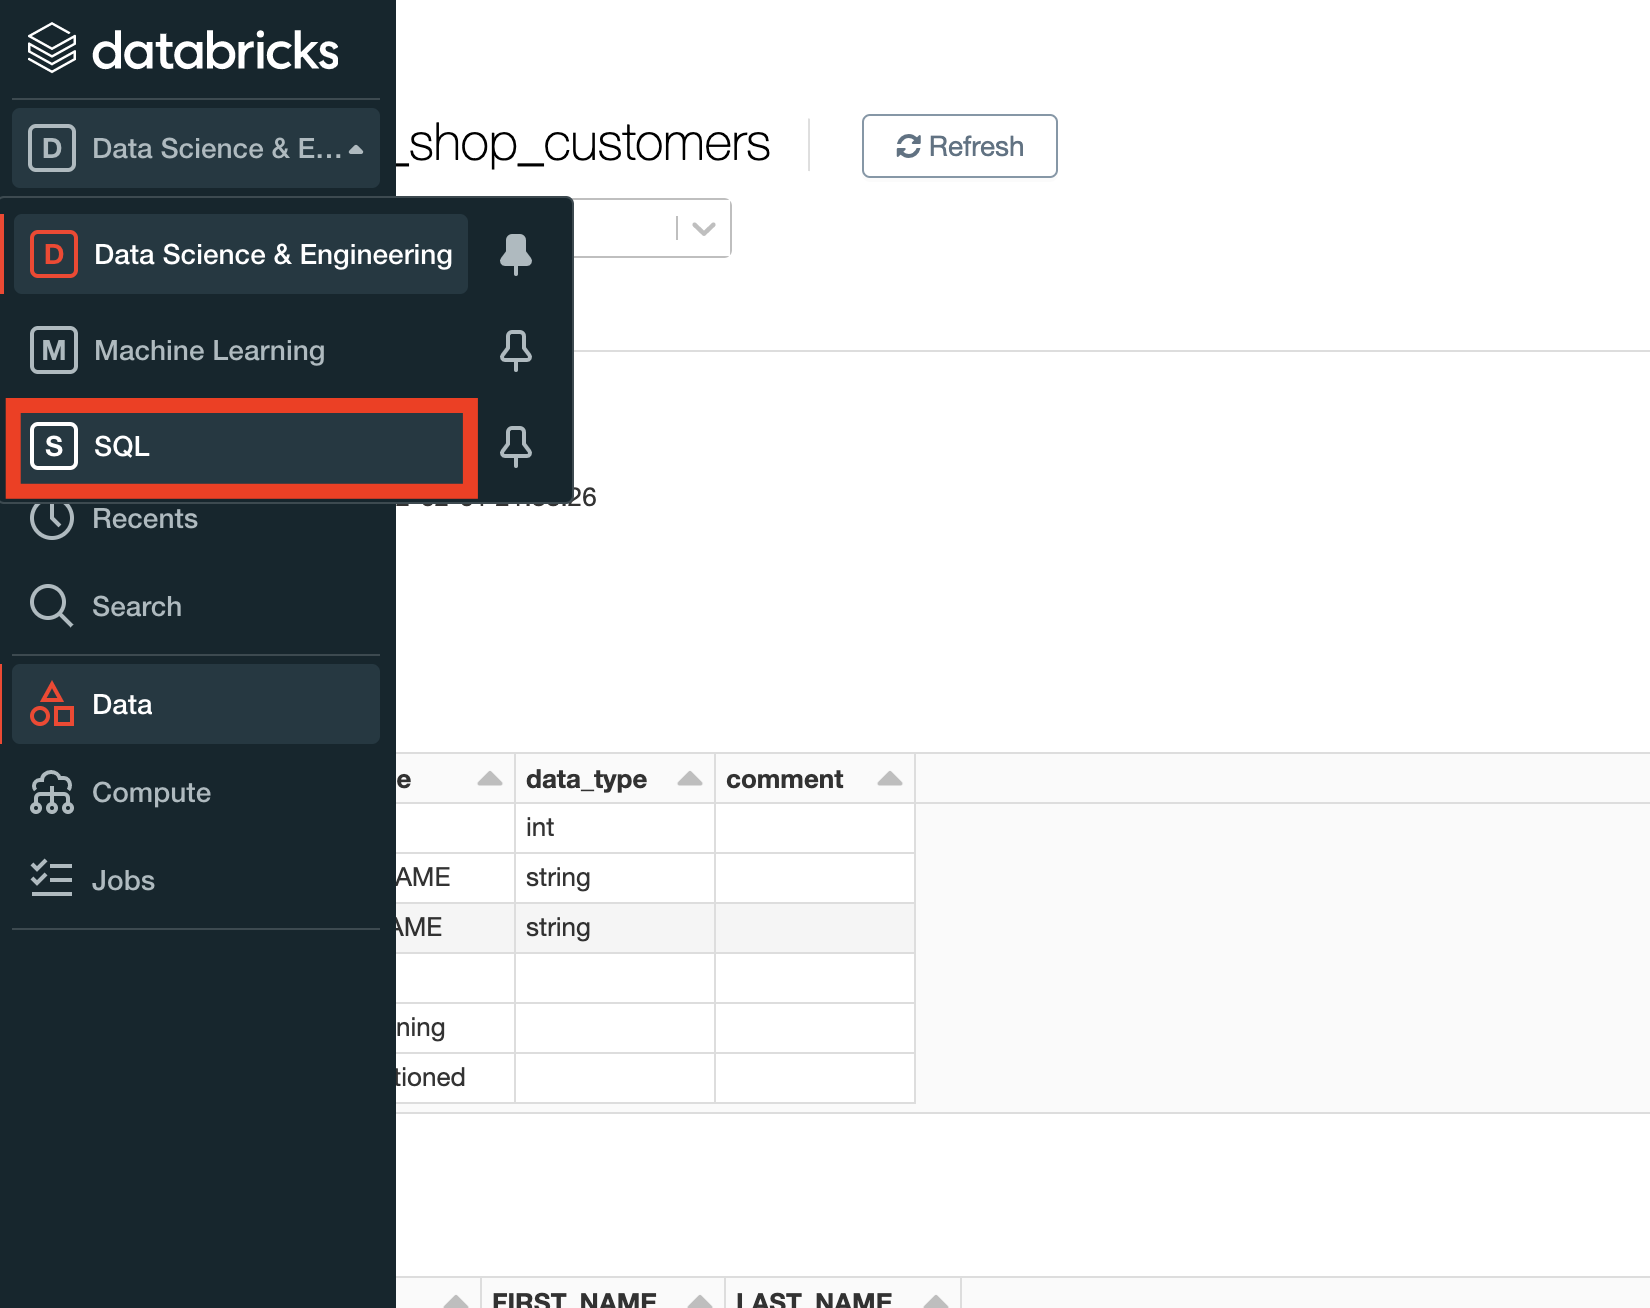 Пространство SQL
-
Сейчас мы будем настраивать SQL-склад. Выберите SQL Warehouses в консоли слева. Вы увидите, что существует склад SQL по умолчанию.
-
Нажмите Start на Starter Warehouse. Это займет несколько минут, чтобы запустить необходимые ресурсы.
-
Как только SQL-склад будет запущен, нажмите New, а затем File upload в выпадающем меню.
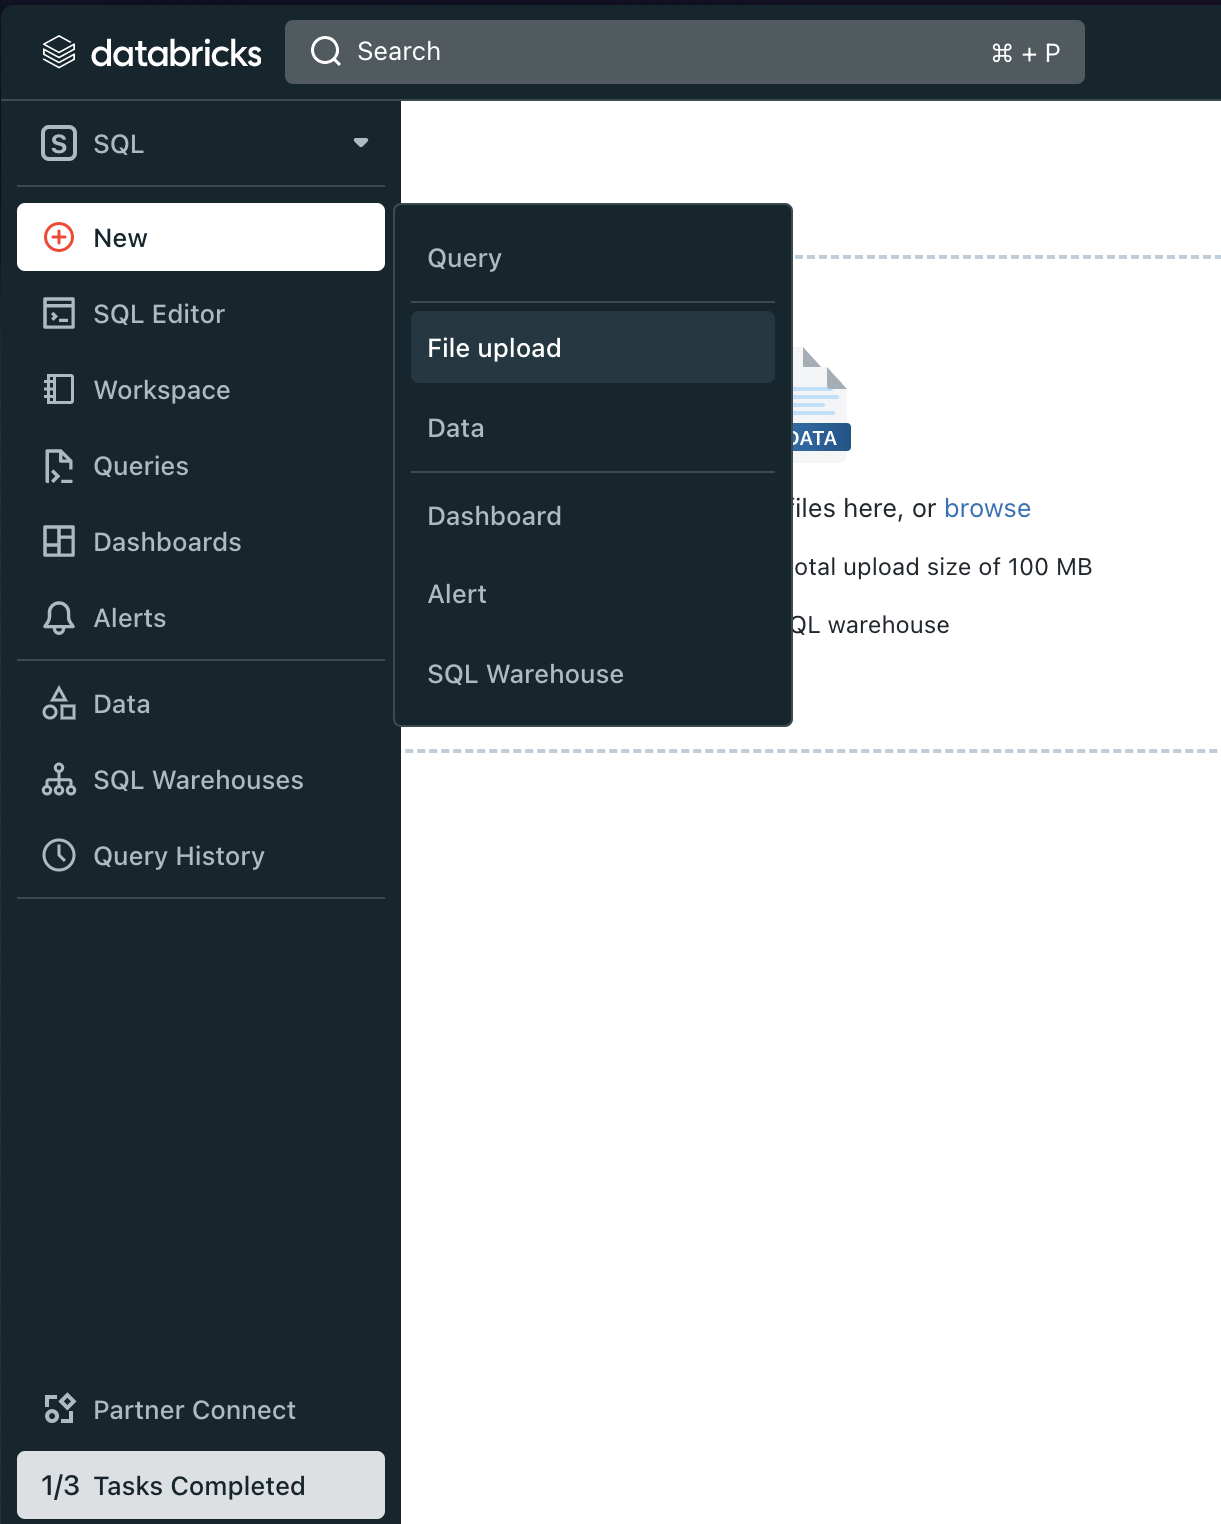 Новая загрузка файла с использованием Databricks SQL
-
Давайте сначала загрузим данные Jaffle Shop Customers. Перетащите файл
jaffle_shop_customers.csvв интерфейс.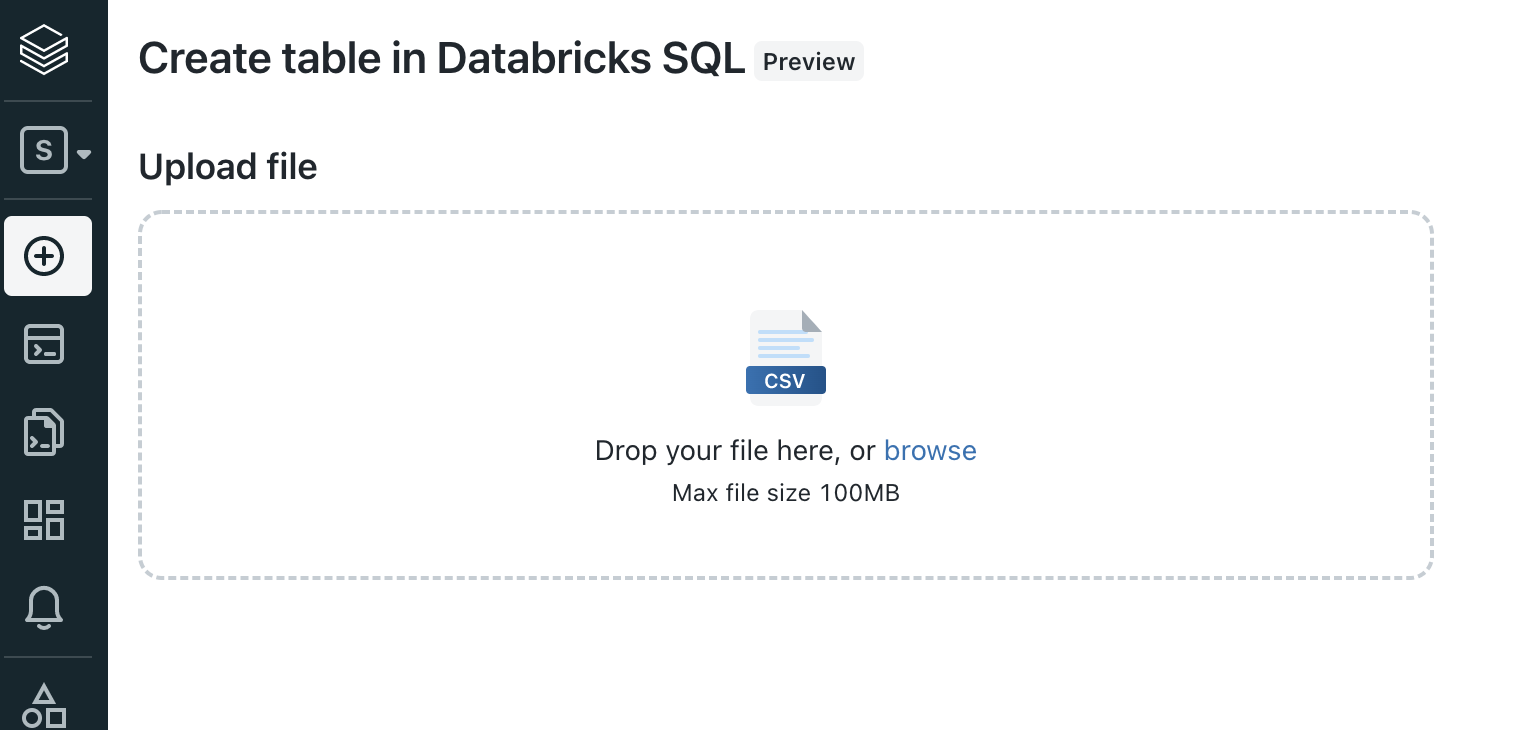 Загрузчик таблиц Databricks
-
Обновите атрибуты таблицы вверху:
- data_catalog = hive_metastore
- database = default
- table = jaffle_shop_customers
- Убедитесь, что типы данных столбцов корректны. Вы можете сделать это, наведя курсор на значок типа данных рядом с именем столбца.
- ID = bigint
- FIRST_NAME = string
- LAST_NAME = string
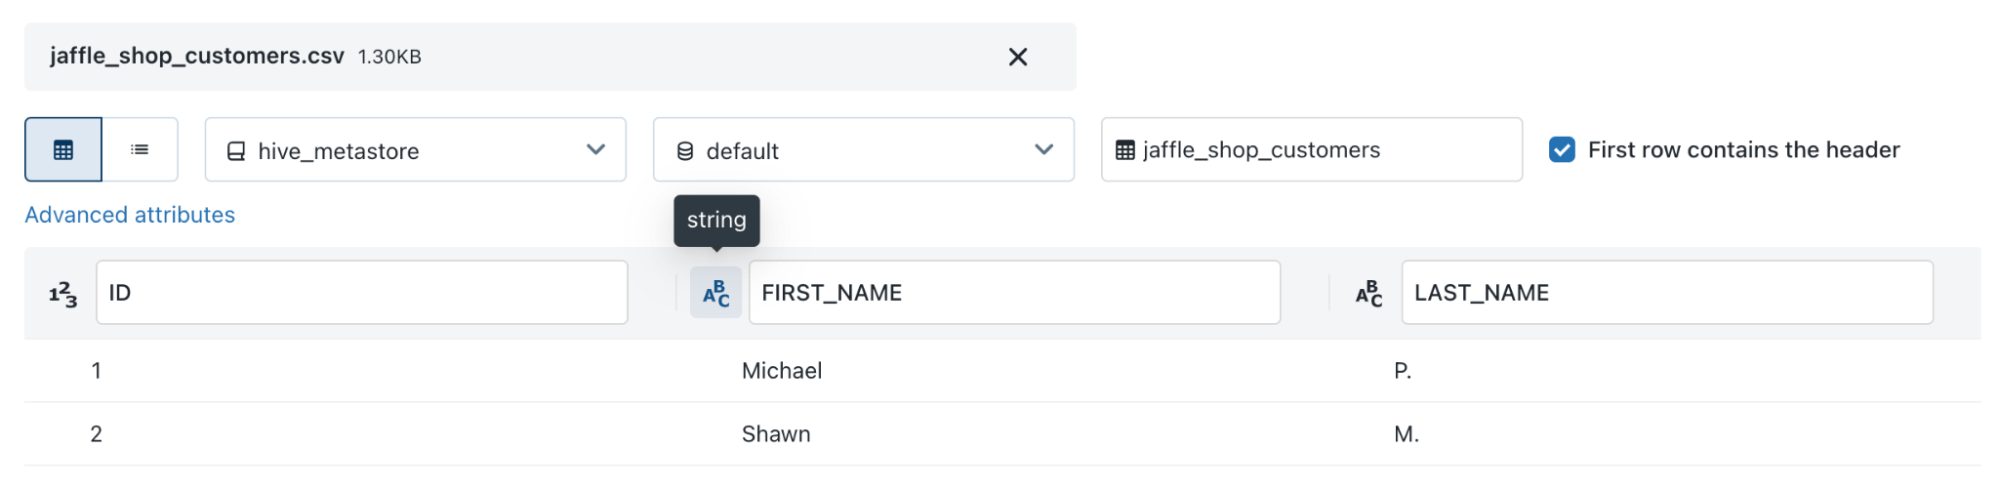 Загрузка клиентов jaffle shop
-
Нажмите Create внизу, когда закончите.
-
Теперь давайте сделаем то же самое для
Jaffle Shop OrdersиStripe Payments.
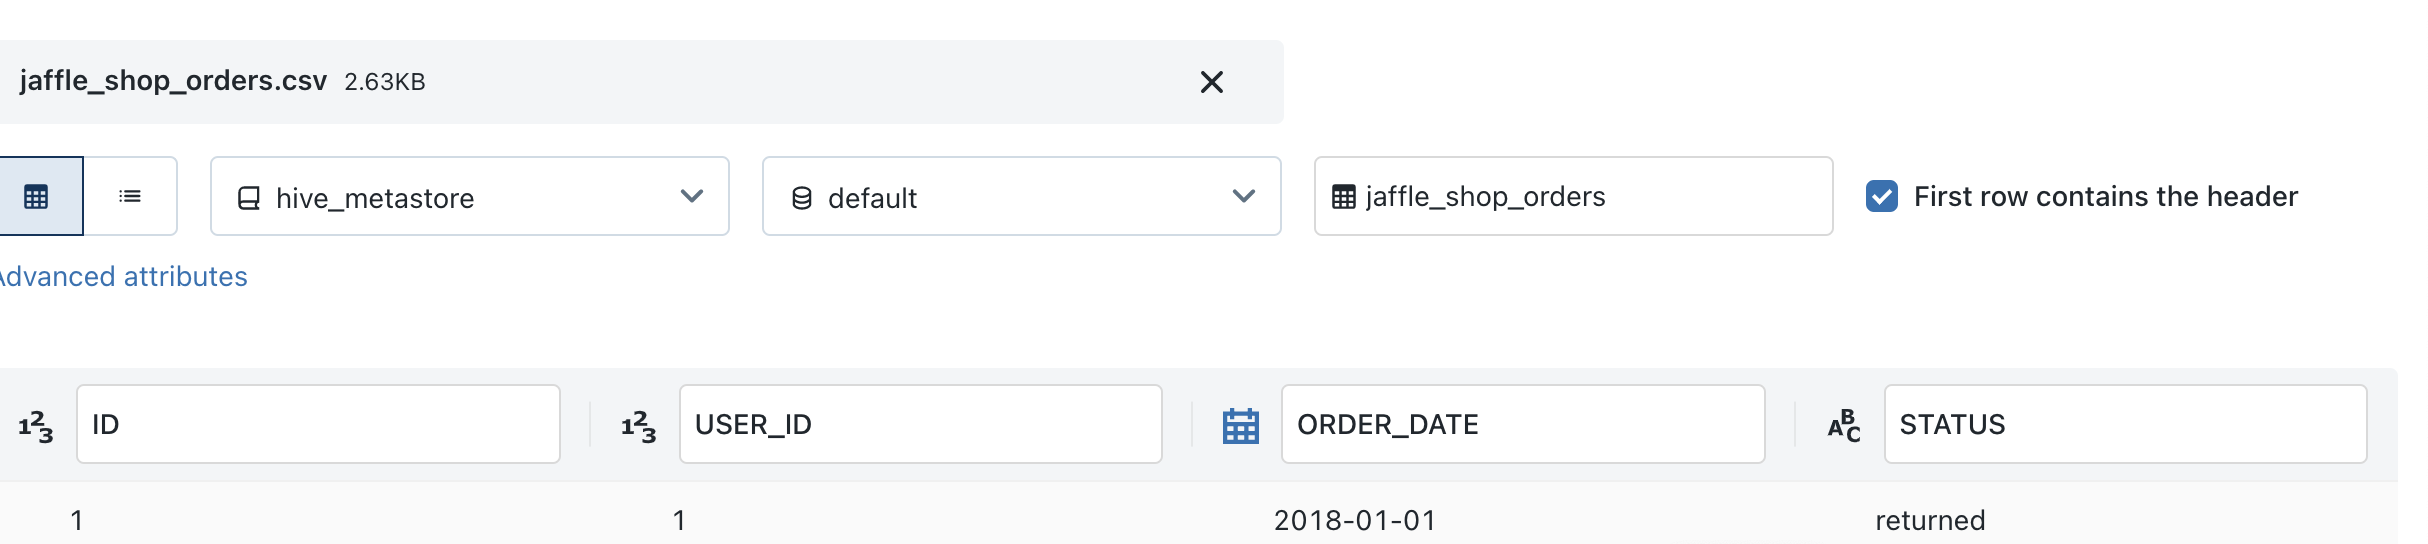 Загрузка заказов jaffle shop
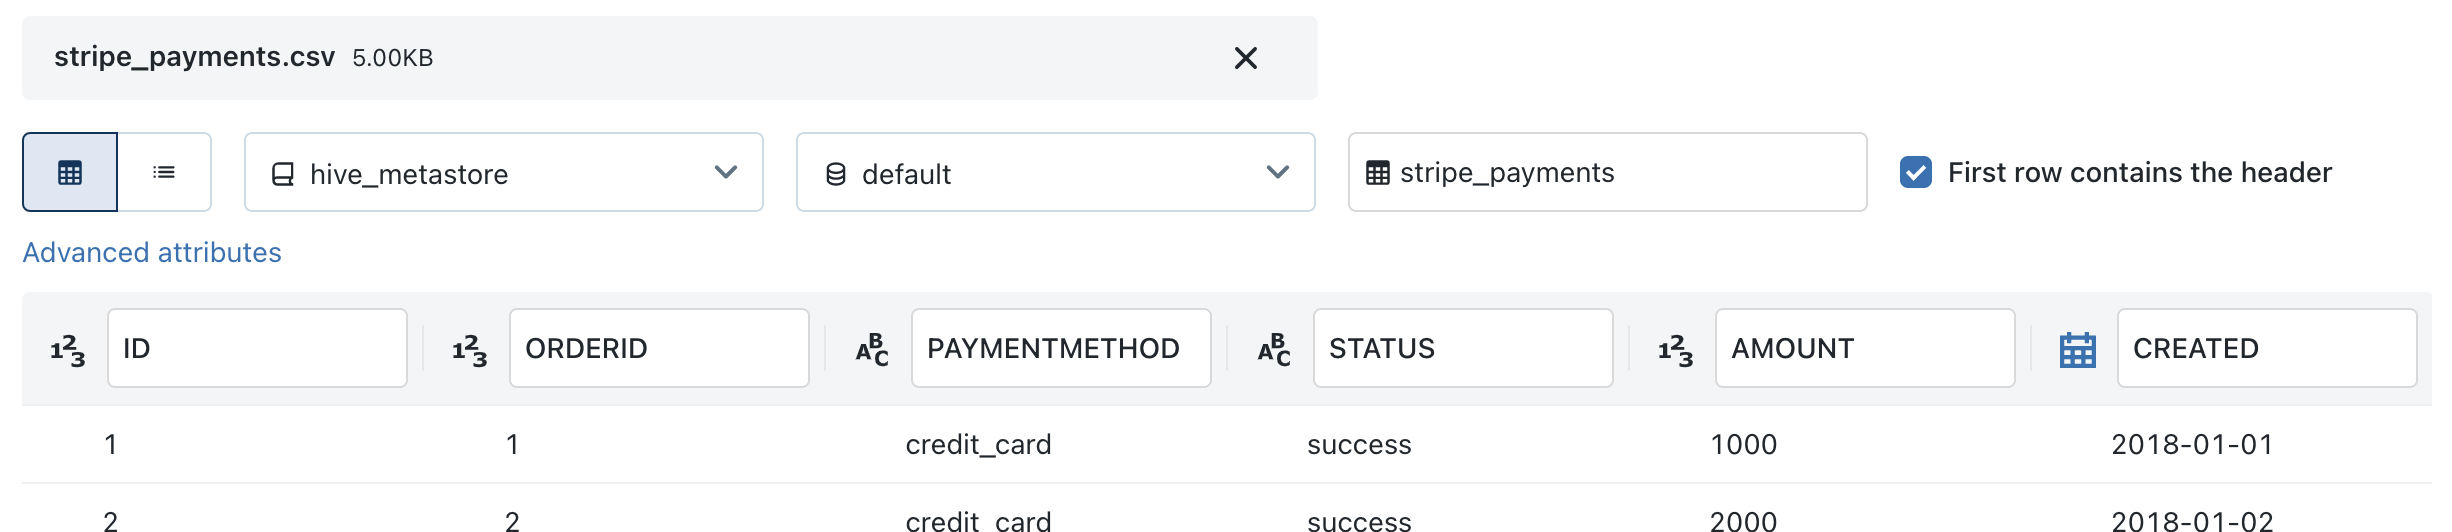 Загрузка платежей Stripe
-
После этого убедитесь, что вы можете выполнять запросы к учебным данным. Перейдите в
SQL Editorчерез меню слева. Это приведет вас к редактору запросов. -
Убедитесь, что вы можете выполнить
select *из каждой из таблиц с помощью следующих фрагментов кода.select * from default.jaffle_shop_customers
select * from default.jaffle_shop_orders
select * from default.stripe_payments Проверка запроса
-
Чтобы гарантировать, что любые пользователи, которые могут работать над вашим проектом dbt, имеют доступ к вашему объекту, выполните эту команду.
grant all privileges on schema default to users;
Подключение dbt к Databricks
Есть два способа подключить dbt к Databricks. Первый — Partner Connect, который упрощает настройку и позволяет создать учетную запись dbt непосредственно из новой пробной учетной записи Databricks. Второй — создать учетную запись dbt отдельно и самостоятельно настроить подключение к Databricks (подключиться вручную). Если вы хотите быстро приступить к работе, dbt Labs рекомендует использовать Partner Connect. Если вы хотите с самого начала настроить все под свои требования и ознакомиться с процессом настройки dbt, dbt Labs рекомендует подключиться вручную.
Если вы хотите начать работу как можно быстрее, dbt Labs рекомендует использовать Partner Connect. Если же вы хотите с самого начала настроить конфигурацию под свои требования и лучше разобраться в процессе настройки , dbt Labs рекомендует подключаться вручную.
Настройка интеграции через Partner Connect
Partner Connect предназначен для пробных учетных записей партнеров. Если у вашей организации уже есть учетная запись dbt, выполните подключение вручную. Инструкции см. в разделе Подключение к dbt вручную документации Databricks.
Чтобы подключить dbt к Databricks с помощью Partner Connect, выполните следующие действия:
-
В боковой панели вашего аккаунта Databricks нажмите Partner Connect.
-
Нажмите на плитку dbt.
-
Выберите каталог из выпадающего списка, а затем нажмите Next. Выпадающий список отображает каталоги, к которым у вас есть доступ на чтение и запись. Если ваше рабочее пространство не
<UC>-enabled, используется устаревший Hive metastore (hive_metastore). -
Если в вашем рабочем пространстве есть SQL-склады, выберите SQL-склад из выпадающего списка. Если ваш SQL-склад остановлен, нажмите Start.
-
Если в вашем рабочем пространстве нет SQL-складов:
- Нажмите Create warehouse. В вашем браузере откроется новая вкладка, на которой отображается страница New SQL Warehouse в интерфейсе Databricks SQL.
- Следуйте шагам в Создание SQL-склада в документации Databricks.
- Вернитесь на вкладку Partner Connect в вашем браузере и закройте плитку dbt.
- Снова откройте плитку dbt.
- Выберите SQL-склад, который вы только что создали, из выпадающего списка.
-
Выберите схему из выпадающего списка, а затем нажмите Add. Выпадающий список отображает схемы, к которым у вас есть доступ на чтение и запись. Вы можете повторить этот шаг, чтобы добавить несколько схем.
Partner Connect создает следующие ресурсы в вашем рабочем пространстве:
- Сервисный принципал Databricks с именем DBT_CLOUD_USER.
- Личный токен доступа Databricks, связанный с сервисным принципалом DBT_CLOUD_USER.
Partner Connect также предоставляет следующие привилегии сервисному принципалу DBT_CLOUD_USER:
- (Unity Catalog) USE CATALOG: Необходим для взаимодействия с объектами в выбранном каталоге.
- (Unity Catalog) USE SCHEMA: Необходим для взаимодействия с объектами в выбранной схеме.
- (Unity Catalog) CREATE SCHEMA: Предоставляет возможность создавать схемы в выбранном каталоге.
- (Hive metastore) USAGE: Необходим для предоставления привилегий SELECT и READ_METADATA для выбранных вами схем.
- SELECT: Предоставляет возможность читать выбранные вами схемы.
- (Hive metastore) READ_METADATA: Предоставляет возможность читать метаданные для выбранных вами схем.
- CAN_USE: Предоставляет разрешения на использование выбранного вами SQL-склада.
-
Нажмите Next.
В поле Email отображается адрес электронной почты вашей учетной записи Databricks. dbt Labs использует этот адрес электронной почты, чтобы предложить вам создать пробную учетную запись dbt.
-
Нажмите Connect to dbt.
В вашем веб-браузере откроется новая вкладка, на которой отображается веб-сайт getdbt.com.
-
Следуйте инструкциям на экране на сайте getdbt.com, чтобы создать пробную учетную запись dbt.
Настройка репозитория под управлением dbt
При разработке в dbt вы можете использовать Git для управления версиями кода.
Чтобы подключиться к репозиторию, вы можете настроить управляемый репозиторий, размещённый на стороне dbt, или напрямую подключиться к поддерживаемому Git-провайдеру. Управляемые репозитории — отличный способ попробовать dbt без необходимости создавать новый репозиторий. В долгосрочной перспективе лучше подключиться к поддерживаемому Git-провайдеру, чтобы использовать такие возможности, как автоматизация и непрерывная интеграция.
Чтобы настроить управляемый репозиторий:
- В разделе "Настроить репозиторий" выберите Управляемый.
- Введите имя для вашего репозитория, например,
bbaggins-dbt-quickstart. - Нажмите Создать. Создание и импорт вашего репозитория займет несколько секунд.
- Как только вы увидите сообщение "Репозиторий успешно импортирован", нажмите Продолжить.
Инициализация вашего проекта dbt и начало разработки
Теперь, когда репозиторий настроен, вы можете инициализировать проект и начать разработку в dbt:
- Нажмите Start developing in the Studio IDE. Первый запуск проекта может занять несколько минут: за это время устанавливается соединение с Git, клонируется репозиторий и проверяется подключение к хранилищу данных.
- Над деревом файлов слева нажмите Initialize dbt project. Это создаст структуру папок с примерами моделей.
- Создайте первый коммит, нажав Commit and sync. Укажите сообщение коммита
initial commitи нажмите Commit. Это создаст первый коммит в управляемом репозитории и позволит вам создать ветку, в которой можно добавлять новый код dbt. - Теперь вы можете напрямую запрашивать данные из хранилища и выполнять
dbt run. Попробуйте сделать это прямо сейчас:- Нажмите + Create new file, добавьте этот запрос в новый файл и нажмите Save as, чтобы сохранить его:
select * from default.jaffle_shop_customers - В командной строке внизу введите
dbt runи нажмите Enter. Вы должны увидеть сообщениеdbt run succeeded.
- Нажмите + Create new file, добавьте этот запрос в новый файл и нажмите Save as, чтобы сохранить его:
Создание вашей первой модели
Если вы хотите использовать ИИ для создания своей первой модели, ознакомьтесь с разделом «Создайте модель с помощью dbt Wizard» ниже.
У вас есть два варианта работы с файлами в Studio IDE:
- Создать новую ветку (рекомендуется) — Создайте новую ветку для редактирования и фиксации изменений. Перейдите в раздел Version Control на левой боковой панели и нажмите Create branch.
- Редактировать в защищённой основной ветке — Если вы предпочитаете редактировать, форматировать файлы или проверять их линтером, а также выполнять команды dbt непосредственно в основной ветке Git. Studio IDE не позволяет создавать коммиты в защищённой ветке, поэтому вам будет предложено зафиксировать изменения в новой ветке.
Назовите новую ветку add-customers-model.
- Нажмите на ... рядом с директорией
models, затем выберите Create file. - Назовите файл
customers.sql, затем нажмите Create. - Скопируйте следующий запрос в файл и нажмите Save.
with customers as (

    select
        id as customer_id,
        first_name,
        last_name

    from jaffle_shop_customers

),

orders as (

    select
        id as order_id,
        user_id as customer_id,
        order_date,
        status

    from jaffle_shop_orders

),

customer_orders as (

    select
        customer_id,

        min(order_date) as first_order_date,
        max(order_date) as most_recent_order_date,
        count(order_id) as number_of_orders

    from orders

    group by 1

),

final as (

    select
        customers.customer_id,
        customers.first_name,
        customers.last_name,
        customer_orders.first_order_date,
        customer_orders.most_recent_order_date,
        coalesce(customer_orders.number_of_orders, 0) as number_of_orders

    from customers

    left join customer_orders using (customer_id)

)

select * from final
- Введите
dbt runв командной строке внизу экрана. Вы должны получить успешное выполнение и увидеть три модели.
Позже вы сможете подключить свои инструменты бизнес-аналитики (BI), например dbt Charts, к этим представлениям и таблицам, чтобы они считывали только очищенные, а не сырые данные.
Часто задаваемые вопросы
Создайте модель с помощью ИИ в dbt Wizard
Не хотите писать SQL вручную? dbt Wizard может создать для вас ту же модель прямо в Studio IDE или на главной вкладке, опираясь на фактическую схему и граф зависимостей вашего проекта. Но будьте осторожны: говорят, волшебник умеет .
- Откройте dbt Wizard в Studio IDE.
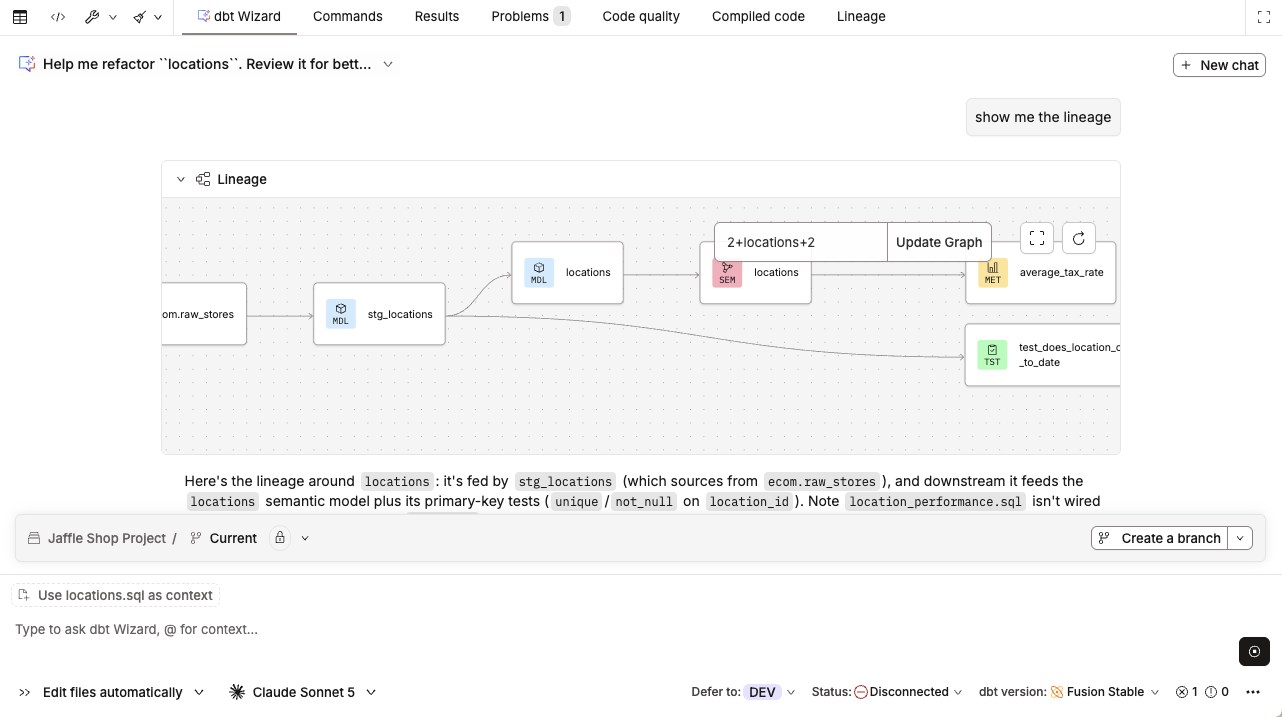 dbt Wizard выполняет рефакторинг модели и показывает граф зависимостей в интерфейсе чата.
- Введите запрос: «Создай модель customers, которая объединяет orders и customers и включает дату последнего заказа и общее количество заказов для каждого клиента».
- Проверьте SQL, сгенерированный dbt Wizard, затем примите его, чтобы сохранить модель.
- Введите
dbt run, чтобы построить модель.
В любом случае вы получите одну и ту же работающую модель. Узнайте больше о dbt Wizard на платформе dbt.
Измените способ материализации вашей модели
Одной из самых мощных функций dbt является возможность изменять способ материализации модели в вашем хранилище данных, просто изменяя значение конфигурации. Вы можете переключаться между таблицами и представлениями, изменяя ключевое слово, вместо того чтобы писать язык определения данных (DDL) для выполнения этого за кулисами.
По умолчанию все создается как представление. Вы можете переопределить это на уровне директории, чтобы все в этой директории материализовалось по-другому.
-
Отредактируйте ваш файл
dbt_project.yml.-
Обновите имя вашего проекта на:
dbt_project.ymlname: 'jaffle_shop' -
Настройте
jaffle_shopтак, чтобы всё внутри него материализовалось как таблица; и настройтеexampleтак, чтобы всё внутри него материализовалось как представление (view). Обновите конфигурациюmodelsв YAML-файле проекта следующим образом:dbt_project.ymlmodels:
jaffle_shop:
+materialized: table
example:
+materialized: view -
Нажмите Сохранить.
-
-
Введите команду
dbt run. Ваша модельcustomersтеперь должна быть построена как таблица!к сведениюДля этого dbt сначала должен был выполнить оператор
drop view(или API вызов на BigQuery), затем операторcreate table as. -
Отредактируйте
models/customers.sql, чтобы переопределитьdbt_project.ymlтолько для моделиcustomers, добавив следующий фрагмент в начало, и нажмите Сохранить:models/customers.sql{{
config(
materialized='view'
)
}}
with customers as (
select
id as customer_id
...
) -
Введите команду
dbt run. Ваша модельcustomersтеперь должна быть построена как представление.- Пользователям BigQuery необходимо выполнить
dbt run --full-refreshвместоdbt run, чтобы полностью применить изменения материализации.
- Пользователям BigQuery необходимо выполнить
-
Введите команду
dbt run --full-refresh, чтобы изменения вступили в силу в вашем хранилище данных.
Часто задаваемые вопросы
Удаление примерных моделей
Теперь вы можете удалить файлы, которые dbt создал при инициализации проекта:
-
Удалите директорию
models/example/. -
Удалите ключ
example:из вашего файлаdbt_project.yml, а также любые конфигурации, которые перечислены под ним.dbt_project.yml# до
models:
  jaffle_shop:
    +materialized: table
    example:
+materialized: viewdbt_project.yml# после
models:
jaffle_shop:
+materialized: table -
Сохраните изменения.
Часто задаваемые вопросы
Создание моделей на основе других моделей
Как лучшая практика в SQL, следует разделять логику, которая очищает ваши данные, от логики, которая трансформирует ваши данные. Вы уже начали делать это в существующем запросе, используя общие табличные выражения (CTE).
Теперь вы можете поэкспериментировать, разделив логику на отдельные модели и используя функцию ref для построения моделей на основе других моделей:
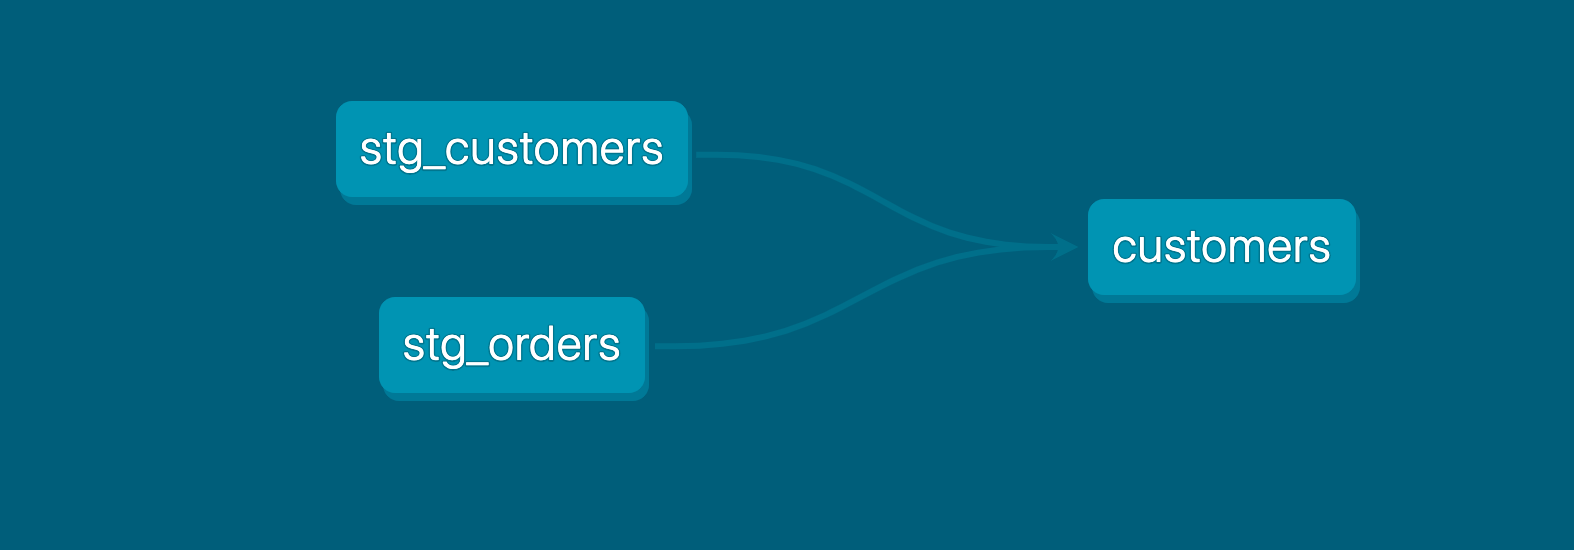 Граф, который мы хотим для нашего проекта dbt
-
Создайте новый SQL-файл,
models/stg_customers.sql, с SQL из CTEcustomersв нашем исходном запросе. -
Создайте второй новый SQL-файл,
models/stg_orders.sql, с SQL из CTEordersв нашем исходном запросе.models/stg_customers.sqlselect
id as customer_id,
first_name,
last_name
from jaffle_shop_customersmodels/stg_orders.sqlselect
id as order_id,
user_id as customer_id,
order_date,
status
from jaffle_shop_orders -
Отредактируйте SQL в вашем файле
models/customers.sqlследующим образом:models/customers.sqlwith customers as (
select * from {{ ref('stg_customers') }}
),
orders as (
select * from {{ ref('stg_orders') }}
),
customer_orders as (
select
customer_id,
min(order_date) as first_order_date,
max(order_date) as most_recent_order_date,
count(order_id) as number_of_orders
from orders
group by 1
),
final as (
select
customers.customer_id,
customers.first_name,
customers.last_name,
customer_orders.first_order_date,
customer_orders.most_recent_order_date,
coalesce(customer_orders.number_of_orders, 0) as number_of_orders
from customers
left join customer_orders using (customer_id)
)
select * from final -
Выполните
dbt run.На этот раз, когда вы выполнили
dbt run, были созданы отдельные представления/таблицы дляstg_customers,stg_ordersиcustomers. dbt определил порядок выполнения этих моделей. Посколькуcustomersзависит отstg_customersиstg_orders, dbt строитcustomersпоследним. Вам не нужно явно определять эти зависимости.
Часто задаваемые вопросы
Добавьте тесты к вашим моделям
Добавление data tests в проект помогает убедиться, что ваши модели работают корректно.
Чтобы добавить data tests в проект:
-
Создайте новый YAML-файл в директории
models, назвав егоmodels/schema.yml. -
Добавьте в файл следующее содержимое:
models/schema.ymlversion: 2
models:
- name: customers
columns:
- name: customer_id
data_tests:
- unique
- not_null
- name: stg_customers
columns:
- name: customer_id
data_tests:
- unique
- not_null
- name: stg_orders
columns:
- name: order_id
data_tests:
- unique
- not_null
- name: status
data_tests:
- accepted_values:
arguments: # available in v1.10.5 and higher. Older versions can set the <argument_name> as the top-level property.
values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
- name: customer_id
data_tests:
- not_null
- relationships:
arguments:
to: ref('stg_customers')
field: customer_id -
Запустите
dbt testи убедитесь, что все ваши тесты прошли успешно.
Когда вы запускаете dbt test, dbt проходит по вашим YAML-файлам и создает запрос для каждого теста. Каждый запрос вернет количество записей, которые не прошли тест. Если это число равно 0, то тест считается успешным.
Часто задаваемые вопросы
Документируйте ваши модели
Добавление документации в ваш проект позволяет подробно описывать ваши модели и делиться этой информацией с вашей командой. Здесь мы добавим базовую документацию в наш проект.
Обновите файл models/schema.yml, добавив описания, например приведённые ниже.
version: 2

models:
  - name: customers
    description: Одна запись на каждого клиента
    columns:
      - name: customer_id
        description: Первичный ключ
        data_tests:
          - unique
          - not_null
      - name: first_order_date
        description: NULL, если клиент еще не сделал заказ.

  - name: stg_customers
    description: Эта модель очищает данные о клиентах
    columns:
      - name: customer_id
        description: Первичный ключ
        data_tests:
          - unique
          - not_null

  - name: stg_orders
    description: Эта модель очищает данные о заказах
    columns:
      - name: order_id
        description: Первичный ключ
        data_tests:
          - unique
          - not_null
      - name: status
        data_tests:
          - accepted_values:
              arguments: # available in v1.10.5 and higher. Older versions can set the <argument_name> as the top-level property.
                values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
      - name: customer_id
        data_tests:
          - not_null
          - relationships:
              arguments:
                to: ref('stg_customers')
                field: customer_id
- View in Catalog
- View in Studio IDE
Catalog предоставляет мощные инструменты для работы с вашими проектами dbt, в том числе с документацией:
- Выполните одну из следующих команд:
dbt docs generate, если вы используете dbt v1dbt build, если вы используете dbt v2
- Нажмите Catalog в меню навигации, чтобы открыть Catalog.
- По умолчанию Catalog отображает среду Production. Если в вашей учетной записи есть дополнительные среды (например, Staging), вы можете выбрать их в раскрывающемся списке сред.
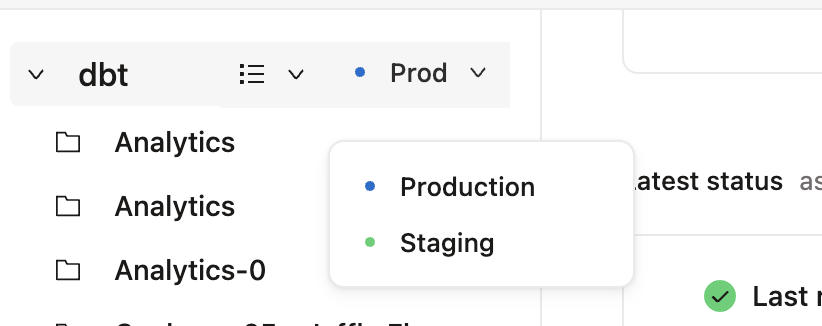 Выбор среды в Catalog.
- Выберите свой проект в дереве файлов.
- Используйте строку поиска или просмотрите список ресурсов, чтобы найти модель
customers. - Нажмите на модель, чтобы просмотреть сведения о ней, включая добавленные вами описания.
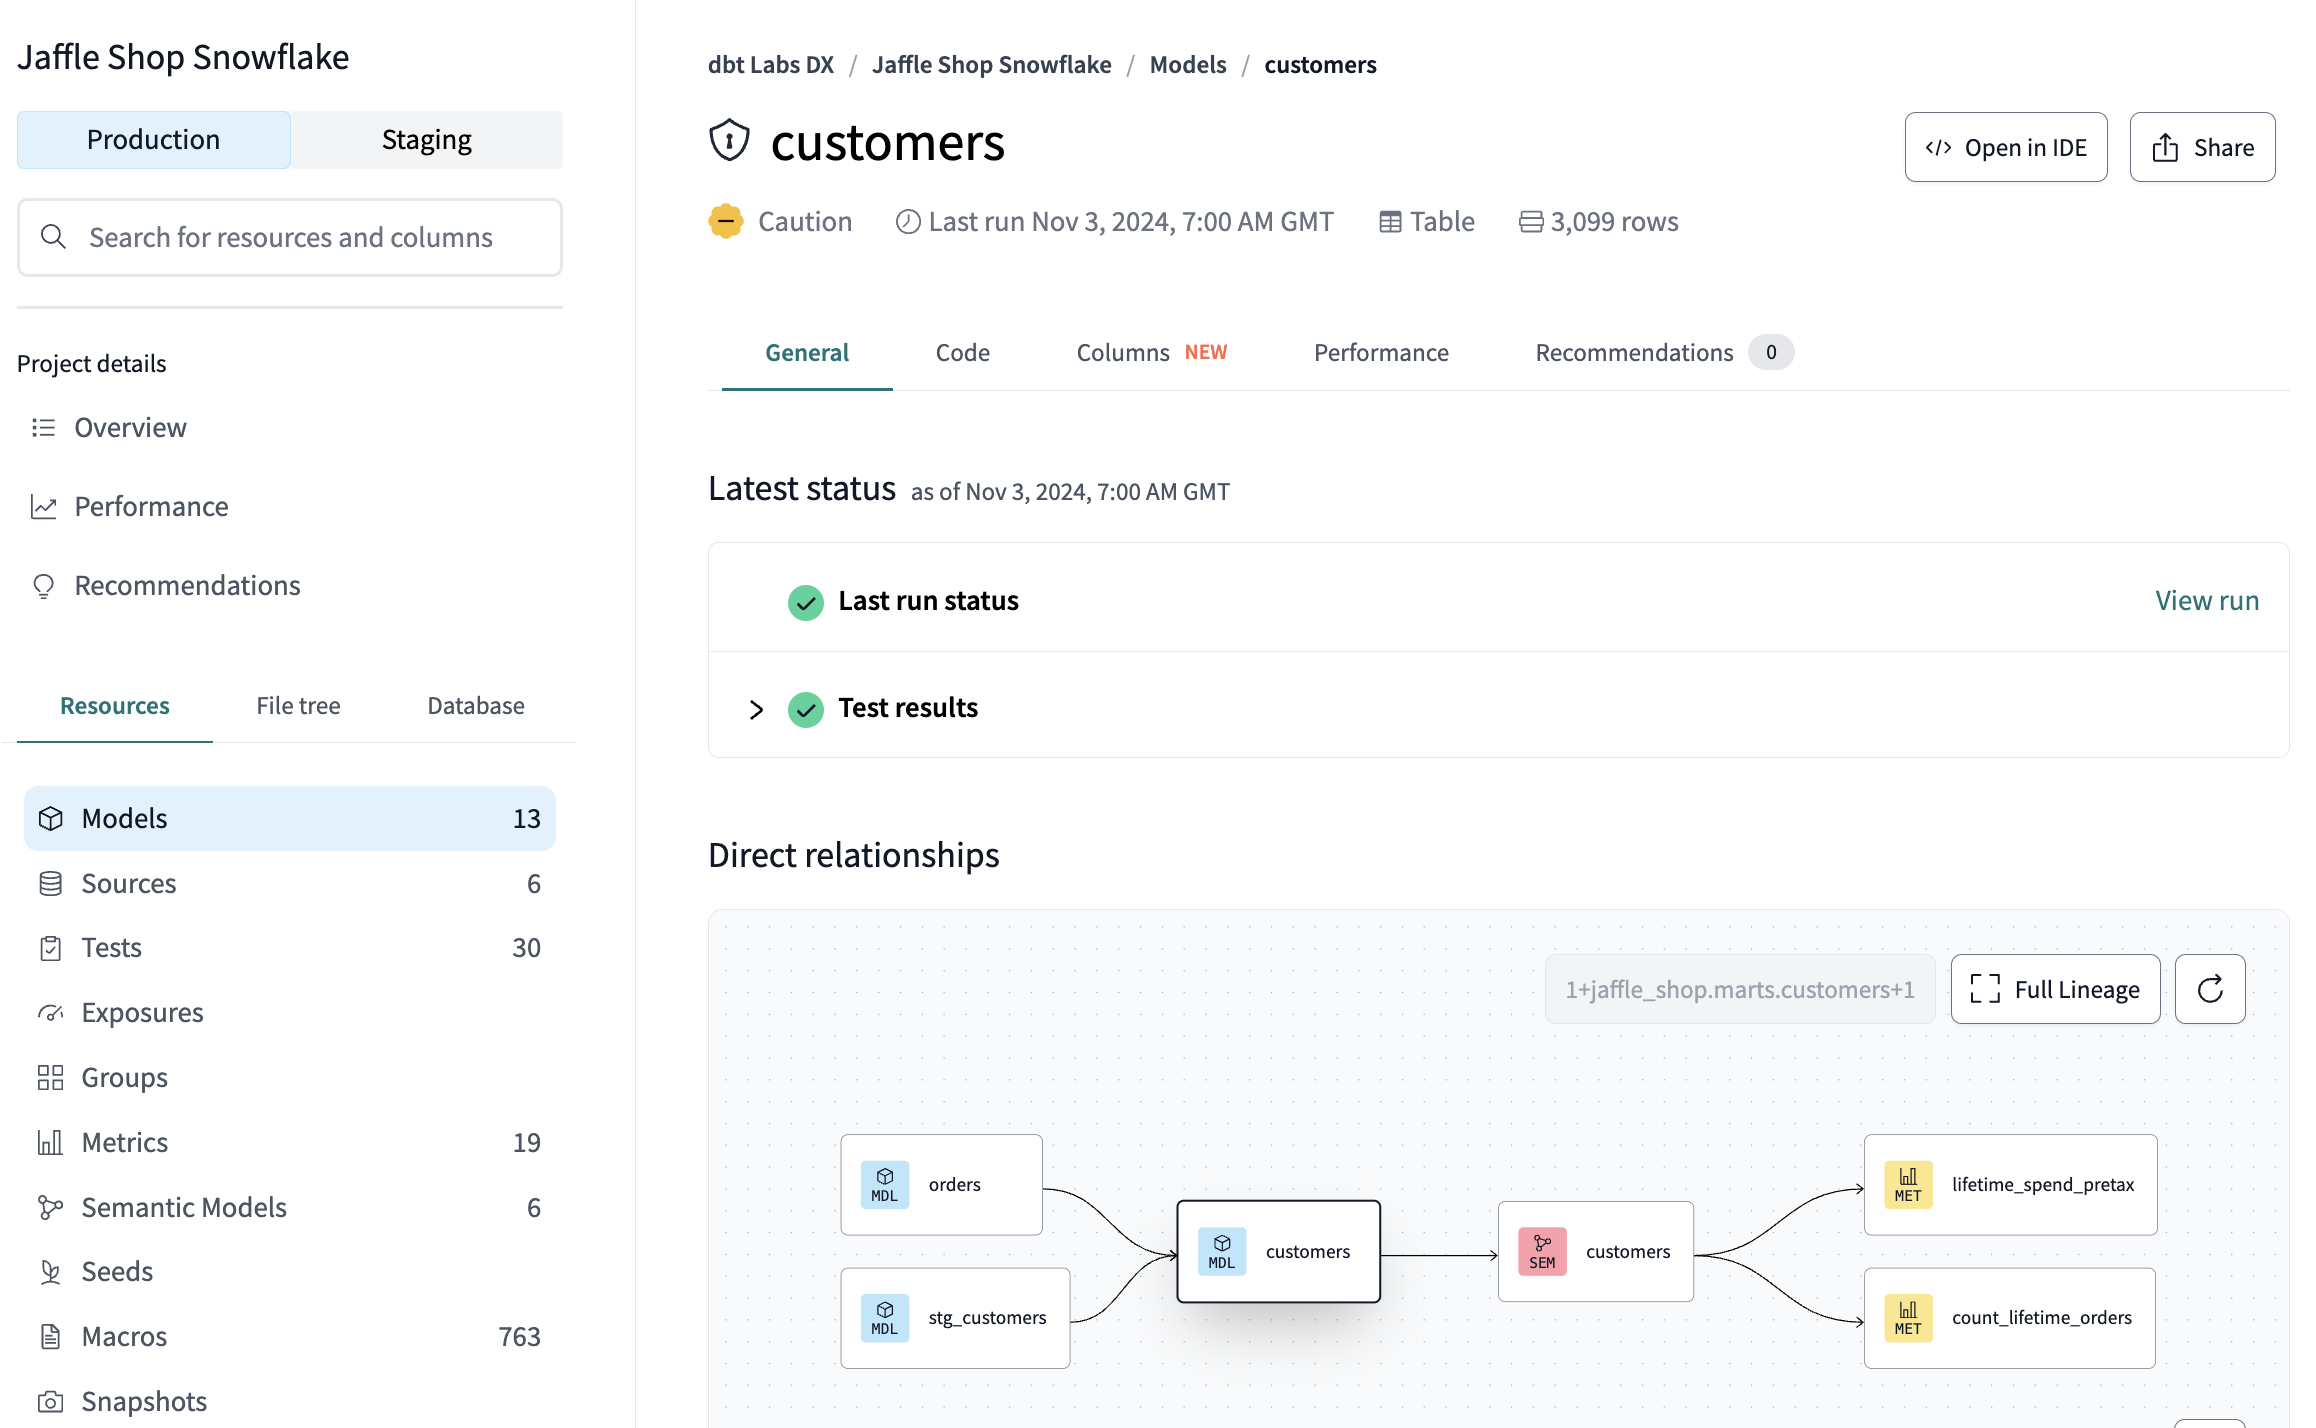 Просмотр документации модели и графа зависимостей в Catalog.
Catalog отображает описание вашей модели, документацию столбцов, тесты данных и граф зависимостей. Вы также можете видеть, для каких столбцов отсутствует документация, и отслеживать покрытие тестами во всем проекте.
Вы можете просматривать документацию непосредственно в IDE, если используете v1 Latest или другую версию dbt v1. Обратите внимание: это устаревший режим просмотра, который не обеспечивает такой же уровень интерактивности, как Catalog.
- В IDE выполните
dbt docs generate. - На панели навигации нажмите значок View docs, расположенный справа от имени ветки.
 Значок View docs в Studio IDE.
- В разделе Projects выберите имя своего проекта и разверните папки.
- Нажмите models > marts > customers.
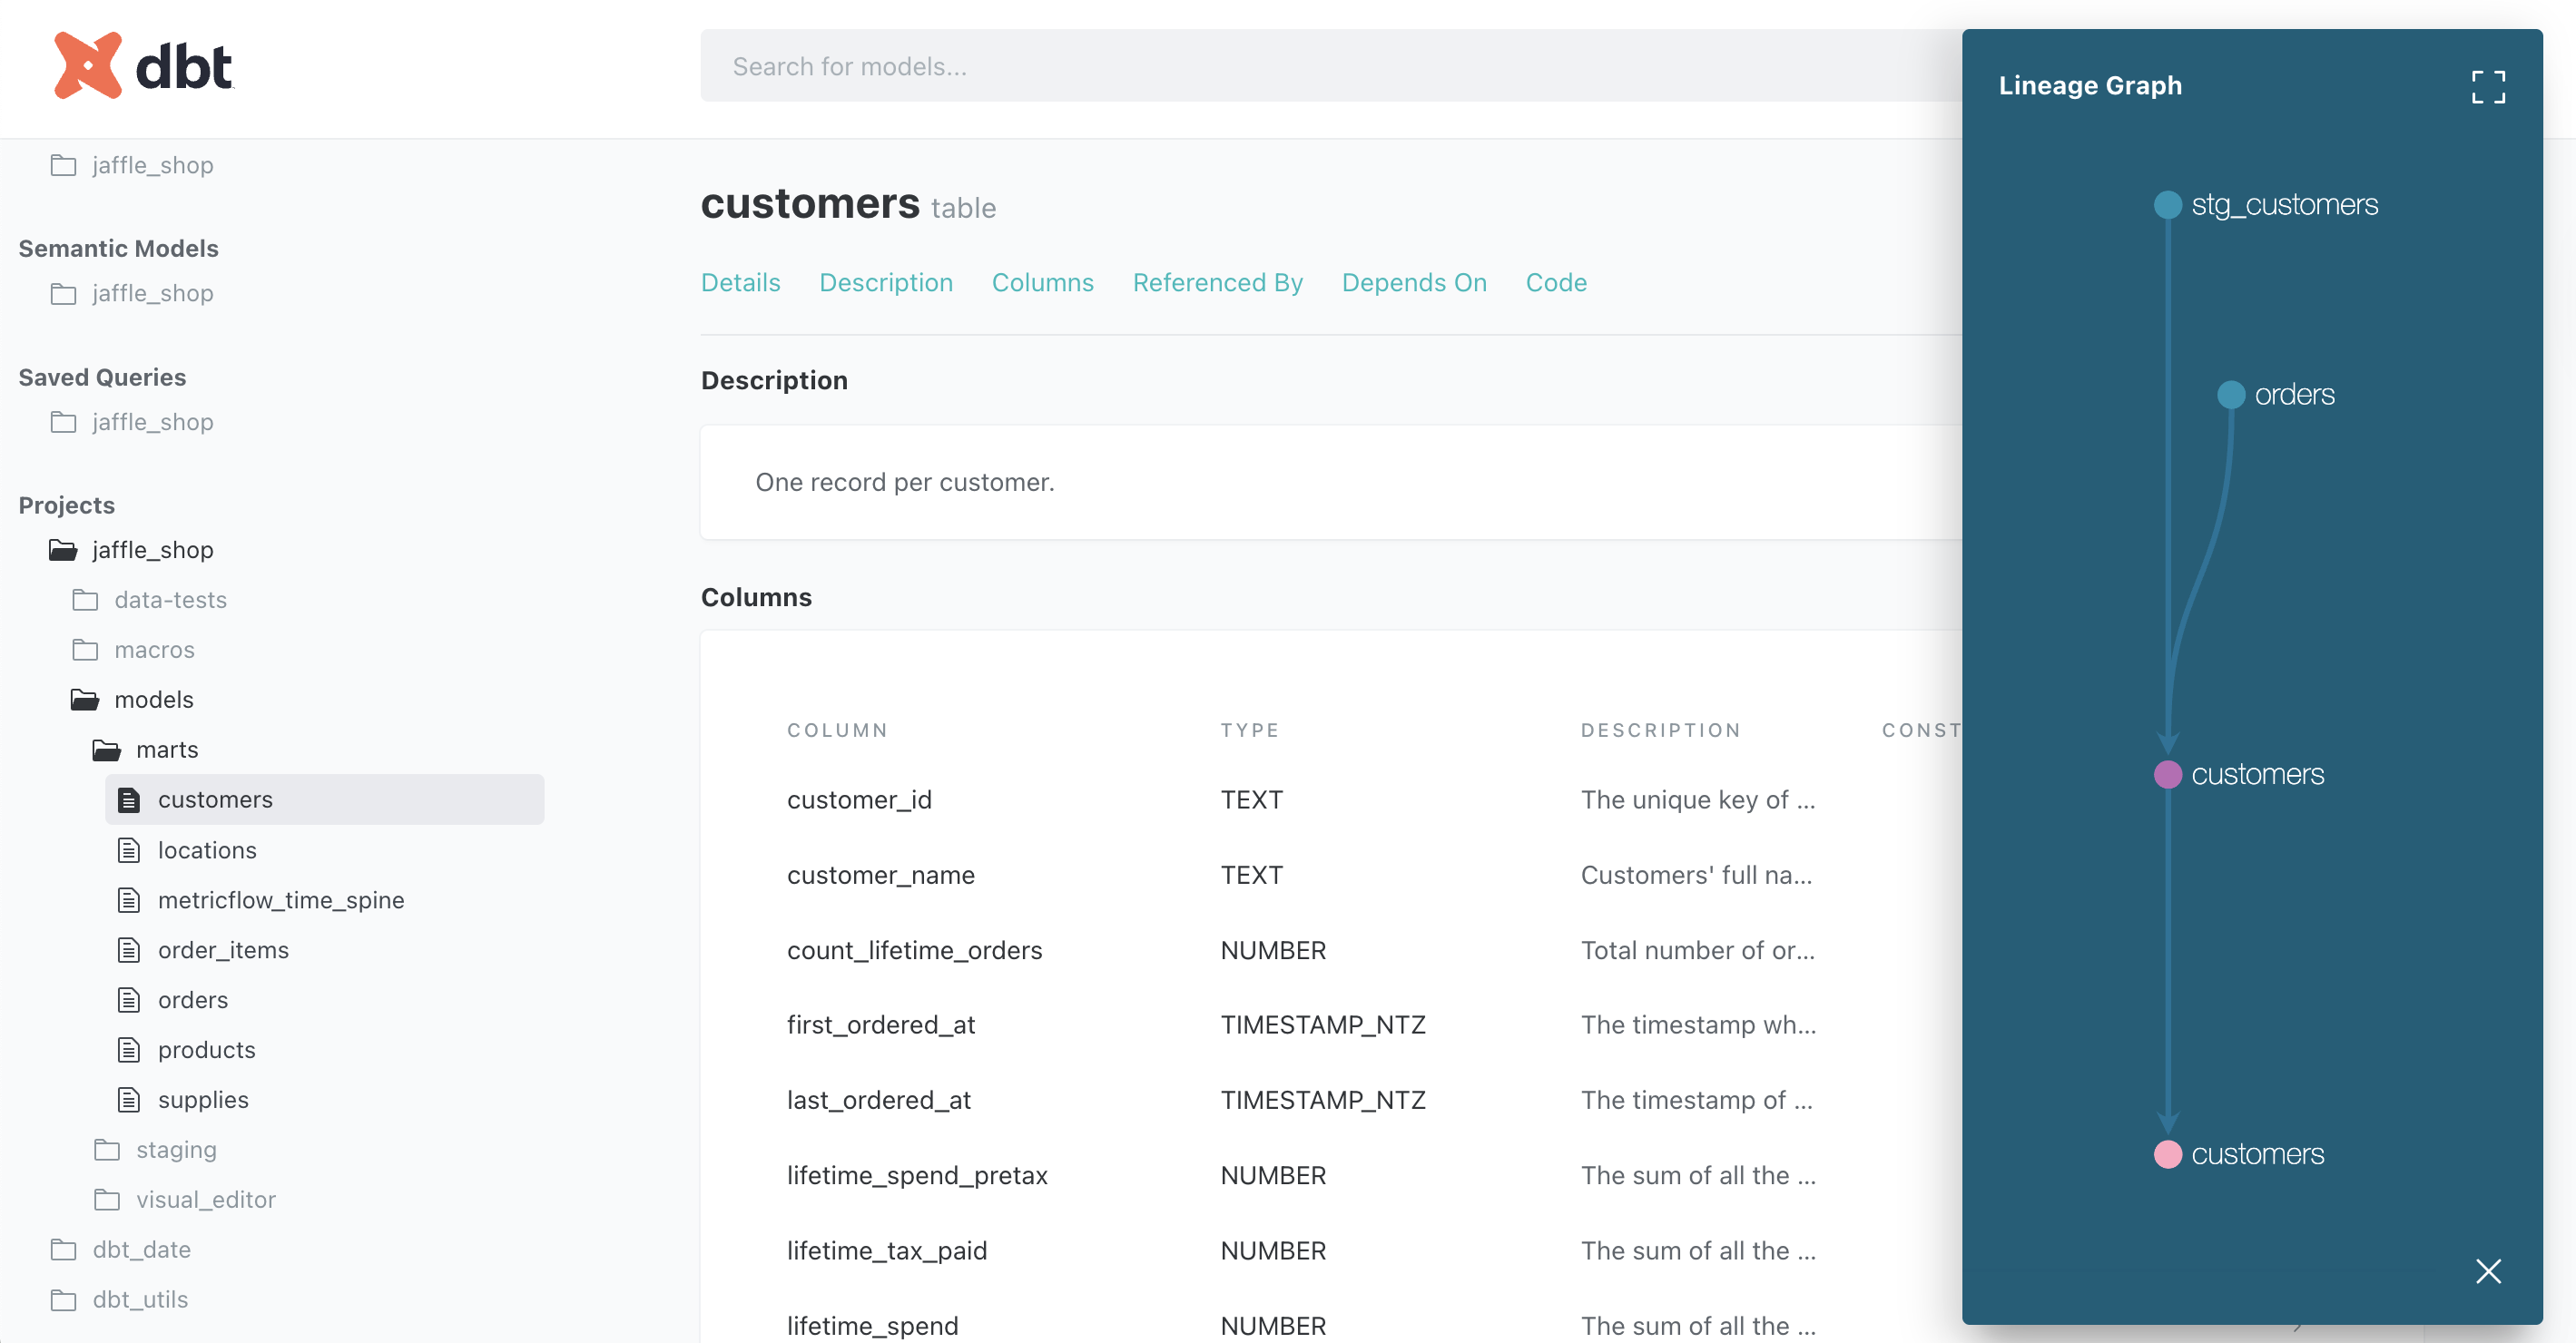 Просмотр документации модели в устаревшем режиме просмотра документации.
Часто задаваемые вопросы
Зафиксируйте изменения
Теперь, когда вы построили модель customers, нужно закоммитить внесённые в проект изменения, чтобы в репозитории оказался ваш актуальный код.
Если вы вносили изменения непосредственно в защищённую основную ветку:
- Нажмите кнопку Commit and sync git. Это действие подготовит ваши изменения к коммиту.
- Появится модальное окно с заголовком Commit to a new branch.
- В модальном окне задайте новой ветке имя
add-customers-model. Будет создана ветка от вашей основной ветки с внесёнными изменениями. - Добавьте сообщение коммита, например «Добавлена модель customers, тесты и документация», и создайте коммит с вашими изменениями.
- Нажмите Merge this branch to main, чтобы добавить эти изменения в ветку main вашего репозитория.
Если вы создали новую ветку до редактирования:
- Поскольку вы уже ответвились от защищённой основной ветки, слева перейдите в Version Control.
- Нажмите Commit and sync, чтобы добавить сообщение.
- Добавьте сообщение коммита, например «Добавить модель customers, тесты и документацию».
- Нажмите Merge this branch to main, чтобы добавить эти изменения в ветку main вашего репозитория.
Разверните dbt
Используйте планировщик dbt, чтобы уверенно запускать задания в продакшене и обеспечивать наблюдаемость ваших процессов. Далее вы узнаете, как создать среду развертывания и запустить задание.
Создайте окружение развертывания (deployment environment)
- В главном меню перейдите в Orchestration > Environments.
- Нажмите Create environment.
- В поле Name введите имя среды развертывания. Например, "Production".
- В поле dbt version по умолчанию выбрана последняя доступная версия. Мы рекомендуем использовать последнюю версию dbt для всех новых проектов.
- В разделе Deployment connection введите имя набора данных, который вы хотите использовать в качестве целевого, например "Analytics". Это позволит dbt создавать объекты в этом наборе данных и работать с ним. В некоторых хранилищах данных целевой набор данных может называться «схемой».
- Нажмите Save.
Создайте и запустите job
Jobs — это набор команд dbt, которые вы хотите запускать по расписанию. Например, dbt build.
По мере того как бизнес jaffle_shop получает больше клиентов, а эти клиенты создают больше заказов, в исходных данных будет появляться больше записей. Поскольку вы материализовали модель customers как таблицу, вам нужно периодически пересобирать её, чтобы данные оставались актуальными. Это обновление будет происходить при запуске job.
- После создания окружения развертывания вы должны попасть на страницу нового окружения. Если нет — в главном меню выберите Orchestration, затем нажмите Jobs.
- Нажмите Create job > Deploy job.
- Укажите имя job (например, «Production run») и выберите окружение, которое вы только что создали.
- Прокрутите вниз до раздела Execution settings.
- В разделе Commands добавьте эту команду как часть job, если её нет:
dbt build
- (Версии dbt: v2.0 и новее) Добавлять шаг создания документации не нужно. При каждом запуске задания метаданные вашего проекта в Catalog обновляются автоматически.
- В этом упражнении не задавайте расписание запуска проекта — хотя проект вашей организации должен запускаться регулярно, для этого примера запуск по расписанию не нужен. Настройку запуска задания по расписанию иногда называют развёртыванием проекта.
- Нажмите Save, затем нажмите Run now, чтобы запустить задание.
- Нажмите на запуск и следите за его ходом в разделе Run summary.
- После завершения запуска (Версии dbt: v2.0 и новее) нажмите Catalog на панели навигации, чтобы изучить свой проект.
Поздравляем 🎉! Вы только что развернули свой первый dbt‑проект!
Часто задаваемые вопросы
Теперь, когда ваш проект настроен и работает, подключите к нему свой ИИ-инструмент (например, Claude или ChatGPT) через dbt MCP server, чтобы задавать вопросы о моделях на естественном языке. Описания, тесты и семантические модели помогут сделать его ответы ещё лучше.