Настройка CI/CD с помощью пользовательских конвейеров
Введение
Один из ключевых принципов dbt заключается в том, что аналитический код должен находиться под контролем версий. Это даёт вашей организации множество преимуществ: удобную совместную работу, единообразие кода, стабильность и возможность отката к предыдущей версии. Платформа хостинга кода предоставляет ещё одно преимущество, которое часто упускают из виду или используют не в полной мере. Некоторые из вас, возможно, уже использовали функциональность вебхуков в dbt для запуска задания при создании PR. Это отличная возможность, которая подходит для большинства сценариев тестирования кода перед его слиянием с кодом рабочей среды. Однако иногда организации нужны дополнительные возможности, например запуск рабочих процессов при каждом коммите (для проверки кода линтером) или после завершения слияния. В этой статье мы покажем, как настроить собственные конвейеры для проверки вашего проекта линтером и запуска задания dbt через API.
Некоторые из вас, возможно, уже имеют опыт использования функциональности webhook в для запуска job при создании PR. Это отличная возможность, которая покрывает большинство сценариев тестирования кода перед слиянием в production. Однако существуют ситуации, когда организации требуется дополнительная функциональность — например, запуск workflows при каждом коммите (linting) или запуск workflows после завершения слияния.
В этой статье мы покажем, как настроить кастомные pipelines для линтинга вашего проекта и запуска job в через API.
Примечание о терминологии в этой статье, так как каждая платформа хостинга кода использует разные термины для схожих концепций. Термины pull request (PR) и merge request (MR) используются взаимозаменяемо, чтобы обозначить процесс слияния одной ветки с другой.
Что такое конвейеры?
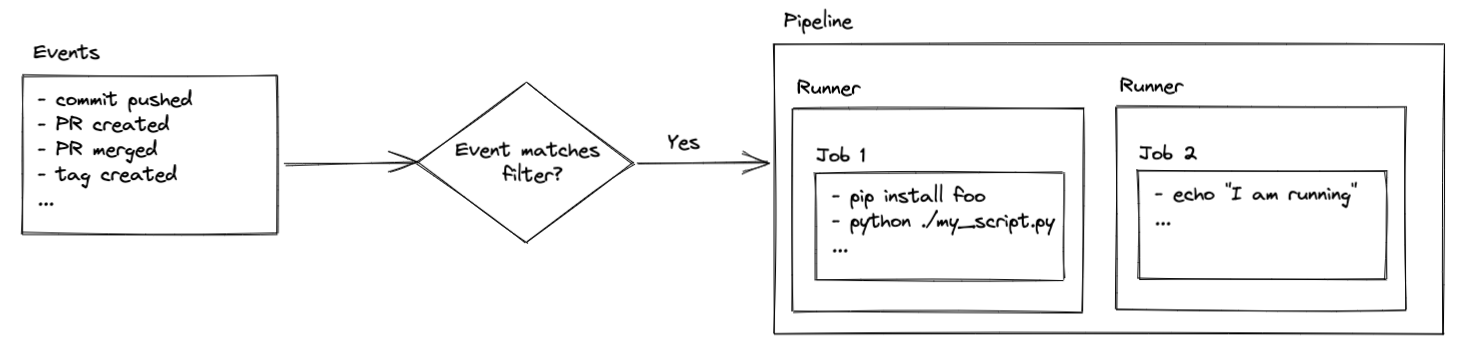
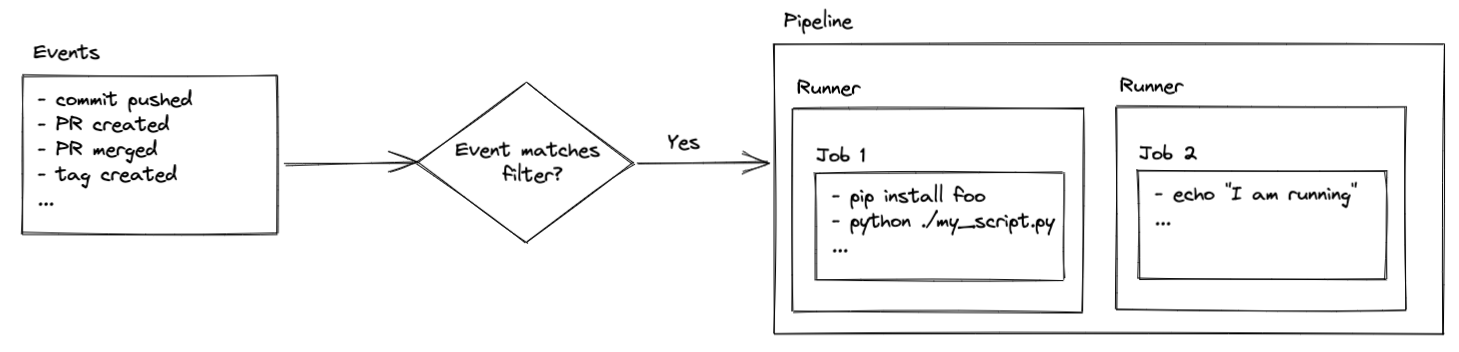 Схема работы конвейеров
Задания выполняются на раннерах, которые являются виртуальными серверами. Раннеры предварительно настроены с Ubuntu Linux, macOS или Windows. Это означает, что команды, которые вы выполняете, определяются операционной системой вашего раннера. Вы увидите, как это будет использоваться позже в настройке, но пока просто помните, что ваш код выполняется на виртуальных серверах, которые, как правило, размещаются платформой хостинга кода.
Обратите внимание, что раннеры, размещенные вашей платформой хостинга кода, предоставляют определенное количество бесплатного времени. После этого могут применяться платежные сборы в зависимости от того, как настроена ваша учетная запись. Вы также можете разместить свои собственные раннеры. Это выходит за рамки данной статьи, но ознакомьтесь с приведенными ниже ссылками, если вам интересно настроить это:
- Информация о биллинге для раннеров, размещенных в репозитории:
- Информация о самостоятелных раннерах:
Кроме того, если вы используете бесплатный тарифный план GitLab, вы все равно можете следовать этому руководству, но вас могут попросить предоставить кредитную карту для подтверждения вашей учетной записи. Вы увидите что-то подобное, когда впервые попытаетесь запустить конвейер:
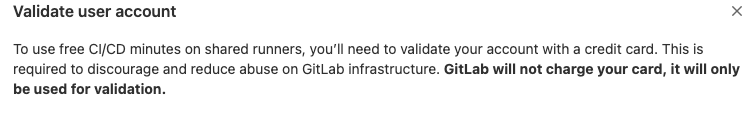 Предупреждение GitLab о необходимости указать платежные данные
Это руководство предоставляет подробности для нескольких платформ хостинга кода. Где шаги уникальны, они представлены без опции выбора. Если код специфичен для платформы (например, GitHub, GitLab, Bitbucket), вы увидите опцию выбора для каждой.
Конвейеры могут быть запущены различными событиями. Процесс вебхука dbt Cloud уже запускает выполнение, если вы хотите запускать свои задания на запрос слияния, поэтому это руководство сосредоточено на запуске конвейеров для каждого пуша и при слиянии PR. Поскольку пуши происходят часто в проекте, мы сделаем это задание супер простым и быстрым, используя линтинг с SQLFluff. Конвейер, который запускается на запросах слияния, будет запускаться реже и может быть использован для вызова API dbt Cloud для запуска конкретного задания. Это может быть полезно, если у вас есть специфические требования, которые должны выполняться при обновлении кода в продакшене, например, выполнение --full-refresh на всех затронутых инкрементальных моделях.
Пайплайны могут запускаться по различным событиям. Механизм вебхуков dbt уже запускает выполнение заданий при создании запроса на слияние, поэтому в этом руководстве основное внимание уделяется запуску пайплайнов при каждом push и при слиянии PR. Поскольку push в проекте выполняются часто, мы сделаем это задание максимально простым и быстрым: оно будет проверять код с помощью SQLFluff. Пайплайн, запускаемый при запросах на слияние, будет выполняться реже, и его можно использовать для вызова API dbt, чтобы запустить определённое задание. Это может быть полезно, если при обновлении кода в production необходимо выполнить особые действия, например запустить --full-refresh для всех затронутых инкрементальных моделей.
Так как push’и в проекте происходят часто, мы сделаем этот job максимально простым и быстрым, ограничившись линтингом с помощью SQLFluff. Пайплайн, который запускается при merge request, будет выполняться реже и может использоваться для вызова API с целью запуска конкретного job’а. Это может быть полезно, если у вас есть особые требования, которые должны выполняться при обновлении кода в production, например запуск --full-refresh для всех затронутых инкрементальных моделей.
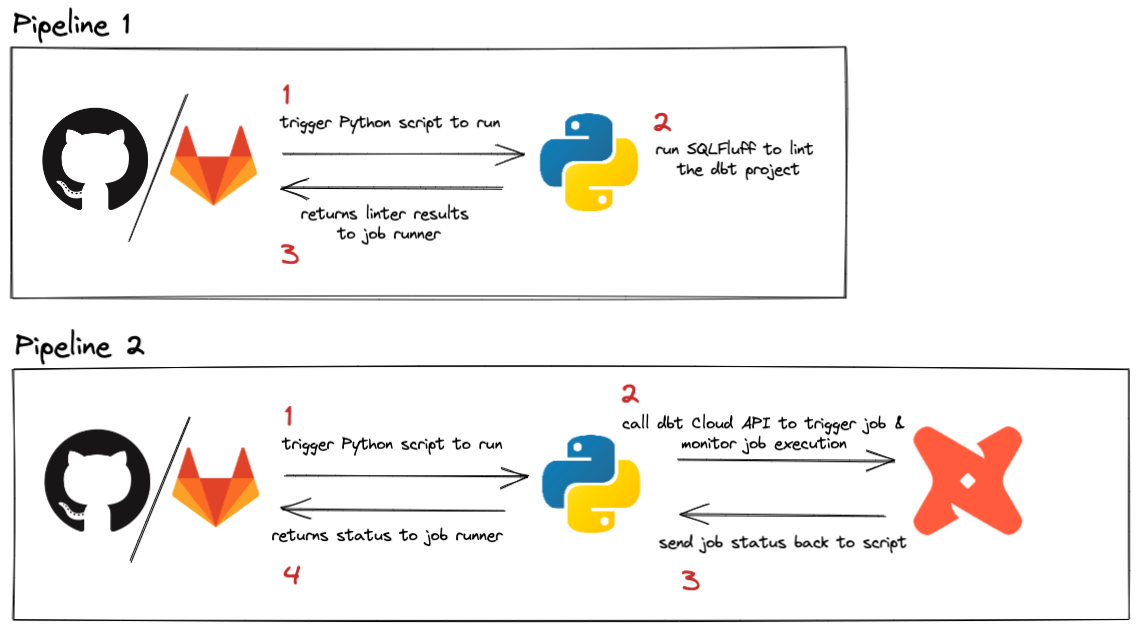 Диаграмма создаваемых конвейеров и задействованных программ
Запуск задания dbt Cloud при слиянии
Настройка этого задания потребует немного больше усилий, но оно служит хорошим примером того, как вызывать API dbt из конвейера CI/CD. Представленные здесь подходы можно обобщить и применять так, как лучше всего подходит для вашего сценария использования.
Эта задача требует немного больше настроек, но является хорошим примером того, как вызывать API из CI/CD‑пайплайна. Описанные здесь концепции можно обобщить и использовать любым образом, который лучше всего подходит под ваш сценарий.
Если ваш провайдер Git имеет встроенную интеграцию с dbt, вы можете настроить задания слияния в пользовательском интерфейсе.
:::
Приведенная ниже настройка показывает, как вызвать API dbt для запуска задания при каждой отправке изменений в вашу ветку по умолчанию.
1. Получите ваш dbt API key
При запуске конвейера CI/CD следует использовать служебный токен вместо API-ключа отдельного пользователя. Этому посвящена подробная документация, а ниже приведена краткая инструкция (эти действия должен выполнять администратор аккаунта):
- Войдите в свой аккаунт dbt.
- Нажмите на название своего аккаунта в нижней части меню слева и перейдите в Account settings.
- Нажмите Service tokens слева.
- Нажмите + Create service token, чтобы создать новый токен специально для вызовов API из CI/CD.
- Задайте токену имя, например «CICD Token».
- Нажмите кнопку +Add permission в разделе Access и предоставьте этому токену разрешение Job Admin.
- Нажмите Save, и появится серое поле с вашим токеном. Скопируйте его и сохраните в безопасном месте (это пароль, и обращаться с ним следует соответственно).
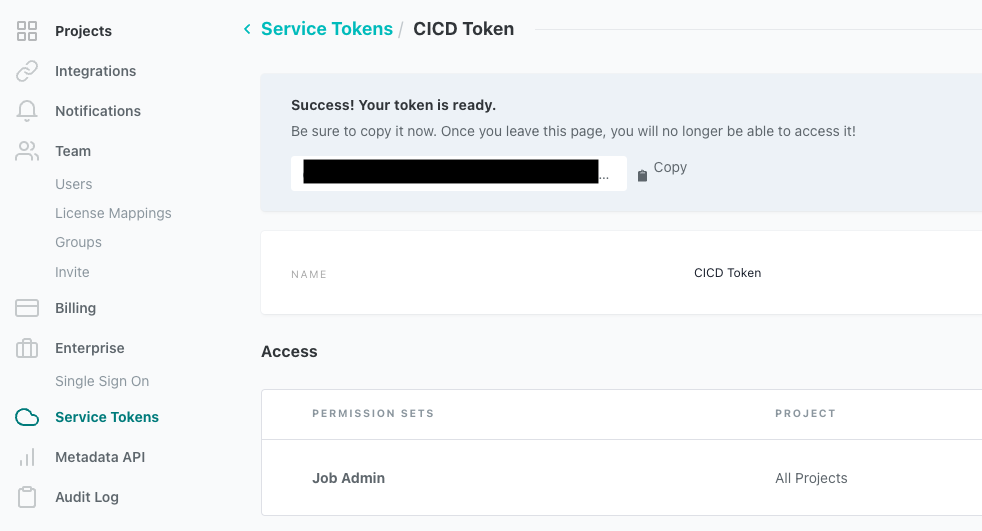 Страница создания сервисных токенов в dbt
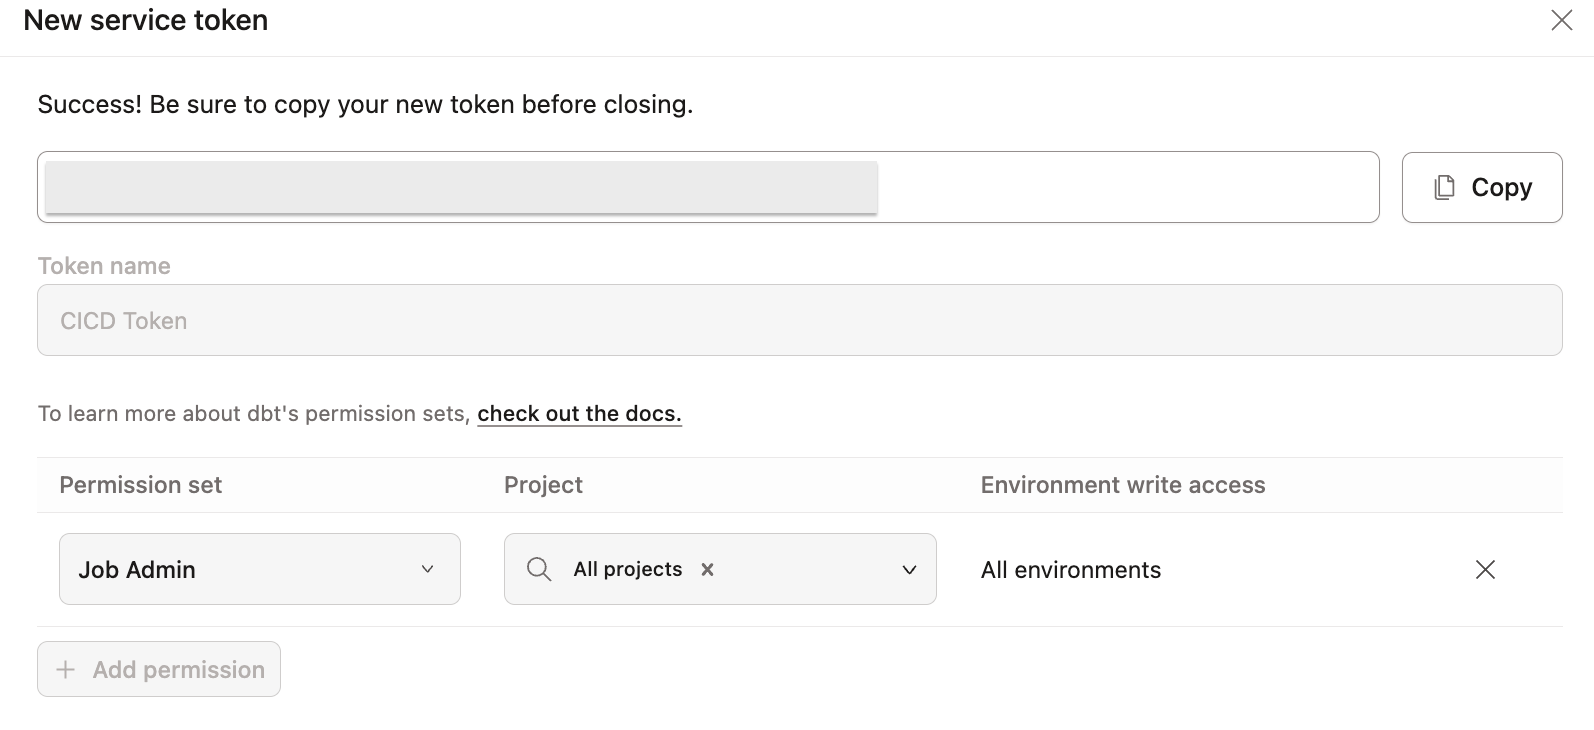 Создание сервисного токена
2. Поместите ваш API-ключ dbt в репозиторий
Добавление API-ключа dbt в ваш репозиторий выполняется на платформе хостинга кода. Вам нужно сохранить API-ключ из предыдущего раздела в качестве секрета репозитория, чтобы задание, которое мы создадим, могло получить к нему доступ. Никогда не сохраняйте пароли или API-ключи в коде. Следующие шаги обеспечат безопасность вашего ключа, сохранив при этом возможность использовать его в ваших пайплайнах.
- GitHub
- GitLab
- Azure DevOps
- Bitbucket
- CodeCommit
- Откройте репозиторий, в котором вы хотите запускать пайплайн (тот же, в котором находится ваш проект dbt).
- Нажмите Settings, чтобы открыть настройки репозитория.
- Слева, в разделе Security, нажмите раскрывающееся меню Secrets and variables.
- В открывшемся списке выберите Actions.
- Ближе к середине экрана нажмите кнопку New repository secret.
- Вам предложат указать имя — назовём наш секрет
DBT_API_KEY.- Очень важно скопировать и вставить это имя в точности, поскольку оно используется в скриптах ниже.
- В поле Secret вставьте ключ, скопированный из dbt.
- Нажмите Add secret — и всё готово!
** Быстрая заметка о безопасности: хотя использование секрета репозитория является самым простым способом настройки этого секрета, в GitHub доступны и другие опции. Они выходят за рамки этого руководства, но могут быть полезны, если вам нужно создать более безопасную среду для выполнения действий. Ознакомьтесь с документацией GitHub о секретах здесь.*
Вот видео, показывающее эти шаги:
-
Откройте репозиторий, в котором вы хотите запускать пайплайн (тот же репозиторий, в котором находится ваш проект dbt).
-
Нажмите Settings > CI/CD.
-
В разделе Variables нажмите Expand, затем нажмите Add variable.
-
Вам будет предложено указать имя переменной. Назовём её
DBT_API_KEY.- Очень важно скопировать и вставить это имя в точности, поскольку оно используется в приведённых ниже скриптах.
-
В поле Value вставьте ключ, скопированный из dbt.
-
Убедитесь, что флажок Protect variable снят, а флажок Mask variable установлен (см. ниже).
- «Protected» означает, что переменная доступна только в пайплайнах, запускаемых для защищённых веток или защищённых тегов. Нам это не подходит, поскольку мы хотим запускать этот пайплайн в нескольких ветках. «Masked» означает, что переменная будет доступна исполнителю пайплайна, но её значение будет скрыто в логах.
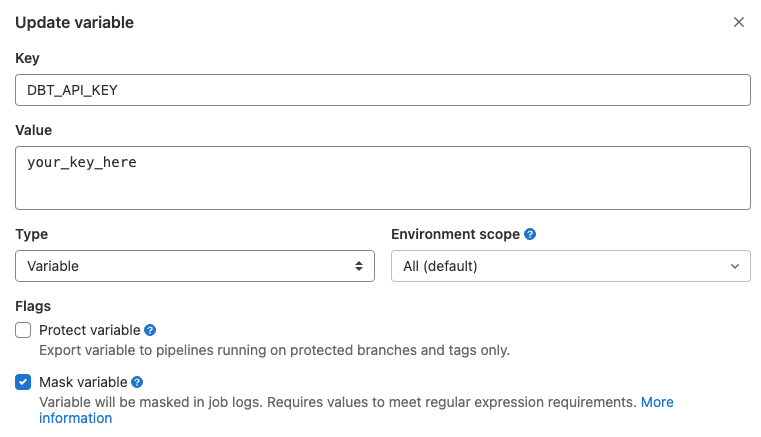 [Вид окна GitLab для ввода DBT_API_KEY
Вот видео, показывающее эти шаги:
В Azure:
- Откройте проект Azure DevOps, в котором вы хотите запускать пайплайн (тот же проект, в котором находится ваш проект dbt).
- Нажмите Pipelines, а затем Create Pipeline.
- Выберите, где хранится ваш код в git. Это должен быть вариант Azure Repos Git.
- Выберите свой репозиторий git из списка.
- Выберите Starter pipeline (он будет обновлён позже, на шаге 4).
- Нажмите Variables, а затем New variable.
- В поле Name введите
DBT_API_KEY.- Очень важно скопировать и вставить это имя без изменений, поскольку оно используется в скриптах ниже.
- В поле Value вставьте ключ, скопированный из dbt.
- Убедитесь, что флажок Keep this value secret установлен. Это скроет значение в логах, и вы не сможете увидеть значение переменной в пользовательском интерфейсе.
- Нажмите OK, а затем Save, чтобы сохранить переменную.
- Сохраните новый пайплайн Azure.
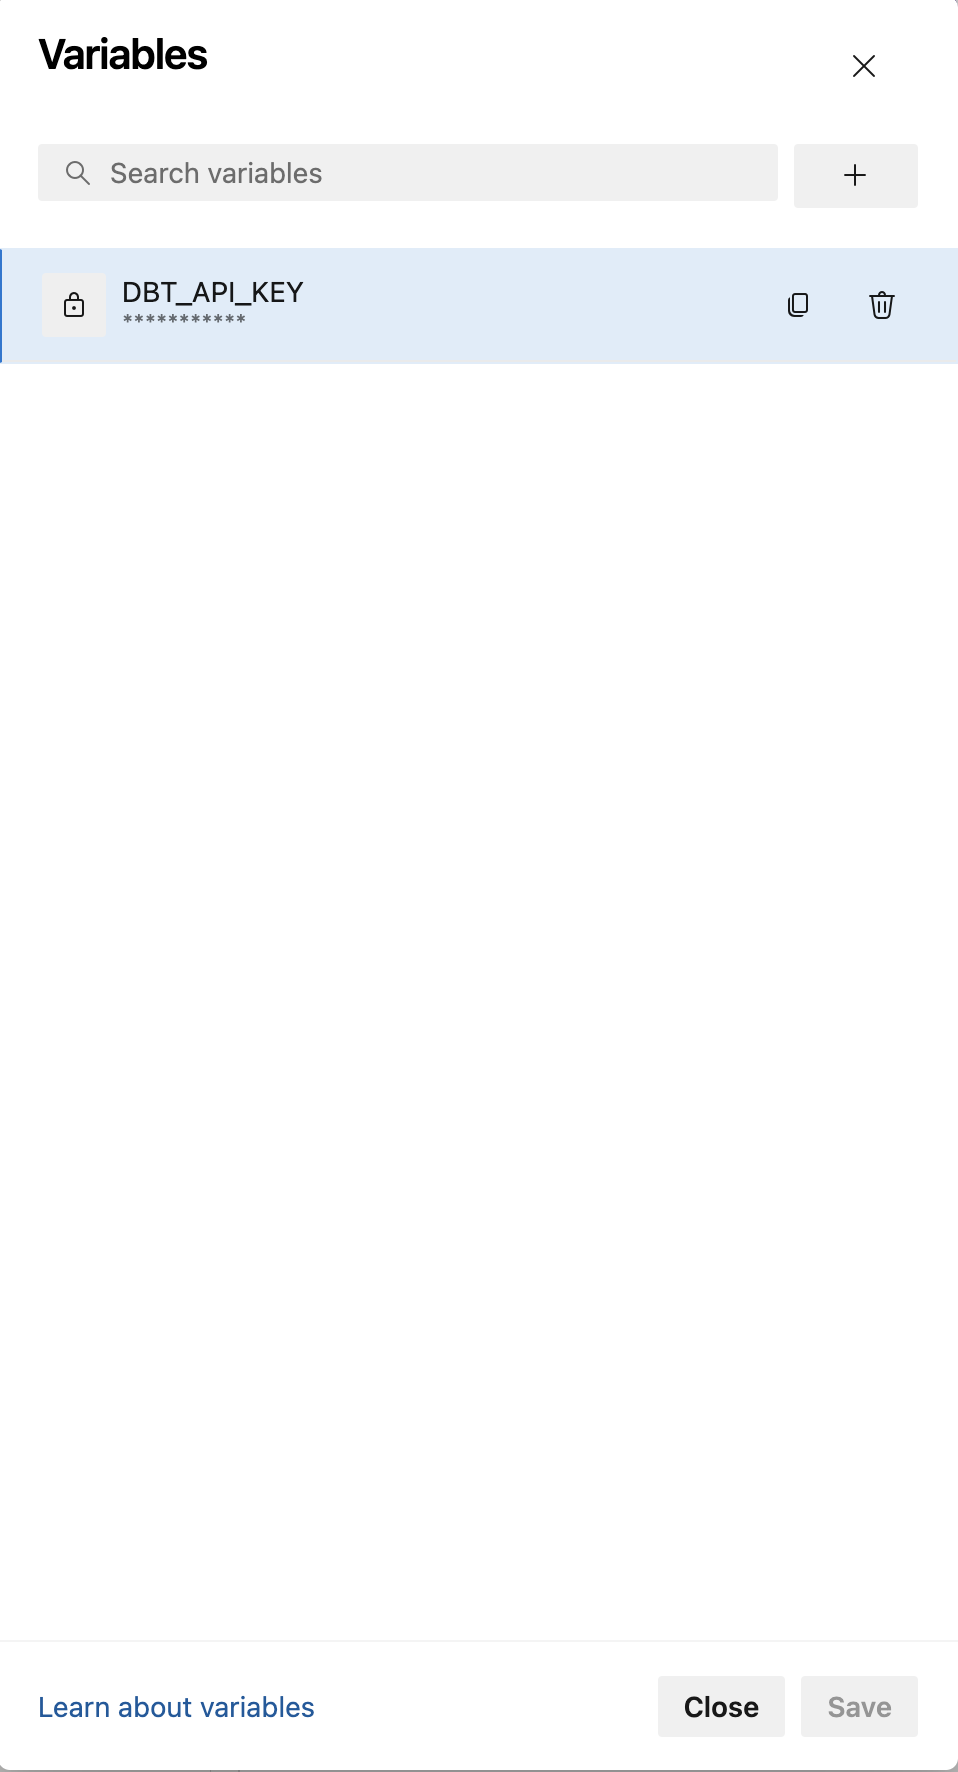 Вид окна конвейеров Azure для ввода DBT_API_KEY
В Bitbucket:
-
Откройте репозиторий, в котором вы хотите запускать пайплайн (тот же репозиторий, где находится ваш проект dbt).
-
В меню слева нажмите Repository Settings.
-
Прокрутите меню слева до конца и выберите Repository variables.
-
В поле Name введите
DBT_API_KEY- Очень важно скопировать и вставить это имя в точности, поскольку оно используется в приведённых ниже скриптах.
-
В поле Value вставьте ключ, скопированный из dbt
-
Убедитесь, что флажок рядом с Secured установлен. Это скроет значение в логах, и вы не сможете увидеть значение переменной в пользовательском интерфейсе.
-
Нажмите Add, чтобы сохранить переменную
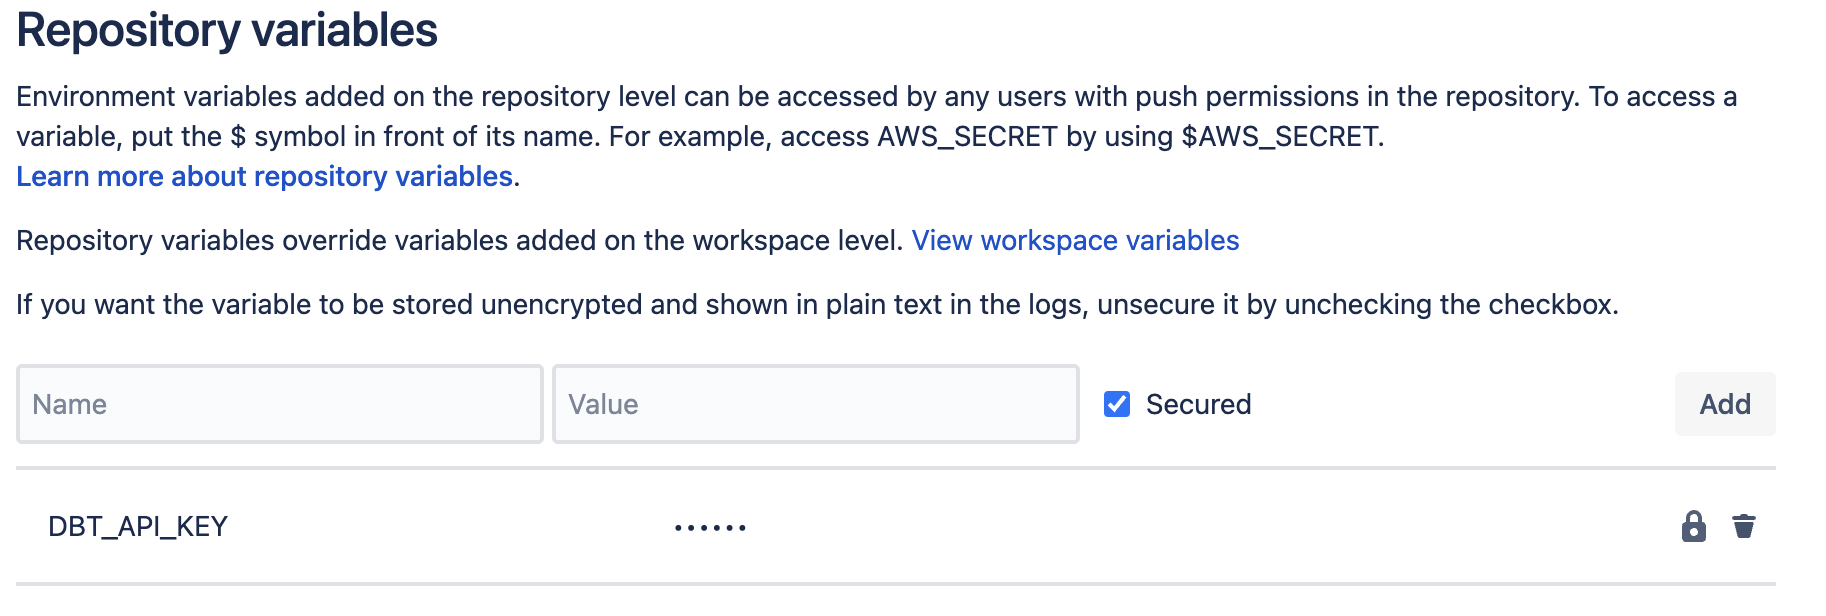 Окно Bitbucket для ввода DBT_API_KEY
Вот видео, показывающее эти шаги:
В AWS храните свой API-ключ в Systems Manager (SSM) Parameter Store, а не в секрете репозитория:
- Откройте консоль AWS и перейдите в Systems Manager → Parameter Store.
- Нажмите Create parameter.
- Введите имя параметра (например,
DBT_API_KEY). - Установите тип SecureString и вставьте свой сервисный токен dbt в качестве значения.
- Нажмите Create parameter.
Вы укажете этот параметр в настройках окружения проекта CodeBuild на шаге 4.
3. Создайте скрипт для запуска dbt‑задачи через API‑вызов
В вашем проекте создайте новую папку на корневом уровне с именем python. В этой папке создайте файл с именем run_and_monitor_dbt_job.py. Скопируйте и вставьте в этот файл содержимое из этого gist.
my_awesome_project
├── python
│   └── run_and_monitor_dbt_job.py
Следующий файл Python содержит всё необходимое для вызова API dbt, но требует нескольких входных параметров, описанных ниже. Эти параметры будут переданы скрипту через переменные окружения, которые будут определены на следующем шаге.
#------------------------------------------------------------------------------
# получение переменных окружения
#------------------------------------------------------------------------------
api_base        = os.getenv('DBT_URL', 'https://cloud.getdbt.com/') # по умолчанию используется URL многопользовательской версии
job_cause       = os.getenv('DBT_JOB_CAUSE', 'API-triggered job') # по умолчанию используется общее сообщение
git_branch      = os.getenv('DBT_JOB_BRANCH', None) # по умолчанию None
schema_override = os.getenv('DBT_JOB_SCHEMA_OVERRIDE', None) # по умолчанию None
api_key         = os.environ['DBT_API_KEY']  # здесь нет значения по умолчанию, просто выбросьте ошибку, если ключ не предоставлен
account_id      = os.environ['DBT_ACCOUNT_ID'] # здесь нет значения по умолчанию, просто выбросьте ошибку, если id не предоставлен
project_id      = os.environ['DBT_PROJECT_ID'] # здесь нет значения по умолчанию, просто выбросьте ошибку, если id не предоставлен
job_id          = os.environ['DBT_PR_JOB_ID'] # здесь нет значения по умолчанию, просто выбросьте ошибку, если id не предоставлен
Требуемый ввод:
Чтобы вызвать API dbt, скрипту потребуется несколько значений. Проще всего получить их, открыв в dbt задание, которое вы хотите запустить. URL-адрес страницы задания содержит все необходимые значения:
DBT_ACCOUNT_ID- это число сразу послеaccounts/в URLDBT_PROJECT_ID- это число сразу послеprojects/в URLDBT_PR_JOB_ID- это число сразу послеjobs/в URL
 URL задания dbt с выделенными частями, обозначающими аккаунт, проект и задание
4. Обновите ваш проект, чтобы включить новый вызов API
- GitHub
- GitLab
- Azure DevOps
- Bitbucket
- CodeCommit
Для этого нового задания добавим файл для вызова API dbt с именем dbt_run_on_merge.yml.
my_awesome_project
├── python
│   └── run_and_monitor_dbt_job.py
├── .github
│   ├── workflows
│   │   └── dbt_run_on_merge.yml
│   │   └── lint_on_push.yml
Файл YAML будет выглядеть довольно похоже на наше предыдущее задание, но есть новый раздел под названием env, который мы будем использовать для передачи необходимых переменных. Обновите переменные ниже, чтобы они соответствовали вашей настройке на основе комментариев в файле.
Стоит отметить, что мы изменили секцию on: так, что теперь workflow запускается только при пушах в ветку с именем main (например, когда pull request был смёрджен). Ознакомьтесь с документацией GitHub по этим фильтрам, чтобы узнать о дополнительных сценариях использования.
Информацию о названиях свойств контекста github и примерах их применения можно найти в документации GitHub.
name: run dbt job on push

# Этот фильтр указывает, что задание следует запускать только при отправке изменений в ветку по умолчанию
# Предполагается, что вы настроили ограничения для этой ветки так, чтобы изменения попадали в неё только через PR
# Укажите имя, соответствующее имени вашей ветки по умолчанию
on:
  push:
    branches:
      - 'main'

jobs:

# это задание вызывает API dbt для запуска задания
  run_dbt_cloud_job:
    name: Run dbt Job
    runs-on: ubuntu-latest

  # Установите переменные окружения, необходимые для выполнения
    env:
      DBT_ACCOUNT_ID: 00000 # введите ваш id учетной записи
      DBT_PROJECT_ID: 00000 # введите ваш id проекта
      DBT_PR_JOB_ID:  00000 # введите ваш id задания
      DBT_API_KEY: ${{ secrets.DBT_API_KEY }}
      DBT_URL: https://cloud.getdbt.com # enter a URL that matches your job
      DBT_JOB_CAUSE: 'GitHub Pipeline CI Job'
      DBT_JOB_BRANCH: ${{ github.head_ref }} # Resolves to the head_ref or source branch of the pull request in a workflow run.

    steps:
      - uses: "actions/checkout@v4"
      - uses: "actions/setup-python@v5"
        with:
          python-version: "3.9"
      - name: Run dbt job
        run: "python python/run_and_monitor_dbt_job.py"
Для этого задания мы настроим его с использованием файла gitlab-ci.yml, как в предыдущем шаге (см. Шаг 1 настройки линтинга для получения дополнительной информации). Файл YAML будет выглядеть довольно похоже на наше предыдущее задание, но есть новый раздел под названием variables, который мы будем использовать для передачи необходимых переменных в скрипт Python. Обновите этот раздел, чтобы он соответствовал вашей настройке на основе комментариев в файле.
Обратите внимание, что раздел rules: теперь говорит запускать только при пушах в ветку с именем main, например, когда PR сливается. Ознакомьтесь с документацией GitLab по этим фильтрам для дополнительных случаев использования.
- Только задание dbt
- Линтинг и задание dbt
image: python:3.9

variables:
  DBT_ACCOUNT_ID: 00000 # введите ваш id учетной записи
  DBT_PROJECT_ID: 00000 # введите ваш id проекта
  DBT_PR_JOB_ID:  00000 # введите ваш id задания
  DBT_API_KEY: $DBT_API_KEY # секретная переменная в учетной записи gitlab
  DBT_URL: https://cloud.getdbt.com
  DBT_JOB_CAUSE: 'GitLab Pipeline CI Job'
  DBT_JOB_BRANCH: $CI_COMMIT_BRANCH

stages:
  - build

# это задание вызывает API dbt для запуска задания
run-dbt-cloud-job:
  stage: build
  rules:
    - if: $CI_PIPELINE_SOURCE == "push" && $CI_COMMIT_BRANCH == 'main'
  script:
    - python python/run_and_monitor_dbt_job.py
image: python:3.9

variables:
  DBT_ACCOUNT_ID: 00000 # введите ваш id учетной записи
  DBT_PROJECT_ID: 00000 # введите ваш id проекта
  DBT_PR_JOB_ID:  00000 # введите ваш id задания
  DBT_API_KEY: $DBT_API_KEY # секретная переменная в учетной записи gitlab
  DBT_URL: https://cloud.getdbt.com
  DBT_JOB_CAUSE: 'GitLab Pipeline CI Job'
  DBT_JOB_BRANCH: $CI_COMMIT_BRANCH

stages:
  - pre-build
  - build

# это задание выполняет SQLFluff с определенным набором правил
# обратите внимание, что диалект установлен на Snowflake, поэтому сделайте это специфичным для вашей настройки
# подробности о правилах линтера: https://docs.sqlfluff.com/en/stable/rules.html
lint-project:
  stage: pre-build
  rules:
    - if: $CI_PIPELINE_SOURCE == "push" && $CI_COMMIT_BRANCH != 'main'
  script:
    - python -m pip install sqlfluff==0.13.1
    - sqlfluff lint models --dialect snowflake --rules L019,L020,L021,L022

# это задание вызывает API dbt для запуска job
run-dbt-cloud-job:
  stage: build
  rules:
    - if: $CI_PIPELINE_SOURCE == "push" && $CI_COMMIT_BRANCH == 'main'
  script:
    - python python/run_and_monitor_dbt_job.py
Для этого нового задания откройте существующий конвейер Azure, который вы создали выше, и выберите кнопку Редактировать. Мы хотим отредактировать соответствующий YAML-файл конвейера Azure с соответствующей конфигурацией, вместо стартового кода, а также включить раздел variables для передачи необходимых переменных.
Скопируйте приведённый ниже YAML-файл в свой конвейер Azure и обновите переменные ниже в соответствии с вашей конфигурацией, следуя комментариям в файле. Обратите внимание: мы изменили секцию trigger так, чтобы конвейер запускался только при отправке изменений (например, при слиянии PR) в main, но вам следует указать имя вашей ветки по умолчанию.
Ознакомьтесь с документацией Azure по этим фильтрам для дополнительных случаев использования.
name: Run dbt Job

trigger: [ main ] # запускается при пушах в main

variables:
  DBT_URL:                 https://cloud.getdbt.com # без завершающего слэша, настройте это соответствующим образом для однопользовательских развертываний
  DBT_JOB_CAUSE:           'Azure Pipeline CI Job' # предоставьте описательную причину задания здесь для более легкой отладки в будущем
  DBT_ACCOUNT_ID:          00000 # введите ваш id учетной записи
  DBT_PROJECT_ID:          00000 # введите ваш id проекта
  DBT_PR_JOB_ID:           00000 # введите ваш id задания

steps:
  - task: UsePythonVersion@0
    inputs:
      versionSpec: '3.7'
    displayName: 'Use Python 3.7'

  - script: |
      python -m pip install requests
    displayName: 'Install python dependencies'

  - script: |
      python -u ./python/run_and_monitor_dbt_job.py
    displayName: 'Run dbt job '
    env:
      DBT_API_KEY: $(DBT_API_KEY) # Установите эти значения как секреты в веб-интерфейсе Azure pipelines
Для этого задания мы настроим его с использованием файла bitbucket-pipelines.yml, как в предыдущем шаге (см. Шаг 1 настройки линтинга для получения дополнительной информации). Файл YAML будет выглядеть довольно похоже на наше предыдущее задание, но мы передадим необходимые переменные в скрипт Python с помощью операторов export. Обновите этот раздел, чтобы он соответствовал вашей настройке на основе комментариев в файле.
- Только задание
- Линтинг и задание dbt
image: python:3.11.1


pipelines:
  branches:
    'main': # переопределите, если ваша ветка по умолчанию не запускается на ветке с именем "main"
      - step:
          name: 'Run dbt Job'
          script:
            - export DBT_URL="https://cloud.getdbt.com" # если у вас однопользовательское развертывание, настройте это соответствующим образом
            - export DBT_JOB_CAUSE="Bitbucket Pipeline CI Job"
            - export DBT_ACCOUNT_ID=00000 # введите ваш id учетной записи здесь
            - export DBT_PROJECT_ID=00000 # введите ваш id проекта здесь
            - export DBT_PR_JOB_ID=00000 # введите ваш id задания здесь
            - python python/run_and_monitor_dbt_job.py
image: python:3.11.1


pipelines:
  branches:
    '**': # это устанавливает подстановочный знак для запуска на каждой ветке, если не указано имя ниже
      - step:
          name: Lint dbt project
          script:
            - python -m pip install sqlfluff==0.13.1
            - sqlfluff lint models --dialect snowflake --rules L019,L020,L021,L022

    'main': # переопределите, если ваша ветка по умолчанию не запускается на ветке с именем "main"
      - step:
          name: 'Run dbt Job'
          script:
            - export DBT_URL="https://cloud.getdbt.com" # если у вас однопользовательское развертывание, настройте это соответствующим образом
            - export DBT_JOB_CAUSE="Bitbucket Pipeline CI Job"
            - export DBT_ACCOUNT_ID=00000 # введите ваш id учетной записи здесь
            - export DBT_PROJECT_ID=00000 # введите ваш id проекта здесь
            - export DBT_PR_JOB_ID=00000 # введите ваш id задания здесь
            - python python/run_and_monitor_dbt_job.py
Для CodeCommit настройте проект CodeBuild и правило EventBridge, чтобы запускать задание dbt при каждой отправке изменений в ветку по умолчанию, например при слиянии pull request в main.
Добавьте в проект dbt следующие файлы:
my_awesome_project
├── ci-configuration
│   └── buildspec-merge.yml
├── python
│   └── run_and_monitor_dbt_cloud_job.py
Создайте python/run_and_monitor_dbt_cloud_job.py со следующим содержимым:
import requests
import os
import time

api_base        = os.getenv('DBT_URL', 'https://cloud.getdbt.com')
job_cause       = os.getenv('DBT_JOB_CAUSE', 'API-triggered job')
git_branch      = os.getenv('DBT_JOB_BRANCH', None)
schema_override = os.getenv('DBT_JOB_SCHEMA_OVERRIDE', None)
api_key         = os.environ['DBT_API_KEY']
account_id      = os.environ['DBT_ACCOUNT_ID']
project_id      = os.environ['DBT_PROJECT_ID']
job_id          = os.environ['DBT_PR_JOB_ID']

print(f"""
Configuration:
api_base: {api_base}
job_cause: {job_cause}
git_branch: {git_branch}
schema_override: {schema_override}
account_id: {account_id}
project_id: {project_id}
job_id: {job_id}
""")

req_auth_header = {'Authorization': f'Token {api_key}'}
req_job_url = f'{api_base}/api/v2/accounts/{account_id}/jobs/{job_id}/run/'
run_status_map = {
  1:  'Queued',
  2:  'Starting',
  3:  'Running',
  10: 'Success',
  20: 'Error',
  30: 'Cancelled',
}

def run_job(url, headers, cause, branch=None, schema_override=None) -> int:
  req_payload = {'cause': cause}
  if branch:
    req_payload['git_branch'] = branch.replace('refs/heads/', '')
  if schema_override:
    req_payload['schema_override'] = schema_override.replace('-', '_')
  print(f'Triggering job:\n\turl: {url}\n\tpayload: {req_payload}')
  run_job_resp = requests.post(url, headers=headers, data=req_payload).json()
  return run_job_resp['data']['id']

def get_run_status(url, headers) -> str:
  req_status_resp = requests.get(url, headers=headers).json()
  run_status_code = req_status_resp['data']['status']
  return run_status_map[run_status_code]

def main():
  print('Beginning request for job run...')
  try:
    run_id = run_job(req_job_url, req_auth_header, job_cause, git_branch, schema_override)
  except Exception as e:
    print(f'ERROR! - Could not trigger job:\n {e}')
    raise

  req_status_url = f'{api_base}/api/v2/accounts/{account_id}/runs/{run_id}/'
  run_status_link = f'{api_base}/#/accounts/{account_id}/projects/{project_id}/runs/{run_id}/'
  print(f'Job running! See job status at {run_status_link}')

  time.sleep(30)
  while True:
    status = get_run_status(req_status_url, req_auth_header)
    print(f'Run status -> {status}')
    if status in ['Error', 'Cancelled']:
      raise Exception(f'Run failed or canceled. See why at {run_status_link}')
    if status == 'Success':
      print(f'Job completed successfully! See details at {run_status_link}')
      return
    time.sleep(10)

if __name__ == "__main__":
    main()
Создайте ci-configuration/buildspec-merge.yml со следующим содержимым:
Подставьте данные своего аккаунта dbt вместо заполнителей:
YOUR_DBT_ACCOUNT_ID: число послеaccounts/в URL задания dbt.YOUR_DBT_PROJECT_ID: число послеprojects/в URL задания dbt.YOUR_DBT_MERGE_JOB_ID: число послеjobs/в URL задания dbt, которое должно запускаться при слиянии.YOUR_SSM_PARAMETER_NAME: имя параметра SSM, созданного на шаге 2, напримерDBT_API_KEY.
version: 0.2

env:
  variables:
    DBT_ACCOUNT_ID: YOUR_DBT_ACCOUNT_ID
    DBT_PROJECT_ID: YOUR_DBT_PROJECT_ID
    DBT_PR_JOB_ID: YOUR_DBT_MERGE_JOB_ID
    DBT_URL: https://cloud.getdbt.com
    DBT_JOB_CAUSE: 'CodeCommit Merge CI Job'
  parameter-store:
    DBT_API_KEY: "YOUR_SSM_PARAMETER_NAME"

phases:
  install:
    commands:
      - apt-get update -y
      - python -m pip install --upgrade pip
      - pip install requests
  build:
    commands:
      - python -u ./python/run_and_monitor_dbt_cloud_job.py
Создайте проект CodeBuild
Создайте проект по документации AWS CodeBuild. Укажите следующие настройки:
- Source: выберите AWS CodeCommit, укажите тип ссылки Branch и выберите основную ветку.
- Environment: выберите Ubuntu в качестве операционной системы.
- Buildspec: выберите Use a buildspec file и укажите путь
ci-configuration/buildspec-merge.yml.
Запишите имя сервисной роли из раздела Environment. Найдите её в IAM и добавьте встроенную политику, разрешающую чтение и расшифровку параметра SSM:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["ssm:GetParameter", "ssm:GetParameters"],
      "Resource": "arn:aws:ssm:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:parameter/YOUR_SSM_PARAMETER_NAME"
    },
    {
      "Effect": "Allow",
      "Action": ["kms:Decrypt"],
      "Resource": "arn:aws:kms:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:key/alias/aws/ssm"
    }
  ]
}
Создайте правило EventBridge
- В консоли AWS откройте Amazon EventBridge → Rules → Create rule.
- Укажите имя правила, например
dbt-run-on-merge. - В разделе Event pattern выберите Custom pattern и вставьте следующий JSON. Подставьте свои значения вместо
YOUR_AWS_ACCOUNT_ID,YOUR_AWS_REGIONиYOUR_CODECOMMIT_REPO_NAME:
{
  "source": ["aws.codecommit"],
  "account": ["YOUR_AWS_ACCOUNT_ID"],
  "region": ["YOUR_AWS_REGION"],
  "detail-type": ["CodeCommit Repository State Change"],
  "resources": ["arn:aws:codecommit:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:YOUR_CODECOMMIT_REPO_NAME"],
  "detail": {
    "event": ["referenceUpdated"],
    "referenceType": ["branch"],
    "referenceName": ["main"]
  }
}
- В разделе Target выберите AWS service → CodeBuild и укажите созданный проект.
- Когда появится запрос, разрешите EventBridge автоматически создать роль IAM для целевого проекта.
- Сохраните правило.
5. Протестируйте ваше новое действие
Теперь, когда у вас есть новенький action, пора его протестировать! Поскольку он настроен на запуск только при слиянии изменений с веткой по умолчанию, вам нужно создать это изменение и слить его в основную ветку. После этого вы увидите, что запустилось новое задание пайплайна, которое выполнит задание dbt, указанное вами в разделе переменных.
Кроме того, вы увидите это задание в истории запусков dbt. Его будет довольно легко найти: там будет указано, что оно запущено через API, а в разделе INFO будет указана ветка, которую вы использовали в этом руководстве.
- GitHub
- GitLab
- Azure DevOps
- Bitbucket
- CodeCommit
 Запуск задания dbt при слиянии в GitHub
 Задание dbt, запущенное из GitHub
 Запуск задания dbt при слиянии в GitLab
 Задание dbt, запущенное из GitLab
 Запуск задания dbt при слиянии в Azure DevOps
 Задание dbt, запущенное из Azure DevOps
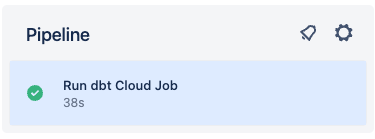 Запуск задания dbt при слиянии в Bitbucket
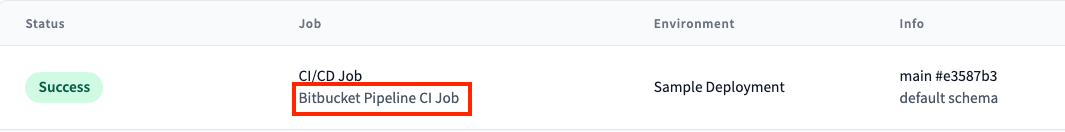 Задание dbt, запущенное из Bitbucket
Чтобы проверить пайплайн, слейте pull request или отправьте коммит прямо в основную ветку. Через несколько секунд в проекте CodeBuild должна начаться сборка. За запуском можно следить в разделе Build history консоли CodeBuild.
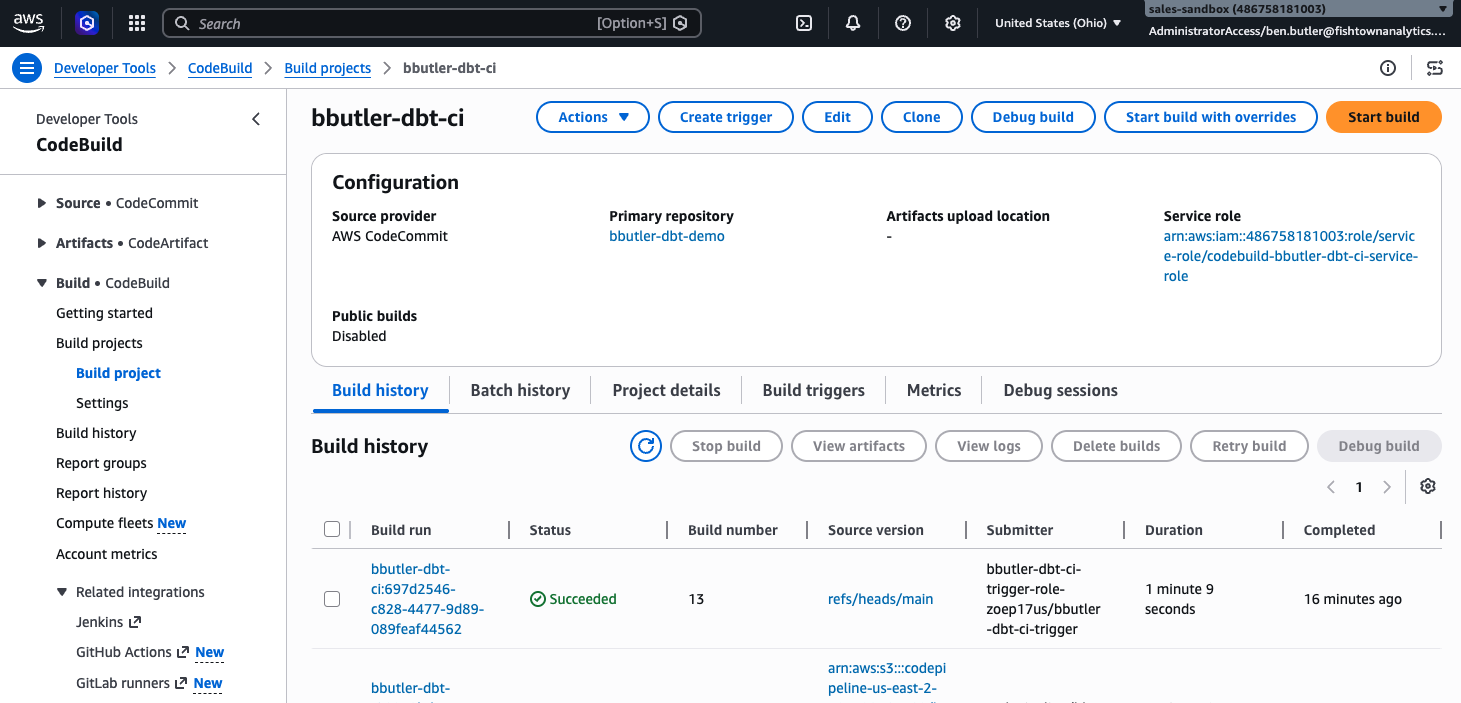 Новая сборка в истории запусков консоли CodeBuild
В истории запусков dbt появится задание с причиной запуска «CodeCommit Merge CI Job».
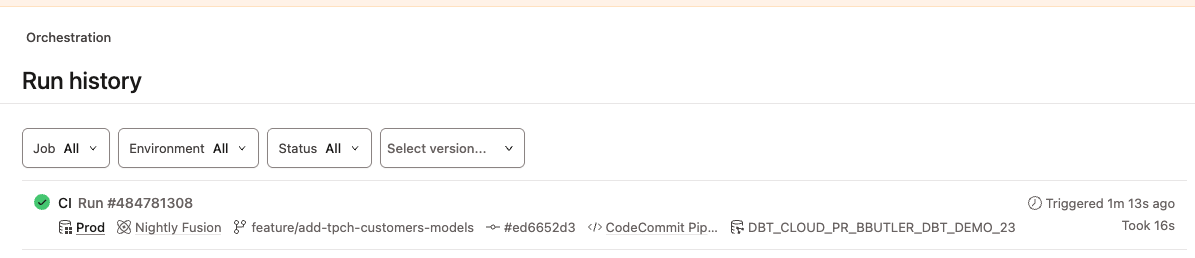 Запуск из CodeCommit в истории запусков dbt
Запуск задания dbt при pull request
Если у вашего Git-провайдера нет встроенной интеграции с dbt, но вы всё же хотите воспользоваться преимуществами CI-сборок, вы обратились по адресу! Приложив немного усилий, можно настроить задание, которое будет запускать задание dbt при создании запроса на слияние (PR).
Если у вашего Git-провайдера есть встроенная интеграция с dbt, вы можете воспользоваться инструкциями по настройке. Этот раздел предназначен только для проектов, которые подключаются к своему Git-репозиторию с помощью SSH-ключа.
Для настройки этого конвейера используются те же шаги, что и на предыдущей странице. Прежде чем продолжить, убедитесь, что вы выполнили шаги 1–5 с предыдущей страницы.
1. Создайте задание конвейера, которое запускается при создании PR
- Bitbucket
- CodeCommit
Для этой задачи мы настроим запуск с помощью файла bitbucket-pipelines.yml, как и на предыдущем шаге. Этот YAML-файл будет очень похож на файл для предыдущей задачи, но необходимые переменные мы передадим в скрипт Python с помощью команд export. Измените этот раздел в соответствии с вашей конфигурацией, следуя комментариям в файле.
Что делает этот пайплайн?
Приведённая ниже конфигурация будет запускать задачу dbt каждый раз, когда в этом репозитории открывается PR. Кроме того, пайплайн будет запускаться заново при каждом новом коммите в PR, пока тот не будет слит.
Например, если вы откроете PR, запустится пайплайн. Если затем вы решите внести дополнительные изменения и выполните коммит и отправку изменений в ветку PR, запустится новый пайплайн с обновлённым кодом.
Например: вы открываете PR — pipeline запускается. Затем вы решаете, что нужны дополнительные изменения, и делаете commit/push в ветку PR — будет запущен новый pipeline с обновлённым кодом.
DBT_JOB_BRANCH: Указывает заданию dbt выполнять код из ветки, из которой был создан этот PRDBT_JOB_SCHEMA_OVERRIDE: Указывает заданию dbt использовать заданную пользователем целевую схему- Формат значения будет следующим:
DBT_CLOUD_PR_{REPO_KEY}_{PR_NUMBER}
- Формат значения будет следующим:
image: python:3.11.1


pipelines:
  # Это задание будет запускаться, когда в репозитории создаются pull requests
  pull-requests:
    '**':
      - step:
          name: 'Run dbt PR Job'
          script:
# Проверка, позволяющая выполнять сборку, только если целевая ветка PR — master (или другая ветка).
            # Закомментируйте или удалите строку ниже, если хотите запускать сборку для всех PR независимо от целевой ветки.
            - if [ "${BITBUCKET_PR_DESTINATION_BRANCH}" != "main" ]; then printf ‘PR Destination is not master, exiting.’; exit; fi
            - export DBT_URL="https://cloud.getdbt.com"
            - export DBT_JOB_CAUSE="Bitbucket Pipeline CI Job"
            - export DBT_JOB_BRANCH=$BITBUCKET_BRANCH
            - export DBT_JOB_SCHEMA_OVERRIDE="DBT_CLOUD_PR_"$BITBUCKET_PROJECT_KEY"_"$BITBUCKET_PR_ID
            - export DBT_ACCOUNT_ID=00000 # введите ваш id учетной записи здесь
            - export DBT_PROJECT_ID=00000 # введите ваш id проекта здесь
            - export DBT_PR_JOB_ID=00000 # введите ваш id задания здесь
            - python python/run_and_monitor_dbt_job.py
Для CodeCommit сначала выполните шаги 1–5 на предыдущей странице: сохраните ключ API, добавьте скрипт Python в репозиторий и настройте пайплайн слияния.
Перед продолжением убедитесь, что вы:
- Подключили проект dbt к CodeCommit по инструкции по интеграции.
- Настроили шаблон URL pull request для CodeCommit в настройках проекта dbt.
- Создали задание CI в dbt. Не включайте запуск по pull request: этот пайплайн запустит задание через API.
Для pull request нужен отдельный проект CodeBuild. Он запускает другое задание dbt, предназначенное для CI, и получает ветку и схему из события pull request во время сборки.
1. Добавьте в проект ci-configuration/buildspec.yml
Этот файл используется отдельно от buildspec-merge.yml с предыдущего шага. Он ссылается на задание CI. Переменные DBT_JOB_BRANCH и DBT_JOB_SCHEMA_OVERRIDE остаются пустыми: функция Lambda передаст их во время сборки.
Подставьте данные своего аккаунта dbt вместо заполнителей:
YOUR_DBT_ACCOUNT_ID: число послеaccounts/в URL задания dbt.YOUR_DBT_PROJECT_ID: число послеprojects/в URL задания dbt.YOUR_DBT_PR_JOB_ID: число послеjobs/в URL задания CI.YOUR_SSM_PARAMETER_NAME: имя параметра SSM, созданного на шаге 2 предыдущей страницы, напримерDBT_API_KEY.
version: 0.2

env:
  variables:
    DBT_ACCOUNT_ID: YOUR_DBT_ACCOUNT_ID
    DBT_PROJECT_ID: YOUR_DBT_PROJECT_ID
    DBT_PR_JOB_ID: YOUR_DBT_PR_JOB_ID
    DBT_URL: https://cloud.getdbt.com
    DBT_JOB_CAUSE: 'CodeCommit Pipeline CI Job'
    DBT_JOB_BRANCH: ''
    DBT_JOB_SCHEMA_OVERRIDE: ''
  parameter-store:
    DBT_API_KEY: "YOUR_SSM_PARAMETER_NAME"

phases:
  install:
    commands:
      - apt-get update -y
      - python -m pip install --upgrade pip
      - pip install requests
  build:
    commands:
      - python -u ./python/run_and_monitor_dbt_cloud_job.py
2. Создайте проект CodeBuild для pull request
По документации AWS CodeBuild создайте второй проект, отдельный от проекта для слияния. Укажите следующие настройки:
- Source: выберите AWS CodeCommit, укажите тип ссылки Branch и выберите основную ветку.
- Environment: выберите Ubuntu в качестве операционной системы.
- Buildspec: выберите Use a buildspec file и укажите путь
ci-configuration/buildspec.yml.
Запишите имя сервисной роли из раздела Environment. Найдите её в IAM и добавьте встроенную политику, разрешающую чтение и расшифровку параметра SSM:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["ssm:GetParameter", "ssm:GetParameters"],
      "Resource": "arn:aws:ssm:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:parameter/YOUR_SSM_PARAMETER_NAME"
    },
    {
      "Effect": "Allow",
      "Action": ["kms:Decrypt"],
      "Resource": "arn:aws:kms:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:key/alias/aws/ssm"
    }
  ]
}
3. Создайте функцию Lambda для запуска сборки
Функция Lambda получает событие pull request от EventBridge, извлекает ветку и идентификатор PR, а затем запускает CodeBuild с этими значениями в переменных окружения. Так задание CI dbt выполняется в ветке PR и использует отдельную схему для этого PR.
- В консоли AWS откройте Lambda → Create function.
- Выберите Author from scratch, укажите имя функции, например
dbt-ci-trigger, и выберите среду выполнения Python 3.12. - Нажмите Create function, затем замените код по умолчанию следующим:
import boto3

def lambda_handler(event, context):
    cb = boto3.client('codebuild')

    source_ref = event['detail']['sourceReference']
    pr_id = event['detail']['pullRequestId']
    repo_name = event['detail']['repositoryNames'][0]

    branch = source_ref.replace('refs/heads/', '')
    schema_override = f'DBT_CLOUD_PR_{repo_name}_{pr_id}'.replace('-', '_').upper()

    print(f'Triggering CodeBuild for branch: {branch}, schema_override: {schema_override}')

    cb.start_build(
        projectName='YOUR_CODEBUILD_PROJECT_NAME',
        environmentVariablesOverride=[
            {'name': 'DBT_JOB_BRANCH', 'value': branch, 'type': 'PLAINTEXT'},
            {'name': 'DBT_JOB_SCHEMA_OVERRIDE', 'value': schema_override, 'type': 'PLAINTEXT'}
        ]
    )
Подставьте имя созданного проекта CodeBuild вместо YOUR_CODEBUILD_PROJECT_NAME, затем нажмите Deploy.
- В разделе Configuration → Permissions нажмите имя роли выполнения, чтобы открыть IAM.
- Добавьте встроенную политику, разрешающую запуск проекта CodeBuild:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "codebuild:StartBuild",
      "Resource": "arn:aws:codebuild:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:project/YOUR_CODEBUILD_PROJECT_NAME"
    }
  ]
}
4. Создайте правило EventBridge
-
В консоли AWS откройте Amazon EventBridge → Rules → Create rule.
-
Укажите имя правила, например
dbt-ci-on-pr-created. -
В разделе Event pattern выберите Custom pattern и вставьте следующий JSON. Подставьте свои значения вместо
YOUR_AWS_ACCOUNT_ID,YOUR_AWS_REGIONиYOUR_CODECOMMIT_REPO_NAME:{
"source": ["aws.codecommit"],
"account": ["YOUR_AWS_ACCOUNT_ID"],
"region": ["YOUR_AWS_REGION"],
"detail-type": ["CodeCommit Pull Request State Change"],
"resources": ["arn:aws:codecommit:YOUR_AWS_REGION:YOUR_AWS_ACCOUNT_ID:YOUR_CODECOMMIT_REPO_NAME"],
"detail": {
"event": ["pullRequestCreated"],
"repositoryNames": ["YOUR_CODECOMMIT_REPO_NAME"]
}
} -
В разделе Target выберите AWS service → Lambda function и укажите созданную функцию.
-
Сохраните правило.
2. Подтвердите, что конвейер запускается
Теперь, когда у вас есть новый конвейер, пришло время запустить его и убедиться, что он работает. Поскольку он запускается только при создании PR, вам нужно будет создать новый PR на ветке, содержащей приведенный выше код. Как только вы это сделаете, вы должны увидеть конвейер, который выглядит следующим образом:
- Bitbucket
- CodeCommit
Пайплайн Bitbucket:
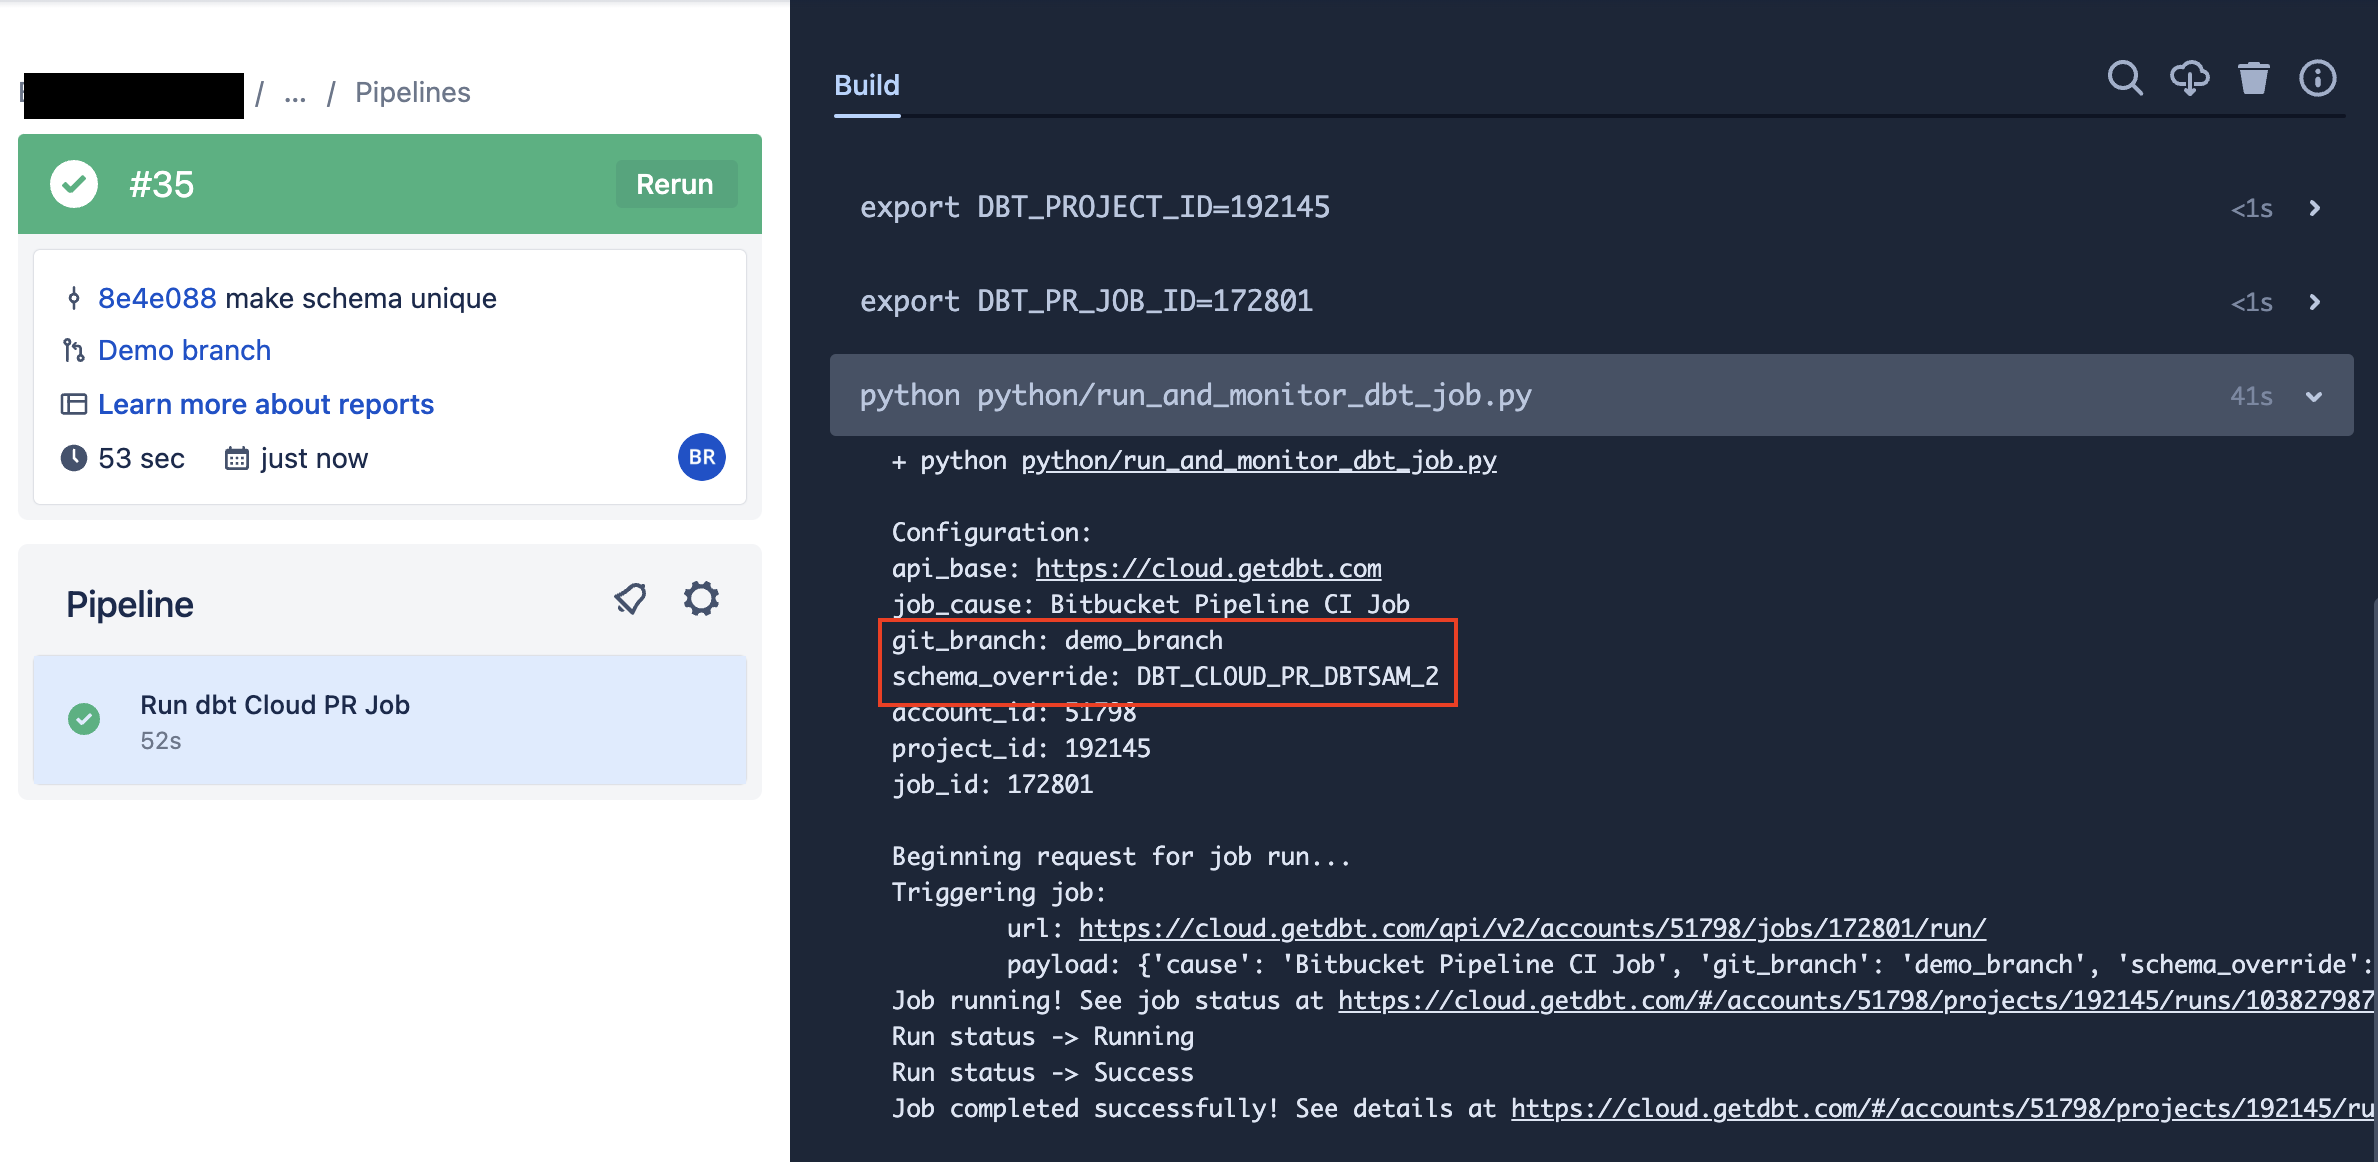 Задание dbt run on PR в Bitbucket
Задание dbt:
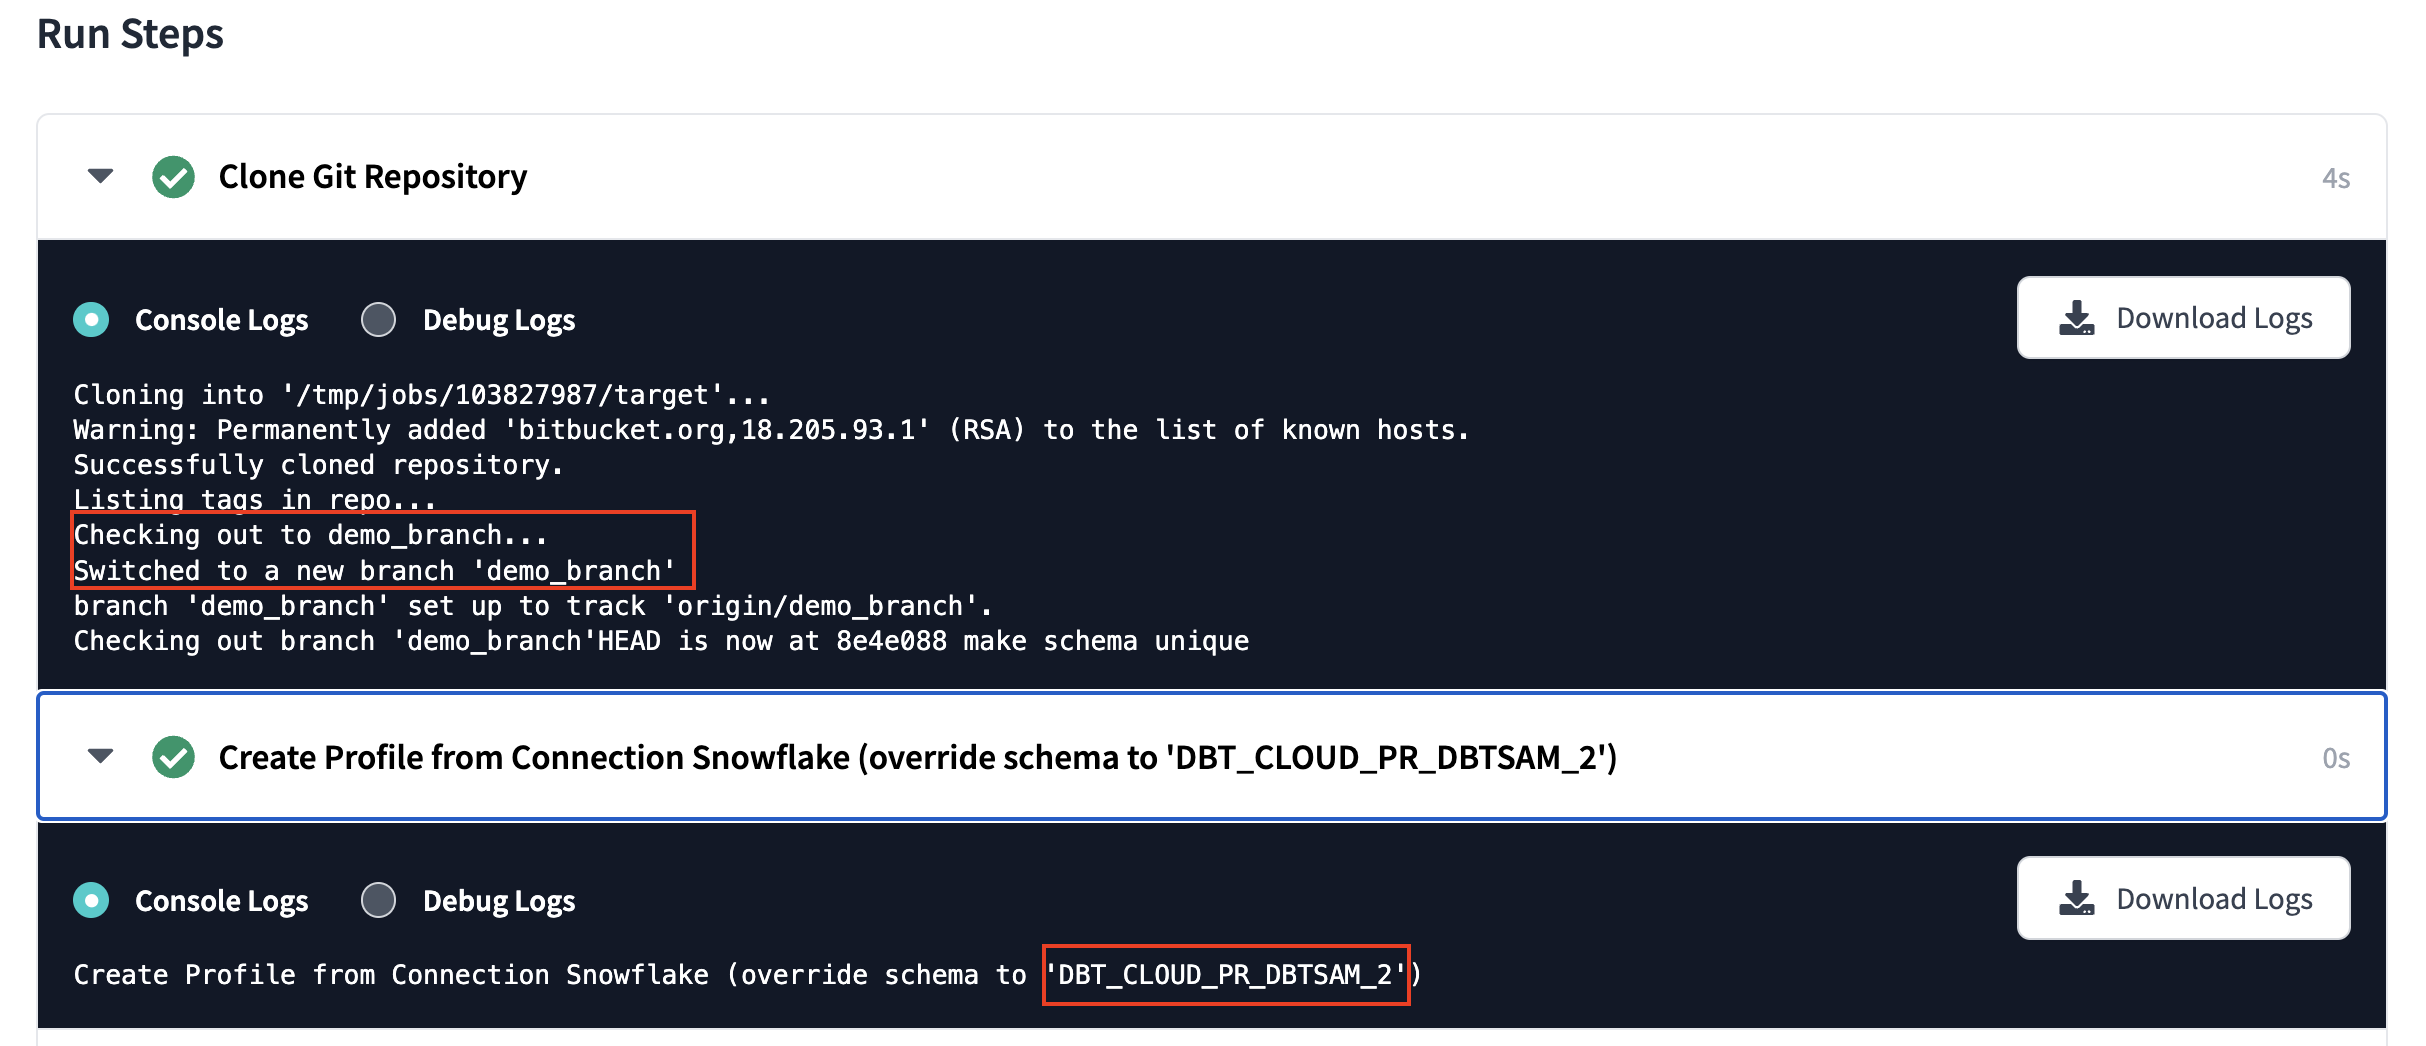 Задание dbt с указанием, что оно запущено из Bitbucket
Чтобы протестировать пайплайн, создайте новый пул-реквест в репозитории CodeCommit из ветки, содержащей файлы, которые вы добавили выше. После открытия пул-реквеста сработает правило EventBridge, Lambda извлечёт имя ветки и идентификатор PR, а CodeBuild запустится автоматически.
Запуск CodeBuild:
Запуск CodeBuild, инициированный пул-реквестом в CodeCommitВ dbt запуск задания появится в истории запусков. В нём будут указаны ветка PR и переопределённое имя схемы в формате DBT_CLOUD_PR_{REPO_NAME}_{PR_NUMBER}:
Задание dbt с указанием, что оно запущено пул-реквестом в CodeCommit3. Обработка этих дополнительных схем в вашей базе данных
Как отмечалось выше, при запуске задания для PR создаётся новая схема на основе этого PR. Чтобы избежать накопления большого количества схем PR в базе данных, рассмотрите возможность добавления задания для очистки в свой аккаунт dbt. Это задание можно запускать по расписанию, чтобы удалять схемы PR, которые в последнее время не обновлялись и не использовались.
Добавьте это как макрос в ваш проект. Он принимает 2 аргумента, которые позволяют контролировать, какие схемы будут удалены:
age_in_days: Количество дней с момента последнего изменения схемы, после которого она должна быть удалена (по умолчанию 10 дней)database_to_clean: Имя базы данных, из которой нужно удалить схемы
{#
    Этот макрос находит схемы PR старше установленной даты и удаляет их
    Макрос по умолчанию удаляет схемы старше 10 дней, но может быть настроен с помощью входного аргумента age_in_days
    Пример использования с другой датой:
        dbt run-operation pr_schema_cleanup --args "{'database_to_clean': 'analytics','age_in_days':'15'}"
#}
{% macro pr_schema_cleanup(database_to_clean, age_in_days=10) %}

    {% set find_old_schemas %}
        select
            'drop schema {{ database_to_clean }}.'||schema_name||';'
        from {{ database_to_clean }}.information_schema.schemata
        where
            catalog_name = '{{ database_to_clean | upper }}'
            and schema_name ilike 'DBT_CLOUD_PR%'
            and last_altered <= (current_date() - interval '{{ age_in_days }} days')
    {% endset %}

    {% if execute %}

        {{ log('Schema drop statements:' ,True) }}

        {% set schema_drop_list = run_query(find_old_schemas).columns[0].values() %}

        {% for schema_to_drop in schema_drop_list %}
            {% do run_query(schema_to_drop) %}
            {{ log(schema_to_drop ,True) }}
        {% endfor %}

    {% endif %}

{% endmacro %}
Этот макрос добавляется в задание dbt, которое запускается по расписанию. Команда будет выглядеть так (текст для копирования и вставки приведён ниже):
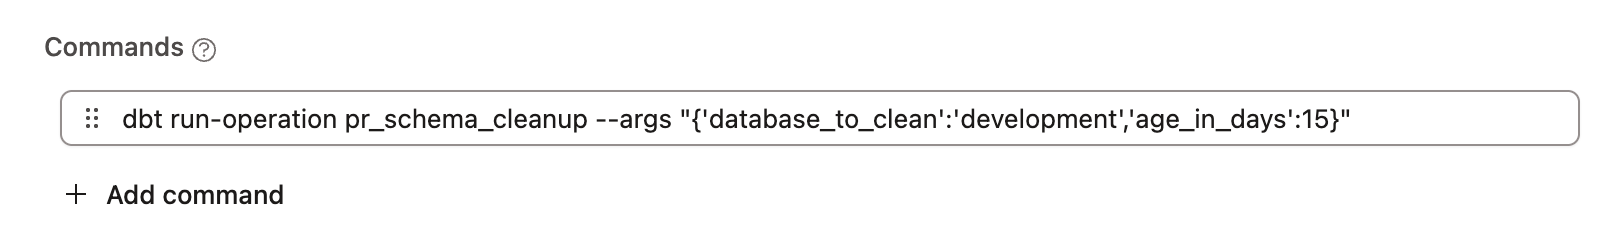 Задание dbt с командой run-operation для макроса очистки
dbt run-operation pr_schema_cleanup --args "{ 'database_to_clean': 'development','age_in_days':15}"
Учитывайте риск конфликтов при использовании нескольких инструментов оркестрации
Запуск заданий dbt через конвейер CI/CD — это один из способов оркестрации заданий. Если вы также запускаете задания с помощью встроенного планировщика dbt, у вас уже два инструмента оркестрации, запускающих задания. Это создаёт риск конфликтов: представьте, что определённые действия запускают конвейер, а одновременно в dbt выполняются задания по расписанию — скорее всего, их запуски будут пересекаться. Чем больше инструментов вы используете, тем больше внимания нужно уделять согласованности их работы.
Тем не менее, если единственная причина, по которой вы хотите использовать конвейеры, — это добавление проверки линтером или запуск при слиянии, вы можете решить, что преимущества перевешивают недостатки, и выбрать гибридный подход. Только помните: если два процесса попытаются одновременно запустить одно и то же задание, dbt поставит запуски в очередь и выполнит их последовательно. Здесь важно найти баланс, но при должном внимании можно организовать оркестрацию заданий так, чтобы их запуски не конфликтовали.