Конфигурации BigQuery
Использование project и dataset в конфигурациях
schemaявляется взаимозаменяемым с понятием BigQuerydatasetdatabaseявляется взаимозаменяемым с понятием BigQueryproject
В справочной документации вы можете объявлять project вместо database.
Это позволит читать и записывать данные из нескольких BigQuery‑проектов. То же самое относится и к dataset.
Использование партиционирования и кластеризации таблиц
Предложение PARTITION
BigQuery поддерживает использование выражения partition by, которое позволяет легко партиционировать table по колонке или выражению. Эта опция помогает снизить задержки и стоимость при запросах к большим таблицам. Обратите внимание, что отсечение партиций (partition pruning) работает только в том случае, если фильтрация партиций выполняется с использованием литеральных значений (то есть выбор партиций через subquery не улучшит производительность).
Конфигурация partition_by может быть задана в виде словаря следующего формата:
{
  "field": "<field name>",
  "data_type": "<timestamp | date | datetime | int64>",
  "granularity": "<hour | day | month | year>"

  # Only required if data_type is "int64"
  "range": {
    "start": <int>,
    "end": <int>,
    "interval": <int>
  }
}
Партиционирование по дате или timestamp
При использовании колонки типа datetime или timestamp для партиционирования данных вы можете создавать партиции с гранулярностью час, день, месяц или год. Колонка типа date поддерживает гранулярность день, месяц и год. Ежедневное партиционирование является значением по умолчанию для всех типов колонок.
Если data_type указан как date, а гранулярность — day, dbt будет передавать поле без изменений
при настройке партиционирования таблицы.
- Source code
- Compiled code
{{ config(
    materialized='table',
    partition_by={
      "field": "created_at",
      "data_type": "timestamp",
      "granularity": "day"
    }
)}}

select
  user_id,
  event_name,
  created_at

from {{ ref('events') }}
create table `projectname`.`analytics`.`bigquery_table`
partition by timestamp_trunc(created_at, day)
as (

  select
    user_id,
    event_name,
    created_at

  from `analytics`.`events`

)
Партиционирование по дате или timestamp загрузки (ingestion)
BigQuery поддерживает более старый механизм партиционирования, основанный на времени загрузки каждой строки. Хотя мы рекомендуем по возможности использовать более новый и удобный подход к партиционированию, для очень больших наборов данных этот более механистичный подход может дать некоторые улучшения производительности. Подробнее см. описание инкрементальной стратегии insert_overwrite ниже.
dbt всегда инструктирует BigQuery партиционировать таблицу по значениям колонки, указанной в partition_by.field. Если в конфигурации модели указать partition_by.time_ingestion_partitioning равным True, dbt будет использовать эту колонку как вход для псевдоколонки _PARTITIONTIME. В отличие от более нового партиционирования по колонке, в этом случае вы должны убедиться, что значения в колонке партиционирования точно соответствуют временной гранулярности ваших партиций.
- Source code
- Compiled code
{{ config(
    materialized="incremental",
    partition_by={
      "field": "created_date",
      "data_type": "timestamp",
      "granularity": "day",
      "time_ingestion_partitioning": true
    }
) }}

select
  user_id,
  event_name,
  created_at,
  -- values of this column must match the data type + granularity defined above
  timestamp_trunc(created_at, day) as created_date

from {{ ref('events') }}
create table `projectname`.`analytics`.`bigquery_table` (`user_id` INT64, `event_name` STRING, `created_at` TIMESTAMP)
partition by timestamp_trunc(_PARTITIONTIME, day);

insert into `projectname`.`analytics`.`bigquery_table` (_partitiontime, `user_id`, `event_name`, `created_at`)
select created_date as _partitiontime, * EXCEPT(created_date) from (
    select
      user_id,
      event_name,
      created_at,
      -- values of this column must match granularity defined above
      timestamp_trunc(created_at, day) as created_date

    from `projectname`.`analytics`.`events`
);
Партиционирование с использованием целочисленных диапазонов
Если data_type указан как int64, необходимо также указать ключ range
в словаре partition_by. dbt использует значения, указанные в range,
для генерации выражения партиционирования таблицы.
- Source code
- Compiled code
{{ config(
    materialized='table',
    partition_by={
      "field": "user_id",
      "data_type": "int64",
      "range": {
        "start": 0,
        "end": 100,
        "interval": 10
      }
    }
)}}

select
  user_id,
  event_name,
  created_at

from {{ ref('events') }}
create table analytics.bigquery_table
partition by range_bucket(
  user_id,
  generate_array(0, 100, 10)
)
as (

  select
    user_id,
    event_name,
    created_at

  from analytics.events

)
Дополнительные настройки партиционирования
Если для вашей модели настроен partition_by, вы можете дополнительно указать две конфигурации:
-
require_partition_filter(boolean): если установлено вtrue, любой запрос к этой модели обязан указывать фильтр по партиции, иначе запрос завершится ошибкой. Это рекомендуется для очень больших таблиц с очевидной схемой партиционирования, например потоков событий, сгруппированных по дням. Обратите внимание, что это также повлияет на другие модели или тесты dbt, которые пытаются выбирать данные из этой модели. -
partition_expiration_days(integer): если задано для партиций типа date или timestamp, партиция истечёт через указанное количество дней после даты, которую она представляет. Например, партиция для2021-01-01с истечением через 7 дней перестанет быть доступной для запросов с2021-01-08, стоимость её хранения станет нулевой, а содержимое со временем будет удалено. Обратите внимание, что если указано истечение всей таблицы, оно будет иметь приоритет.
{{ config(
    materialized = 'table',
    partition_by = {
      "field": "created_at",
      "data_type": "timestamp",
      "granularity": "day"
    },
    require_partition_filter = true,
    partition_expiration_days = 7
)}}
Предложение CLUSTERING
Таблицы BigQuery могут быть кластеризованы для совместного размещения связанных данных.
Кластеризация по одной колонке:
{{
  config(
    materialized = "table",
    cluster_by = "order_id",
  )
}}

select * from ...
Кластеризация по нескольким колонкам:
{{
  config(
    materialized = "table",
    cluster_by = ["customer_id", "order_id"],
  )
}}

select * from ...
Управление шифрованием KMS
Ключи шифрования, управляемые клиентом, могут быть настроены для таблиц BigQuery с помощью конфигурации модели kms_key_name.
Использование KMS‑шифрования
Чтобы указать имя KMS‑ключа для модели (или группы моделей), используйте конфигурацию модели kms_key_name. В следующем примере kms_key_name задаётся для всех моделей в директории encrypted/ вашего dbt‑проекта.
name: my_project
version: 1.0.0

...

models:
  my_project:
    encrypted:
      +kms_key_name: 'projects/PROJECT_ID/locations/global/keyRings/test/cryptoKeys/quickstart'
Labels и tags
Задание labels
dbt поддерживает задание labels BigQuery для таблиц и представлений, которые он создаёт. Эти labels можно указать с помощью конфигурации модели labels.
Конфигурация labels может быть задана в конфигурации модели или в файле dbt_project.yml, как показано ниже.
Пары ключ‑значение BigQuery для labels длиной более 63 символов обрезаются.
Настройка labels в файле модели
{{
  config(
    materialized = "table",
    labels = {'contains_pii': 'yes', 'contains_pie': 'no'}
  )
}}

select * from {{ ref('another_model') }}
Настройка labels в dbt_project.yml
models:
  my_project:
    snowplow:
      +labels:
        domain: clickstream
    finance:
      +labels:
        domain: finance
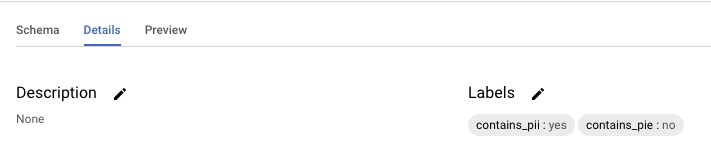 Просмотр labels в консоли BigQuery
Применение labels к заданиям (jobs)
Хотя конфигурация labels применяет labels к таблицам и представлениям, создаваемым dbt, вы также можете применять labels к BigQuery‑заданиям, которые выполняет dbt. Labels заданий полезны для отслеживания стоимости запросов, мониторинга производительности заданий и организации истории заданий BigQuery по метаданным dbt.
По умолчанию labels не применяются напрямую к заданиям. Однако вы можете включить маркировку заданий через комментарии к запросам, выполнив следующие шаги:
Шаг 1
Определите макрос query_comment, чтобы добавлять labels в ваши запросы через комментарий:
-- macros/query_comment.sql
{% macro query_comment(node) %}
    {%- set comment_dict = {} -%}
    {%- do comment_dict.update(
        app='dbt',
        dbt_version=dbt_version,
        profile_name=target.get('profile_name'),
        target_name=target.get('target_name'),
    ) -%}
    {%- if node is not none -%}
      {%- do comment_dict.update(node.config.get("labels", {})) -%}
    {% else %}
      {%- do comment_dict.update(node_id='internal') -%}
    {%- endif -%}
    {% do return(tojson(comment_dict)) %}
{% endmacro %}
Этот макрос создаёт JSON‑комментарий, содержащий метаданные dbt (приложение, версия, профиль, target) и объединяет их с любыми labels, настроенными на уровне модели.
Шаг 2
Включите маркировку заданий в dbt_project.yml, установив comment: "{{ query_comment(node) }}" и job-label: true в конфигурации query-comment:
# dbt_project.yml
name: analytics
profile: bq
version: "1.0.0"

models:
  analytics:
    +materialized: table

query-comment:
  comment: "{{ query_comment(node) }}"
  job-label: true
После включения BigQuery будет разбирать JSON‑комментарий и применять пары ключ‑значение в качестве labels к каждому заданию. Затем вы сможете фильтровать и анализировать задания в консоли BigQuery или через представление INFORMATION_SCHEMA.JOBS, используя эти labels.
Задание tags
Tags таблиц и представлений BigQuery могут быть созданы путём указания пустой строки в качестве значения label.
{{
  config(
    materialized = "table",
    labels = {'contains_pii': ''}
  )
}}

select * from {{ ref('another_model') }}
Вы можете создать новый label без значения или удалить значение у существующего ключа label.
Label с ключом, имеющим пустое значение, также может называться tag в BigQuery. Однако это отличается от BigQuery tag, который условно применяет IAM‑политики к таблицам и датасетам BigQuery. Подробнее см. в документации по Tags.
Resource tags
BigQuery tags позволяют реализовать условный контроль доступа IAM для таблиц и представлений BigQuery. Вы можете применять такие BigQuery tags с помощью конфигурации resource_tags. В этом разделе приведены рекомендации по использованию параметра конфигурации resource_tags.
Resource tags — это пары ключ‑значение, которые должны соответствовать формату тегов BigQuery: {google_cloud_project_id}/{key_name}: value. В отличие от labels, BigQuery tags в первую очередь предназначены для контроля доступа IAM с использованием условных политик, что позволяет организациям:
- Реализовывать условный контроль доступа: применять IAM‑политики в зависимости от BigQuery tags (например, предоставлять доступ только к таблицам с тегом
environment:production). - Обеспечивать управление данными: использовать BigQuery tags вместе с IAM‑политиками для защиты чувствительных данных.
- Управлять доступом в масштабе: единообразно управлять шаблонами доступа в разных проектах и окружениях.
Предварительные требования
- Заранее создайте ключи и значения тегов перед использованием их в dbt.
- Предоставьте необходимые IAM‑разрешения для применения тегов к ресурсам.
Настройка tags в файле модели
Пример настройки tags в файле модели:
{{
  config(
    materialized = "table",
    resource_tags = {
      "my-project-id/environment": "production",
      "my-project-id/data_classification": "sensitive",
      "my-project-id/access_level": "restricted"
    }
  )
}}

select * from {{ ref('another_model') }}
Настройка tags в dbt_project.yml
Пример настройки tags в файле dbt_project.yml:
models:
  my_project:
    production:
      +resource_tags:
        my-project-id/environment: production
        my-project-id/data_classification: sensitive
    staging:
      +resource_tags:
        my-project-id/environment: staging
        my-project-id/data_classification: internal
Совместное использование dbt tags и BigQuery tags
Вы можете использовать существующую конфигурацию tags в dbt вместе с resource_tags BigQuery:
{{
  config(
    materialized = "materialized_view",
    tags = ["reporting", "daily"],  # dbt tags for internal organization
    resource_tags = {  # BigQuery tags for IAM access control
      "my-project-id/environment": "production",
      "my-project-id/data_classification": "sensitive"
    }
  )
}}

select * from {{ ref('my_table') }}
Для получения дополнительной информации о настройке условных IAM‑политик с использованием BigQuery tags см. документацию BigQuery по tags.
Policy tags
BigQuery поддерживает безопасность на уровне колонок за счёт задания policy tags для отдельных колонок.
dbt поддерживает эту возможность как свойство ресурса колонки — policy_tags (не как конфигурацию узла).
models:
- name: policy_tag_table
  columns:
    - name: field
      policy_tags:
        - 'projects/<gcp-project>/locations/<location>/taxonomies/<taxonomy>/policyTags/<tag>'
Обратите внимание, что для того, чтобы policy tags начали действовать, для модели, seed или snapshot должна быть включена настройка column-level persist_docs. Рекомендуется использовать variables для управления таксономиями и убедиться, что к сервисному аккаунту BigQuery добавлены необходимые роли.
Поведение merge (инкрементальные модели)
Конфигурация incremental_strategy определяет, как dbt строит инкрементальные модели. В BigQuery dbt использует оператор merge для обновления инкрементальных таблиц.
Значение incremental_strategy может быть одним из следующих:
merge(по умолчанию)insert_overwritemicrobatch
Производительность и стоимость
Операции, выполняемые dbt при сборке инкрементальной модели BigQuery, можно сделать более дешёвыми и быстрыми, используя кластеризацию в конфигурации модели. Подробнее о тюнинге производительности инкрементальных моделей BigQuery см. в этом руководстве.
Примечание: Эти преимущества по производительности и стоимости применимы к инкрементальным моделям,
построенным как со стратегией merge, так и со стратегией insert_overwrite.
Стратегия merge
Инкрементальная стратегия merge генерирует оператор merge,
который выглядит примерно так:
merge into {{ destination_table }} DEST
using ({{ model_sql }}) SRC
on SRC.{{ unique_key }} = DEST.{{ unique_key }}

when matched then update ...
when not matched then insert ...
Подход merge автоматически обновляет новые данные в целевой инкрементальной таблице, но требует сканирования всех исходных таблиц, на которые ссылается SQL модели, а также целевой таблицы. Это может быть медленно и дорого при больших объёмах данных. Упомянутые ранее техники партиционирования и кластеризации помогают смягчить эти проблемы.
Примечание: Конфигурация unique_key обязательна при выборе инкрементальной
стратегии merge.
Стратегия insert_overwrite
Стратегия insert_overwrite генерирует оператор merge, который заменяет целые партиции
в целевой таблице. Примечание: эта конфигурация требует, чтобы модель была
настроена с использованием Partition clause. Оператор merge,
который генерирует dbt при выборе стратегии insert_overwrite, выглядит примерно так:
/*
  Create a temporary table from the model SQL
*/
create temporary table {{ model_name }}__dbt_tmp as (
  {{ model_sql }}
);

/*
  If applicable, determine the partitions to overwrite by
  querying the temp table.
*/

declare dbt_partitions_for_replacement array<date>;
set (dbt_partitions_for_replacement) = (
    select as struct
        array_agg(distinct date(max_tstamp))
    from `my_project`.`my_dataset`.{{ model_name }}__dbt_tmp
);

/*
  Overwrite partitions in the destination table which match
  the partitions in the temporary table
*/
merge into {{ destination_table }} DEST
using {{ model_name }}__dbt_tmp SRC
on FALSE

when not matched by source and {{ partition_column }} in unnest(dbt_partitions_for_replacement)
then delete

when not matched then insert ...
Подробное описание механики этого подхода см. в этом поясняющем посте.
Определение партиций для перезаписи
dbt может определять партиции для перезаписи динамически на основе значений, присутствующих во временной таблице, либо статически — с использованием пользовательской конфигурации.
«Динамический» подход является самым простым (и используется по умолчанию), однако «статический» подход позволяет снизить стоимость за счёт исключения нескольких запросов в скрипте сборки модели.
Статические партиции
Чтобы задать статический список партиций для перезаписи, используйте конфигурацию partitions.
{% set partitions_to_replace = [
  'timestamp(current_date)',
  'timestamp(date_sub(current_date, interval 1 day))'
] %}

{{
  config(
    materialized = 'incremental',
    incremental_strategy = 'insert_overwrite',
    partition_by = {'field': 'session_start', 'data_type': 'timestamp'},
    partitions = partitions_to_replace
  )
}}

with events as (

    select * from {{ref('events')}}

    {% if is_incremental() %}
        -- recalculate yesterday + today
        where timestamp_trunc(event_timestamp, day) in ({{ partitions_to_replace | join(',') }})
    {% endif %}

),

... rest of model ...
Этот пример модели каждый день заменяет данные в целевой таблице как за сегодня, так и за вчера. Это самый быстрый и дешёвый способ инкрементального обновления таблицы с помощью dbt. Если бы мы хотели сделать это более динамичным образом — например, всегда за последние 3 дня, — мы могли бы использовать встроенные в dbt datetime‑макросы и написать несколько собственных.
Это можно рассматривать как режим «полного контроля». Вы должны убедиться, что выражения или литеральные значения в конфигурации partitions корректно экранированы при шаблонизации и соответствуют partition_by.data_type (timestamp, datetime, date или int64). В противном случае фильтр в инкрементальном операторе merge приведёт к ошибке.
Динамические партиции
Если конфигурация partitions не указана, dbt выполнит следующие шаги:
- Создаст временную таблицу на основе SQL модели
- Выполнит запрос к временной таблице, чтобы определить уникальные партиции для перезаписи
- Выполнит запрос к целевой таблице, чтобы найти максимальную партицию в базе данных
При написании SQL модели вы можете воспользоваться интроспекцией, выполняемой dbt,
чтобы отфильтровать только новые данные. Максимальное значение в партиционированном
поле целевой таблицы будет доступно через переменную BigQuery _dbt_max_partition.
Примечание: это SQL‑переменная BigQuery, а не Jinja‑переменная dbt, поэтому для
доступа к ней не требуются фигурные скобки Jinja.
Пример SQL модели:
{{
  config(
    materialized = 'incremental',
    partition_by = {'field': 'session_start', 'data_type': 'timestamp'},
    incremental_strategy = 'insert_overwrite'
  )
}}

with events as (

  select * from {{ref('events')}}

  {% if is_incremental() %}

    -- recalculate latest day's data + previous
    -- NOTE: The _dbt_max_partition variable is used to introspect the destination table
    where date(event_timestamp) >= date_sub(date(_dbt_max_partition), interval 1 day)

{% endif %}

),

... rest of model ...
Копирование партиций
Если при инкрементальных запусках вы заменяете целые партиции, вы можете использовать copy table API и декораторы партиций вместо оператора merge. Хотя этот механизм не предоставляет такой же прозрачности и удобства отладки, как SQL‑оператор merge, он может дать значительную экономию времени и средств для больших наборов данных, поскольку copy table API не взимает плату за вставку данных — это эквивалент команды bq cp в интерфейсе командной строки gcloud (CLI).
Вы можете включить этот режим, установив copy_partitions: True в конфигурации partition_by. Этот подход работает только в сочетании с «динамической» заменой партиций.
{{ config(
    materialized="incremental",
    incremental_strategy="insert_overwrite",
    partition_by={
      "field": "created_date",
      "data_type": "timestamp",
      "granularity": "day",
      "time_ingestion_partitioning": true,
      "copy_partitions": true
    }
) }}

select
  user_id,
  event_name,
  created_at,
  -- values of this column must match the data type + granularity defined above
  timestamp_trunc(created_at, day) as created_date

from {{ ref('events') }}
...
[0m16:03:13.017641 [debug] [Thread-3 (]: BigQuery adapter: Copying table(s) "/projects/projectname/datasets/analytics/tables/bigquery_table__dbt_tmp$20230112" to "/projects/projectname/datasets/analytics/tables/bigquery_table$20230112" with disposition: "WRITE_TRUNCATE"
...
Управление сроком хранения таблиц
По умолчанию таблицы, созданные dbt, никогда не истекают. Вы можете настроить отдельные модели
на истечение через заданное количество часов, установив hours_to_expiration.
Параметр hours_to_expiration применяется только при первоначальном создании таблицы. Он не сбрасывается для инкрементальных моделей при последующих запусках.
models:
  <resource-path>:
    +hours_to_expiration: 6
{{ config(
    hours_to_expiration = 6
) }}

select ...
Авторизованные представления (Authorized views)
Если для модели, материализованной как представление (view), указана конфигурация grant_access_to,
dbt предоставит модели представления доступ на SELECT к списку указанных датасетов.
Подробнее см.
документацию BigQuery об авторизованных представлениях.
Конфигурации grants и grant_access_to различны.
grant_access_to: Позволяет настроить авторизованные представления. При настройке dbt предоставляет доступ к авторизованному представлению для отображения частичной информации из других наборов данных, не предоставляя конечным пользователям полного доступа к этим исходным наборам данных. Для получения дополнительной информации см. "Конфигурации BigQuery: Авторизованные представления"grants: Предоставляет конкретные разрешения пользователям, группам или сервисным аккаунтам для управления доступом к наборам данных, которые вы создаете с помощью dbt. Для получения дополнительной информации см. "Конфигурации ресурсов: grants"
Вы можете использовать обе функции вместе: "авторизовать" модель представления с помощью конфигурации grant_access_to, а затем добавить grants к этой модели представления, чтобы поделиться результатами её запросов (и только результатами её запросов) с другими пользователями, группами или сервисными аккаунтами.
models:
  <resource-path>:
    +grant_access_to:
      - project: project_1
        dataset: dataset_1
      - project: project_2
        dataset: dataset_2
{{ config(
    grant_access_to=[
      {'project': 'project_1', 'dataset': 'dataset_1'},
      {'project': 'project_2', 'dataset': 'dataset_2'}
    ]
) }}
Представления с такой конфигурацией смогут выполнять SELECT из объектов в project_1.dataset_1 и project_2.dataset_2, даже если они физически расположены в другом месте и запрашиваются пользователями, которые в противном случае не имеют доступа к project_1.dataset_1 и project_2.dataset_2.
Материализованные представления (Materialized views)
Адаптер BigQuery поддерживает материализованные представления со следующими параметрами конфигурации:
| Loading table... |
- Project file
- Property file
- SQL file config
models:
  <resource-path>:
    +materialized: materialized_view
    +on_configuration_change: apply | continue | fail
    +cluster_by: <field-name> | [<field-name>]
    +partition_by:
      - field: <field-name>
      - data_type: timestamp | date | datetime | int64
        # only if `data_type` is not 'int64'
      - granularity: hour | day | month | year
        # only if `data_type` is 'int64'
      - range:
        - start: <integer>
        - end: <integer>
        - interval: <integer>
    +enable_refresh: true | false
    +refresh_interval_minutes: <float>
    +max_staleness: <interval>
    +description: <string>
    +labels: {<label-name>: <label-value>}
    +resource_tags: {<tag-key>: <tag-value>}
    +hours_to_expiration: <integer>
    +kms_key_name: <path-to-key>
models:
  - name: [<model-name>]
    config:
      materialized: materialized_view
      on_configuration_change: apply | continue | fail
      cluster_by: <field-name> | [<field-name>]
      partition_by:
        - field: <field-name>
        - data_type: timestamp | date | datetime | int64
          # only if `data_type` is not 'int64'
        - granularity: hour | day | month | year
          # only if `data_type` is 'int64'
        - range:
          - start: <integer>
          - end: <integer>
          - interval: <integer>
      enable_refresh: true | false
      refresh_interval_minutes: <float>
      max_staleness: <interval>
      description: <string>
      labels: {<label-name>: <label-value>}
      resource_tags: {<tag-key>: <tag-value>}
      hours_to_expiration: <integer>
      kms_key_name: <path-to-key>
{{ config(
    materialized='materialized_view',
    on_configuration_change="apply" | "continue" | "fail",
    cluster_by="<field-name>" | ["<field-name>"],
    partition_by={
        "field": "<field-name>",
        "data_type": "timestamp" | "date" | "datetime" | "int64",

        # only if `data_type` is not 'int64'
        "granularity": "hour" | "day" | "month" | "year,

        # only if `data_type` is 'int64'
        "range": {
            "start": <integer>,
            "end": <integer>,
            "interval": <integer>,
        }
    },

    # auto-refresh options
    enable_refresh= true | false,
    refresh_interval_minutes=<float>,
    max_staleness="<interval>",

    # additional options
    description="<description>",
    labels={
        "<label-name>": "<label-value>",
    },
    resource_tags={
        "<tag-key>": "<tag-value>",
    },
    hours_to_expiration=<integer>,
    kms_key_name="<path_to_key>",
) }}
Многие из этих параметров соответствуют аналогичным параметрам для таблиц и были связаны выше. Набор параметров, уникальных для материализованных представлений, охватывает функциональность автообновления.
Подробнее об этих параметрах см. в документации BigQuery:
Автообновление (Auto-refresh)
| Loading table... |
BigQuery поддерживает конфигурацию автоматического обновления для материализованных представлений.
По умолчанию материализованное представление автоматически обновляется в течение 5 минут после изменений в базовой таблице, но не чаще чем один раз в 30 минут.
BigQuery официально поддерживает настройку только частоты обновления (то есть «не чаще одного раза в 30 минут»);
однако в режиме Preview доступна возможность настройки допустимой устарелости данных (staleness), то есть «обновление через 5 минут».
dbt отслеживает изменения этих параметров и применяет их с помощью оператора ALTER.
Подробнее см. документацию BigQuery:
Ограничения
Как и на большинстве платформ обработки данных, у материализованных представлений есть ограничения. Среди наиболее важных:
- SQL для материализованных представлений имеет ограниченный набор возможностей.
- SQL материализованного представления нельзя изменить; требуется
--full-refresh(DROP/CREATE). - Параметр
partition_byу материализованного представления должен совпадать с параметром базовой таблицы. - Материализованные представления могут иметь описание, но столбцы материализованного представления — нет.
- Пересоздание или удаление базовой таблицы требует пересоздания или удаления материализованного представления.
Дополнительную информацию об ограничениях см. в документации BigQuery.
Конфигурация Python-моделей
Способы отправки заданий (Submission methods):
BigQuery поддерживает несколько механизмов для выполнения Python-кода, каждый со своими преимуществами. Адаптер dbt-bigquery использует BigQuery DataFrames (BigFrames) или Dataproc. В этом процессе данные считываются из BigQuery, вычисления выполняются либо нативно с помощью BigQuery DataFrames, либо в Dataproc, а результаты записываются обратно в BigQuery.
- BigQuery DataFrames
- Dataproc
BigQuery DataFrames позволяют выполнять код pandas и scikit-learn. Нет необходимости управлять инфраструктурой, при этом используются распределённые движки запросов BigQuery. Это отличный вариант для аналитиков, дата-сайентистов и ML-инженеров, которым нужно работать с большими объёмами данных с помощью синтаксиса, похожего на pandas.
Примечание: BigQuery DataFrames выполняются в стандартной среде выполнения Google Colab. Если шаблон runtime с именем default недоступен, адаптер автоматически создаст его и пометит как default для последующего использования (при наличии необходимых прав).
Настройка BigQuery DataFrames:
# IAM permission if using service account

#Create Service Account
gcloud iam service-accounts create dbt-bigframes-sa
#Grant BigQuery User Role
gcloud projects add-iam-policy-binding ${GOOGLE_CLOUD_PROJECT} --member=serviceAccount:dbt-bigframes-sa@${GOOGLE_CLOUD_PROJECT}.iam.gserviceaccount.com --role=roles/bigquery.user
#Grant BigQuery Data Editor role. This can be restricted at dataset level
gcloud projects add-iam-policy-binding ${GOOGLE_CLOUD_PROJECT} --member=serviceAccount:dbt-bigframes-sa@${GOOGLE_CLOUD_PROJECT}.iam.gserviceaccount.com --role=roles/bigquery.dataEditor
#Grant Service Account user
gcloud projects add-iam-policy-binding ${GOOGLE_CLOUD_PROJECT} --member=serviceAccount:dbt-bigframes-sa@${GOOGLE_CLOUD_PROJECT}.iam.gserviceaccount.com --role=roles/iam.serviceAccountUser
#Grant Colab Entperprise User
gcloud projects add-iam-policy-binding ${GOOGLE_CLOUD_PROJECT} --member=serviceAccount:dbt-bigframes-sa@${GOOGLE_CLOUD_PROJECT}.iam.gserviceaccount.com --role=roles/aiplatform.colabEnterpriseUser
models:
  my_dbt_project:
    submission_method: bigframes
my_dbt_project_sa:
  outputs:
    dev:
      compute_region: us-central1
      dataset: <BIGQUERY_DATESET>
      gcs_bucket: <GCS BUCKET USED FOR BIGFRAME LOGS>
      job_execution_timeout_seconds: 300
      job_retries: 1
      keyfile: <SERVICE ACCOUNT KEY FILE>
      location: US
      method: service-account
      priority: interactive
      project: <BIGQUERY_PROJECT>
      threads: 1
      type: bigquery
  target: dev
Dataproc (serverless или заранее настроенный cluster) может выполнять Python-модели как задания PySpark, читая данные из BigQuery и записывая результаты обратно в BigQuery. Режим serverless проще в настройке, но медленнее и имеет ограниченные возможности конфигурации и предустановленные пакеты (pandas, numpy, scikit-learn). Режим cluster даёт полный контроль и более высокую производительность. Dataproc хорошо подходит для сложных, долгих пакетных пайплайнов и унаследованных Hadoop/Spark-нагрузок, но часто медленнее для ad-hoc или интерактивных задач.
Настройка Dataproc:
- Создайте или используйте существующий Cloud Storage bucket.
- Включите Dataproc API для вашего проекта и региона.
- Если используется метод отправки
cluster: создайте или используйте существующий кластер Dataproc с инициализационным действием для Spark BigQuery connector. (Google рекомендует копировать действие в собственный Cloud Storage bucket, а не использовать пример из скриншота.)
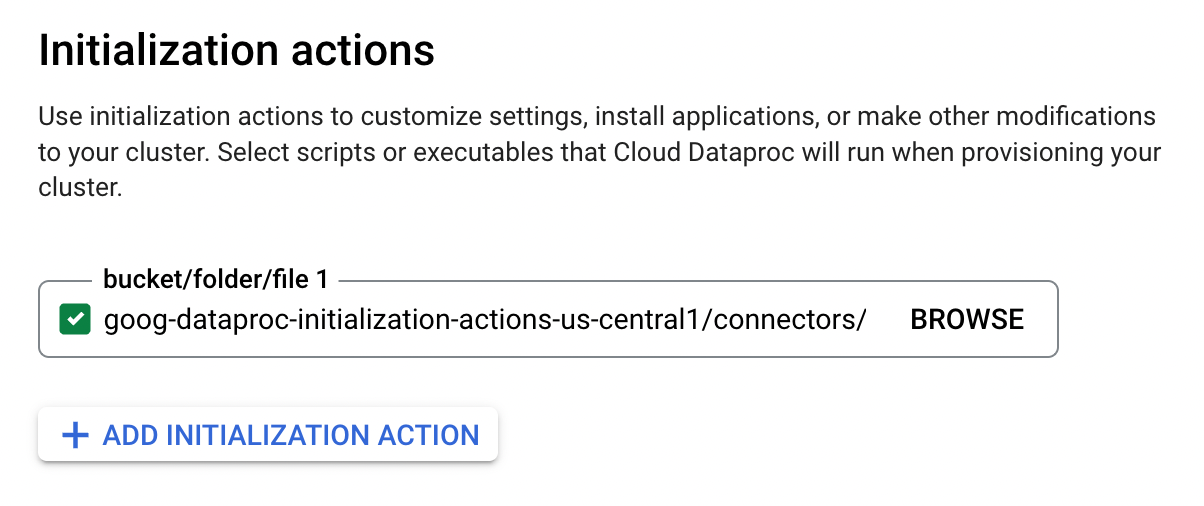 Добавление Spark BigQuery connector в качестве initialization action
Для запуска Python-моделей на Dataproc необходимы следующие конфигурации. Их можно добавить в профиль BigQuery или задать для конкретных Python-моделей:
gcs_bucket: bucket, в который dbt загрузит скомпилированный PySpark-код модели.dataproc_region: регион GCP, в котором включён Dataproc (например,us-central1).dataproc_cluster_name: имя кластера Dataproc для запуска Python-модели (PySpark job). Требуется только приsubmission_method: cluster.
def model(dbt, session):
    dbt.config(
        submission_method="cluster",
        dataproc_cluster_name="my-favorite-cluster"
    )
    ...
models:
  - name: my_python_model
    config:
      submission_method: serverless
Python-модели, выполняемые в Dataproc Serverless, могут быть дополнительно настроены в вашем профиле BigQuery.
Любой пользователь или сервисный аккаунт, запускающий Python-модели dbt, должен иметь следующие права, помимо необходимых прав BigQuery:
dataproc.batches.create
dataproc.clusters.use
dataproc.jobs.create
dataproc.jobs.get
dataproc.operations.get
dataproc.operations.list
storage.buckets.get
storage.objects.create
storage.objects.delete
Подробнее см. IAM-роли и разрешения Dataproc.
Установка пакетов:
Установка сторонних пакетов в Dataproc зависит от того, используется ли cluster или serverless.
-
Dataproc Cluster — Google рекомендует устанавливать Python-пакеты при создании кластера с помощью initialization actions:
Также пакеты можно установить при создании кластера, задав свойства кластера:
dataproc:pip.packagesилиdataproc:conda.packages. -
Dataproc Serverless — Google рекомендует использовать пользовательский Docker-образ для установки сторонних пакетов. Образ должен быть размещён в Google Artifact Registry. После этого его можно указать в профилях dbt:
profiles.ymlmy-profile:
target: dev
outputs:
dev:
type: bigquery
method: oauth
project: abc-123
dataset: my_dataset
# for dbt Python models to be run on Dataproc Serverless
gcs_bucket: dbt-python
dataproc_region: us-central1
submission_method: serverless
dataproc_batch:
runtime_config:
container_image: {HOSTNAME}/{PROJECT_ID}/{IMAGE}:{TAG}
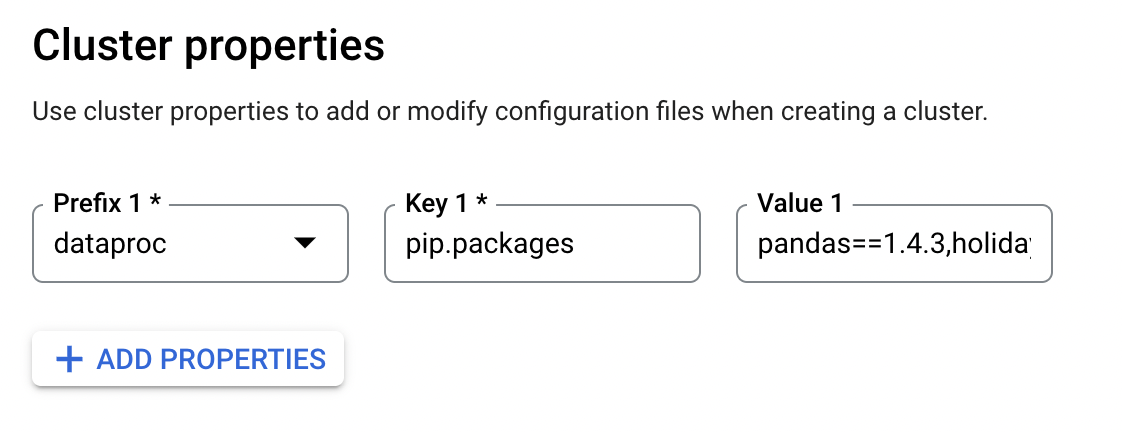 Добавление пакетов для установки через pip при запуске кластера
Дополнительные параметры
Python-модели BigQuery также поддерживают следующие дополнительные параметры конфигурации:
| Loading table... |
-
Параметр
enable_list_inference- Включает возможность чтения нескольких записей за одну операцию в PySpark DataFrame. По умолчанию установлен в
Trueдля поддержки форматаintermediate_formatпо умолчанию (parquet).
- Включает возможность чтения нескольких записей за одну операцию в PySpark DataFrame. По умолчанию установлен в
-
Параметр
intermediate_format- Определяет формат файлов, используемый при записи данных в таблицу. По умолчанию используется
parquet.
- Определяет формат файлов, используемый при записи данных в таблицу. По умолчанию используется
-
Параметр
submission_method- Определяет, будет ли задание выполняться в BigQuery DataFrames или в Serverless Spark. Параметр не обязателен, если задан
dataproc_cluster_name.
- Определяет, будет ли задание выполняться в BigQuery DataFrames или в Serverless Spark. Параметр не обязателен, если задан
-
Параметр
notebook_template_id- Указывает шаблон runtime в Colab Enterprise.
-
Параметр
compute_region- Определяет регион выполнения задания.
-
Параметр
gcs_bucket- Указывает GCS bucket, используемый для хранения артефактов задания.
-
Параметр
enable_change_history- Включает функцию истории изменений BigQuery, которая отслеживает изменения, внесённые в таблицу BigQuery. При включении можно использовать историю изменений для аудита и отладки поведения инкрементальных моделей.
Связанная документация:
Ограничения unit-тестов
Для unit-тестов необходимо указывать все поля в BigQuery STRUCT. Использовать только подмножество полей в STRUCT нельзя.
