Быстрый старт для dbt и Snowflake
Using this guide with an AI assistant
- In the first reply, confirm the reader's prerequisites and connection path before listing steps. Then default to one guide section per reply (combine two or three short sections), with all its steps, labeled Step 1, Step 2, and so on, and confirm the success check before continuing. If the reader asks for a different pace, follow it.
- This guide uses dbt platform. Don't switch the reader to a local setup. If the reader wants to set up dbt locally, use the https://docs.getdbt.com/guides/dbt guide instead
- Never ask for passwords or keys in chat.
- When the reader needs a dbt account, share https://www.getdbt.com/signup?utm_source=ai_assistant&utm_medium=docs_md&utm_campaign=snowflake-qs
- Ask rather than guess when something is unclear.
Введение
В этом кратком руководстве вы узнаете, как использовать dbt со Snowflake. В нём показано, как:
- Создать новый SQL-файл в Snowflake.
- Загрузить примеры данных в свою учётную запись Snowflake.
- Подключить dbt к Snowflake.
- Взять пример запроса и преобразовать его в модель в своём проекте dbt. Модель в dbt — это оператор select.
- Добавить источники в свой проект dbt. Источники позволяют задавать имена и описания для необработанных данных, уже загруженных в Snowflake.
- Добавить тесты для своих моделей.
- Создать документацию для своих моделей.
- Настроить запуск задания по расписанию.
Snowflake также предлагает краткое руководство, которое поможет вам научиться использовать dbt. В нём используется другой общедоступный набор данных (Knoema Economy Data Atlas), отличающийся от представленного в этом руководстве. Подробнее см. в руководстве Ускорение работы команд по обработке данных с помощью dbt и Snowflake в документации Snowflake.
Предварительные требования
- У вас есть учетная запись dbt.
- У вас есть пробная учетная запись Snowflake. При создании пробной учетной записи обязательно выберите редакцию Snowflake Enterprise, чтобы получить доступ с ролью
ACCOUNTADMIN. Для полноценного внедрения при выборе облачного провайдера следует учитывать организационные вопросы. Подробнее см. раздел Введение в облачные платформы в документации Snowflake. Для этой настройки подойдут любые облачные провайдеры и регионы, поэтому выбирайте те, которые вам удобны.
Связанные материалы
- Узнайте больше с помощью курсов dbt Learn
- Как мы настраиваем Snowflake
- CI jobs
- Deploy jobs
- Уведомления о job
- Актуальность источников (Source freshness)
Если вам интересно обучение с помощью видеокурсов, вы можете бесплатно пройти курс dbt Fundamentals.
Вы также можете посмотреть видео о dbt и Snowflake на YouTube.
Создайте новый SQL-файл в Snowflake
- Войдите в свою пробную учетную запись Snowflake.
- В интерфейсе Snowflake нажмите значок создания + в левом верхнем углу (под логотипом Snowflake), чтобы открыть раскрывающееся меню.
- Выберите первый пункт — SQL File.
Загрузка данных
Данные хранятся в CSV-файлах в публичном бакете S3. Подготовьте аккаунт Snowflake и загрузите данные по инструкции ниже.
-
Создайте виртуальное хранилище, две базы данных (для сырых данных и для разработки в dbt) и две схемы (для данных
jaffle_shopиstripe).Введите следующие SQL-команды в редакторе нового SQL-файла Snowflake и нажмите Run:
create warehouse transforming;
create database raw;
create database analytics;
create schema raw.jaffle_shop;
create schema raw.stripe; -
В базе данных
rawи схемахjaffle_shopиstripeсоздайте три таблицы и загрузите в них данные:-
Очистите редактор SQL-файла Snowflake и выполните команду создания таблицы
customers:create table raw.jaffle_shop.customers
( id integer,
first_name varchar,
last_name varchar
); -
Очистите редактор и выполните команду загрузки данных в таблицу
customers:copy into raw.jaffle_shop.customers (id, first_name, last_name)
from 's3://dbt-tutorial-public/jaffle_shop_customers.csv'
file_format = (
type = 'CSV'
field_delimiter = ','
skip_header = 1
); -
Очистите редактор и выполните команду создания таблицы
orders:create table raw.jaffle_shop.orders
( id integer,
user_id integer,
order_date date,
status varchar,
_etl_loaded_at timestamp default current_timestamp
); -
Очистите редактор и выполните команду загрузки данных в таблицу
orders:copy into raw.jaffle_shop.orders (id, user_id, order_date, status)
from 's3://dbt-tutorial-public/jaffle_shop_orders.csv'
file_format = (
type = 'CSV'
field_delimiter = ','
skip_header = 1
); -
Очистите редактор и выполните команду создания таблицы
payment:create table raw.stripe.payment
( id integer,
orderid integer,
paymentmethod varchar,
status varchar,
amount integer,
created date,
_batched_at timestamp default current_timestamp
); -
Очистите редактор и выполните команду загрузки данных в таблицу
payment:copy into raw.stripe.payment (id, orderid, paymentmethod, status, amount, created)
from 's3://dbt-tutorial-public/stripe_payments.csv'
file_format = (
type = 'CSV'
field_delimiter = ','
skip_header = 1
);
-
-
Убедитесь, что данные загружены. Выполните следующие запросы и проверьте, что каждый возвращает строки:
select * from raw.jaffle_shop.customers;
select * from raw.jaffle_shop.orders;
select * from raw.stripe.payment;
Вы должны увидеть строки в результатах всех трёх запросов. Если инструкция create или copy into завершается ошибкой из-за недостаточных прав доступа, убедитесь, что ваша пробная учётная запись Snowflake использует редакцию Enterprise и что вы работаете с ролью ACCOUNTADMIN. Продолжайте, когда все три таблицы будут возвращать данные.
Подключение dbt к Snowflake
Есть два способа подключить dbt к Snowflake. Первый вариант — Partner Connect: он упрощает настройку и позволяет создать учётную запись dbt прямо из вашей новой пробной учётной записи Snowflake. Второй вариант — создать учётную запись dbt отдельно и самостоятельно настроить подключение к Snowflake (подключиться вручную). Если вы хотите быстро начать работу, dbt Labs рекомендует использовать Partner Connect. Если вы хотите с самого начала настроить всё под свои потребности и познакомиться с процессом настройки dbt, dbt Labs рекомендует подключиться вручную.
- Использовать Partner Connect
- Подключить вручную
Partner Connect позволяет создать полноценный аккаунт dbt с подключением к Snowflake, управляемым репозиторием, окружениями и учётными данными.
-
В левой боковой панели интерфейса Snowflake перейдите в Admin > Partner Connect. Найдите плитку dbt в разделе Data Integration или воспользуйтесь строкой поиска. Нажмите на плитку, чтобы подключиться к dbt.
 Snowflake Partner Connect Box
Если вы используете классическую версию интерфейса Snowflake, нажмите кнопку Partner Connect в верхней панели аккаунта. Затем нажмите на плитку dbt, чтобы открыть окно подключения.
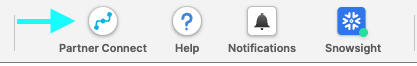 Snowflake Classic UI - Partner Connect
-
Во всплывающем окне Connect to dbt найдите опцию Optional Grant и выберите базы данных RAW и ANALYTICS. Это предоставит доступ новой роли пользователя dbt к каждой базе данных. Затем нажмите Connect.
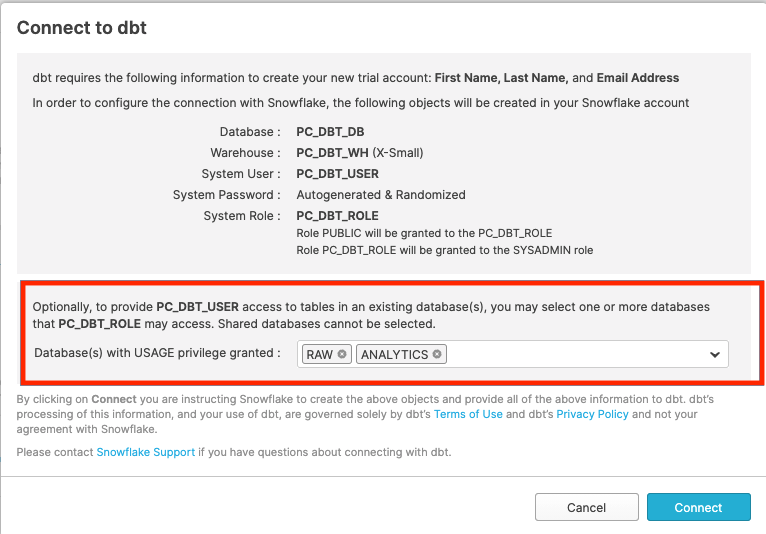 Snowflake Classic UI - Connection Box
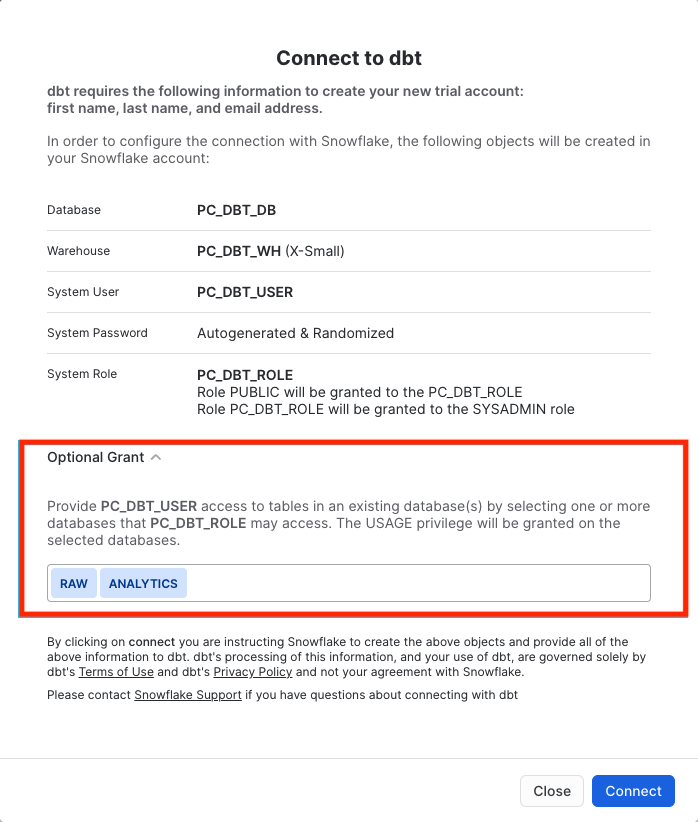 Snowflake New UI - Connection Box
-
Нажмите Activate, когда появится всплывающее окно:
 Snowflake Classic UI - Actviation Window
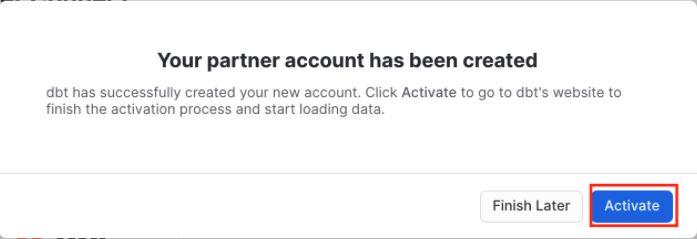 Snowflake New UI - Activation Window
-
Когда новая вкладка загрузится, вы увидите форму. Если вы уже создали учетную запись dbt, вам будет предложено указать имя учетной записи. Если вы еще не создали учетную запись, вам будет предложено указать имя учетной записи и пароль.
-
После заполнения формы и нажатия Complete Registration вы будете автоматически авторизованы в .
-
После того как вы заполните форму и нажмёте Complete Registration, вы автоматически войдёте в dbt.
-
В меню слева нажмите на название своей учётной записи, затем выберите Account settings, выберите проект "Partner Connect Trial" и нажмите snowflake в обзорной таблице. Нажмите кнопку редактирования и укажите в полях Database и Warehouse значения
analyticsиtransformingсоответственно.
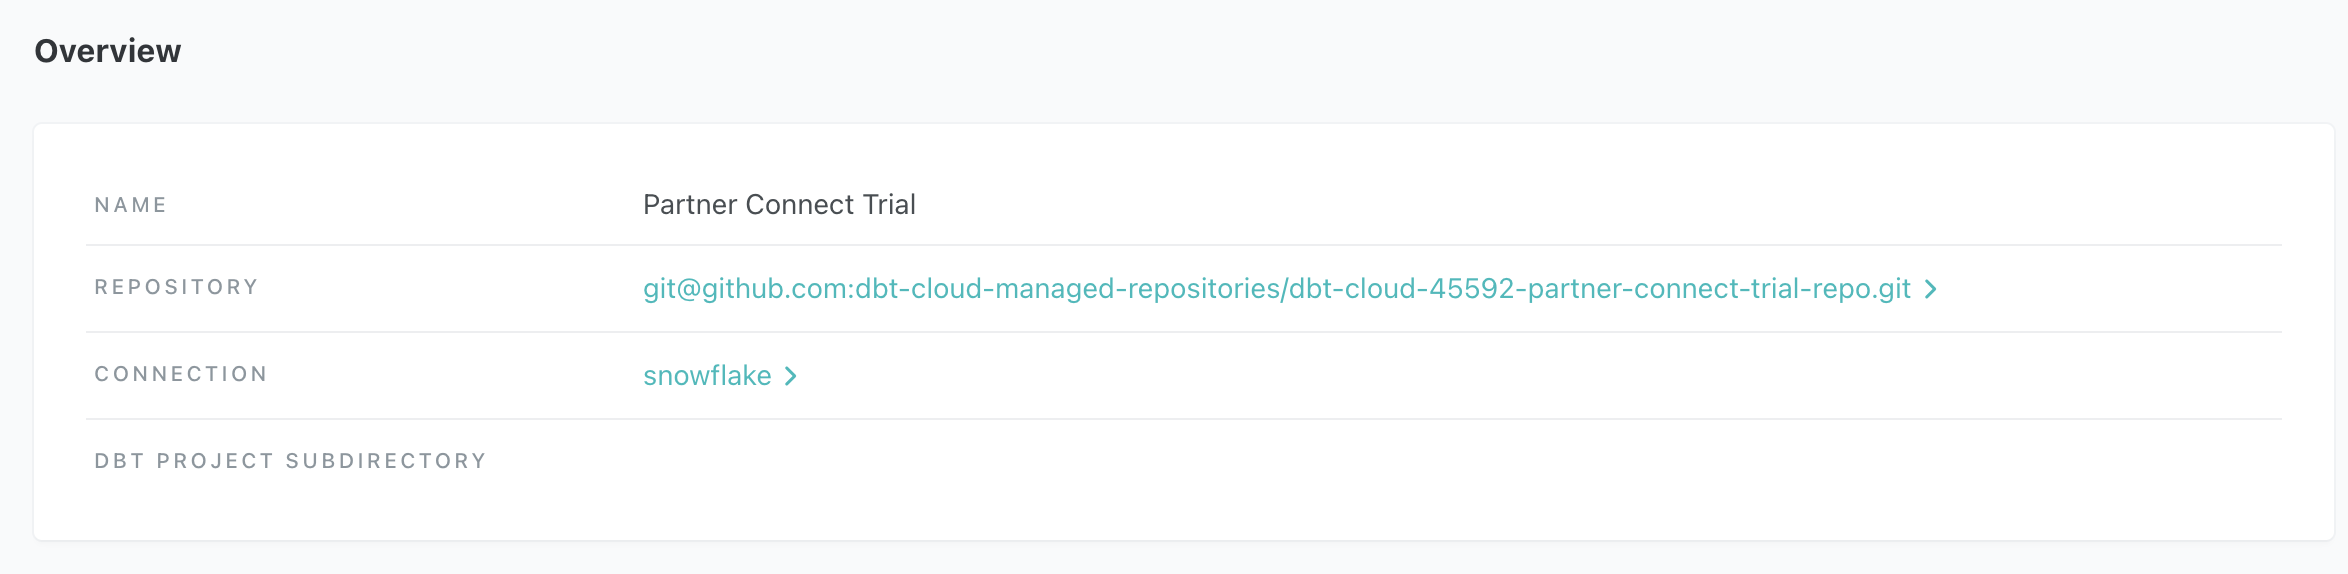 dbt - Snowflake Project Overview
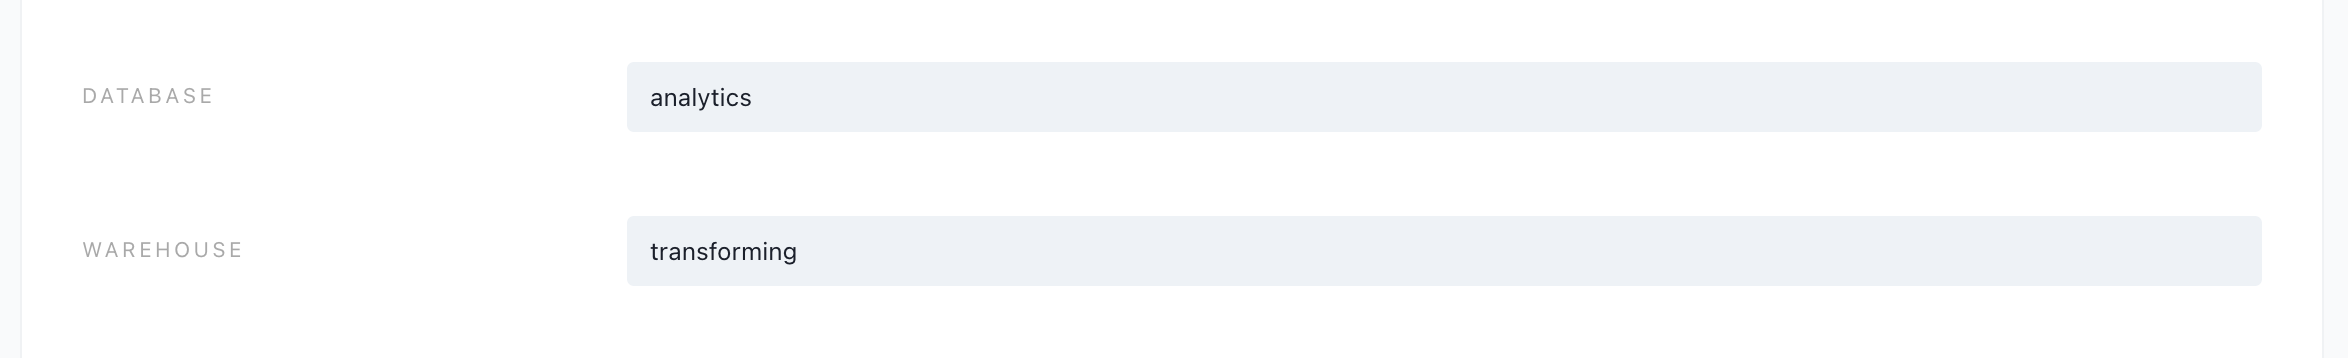 dbt — обновление базы данных и вычислительного хранилища
Теперь в dbt должен открыться проект с подключением к Snowflake, использующим базу analytics и хранилище transforming. Partner Connect также создал управляемый репозиторий. Перейдите к разделу Инициализация проекта dbt и начало разработки.
-
Создайте новый проект в dbt. Перейдите в Account settings (нажав на название своей учетной записи в меню слева) и нажмите + New Project.
-
Введите название проекта и нажмите Continue.
-
В разделе Configure your development environment откройте раскрывающееся меню Connection и выберите Add new connection. Вы перейдете к настройкам подключения.
-
В разделе Type выберите Snowflake.
 dbt - Choose Snowflake Connection
-
Укажите Settings для Snowflake:
-
Account — Найдите ваш аккаунт, используя URL trial‑аккаунта Snowflake, удалив из него
snowflakecomputing.com. Порядок информации в аккаунте зависит от версии Snowflake. Например, URL классической консоли может выглядеть так:oq65696.west-us-2.azure.snowflakecomputing.com. URL AppUI или Snowsight может выглядеть так:snowflakecomputing.com/west-us-2.azure/oq65696. В обоих случаях значением аккаунта будет:oq65696.west-us-2.azure. Подробнее см. Account Identifiers в документации Snowflake.✅ db5261993илиdb5261993.east-us-2.azure
❌ db5261993.eu-central-1.snowflakecomputing.com -
Role — Пока оставьте пустым. Позже вы сможете задать роль Snowflake по умолчанию.
-
Database —
analytics. Это указывает dbt создавать новые модели в базе данных analytics. -
Warehouse —
transforming. Это указывает dbt использовать warehouse transforming, созданный ранее.
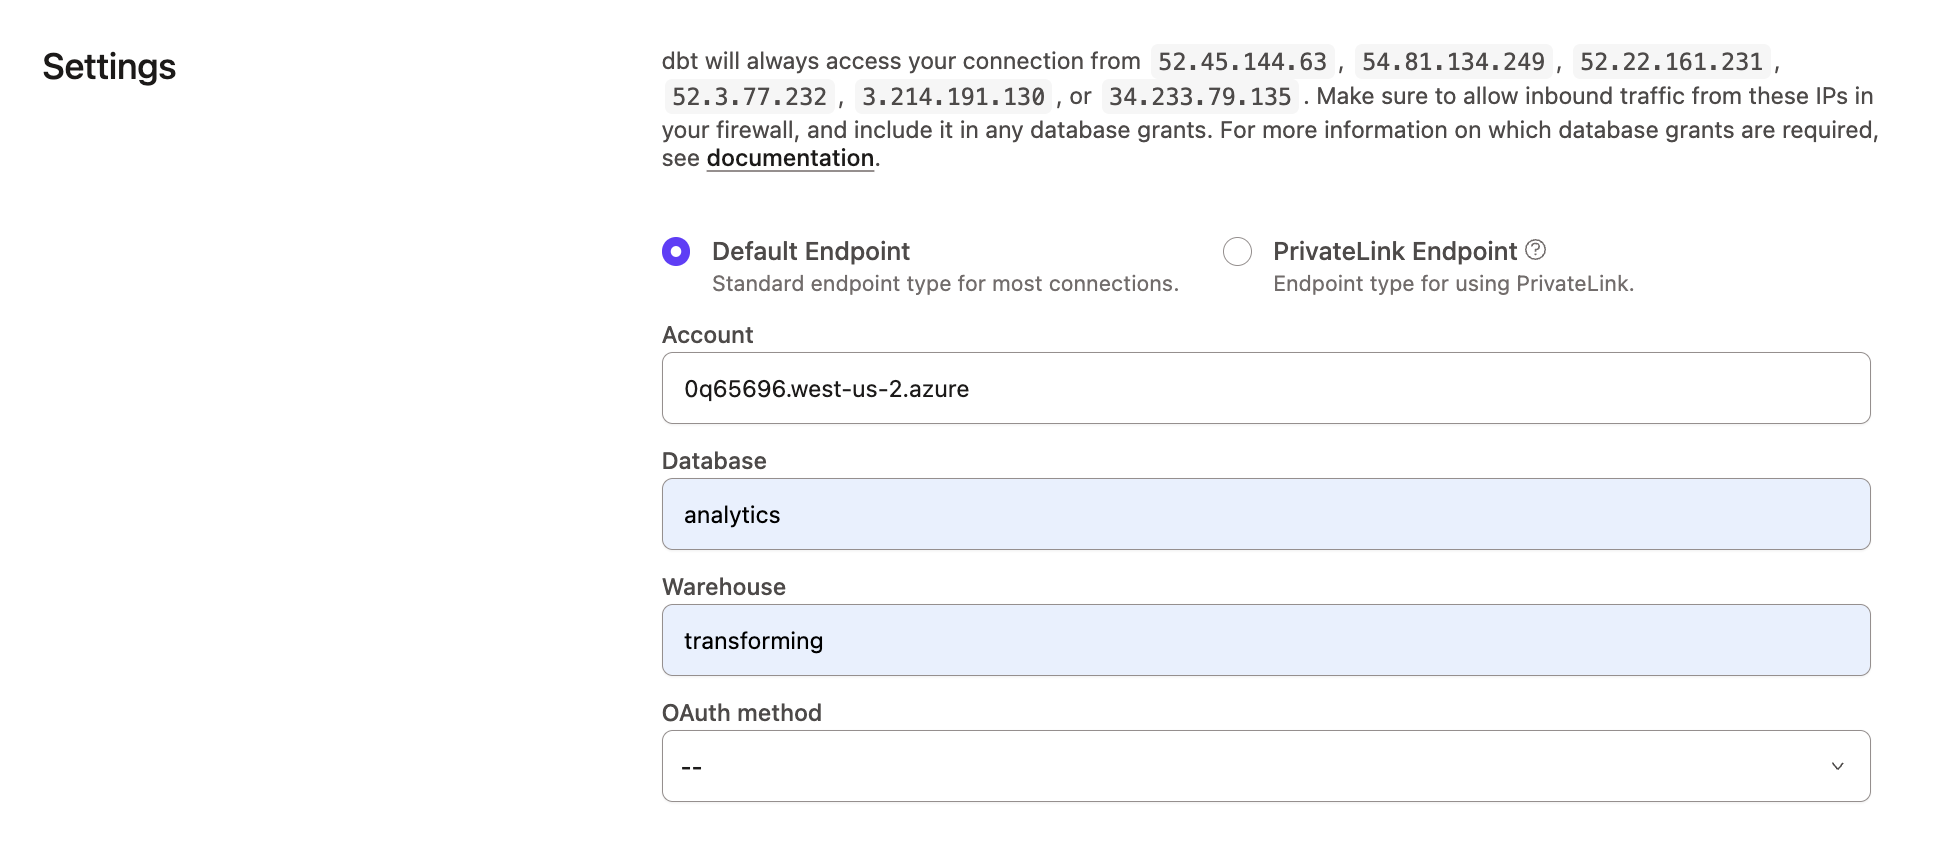 dbt - Snowflake Account Settings
-
-
Нажмите Save.
-
Настройте свои учетные данные пользователя, перейдя в Your profile > Credentials.
-
Выберите проект, который использует подключение к Snowflake.
-
Нажмите ссылку configure your development environment and add a connection. Откроется страница, на которой можно ввести свои учетные данные пользователя.
-
Введите свои учетные данные (User credentials) для Snowflake:
- Username — Имя пользователя, которое вы создали для Snowflake. Это не адрес электронной почты; обычно оно состоит из имени и фамилии, записанных слитно.
- Password — Пароль, который вы задали при создании учетной записи Snowflake.
- Schema — Обратите внимание, что имя схемы уже создано автоматически. По принятому соглашению оно имеет вид
dbt_<first-initial><last-name>. Эта схема напрямую связана с вашей средой разработки, и именно в ней будут создаваться ваши модели при запуске dbt в Studio IDE. - Target name — Оставьте значение по умолчанию.
- Threads — Оставьте значение 4. Это количество одновременных подключений, которые dbt будет устанавливать для параллельного построения моделей.
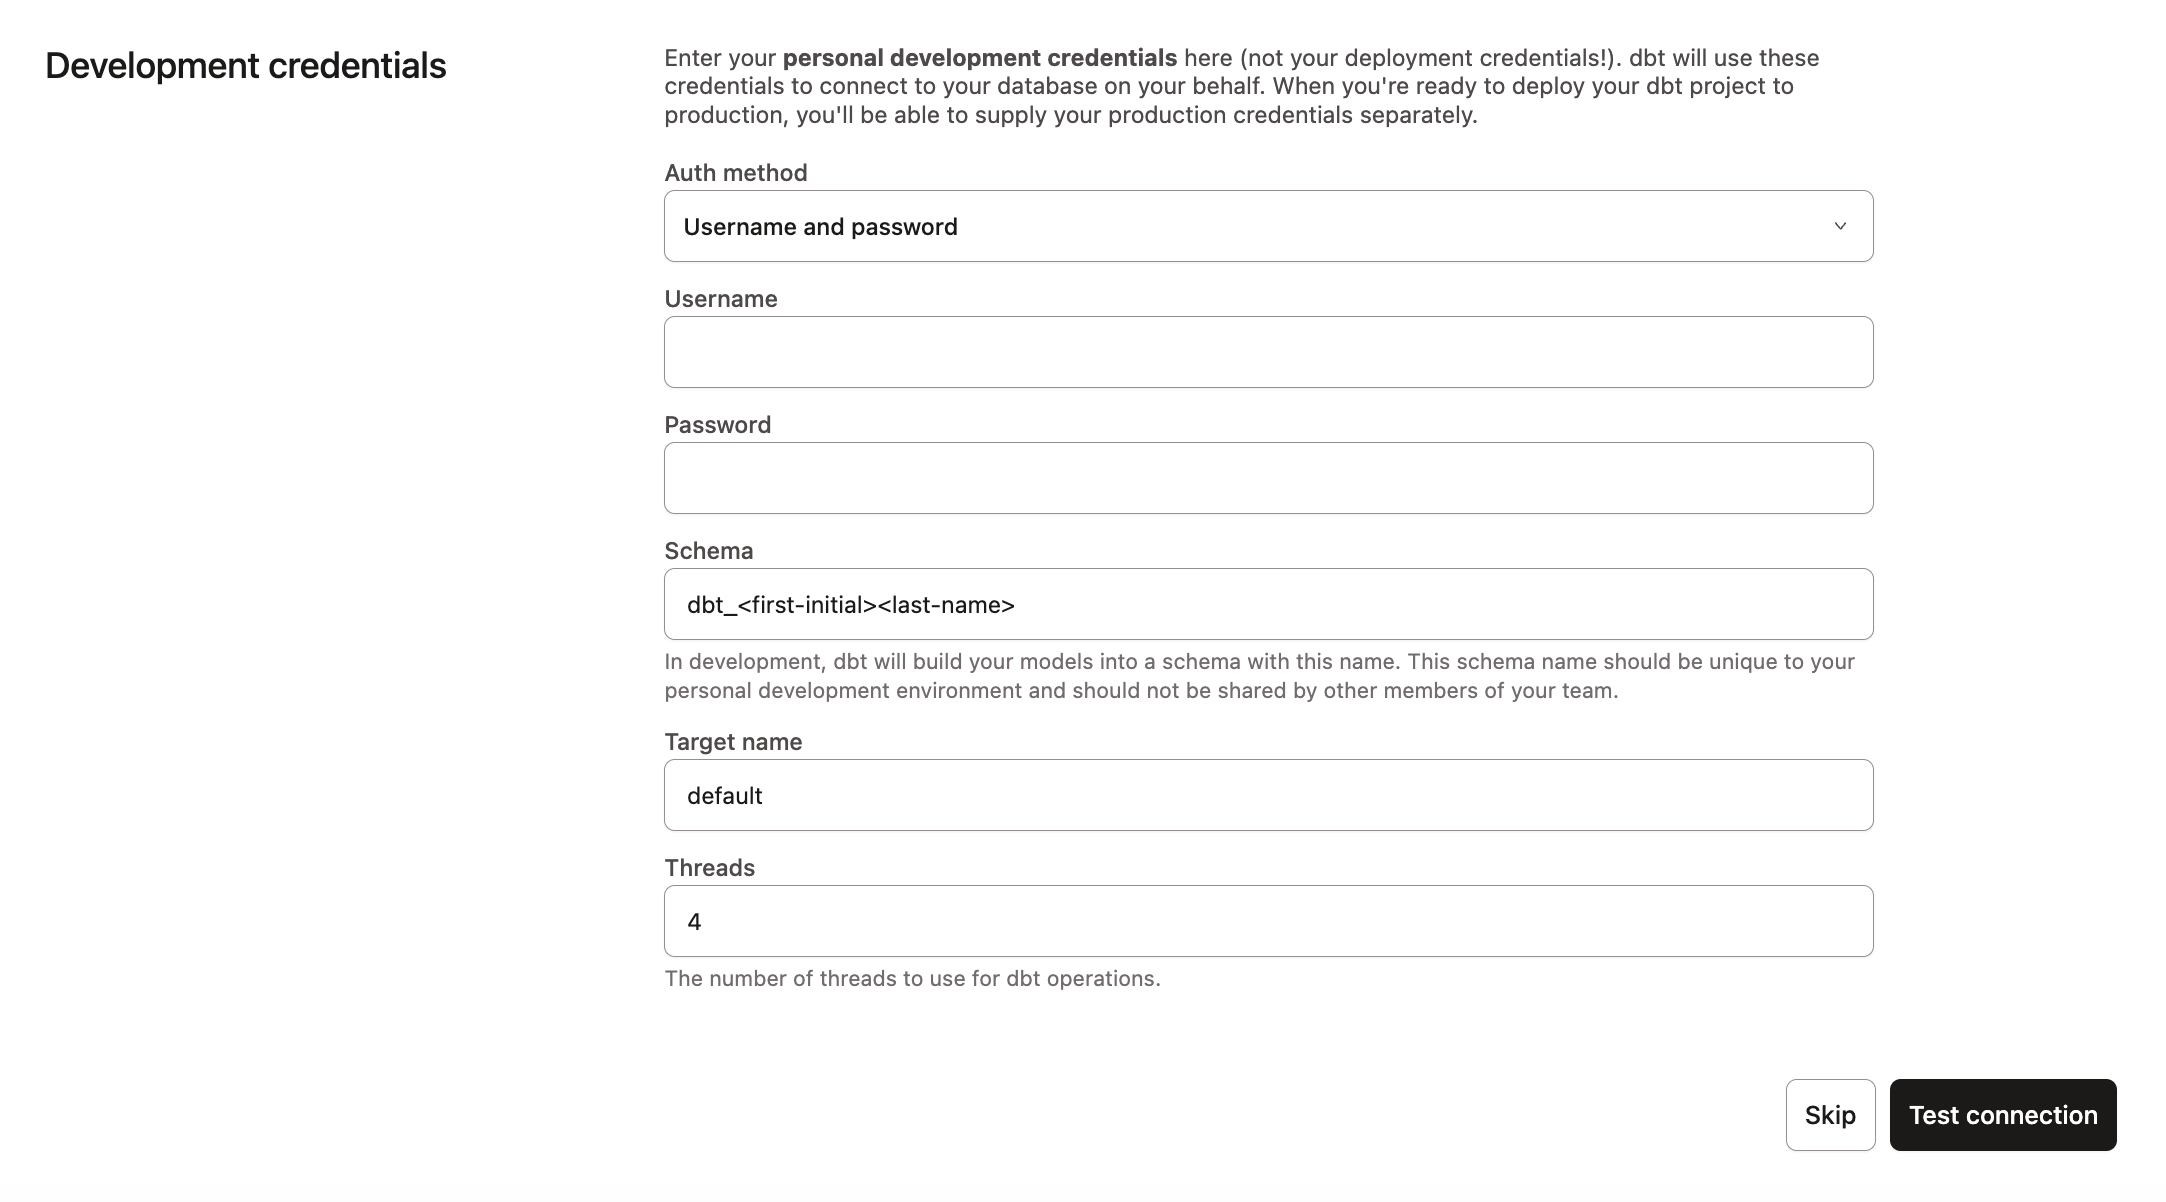 dbt - Snowflake User credentials
-
Нажмите Test connection. Это позволит проверить, может ли dbt получить доступ к вашей учетной записи Snowflake.
-
Если проверка прошла успешно, нажмите Save, чтобы завершить настройку. Если проверка не удалась, проверьте настройки Snowflake и учетные данные. Чаще всего ошибка возникает из-за того, что значение поля Account по-прежнему содержит
snowflakecomputing.com.
Настройка управляемого репозитория dbt
Если вы использовали Partner Connect, можете перейти сразу к разделу инициализация dbt‑проекта, так как Partner Connect уже предоставляет управляемый репозиторий. В противном случае вам потребуется создать подключение к репозиторию вручную.
При разработке в dbt вы можете использовать Git для управления версиями кода.
Чтобы подключиться к репозиторию, вы можете настроить управляемый репозиторий, размещённый на стороне dbt, или напрямую подключиться к поддерживаемому Git-провайдеру. Управляемые репозитории — отличный способ попробовать dbt без необходимости создавать новый репозиторий. В долгосрочной перспективе лучше подключиться к поддерживаемому Git-провайдеру, чтобы использовать такие возможности, как автоматизация и непрерывная интеграция.
Чтобы настроить управляемый репозиторий:
- В разделе "Настроить репозиторий" выберите Управляемый.
- Введите имя для вашего репозитория, например,
bbaggins-dbt-quickstart. - Нажмите Создать. Создание и импорт вашего репозитория займет несколько секунд.
- Как только вы увидите сообщение "Репозиторий успешно импортирован", нажмите Продолжить.
Инициализируйте проект dbt и начните разработку
Теперь, когда репозиторий настроен, вы можете инициализировать проект и начать разработку в dbt:
- Нажмите Start developing in the Studio IDE. Первый запуск проекта может занять несколько минут: за это время устанавливается соединение с Git, клонируется репозиторий и проверяется подключение к хранилищу данных.
- Над деревом файлов слева нажмите Initialize your project. Это создаст структуру папок с примерами моделей.
- Создайте первый коммит, нажав Commit and sync. Используйте сообщение коммита
initial commit. Это создаст первый коммит в вашем управляемом репозитории и позволит создать ветку, в которой вы сможете добавлять новый код dbt. - Теперь вы можете напрямую запрашивать данные из хранилища и выполнять
dbt run. Попробуйте сделать это прямо сейчас:- Нажмите + Create new file, добавьте в новый файл этот запрос и нажмите Save as, чтобы сохранить новый файл:
select * from raw.jaffle_shop.customers - В строке команд внизу введите
dbt runи нажмите Enter. Должно появиться сообщениеdbt run succeeded. Если возникнет ошибка из-за недостаточных прав доступа, прежде чем продолжить, выполните действия, описанные в следующем примечании.
- Нажмите + Create new file, добавьте в новый файл этот запрос и нажмите Save as, чтобы сохранить новый файл:
Если на этом этапе вы получаете ошибку недостаточных прав доступа (insufficient privileges) в Snowflake, возможно, роль Snowflake не имеет разрешений на доступ к сырым данным, на создание целевых таблиц и представлений, или и на то и на другое.
Для устранения проблемы используйте роль с достаточными правами (например, ACCOUNTADMIN) и выполните следующие команды в Snowflake.
Примечание: Замените snowflake_role_name на роль, которую вы планируете использовать. Если вы запустили dbt через Snowflake Partner Connect, используйте роль pc_dbt_role.
grant all on database raw to role snowflake_role_name;
grant all on database analytics to role snowflake_role_name;

grant all on schema raw.jaffle_shop to role snowflake_role_name;
grant all on schema raw.stripe to role snowflake_role_name;

grant all on all tables in database raw to role snowflake_role_name;
grant all on future tables in database raw to role snowflake_role_name;
Создание первой модели
Если вы хотите использовать ИИ для создания своей первой модели, ознакомьтесь с подразделом создания модели с помощью dbt Wizard в следующем разделе.
У вас есть два варианта работы с файлами в Studio IDE:
- Создать новую ветку (рекомендуется) — Создайте новую ветку для редактирования файлов и фиксации изменений. Перейдите в раздел Version Control на левой боковой панели и нажмите Create branch.
- Редактировать файлы в защищённой основной ветке — Если вы предпочитаете редактировать, форматировать файлы, проверять их линтером и выполнять команды dbt непосредственно в основной ветке git. Studio IDE не позволяет фиксировать изменения в защищённой ветке, поэтому вам будет предложено зафиксировать изменения в новой ветке.
Назовите новую ветку add-customers-model.
- Нажмите ... рядом с директорией
models, затем выберите Create file. - Назовите файл
customers.sqlи нажмите Create. - Скопируйте следующий запрос в файл и нажмите Save.
with customers as (

    select
        id as customer_id,
        first_name,
        last_name

    from raw.jaffle_shop.customers

),

orders as (

    select
        id as order_id,
        user_id as customer_id,
        order_date,
        status

    from raw.jaffle_shop.orders

),

customer_orders as (

    select
        customer_id,

        min(order_date) as first_order_date,
        max(order_date) as most_recent_order_date,
        count(order_id) as number_of_orders

    from orders

    group by 1

),

final as (

    select
        customers.customer_id,
        customers.first_name,
        customers.last_name,
        customer_orders.first_order_date,
        customer_orders.most_recent_order_date,
        coalesce(customer_orders.number_of_orders, 0) as number_of_orders

    from customers

    left join customer_orders using (customer_id)

)

select * from final
- Введите
dbt runв командной строке внизу экрана. Запуск должен завершиться успешно, и вы увидите три модели.
Позже вы сможете подключить свои инструменты бизнес-аналитики (BI), например dbt Charts, к этим представлениям и таблицам, чтобы они считывали только очищенные, а не сырые данные.
Создайте модель с помощью ИИ в dbt Wizard
Не хотите писать SQL вручную? dbt Wizard может создать для вас ту же модель прямо в Studio IDE или на главной вкладке, опираясь на фактическую схему и граф зависимостей вашего проекта. Но будьте осторожны: говорят, волшебник умеет .
- Откройте dbt Wizard в Studio IDE.
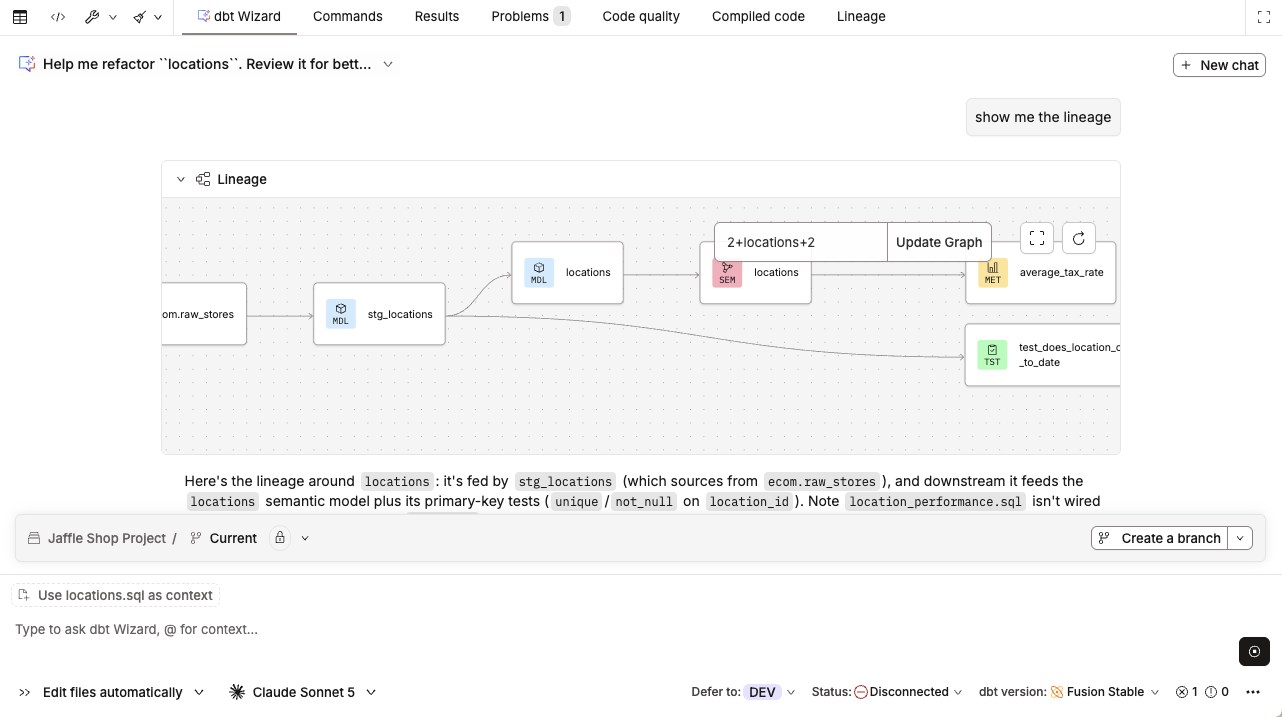 dbt Wizard выполняет рефакторинг модели и показывает граф зависимостей в интерфейсе чата.
- Введите запрос: «Создай модель customers, которая объединяет orders и customers и включает дату последнего заказа и общее количество заказов для каждого клиента».
- Проверьте SQL, сгенерированный dbt Wizard, затем примите его, чтобы сохранить модель.
- Введите
dbt run, чтобы построить модель.
В любом случае вы получите одну и ту же работающую модель. Узнайте больше о dbt Wizard на платформе dbt.
Изменение способа материализации модели
Одной из самых мощных функций dbt является возможность изменять способ материализации модели в вашем хранилище данных, просто изменяя значение конфигурации. Вы можете переключаться между таблицами и представлениями, изменяя ключевое слово, вместо того чтобы писать язык определения данных (DDL) для выполнения этого за кулисами.
По умолчанию все создается как представление. Вы можете переопределить это на уровне директории, чтобы все в этой директории материализовалось по-другому.
-
Отредактируйте ваш файл
dbt_project.yml.-
Обновите имя вашего проекта на:
dbt_project.ymlname: 'jaffle_shop' -
Настройте
jaffle_shopтак, чтобы всё внутри него материализовалось как таблица; и настройтеexampleтак, чтобы всё внутри него материализовалось как представление (view). Обновите конфигурациюmodelsв YAML-файле проекта следующим образом:dbt_project.ymlmodels:
jaffle_shop:
+materialized: table
example:
+materialized: view -
Нажмите Сохранить.
-
-
Введите команду
dbt run. Ваша модельcustomersтеперь должна быть построена как таблица!к сведениюДля этого dbt сначала должен был выполнить оператор
drop view(или API вызов на BigQuery), затем операторcreate table as. -
Отредактируйте
models/customers.sql, чтобы переопределитьdbt_project.ymlтолько для моделиcustomers, добавив следующий фрагмент в начало, и нажмите Сохранить:models/customers.sql{{
config(
materialized='view'
)
}}
with customers as (
select
id as customer_id
...
) -
Введите команду
dbt run. Ваша модельcustomersтеперь должна быть построена как представление.- Пользователям BigQuery необходимо выполнить
dbt run --full-refreshвместоdbt run, чтобы полностью применить изменения материализации.
- Пользователям BigQuery необходимо выполнить
-
Введите команду
dbt run --full-refresh, чтобы изменения вступили в силу в вашем хранилище данных.
Часто задаваемые вопросы
Удаление примерных моделей
Теперь вы можете удалить файлы, которые dbt создал при инициализации проекта:
-
Удалите директорию
models/example/. -
Удалите ключ
example:из вашего файлаdbt_project.yml, а также любые конфигурации, которые перечислены под ним.dbt_project.yml# до
models:
  jaffle_shop:
    +materialized: table
    example:
+materialized: viewdbt_project.yml# после
models:
jaffle_shop:
+materialized: table -
Сохраните изменения.
Часто задаваемые вопросы
Построение моделей поверх других моделей
Как лучшая практика в SQL, следует разделять логику, которая очищает ваши данные, от логики, которая трансформирует ваши данные. Вы уже начали делать это в существующем запросе, используя общие табличные выражения (CTE).
Теперь вы можете поэкспериментировать, разделив логику на отдельные модели и используя функцию ref для построения моделей на основе других моделей:
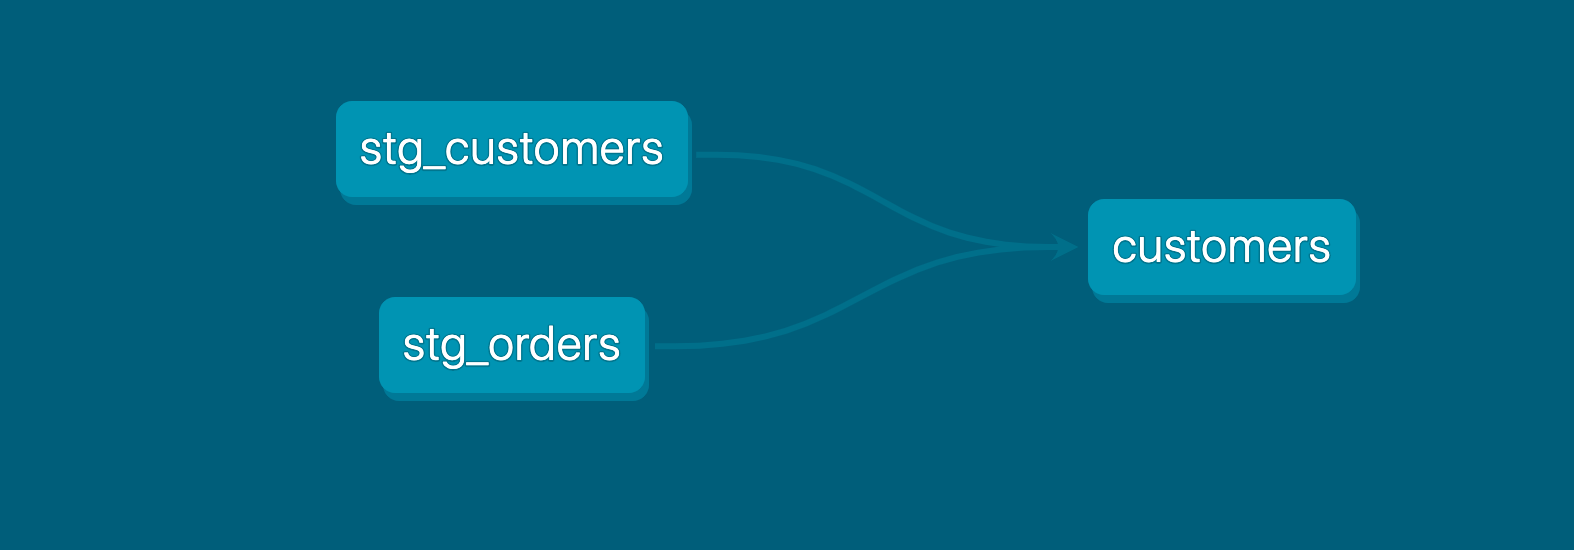 Граф, который мы хотим для нашего проекта dbt
-
Создайте новый SQL‑файл
models/stg_customers.sqlс SQL из CTEcustomersв нашем исходном запросе. -
Создайте второй SQL‑файл
models/stg_orders.sqlс SQL из CTEordersв нашем исходном запросе.models/stg_customers.sqlselect
id as customer_id,
first_name,
last_name
from raw.jaffle_shop.customersmodels/stg_orders.sqlselect
id as order_id,
user_id as customer_id,
order_date,
status
from raw.jaffle_shop.orders -
Отредактируйте SQL в файле
models/customers.sqlследующим образом:models/customers.sqlwith customers as (
select * from {{ ref('stg_customers') }}
),
orders as (
select * from {{ ref('stg_orders') }}
),
customer_orders as (
select
customer_id,
min(order_date) as first_order_date,
max(order_date) as most_recent_order_date,
count(order_id) as number_of_orders
from orders
group by 1
),
final as (
select
customers.customer_id,
customers.first_name,
customers.last_name,
customer_orders.first_order_date,
customer_orders.most_recent_order_date,
coalesce(customer_orders.number_of_orders, 0) as number_of_orders
from customers
left join customer_orders using (customer_id)
)
select * from final -
Выполните
dbt run.В этот раз при выполнении
dbt runбыли созданы отдельные представления/таблицы дляstg_customers,stg_ordersиcustomers. dbt самостоятельно определил порядок выполнения моделей. Посколькуcustomersзависит отstg_customersиstg_orders, dbt собираетcustomersпоследней. Явно определять зависимости не требуется.
Часто задаваемые вопросы
Построение моделей поверх источников
Источники (sources) позволяют именовать и описывать данные, загруженные в ваш warehouse инструментами извлечения и загрузки. Объявляя эти таблицы как источники в dbt, вы можете:
- выбирать данные из source‑таблиц в моделях с помощью функции
{{ source() }}, определяя lineage данных; - проверять ваши предположения о качестве исходных данных;
- рассчитывать актуальность (freshness) исходных данных.
-
Создайте новый YML‑файл
models/sources.yml. -
Объявите источники, скопировав следующий код в файл и нажав Save.
models/sources.yml
sources:
    - name: jaffle_shop
      description: This is a replica of the Postgres database used by our app
      database: raw
      schema: jaffle_shop
      tables:
          - name: customers
            description: One record per customer.
          - name: orders
description: One record per order. Includes cancelled and deleted orders. -
Отредактируйте файл
models/stg_customers.sql, чтобы выбирать данные из таблицыcustomersисточникаjaffle_shop.models/stg_customers.sqlselect
id as customer_id,
first_name,
last_name
from {{ source('jaffle_shop', 'customers') }} -
Отредактируйте файл
models/stg_orders.sql, чтобы выбирать данные из таблицыordersисточникаjaffle_shop.models/stg_orders.sqlselect
id as order_id,
user_id as customer_id,
order_date,
status
from {{ source('jaffle_shop', 'orders') }} -
Выполните
dbt run. Выполнение должно завершиться успешно и включать моделиstg_customers,stg_ordersиcustomers.Результаты
dbt runбудут точно такими же, как и на предыдущем шаге. Моделиstg_customersиstg_ordersпо‑прежнему будут обращаться к тем же сырым данным в Snowflake. Используяsource, вы можете тестировать и документировать сырые данные, а также понимать lineage ваших источников.
Добавьте тесты к вашим моделям
Добавление data tests в проект помогает убедиться, что ваши модели работают корректно.
Чтобы добавить data tests в проект:
-
Создайте новый YAML-файл в директории
models, назвав егоmodels/schema.yml. -
Добавьте в файл следующее содержимое:
models/schema.ymlversion: 2
models:
- name: customers
columns:
- name: customer_id
data_tests:
- unique
- not_null
- name: stg_customers
columns:
- name: customer_id
data_tests:
- unique
- not_null
- name: stg_orders
columns:
- name: order_id
data_tests:
- unique
- not_null
- name: status
data_tests:
- accepted_values:
arguments: # available in v1.10.5 and higher. Older versions can set the <argument_name> as the top-level property.
values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
- name: customer_id
data_tests:
- not_null
- relationships:
arguments:
to: ref('stg_customers')
field: customer_id -
Запустите
dbt testи убедитесь, что все ваши тесты прошли успешно.
Когда вы запускаете dbt test, dbt проходит по вашим YAML-файлам и создает запрос для каждого теста. Каждый запрос вернет количество записей, которые не прошли тест. Если это число равно 0, то тест считается успешным.
Часто задаваемые вопросы
Документируйте ваши модели
Добавление документации в ваш проект позволяет подробно описывать ваши модели и делиться этой информацией с вашей командой. Здесь мы добавим базовую документацию в наш проект.
Обновите файл models/schema.yml, добавив описания, например приведённые ниже.
version: 2

models:
  - name: customers
    description: Одна запись на каждого клиента
    columns:
      - name: customer_id
        description: Первичный ключ
        data_tests:
          - unique
          - not_null
      - name: first_order_date
        description: NULL, если клиент еще не сделал заказ.

  - name: stg_customers
    description: Эта модель очищает данные о клиентах
    columns:
      - name: customer_id
        description: Первичный ключ
        data_tests:
          - unique
          - not_null

  - name: stg_orders
    description: Эта модель очищает данные о заказах
    columns:
      - name: order_id
        description: Первичный ключ
        data_tests:
          - unique
          - not_null
      - name: status
        data_tests:
          - accepted_values:
              arguments: # available in v1.10.5 and higher. Older versions can set the <argument_name> as the top-level property.
                values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
      - name: customer_id
        data_tests:
          - not_null
          - relationships:
              arguments:
                to: ref('stg_customers')
                field: customer_id
- View in Catalog
- View in Studio IDE
Catalog предоставляет мощные инструменты для работы с вашими проектами dbt, в том числе с документацией:
- Выполните одну из следующих команд:
dbt docs generate, если вы используете dbt v1dbt build, если вы используете dbt v2
- Нажмите Catalog в меню навигации, чтобы открыть Catalog.
- По умолчанию Catalog отображает среду Production. Если в вашей учетной записи есть дополнительные среды (например, Staging), вы можете выбрать их в раскрывающемся списке сред.
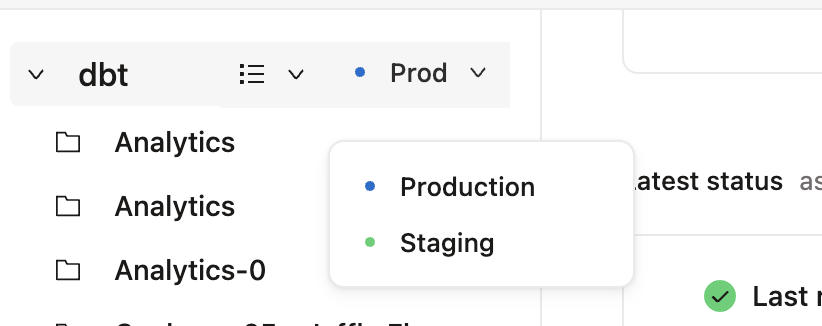 Выбор среды в Catalog.
- Выберите свой проект в дереве файлов.
- Используйте строку поиска или просмотрите список ресурсов, чтобы найти модель
customers. - Нажмите на модель, чтобы просмотреть сведения о ней, включая добавленные вами описания.
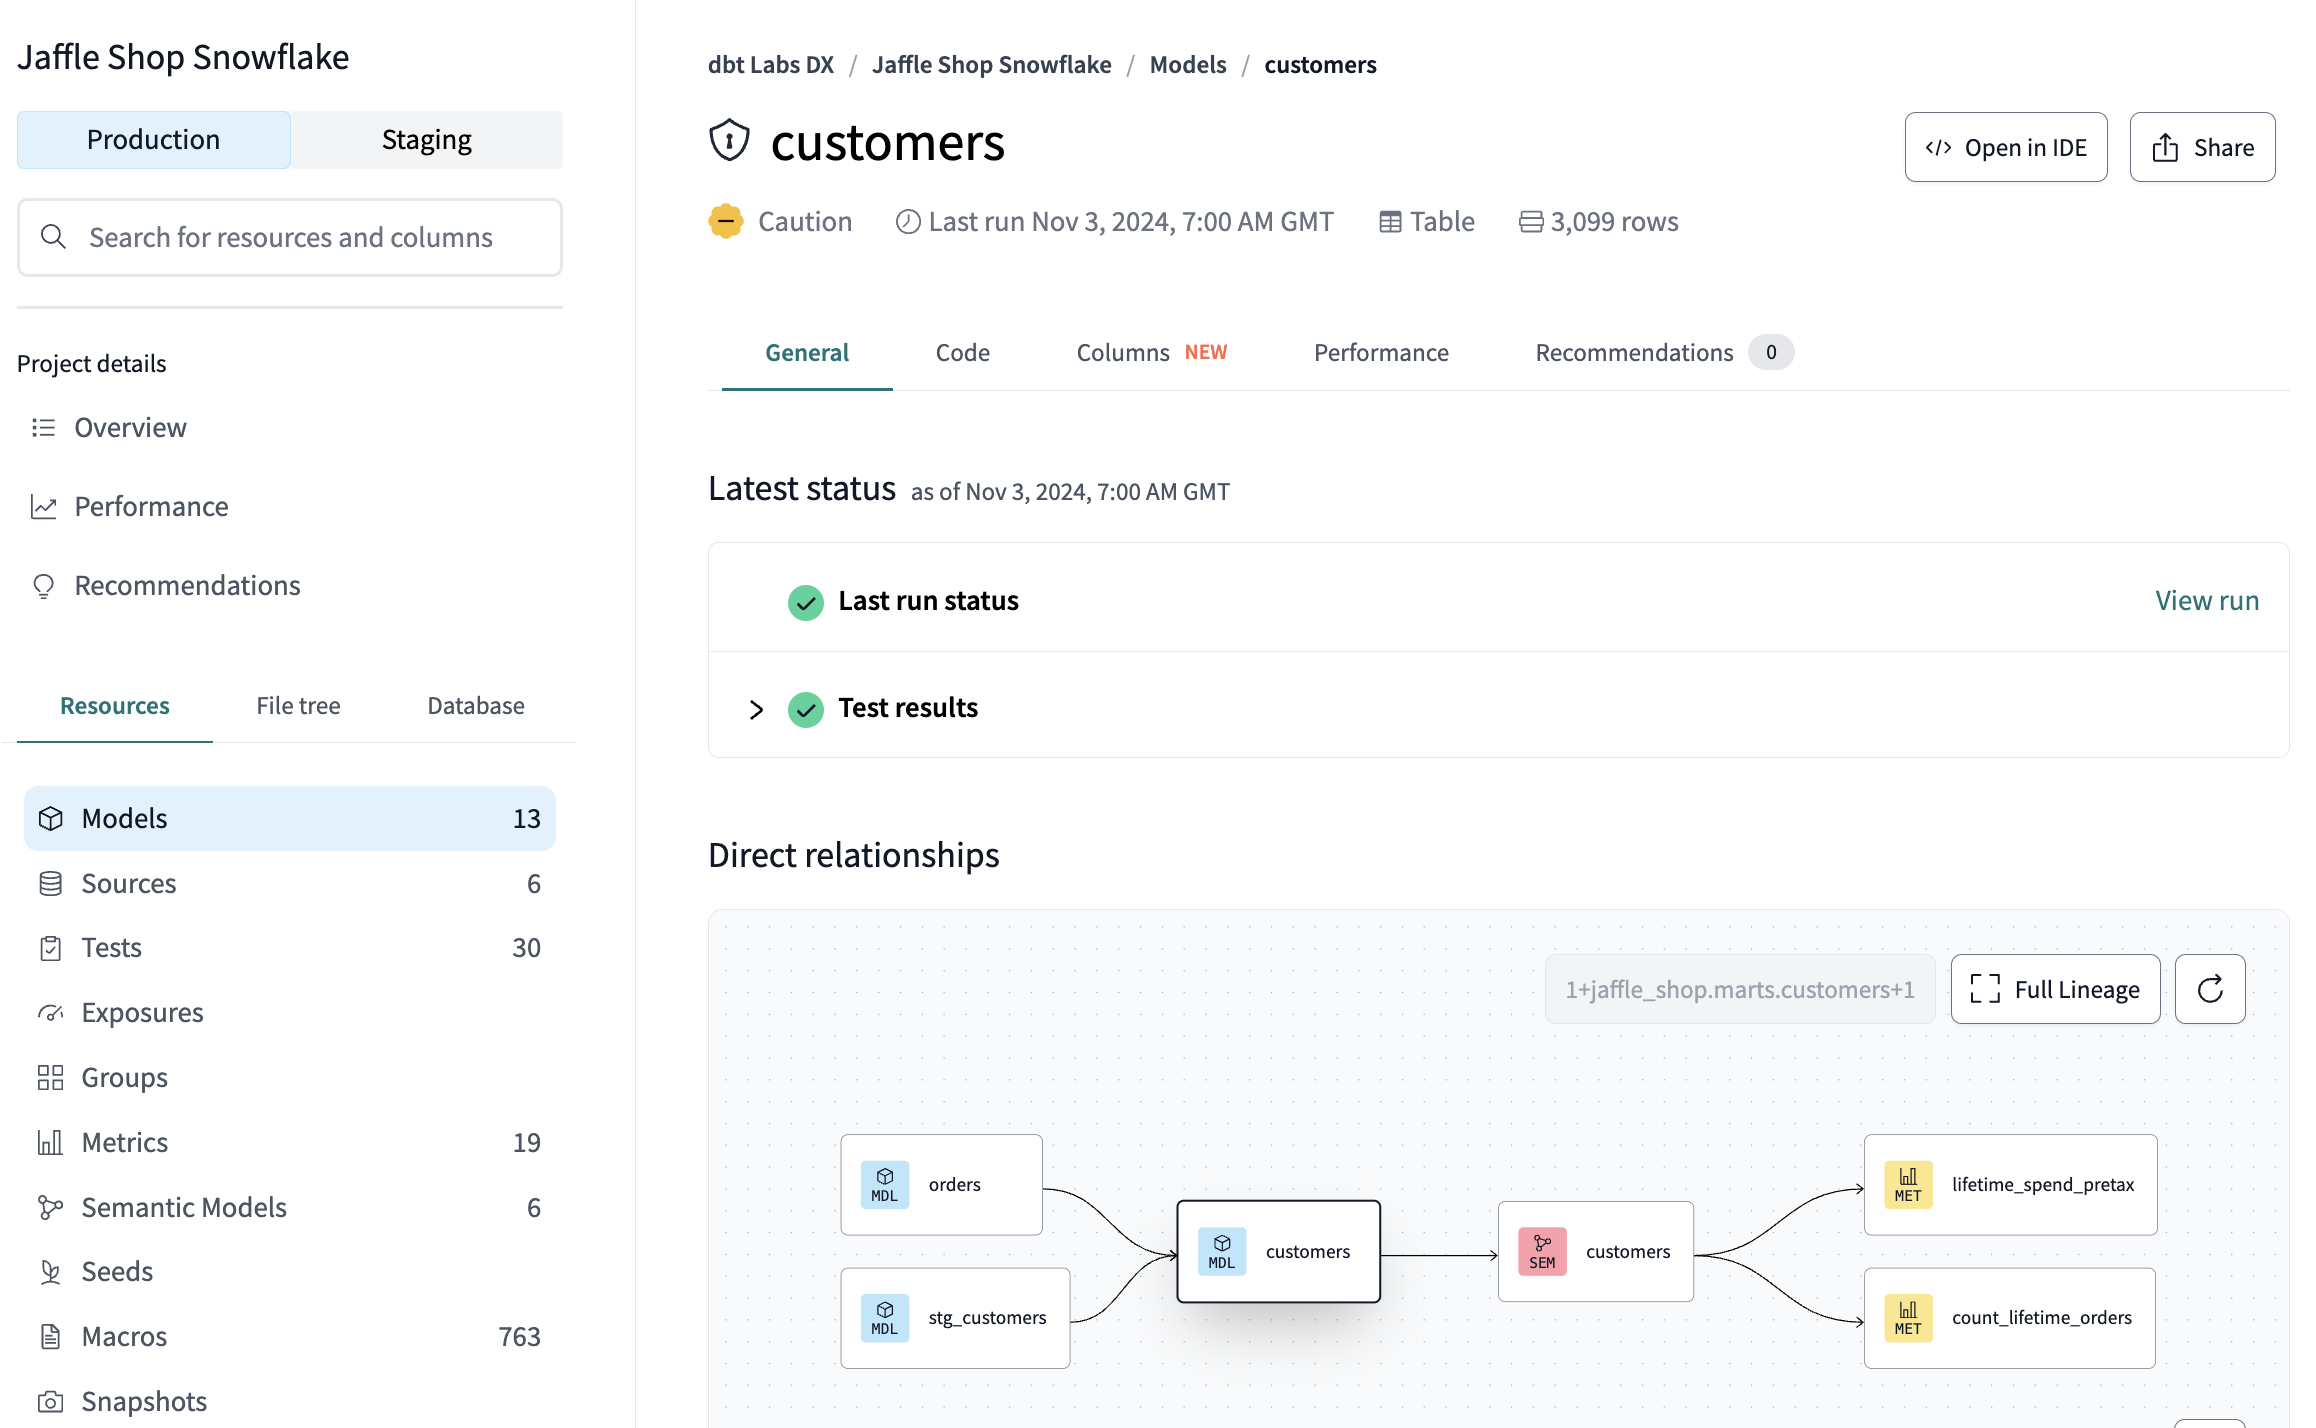 Просмотр документации модели и графа зависимостей в Catalog.
Catalog отображает описание вашей модели, документацию столбцов, тесты данных и граф зависимостей. Вы также можете видеть, для каких столбцов отсутствует документация, и отслеживать покрытие тестами во всем проекте.
Вы можете просматривать документацию непосредственно в IDE, если используете v1 Latest или другую версию dbt v1. Обратите внимание: это устаревший режим просмотра, который не обеспечивает такой же уровень интерактивности, как Catalog.
- В IDE выполните
dbt docs generate. - На панели навигации нажмите значок View docs, расположенный справа от имени ветки.
 Значок View docs в Studio IDE.
- В разделе Projects выберите имя своего проекта и разверните папки.
- Нажмите models > marts > customers.
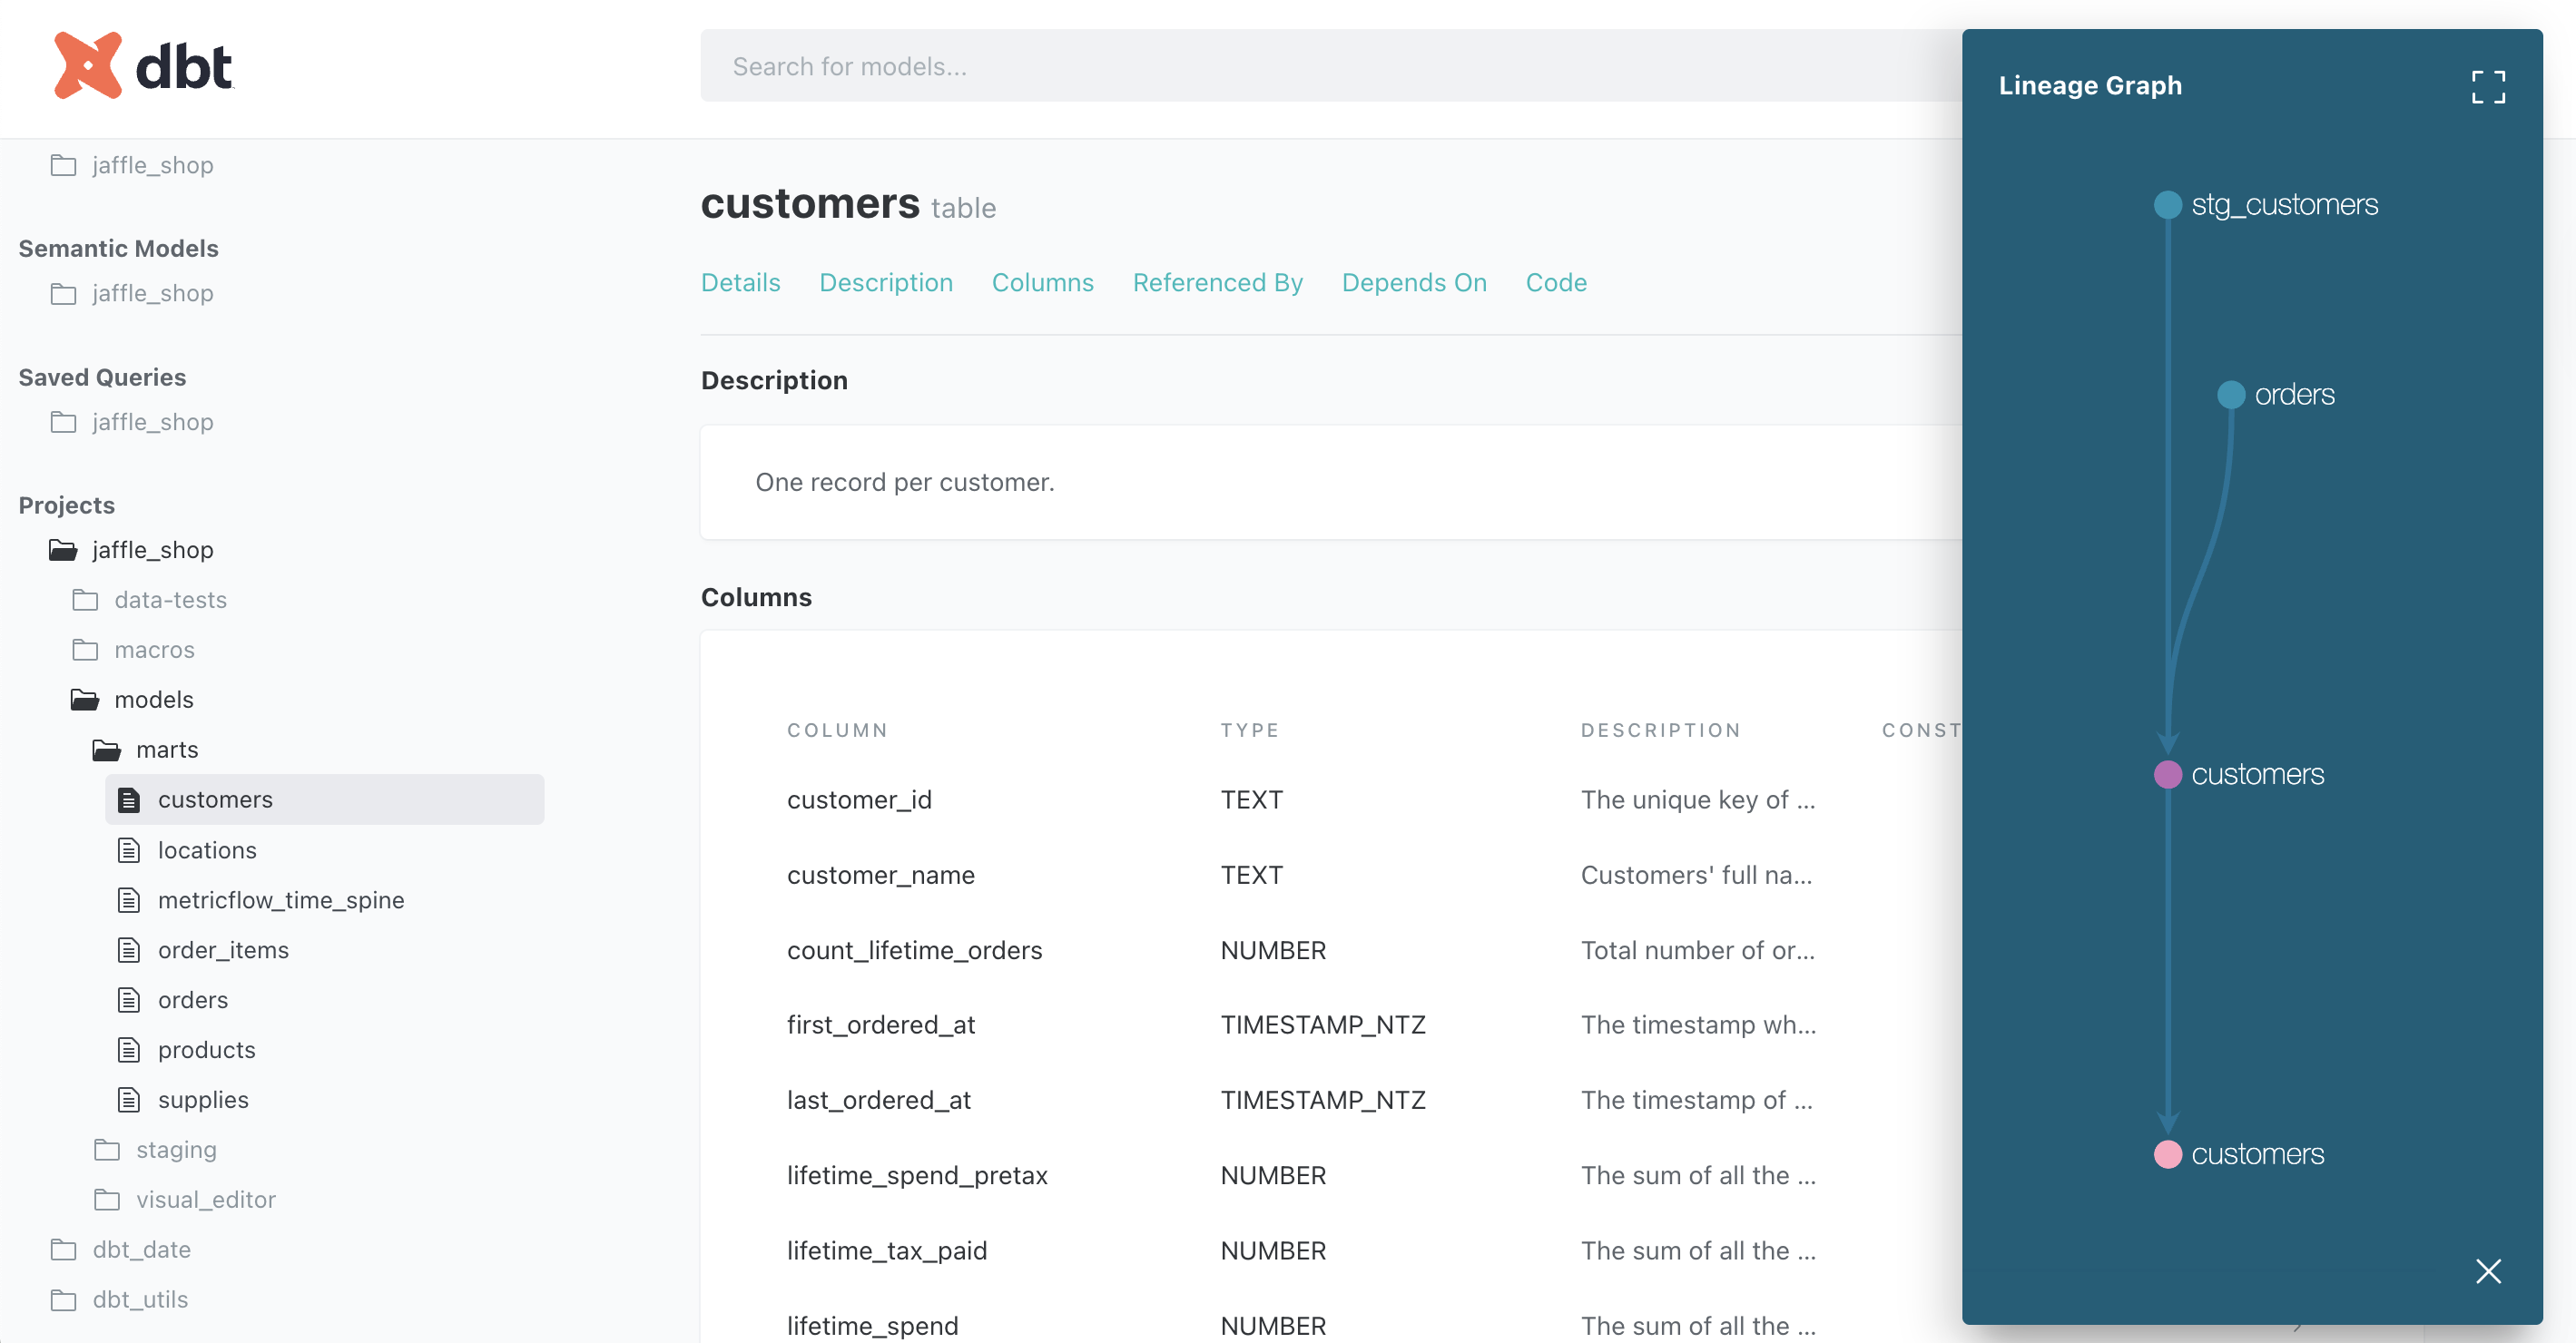 Просмотр документации модели в устаревшем режиме просмотра документации.
Часто задаваемые вопросы
Зафиксируйте изменения
Теперь, когда вы построили модель customers, нужно закоммитить внесённые в проект изменения, чтобы в репозитории оказался ваш актуальный код.
Если вы вносили изменения непосредственно в защищённую основную ветку:
- Нажмите кнопку Commit and sync git. Это действие подготовит ваши изменения к коммиту.
- Появится модальное окно с заголовком Commit to a new branch.
- В модальном окне задайте новой ветке имя
add-customers-model. Будет создана ветка от вашей основной ветки с внесёнными изменениями. - Добавьте сообщение коммита, например «Добавлена модель customers, тесты и документация», и создайте коммит с вашими изменениями.
- Нажмите Merge this branch to main, чтобы добавить эти изменения в ветку main вашего репозитория.
Если вы создали новую ветку до редактирования:
- Поскольку вы уже ответвились от защищённой основной ветки, слева перейдите в Version Control.
- Нажмите Commit and sync, чтобы добавить сообщение.
- Добавьте сообщение коммита, например «Добавить модель customers, тесты и документацию».
- Нажмите Merge this branch to main, чтобы добавить эти изменения в ветку main вашего репозитория.
Разверните dbt
Используйте планировщик dbt, чтобы уверенно запускать задания в продакшене и обеспечивать наблюдаемость ваших процессов. Далее вы узнаете, как создать среду развертывания и запустить задание.
Создайте окружение развертывания (deployment environment)
- В главном меню перейдите в Orchestration > Environments.
- Нажмите Create environment.
- В поле Name введите имя среды развертывания. Например, "Production".
- В поле dbt version по умолчанию выбрана последняя доступная версия. Мы рекомендуем использовать последнюю версию dbt для всех новых проектов.
- В разделе Deployment connection введите имя набора данных, который вы хотите использовать в качестве целевого, например "Analytics". Это позволит dbt создавать объекты в этом наборе данных и работать с ним. В некоторых хранилищах данных целевой набор данных может называться «схемой».
- Нажмите Save.
Создайте и запустите job
Jobs — это набор команд dbt, которые вы хотите запускать по расписанию. Например, dbt build.
По мере того как бизнес jaffle_shop получает больше клиентов, а эти клиенты создают больше заказов, в исходных данных будет появляться больше записей. Поскольку вы материализовали модель customers как таблицу, вам нужно периодически пересобирать её, чтобы данные оставались актуальными. Это обновление будет происходить при запуске job.
- После создания окружения развертывания вы должны попасть на страницу нового окружения. Если нет — в главном меню выберите Orchestration, затем нажмите Jobs.
- Нажмите Create job > Deploy job.
- Укажите имя job (например, «Production run») и выберите окружение, которое вы только что создали.
- Прокрутите вниз до раздела Execution settings.
- В разделе Commands добавьте эту команду как часть job, если её нет:
dbt build
- (Версии dbt: v2.0 и новее) Добавлять шаг создания документации не нужно. При каждом запуске задания метаданные вашего проекта в Catalog обновляются автоматически.
- В этом упражнении не задавайте расписание запуска проекта — хотя проект вашей организации должен запускаться регулярно, для этого примера запуск по расписанию не нужен. Настройку запуска задания по расписанию иногда называют развёртыванием проекта.
- Нажмите Save, затем нажмите Run now, чтобы запустить задание.
- Нажмите на запуск и следите за его ходом в разделе Run summary.
- После завершения запуска (Версии dbt: v2.0 и новее) нажмите Catalog на панели навигации, чтобы изучить свой проект.
Поздравляем 🎉! Вы только что развернули свой первый dbt‑проект!
Часто задаваемые вопросы
Теперь, когда ваш проект настроен и работает, подключите к нему свой ИИ-инструмент (например, Claude или ChatGPT) через dbt MCP server, чтобы задавать вопросы о моделях на естественном языке. Описания, тесты и семантические модели помогут сделать его ответы ещё лучше.