Перевод вашего проекта dbt Databricks в продакшн
Введение
Добро пожаловать в третью часть нашей подробной серии об оптимизации и развертывании конвейеров данных с помощью Databricks и dbt. В этом руководстве мы подробно рассмотрим, как сделать эти модели доступными конечным пользователям, применяя лучшие практики, чтобы данные в вашей производственной среде оставались надежными и своевременно обновлялись.
Предварительные требования
Если у вас нет каких-либо из следующих требований, обратитесь к инструкциям в Настройка вашего проекта dbt с Databricks для помощи в их выполнении:
- Вы настроили проект dbt для работы с Databricks.
- Вы оптимизировали модели dbt для максимальной производительности.
- Вы создали два каталога в Databricks: dev и prod.
- Вы создали субъект-службу (Service Principal) в Databricks для выполнения заданий в production.
- У вас есть хотя бы одна среда развертывания в dbt.
Чтобы начать, давайте вернемся к среде развертывания, созданной для ваших данных в продакшене.
Среды развертывания
В программной инженерии среды играют ключевую роль, позволяя инженерам разрабатывать и тестировать код, не влияя на конечных пользователей их программного обеспечения. Аналогично, вы можете проектировать data lakehouses с отдельными средами. Продакшн среда включает в себя отношения (схемы, таблицы и представления), которые запрашивают или используют конечные пользователи, обычно в BI инструменте или модели ML.
В dbt окружения бывают двух типов:
- Окружение развертывания — определяет настройки, используемые для выполнения заданий, созданных в этом окружении.
- Окружение разработки — определяет настройки, используемые в Studio IDE для конкретного проекта dbt.
В каждом проекте dbt может быть несколько окружений развертывания, но только одно окружение разработки на пользователя.
Создание и планирование продакшн задачи
С вашей настроенной средой развертывания пришло время создать продакшн задачу для выполнения в вашей prod среде.
Для развертывания наших рабочих процессов преобразования данных мы будем использовать встроенный планировщик заданий dbt. Планировщик заданий разработан специально для упрощения развертывания и запуска проектов dbt, чтобы вы могли легко создавать, отслеживать и эффективно изменять свои конвейеры данных.
Использование планировщика заданий dbt позволяет командам по работе с данными полностью управлять рабочим процессом преобразования. Вам не нужно изучать и поддерживать дополнительные инструменты оркестрации или полагаться на другую команду для запуска написанного вашей командой кода по расписанию. Такой полный контроль упрощает процесс развертывания и ускоряет выпуск новых продуктов на основе данных.
Давайте создадим задание в dbt, которое будет преобразовывать данные в нашем каталоге prod в Databricks.
-
Создайте новую задачу, нажав Deploy в заголовке, затем Jobs и Create job.
-
Назовите задачу “Ежедневное обновление”.
-
Установите Environment на вашу production среду.
- Это позволит задаче наследовать каталог, схему, учетные данные и переменные среды, определенные в Настройка вашего проекта dbt с Databricks.
-
В разделе Execution Settings
- Установите флажок Generate docs on run, чтобы настроить задачу на автоматическую генерацию документации проекта каждый раз, когда эта задача выполняется. Это обеспечит актуальность вашей документации по мере добавления и изменения моделей.
- Выберите флажок Run on source freshness, чтобы настроить dbt source freshness как первый шаг этой задачи. Ваши источники должны быть настроены на снимок информации о свежести, чтобы это давало значимые инсайты.
Добавьте следующие три Commands:
dbt source freshness- Это проверит, не устарели ли какие-либо источники. Мы не хотим пересчитывать модели с данными, которые не изменились с момента нашего последнего запуска.
dbt test --models source:*- Это проверит качество данных наших исходных данных, например, убедится, что поля ID уникальны и не пусты. Мы не хотим, чтобы плохие данные попадали в продакшн модели.
dbt build --exclude source:* --fail-fast
- dbt build эффективнее, чем отдельный запуск команд dbt run и dbt test, поскольку сначала выполняет каждую модель, а затем тестирует её, прежде чем продолжить.
- Мы исключаем исходные данные, поскольку уже протестировали их на шаге 2.
- Флаг fail-fast заставляет dbt немедленно завершить работу, если не удаётся собрать хотя бы один ресурс. Если в момент сбоя первой модели другие модели ещё выполняются, dbt закроет соединения для этих моделей.
-
В разделе Triggers используйте переключатель, чтобы настроить запуск задания по расписанию. Вы можете указать конкретные дни и время или создать собственное расписание cron.
- Если вы хотите, чтобы запуск задания dbt по расписанию выполнялся другим оркестратором, например Databricks Workflows, см. раздел Дополнительные рекомендации ниже.
-
В разделе Triggers с помощью переключателя настройте ваш job на запуск по расписанию. Вы можете указать конкретные дни и время либо создать собственное cron-расписание.
- Если вы хотите, чтобы ваш job в запускался другим оркестратором, например Databricks Workflows, см. раздел Advanced Considerations ниже.
Это всего лишь один пример списка команд "все или ничего", предназначенного для минимизации потерь вычислительных ресурсов. Список команд задач и селекторы предоставляют большую гибкость в том, как будет выполняться ваш DAG. Вы можете захотеть спроектировать свой так, чтобы продолжать выполнение определенных моделей, если другие не удаются. Вы можете захотеть настроить несколько задач для обновления моделей с разной частотой. См. наш Job Creation Best Practices discourse для получения дополнительных предложений по проектированию задач.
После того как ваша задача настроена и успешно выполняется, настройте ваши артефакты проекта, чтобы эта задача информировала ваш сайт документации продакшн и панель данных источников, к которым можно получить доступ из пользовательского интерфейса.
Это будет наша основная продакшн задача для обновления данных, которые будут использоваться конечными пользователями. Еще одна задача, которую все должны включить в свой проект dbt, это задача непрерывной интеграции.
CI/CD, или непрерывная интеграция и непрерывное развёртывание/доставка, стала стандартной практикой в разработке программного обеспечения, позволяющей быстро выпускать новые функции и исправления ошибок, сохраняя высокое качество и стабильность. dbt позволяет применять эти практики к преобразованиям данных.
Приведённые ниже шаги показывают, как создать CI-тест для вашего проекта dbt. CD в dbt не требует дополнительных действий, поскольку ваши задания автоматически подхватывают последние изменения из ветки, назначенной среде, в которой выполняется задание. В зависимости от вашей стратегии развёртывания вы можете добавить дополнительные шаги. Если вы хотите подробнее узнать о вариантах CD, ознакомьтесь с этой статьёй о внедрении CI/CD с помощью dbt.
Ниже описаны шаги по созданию CI‑теста для вашего dbt‑проекта. CD в не требует дополнительных шагов, так как ваши jobs автоматически подхватывают последние изменения из ветки, назначенной среде, в которой выполняется job. В зависимости от вашей стратегии развертывания вы можете добавить дополнительные шаги. Если вы хотите глубже разобраться в вариантах CD, ознакомьтесь с этой статьей в блоге о внедрении CI/CD с помощью .
dbt позволяет писать data tests для вашего data pipeline, которые можно запускать на каждом этапе процесса, чтобы обеспечить стабильность и корректность преобразований данных. Основные места, где вы будете использовать dbt‑тесты, следующие:
- Ежедневные запуски: Регулярное выполнение тестов на вашем конвейере данных помогает выявлять проблемы, вызванные плохими исходными данными, обеспечивая качество данных, которые достигают ваших пользователей.
- Разработка: Выполнение тестов во время разработки гарантирует, что изменения в вашем коде не нарушают существующие предположения, позволяя разработчикам быстрее итеративно работать, выявляя проблемы сразу после написания кода.
- Проверки CI: Автоматизированные задачи CI выполняют и тестируют ваш конвейер от начала до конца, когда создается запрос на слияние, обеспечивая уверенность разработчикам, рецензентам кода и конечным пользователям, что предлагаемые изменения надежны и не вызовут сбоев или проблем с качеством данных.
- Каталог с именем test
- Субъект-служба (service principal) с именем dbt_test_sp
- Новая среда dbt с именем test, которая по умолчанию использует каталог test и токен dbt_test_sp в учетных данных развертывания
Мы рекомендуем настроить CI-задание в dbt. Это сократит время выполнения задания за счет запуска и тестирования только измененных моделей, что также снизит затраты на вычислительные ресурсы в lakehouse. Подробные инструкции по созданию CI-задания см. в разделе Настройка CI-заданий.
Мы рекомендуем настроить CI‑задачу в . Это позволит сократить время выполнения задач за счет запуска и тестирования только изменённых моделей, а также снизить вычислительные затраты в lakehouse. Подробные инструкции по созданию CI‑задачи см. в разделе Set up CI jobs.
С тестами dbt и SlimCI вы можете быть уверены, что ваши данные в продакшене будут своевременными и точными, даже при высокой скорости доставки.
Внимательное наблюдение за заданиями dbt крайне важно для поддержания надежного и эффективного конвейера данных. Отслеживая производительность заданий и быстро выявляя потенциальные проблемы, вы можете обеспечить бесперебойное выполнение преобразований данных. dbt предоставляет три способа отслеживания состояния проекта: историю запусков, монитор развертывания и плитки состояния.
Панель истории запусков в dbt предоставляет подробную информацию обо всех запусках заданий вашего проекта и различные фильтры, которые помогают сосредоточиться на нужных аспектах. Это отличный инструмент для разработчиков, которым нужно проверить недавние запуски, убедиться в корректности результатов ночных запусков или отследить ход выполнения текущих заданий. Чтобы открыть эту панель, выберите Run History в меню Deploy.
Монитор развертывания в dbt предоставляет сводное представление истории запусков, позволяя оценить состояние конвейера данных за продолжительный период времени. Он содержит информацию о длительности запусков и доле успешных запусков, что позволяет выявлять тенденции в работе заданий, например увеличение времени выполнения или более частые сбои. Монитор развертывания также выделяет выполняющиеся задания, задания в очереди и недавние сбои. Чтобы открыть монитор развертывания, нажмите на логотип dbt в левом верхнем углу интерфейса dbt.
Мониторинг деплоев в предоставляет более высокоуровневое представление истории запусков и позволяет оценить состояние вашего конвейера данных за более длительный период времени. Эта функция включает информацию о длительности запусков и показателях успешности, что помогает выявлять тенденции в производительности заданий, например, рост времени выполнения или увеличение числа сбоев. Мониторинг деплоев также подсвечивает выполняющиеся задания, задания в очереди и недавние ошибки. Чтобы открыть мониторинг деплоев, нажмите на логотип dbt в левом верхнем углу интерфейса .
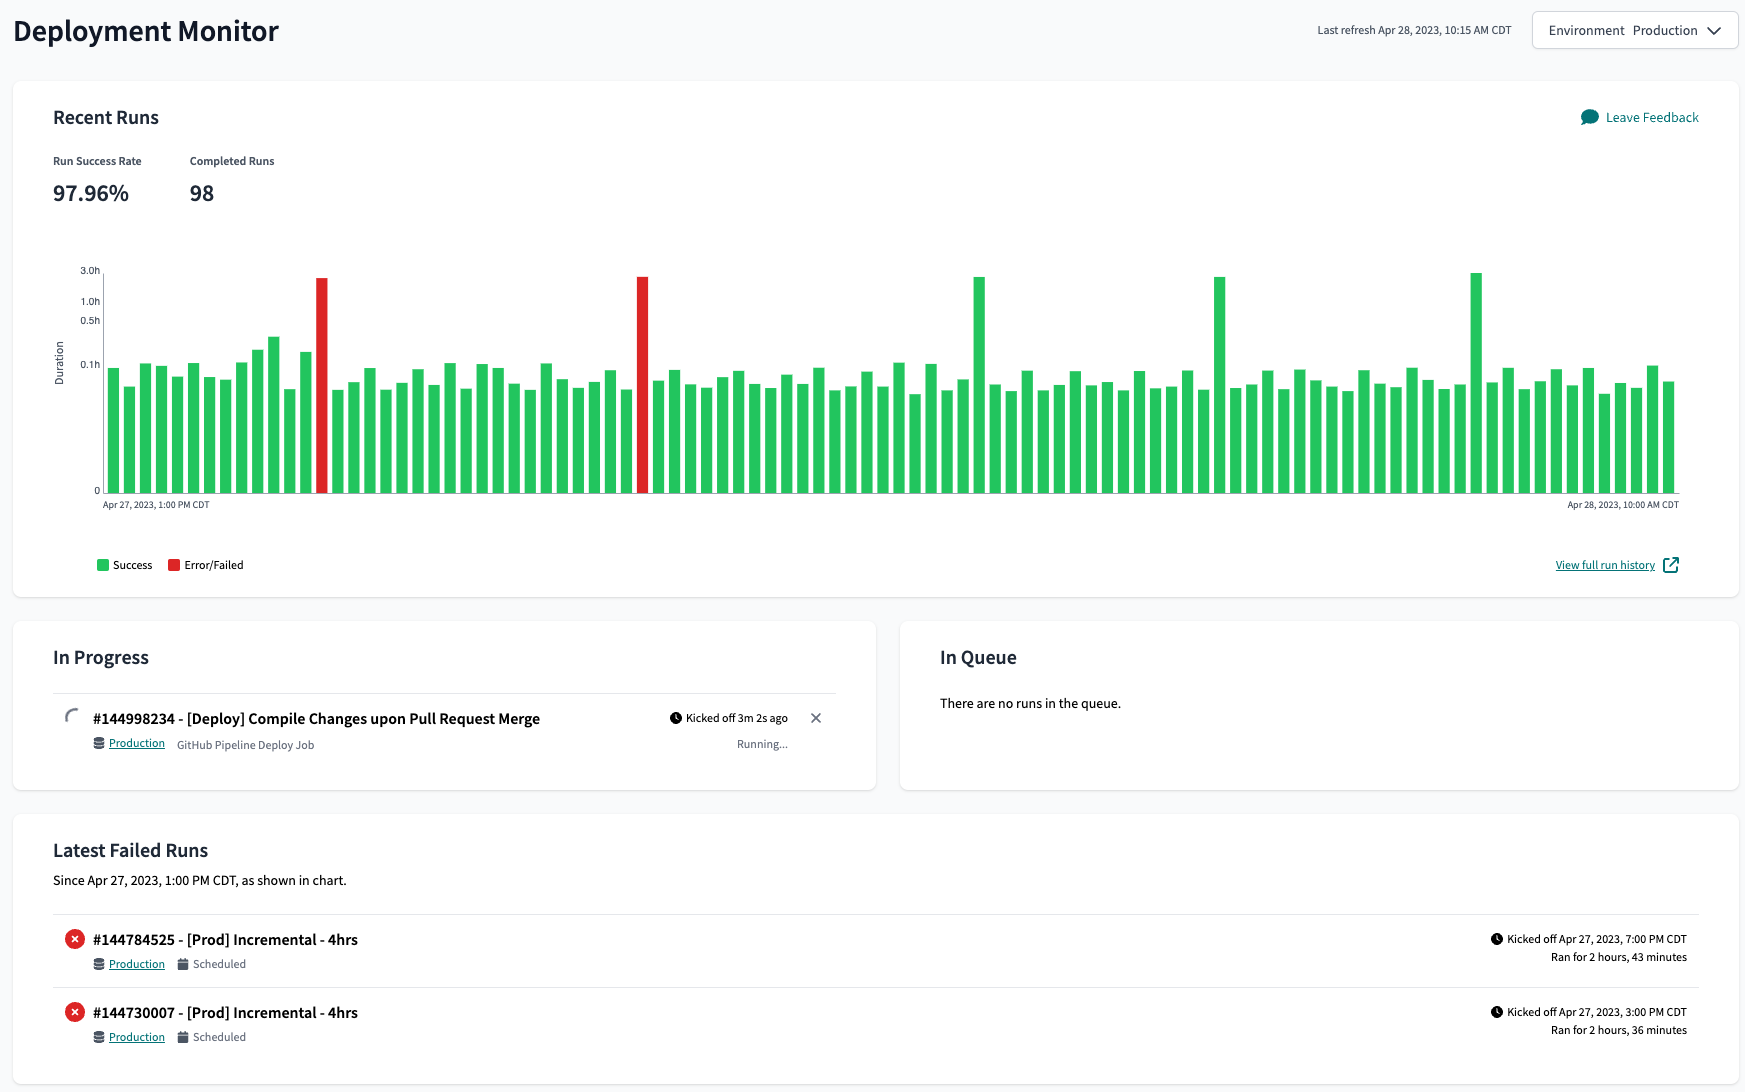 Монитор развертывания показывает статус задач с течением времени в разных средах
Добавляя data health tiles в ваши BI-дашборды, вы даёте стейкхолдерам наглядное представление о состоянии вашего data pipeline, не заставляя их покидать привычный интерфейс. Data tiles повышают доверие к данным и помогают избежать лишних вопросов или необходимости переключаться между инструментами. Чтобы реализовать status tiles на дашбордах, у вас должна быть настроена документация dbt с определёнными exposures.
Настройка уведомлений в dbt позволяет получать оповещения по электронной почте или в канале Slack при каждом завершении запуска. Это гарантирует, что соответствующие команды получат уведомления и смогут оперативно принять меры, если задания завершатся с ошибкой или будут отменены. Чтобы настроить уведомления:
- Перейдите в настройки вашего проекта dbt.
- Выберите вкладку Notifications.
- Выберите нужный тип уведомлений (Email или Slack) и настройте соответствующие параметры.
Если вам нужны уведомления через другие каналы, помимо электронной почты или Slack, вы можете использовать функцию исходящих вебхуков в dbt для передачи событий заданий в другие инструменты. Вебхуки позволяют интегрировать dbt с широким спектром SaaS-приложений, распространяя автоматизацию вашего пайплайна на другие системы.
Если вам требуются уведомления через другие каналы, помимо электронной почты или Slack, вы можете использовать функцию исходящих webhooks в для передачи событий заданий в другие инструменты. Webhooks позволяют интегрировать с широким спектром SaaS‑приложений, расширяя автоматизацию вашего пайплайна на другие системы.
Устранение неполадок
Пять основных шагов для устранения проблем с dbt:
-
Прочитайте сообщение об ошибке: сообщения об ошибках dbt обычно указывают тип ошибки и файл, в котором возникла проблема.
-
Изучите проблемный файл и попробуйте найти очевидное исправление.
-
Локализуйте проблему, запуская по одной модели в Studio IDE или отменяя изменения кода, вызвавшие проблему.
-
Проверьте скомпилированные файлы и журналы на наличие проблем.
-
Прочитайте сообщение об ошибке: сообщения об ошибках dbt обычно указывают тип ошибки и файл, в котором она произошла.
-
Проверьте проблемный файл и поищите очевидное решение.
-
Изолируйте проблему, запуская по одной модели в или откатывая код, который вызвал ошибку.
-
Проверьте наличие проблем в скомпилированных файлах и логах.
Чтобы устранить проблемы с заданием dbt, перейдите на вкладку «Deploy > Run History» в вашем проекте dbt и выберите неудачный запуск. Затем разверните шаги запуска, чтобы просмотреть журналы консоли и отладки с подробными сообщениями. Чтобы получить дополнительную информацию, откройте вкладку «Artifacts» и скачайте скомпилированные файлы, связанные с этим запуском.
Чтобы устранить проблемы с заданием , перейдите на вкладку Deploy > Run History в вашем проекте и выберите неудачный запуск. Затем разверните шаги выполнения, чтобы просмотреть console и debug логи и изучить подробные сообщения журнала. Чтобы получить дополнительную информацию, откройте вкладку Artifacts и скачайте скомпилированные файлы, связанные с этим запуском.
Если ваши задачи занимают больше времени, чем ожидалось, используйте панель времени выполнения модели для выявления узких мест в вашем конвейере. Анализ времени, затраченного на выполнение каждой модели, помогает вам определить самые медленные компоненты и оптимизировать их для повышения производительности. История запросов Databricks Query History позволяет вам изучать детальные сведения, такие как время, затраченное на каждую задачу, возвращенные строки, производительность ввода-вывода и план выполнения.
Для получения дополнительной информации о настройке производительности ознакомьтесь с нашим руководством по Как оптимизировать и устранять неполадки моделей dbt на Databricks.
По мере накопления опыта работы с dbt и Databricks вы, возможно, захотите изучить продвинутые методы, чтобы усовершенствовать свой конвейер данных и улучшить управление преобразованиями данных. Темы этого раздела не обязательны к изучению, но помогут вам укрепить производственную среду, повысив её безопасность, эффективность и доступность.
По мере того как вы будете набираться опыта работы с и Databricks, вам может понадобиться изучить более продвинутые техники, которые помогут дополнительно улучшить ваш data pipeline и оптимизировать управление преобразованиями данных. Темы в этом разделе не являются обязательными, но они помогут укрепить production‑окружение, повысив уровень безопасности, эффективности и доступности.
Планировщик заданий dbt предлагает несколько способов запуска заданий. Если ваши преобразования dbt — лишь один из этапов более масштабного процесса оркестрации, используйте API dbt для запуска задания из Databricks Workflows.
Планировщик заданий предлагает несколько способов запуска ваших заданий. Если преобразования dbt — это лишь один из шагов в более крупном оркестрационном workflow, используйте API , чтобы запускать ваше задание из Databricks Workflows.
API обеспечивает интеграцию между вашими заданиями dbt и рабочим процессом Databricks, позволяя эффективно управлять преобразованиями данных в рамках общего конвейера обработки данных.
Добавление заданий dbt в Databricks Workflows позволяет объединять внешние задачи в цепочки, сохраняя при этом следующие преимущества dbt:
- Контекст пользовательского интерфейса: интерфейс dbt позволяет определять задание в контексте ваших окружений dbt, упрощая создание соответствующих конфигураций и управление ими.
- Журналы и история запусков: использование dbt упрощает доступ к журналам и истории запусков.
- Функции мониторинга и уведомлений: dbt предоставляет функции мониторинга и уведомлений, подобные описанным выше, которые помогают отслеживать состояние и производительность ваших заданий.
Чтобы запустить задание dbt из Databricks, следуйте инструкциям в нашем руководстве по запуску заданий dbt с помощью Databricks Workflows.
Чтобы запускать задания из Databricks, следуйте инструкциям в нашем руководстве Запуск заданий из Databricks Workflows.
В нашем руководстве Рекомендации по работе с dbt и Unity Catalog рекомендуется использовать отдельные каталоги dev и prod для сред разработки и развертывания, а управление конфигурациями и разрешениями для изоляции сред выполнять с помощью Unity Catalog и dbt. Крайне важно обеспечивать безопасность, сохраняя при этом эффективность работы в средах разработки и развертывания. Для защиты конфиденциальных данных, таких как персональные данные (PII), могут потребоваться дополнительные меры безопасности.
В нашем руководстве Рекомендации по работе с dbt и Unity Catalog рекомендуется использовать отдельные каталоги dev и prod для сред разработки и развертывания, при этом Unity Catalog и берут на себя управление конфигурациями и правами доступа для изоляции окружений. Обеспечение безопасности при сохранении эффективности в средах разработки и развертывания имеет решающее значение. Для защиты чувствительных данных, таких как персональные данные (PII), могут потребоваться дополнительные меры безопасности.
Databricks использует Динамические представления для включения маскирования данных на основе членства в группе. Поскольку представления в Unity Catalog используют Spark SQL, вы можете реализовать продвинутое маскирование данных, используя более сложные SQL выражения и регулярные выражения. Вы также можете применять более детализированные средства управления доступом, такие как фильтры строк в предварительном просмотре и маски столбцов в предварительном просмотре на таблицах в Databricks Unity Catalog, что будет рекомендованным подходом для защиты конфиденциальных данных, как только это станет общедоступным. В ближайшем будущем Databricks Unity Catalog также позволит нативно использовать управление доступом на основе атрибутов, что упростит защиту конфиденциальных данных в масштабе.
Чтобы реализовать маскирование данных в модели dbt, убедитесь, что конфигурация материализации модели установлена на представление. Затем добавьте оператор case, используя функцию is_account_group_member для идентификации групп, которым разрешено просматривать значения в открытом виде. Затем используйте regex для маскирования данных для всех остальных пользователей. Например:
CASE
WHEN is_account_group_member('auditors') THEN email
ELSE regexp_extract(email, '^.*@(.*)$', 1)
END
Рекомендуется не предоставлять пользователям возможность читать таблицы и представления, на которые ссылается динамическое представление. Вместо этого назначьте ваши источники dbt динамическим представлениям, а не сырым данным, позволяя разработчикам безопасно выполнять полные сборки и команды свежести источников.
Использование одних и тех же источников для сред разработки и развертывания позволяет тестировать с теми же объемами и частотой, которые вы увидите в продакшене. Однако это может привести к тому, что запуски разработки будут занимать больше времени, чем необходимо. Чтобы решить эту проблему, рассмотрите возможность использования переменной Jinja target.name для ограничения данных при работе в среде разработки.
Сочетание dbt Docs и Unity Catalog
Хотя между dbt docs и Databricks Unity Catalog есть сходства, они в конечном итоге используются для разных целей и хорошо дополняют друг друга. Объединяя их сильные стороны, вы можете предоставить вашей организации надежную и удобную экосистему управления данными.
dbt docs — это сайт документации, созданный на основе вашего проекта dbt. Он предоставляет разработчикам и заинтересованным сторонам без технической подготовки интерфейс, который позволяет разобраться в происхождении данных и бизнес-логике преобразований без полного доступа к dbt или Databricks. Он также предоставляет дополнительные возможности для организации и поиска данных. Вы можете автоматически создавать и просматривать документацию dbt с помощью dbt, чтобы поддерживать её в актуальном состоянии.
Unity Catalog — это единое решение для управления вашими lakehouse. Оно предоставляет исследователь данных, который можно использовать для обнаружения наборов данных, которые не были определены в dbt. Исследователь данных также фиксирует происхождение на уровне столбцов, когда вам нужно отследить происхождение конкретного столбца.
Чтобы получить максимальную отдачу от обоих инструментов, вы можете использовать persist docs config для передачи описаний таблиц и столбцов, написанных в dbt, в Unity Catalog, делая информацию легко доступной для пользователей обоих инструментов. Сохранение описаний в dbt гарантирует, что они находятся под контролем версий и могут быть воспроизведены после удаления таблицы.
Связанные документы
- Курс по продвинутому развертыванию, если вы хотите глубже изучить эти темы
- Автомасштабирование CI: интеллектуальный Slim CI
- Запуск задания dbt в автоматизированном рабочем процессе с помощью Python
- Краткое руководство по началу работы с Databricks + dbt
- Свяжитесь с командой Databricks, которая работает с вашей учетной записью, чтобы получить доступ к функциям Databricks на стадии предварительного ознакомления.