Быстрый старт с dbt Mesh
Введение
Mesh — это подход, который помогает организациям эффективно масштабировать команды и ресурсы данных. Он способствует внедрению лучших практик управления и позволяет разбивать крупные проекты на управляемые части — для ускорения разработки решений для работы с данными. Mesh доступен для учетных записей dbt Enterprise.
В этом руководстве вы узнаете, как организовать работу с несколькими проектами, используя основные концепции Mesh, и как реализовать data mesh в dbt:
- Настроить базовый проект под названием «Jaffle | Data Analytics»
- Настроить зависимый проект под названием «Jaffle | Finance»
- Добавить настройки доступа к моделям, версии и контракты
- Настроить задание dbt, которое запускается после завершения вышестоящего задания
Подробнее о том, почему data mesh важен, читайте в статье: What is data mesh? The definition and importance of data mesh.
Вы можете бесплатно пройти курс dbt Fundamentals, если вам интересен формат обучения с видео.
Также вы можете посмотреть видео на YouTube про dbt и Snowflake.
Связанные материалы:
- Концепции data mesh: что это и как начать
- Как выбрать структуру для вашего Mesh
- Руководство по лучшим практикам Mesh
- Часто задаваемые вопросы по Mesh
Предварительные требования
Чтобы использовать Mesh, необходимо следующее:
- У вас должна быть учётная запись dbt с тарифом Enterprise EnterpriseEnterprise +
- У вас есть доступ к облачной платформе данных, разрешения на загрузку таблиц с демонстрационными данными и разрешения в dbt на создание новых проектов.
- В этом руководстве используются демонстрационные данные Jaffle Shop, включая таблицы
customers,ordersиpayments. Следуйте приведённым инструкциям, чтобы загрузить эти данные на используемую вами платформу данных:
Также предполагается, что у вас уже есть опыт работы с dbt или базовые знания. Если вы только начинаете, сначала пройдите курс dbt Fundamentals.
Создание и настройка двух проектов
В этом разделе вы создадите два новых пустых проекта в dbt, которые будут служить вашим базовым и нижестоящим проектами:
- Базовые проекты (или upstream‑проекты) обычно содержат основные модели и датасеты, которые служат фундаментом для дальнейшей аналитики и отчетности.
- Downstream‑проекты строятся поверх этого фундамента и часто добавляют более специфичные трансформации или бизнес‑логику для отдельных команд или задач.
Например, предприимчивая вымышленная организация «Jaffle Labs» создаст в своей учетной записи два проекта для команд аналитики данных и финансов: Jaffle | Data Analytics и Jaffle | Finance.
Чтобы создать новый проект в dbt:
- В разделе Account settings перейдите в Projects. Нажмите New project.
- Введите название проекта и нажмите Continue.
- Используйте «Jaffle | Data Analytics» для одного проекта
- Используйте «Jaffle | Finance» для другого проекта
- Выберите свою платформу данных, затем нажмите Next, чтобы настроить подключение.
- В разделе Configure your environment укажите параметры Settings для нового проекта.
- Нажмите Test Connection. Эта проверка подтверждает, что dbt может получить доступ к вашей учетной записи на платформе данных.
- Нажмите Next, если проверка прошла успешно. Если проверка завершилась с ошибкой, возможно, потребуется вернуться и перепроверить настройки.
- В рамках этого руководства обязательно создайте для каждого проекта по одной среде разработки и среде развертывания.
- Для «Jaffle | Data Analytics» задайте базу данных по умолчанию
jaffle_da. - Для «Jaffle | Finance» задайте базу данных по умолчанию
jaffle_finance.
- Для «Jaffle | Data Analytics» задайте базу данных по умолчанию
- В рамках этого руководства обязательно создайте для каждого проекта по одной среде разработки и среде развертывания.
- Следуйте дальнейшим указаниям, чтобы завершить настройку проекта. После настройки в каждом проекте должны быть:
- Подключение к платформе данных
- Новый репозиторий Git
- Одна или несколько сред (например, среда разработки и среда развертывания)
 Перейдите в Account settings.
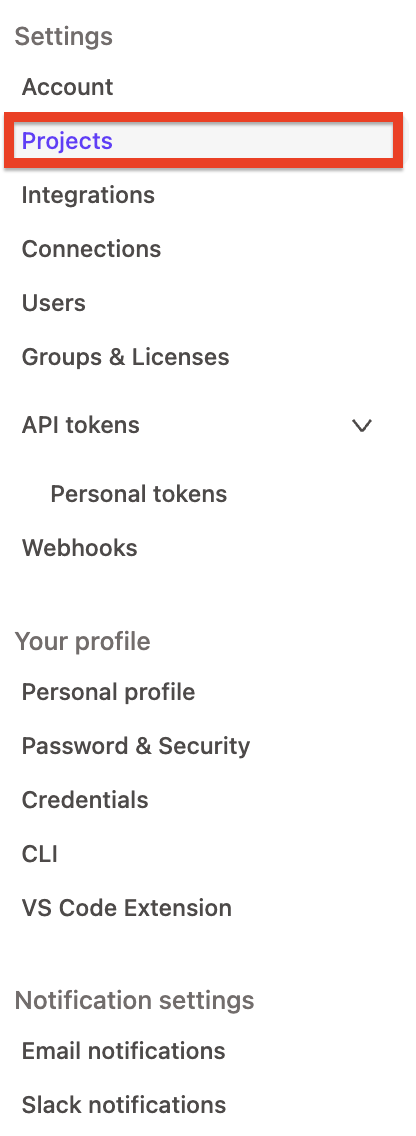 Выберите Projects в меню.
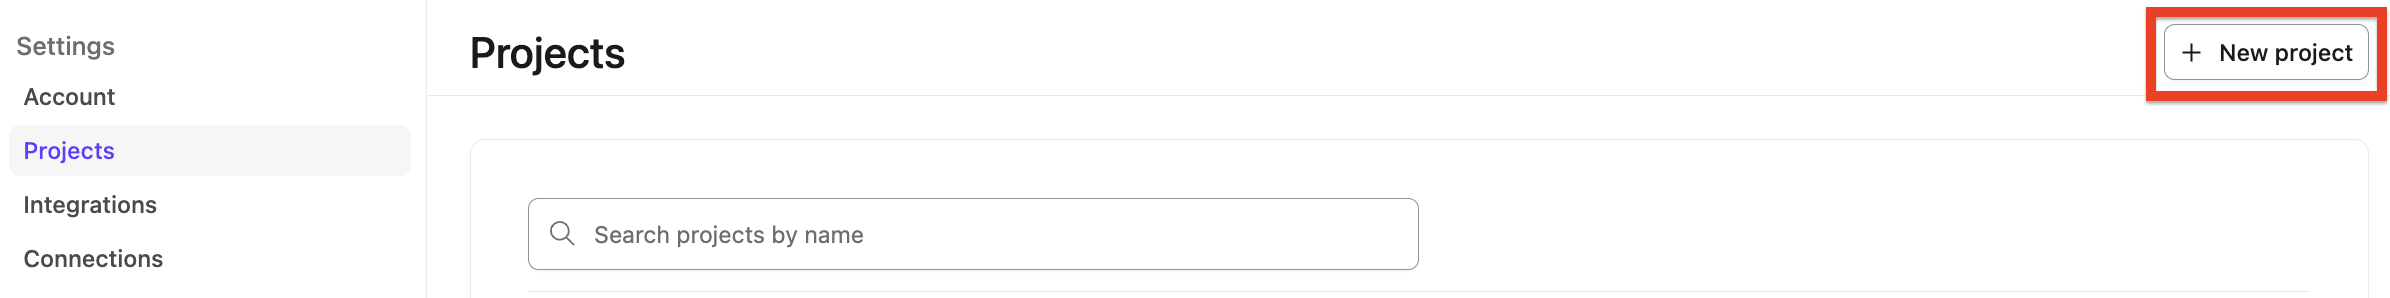 Создание нового проекта в Studio IDE.
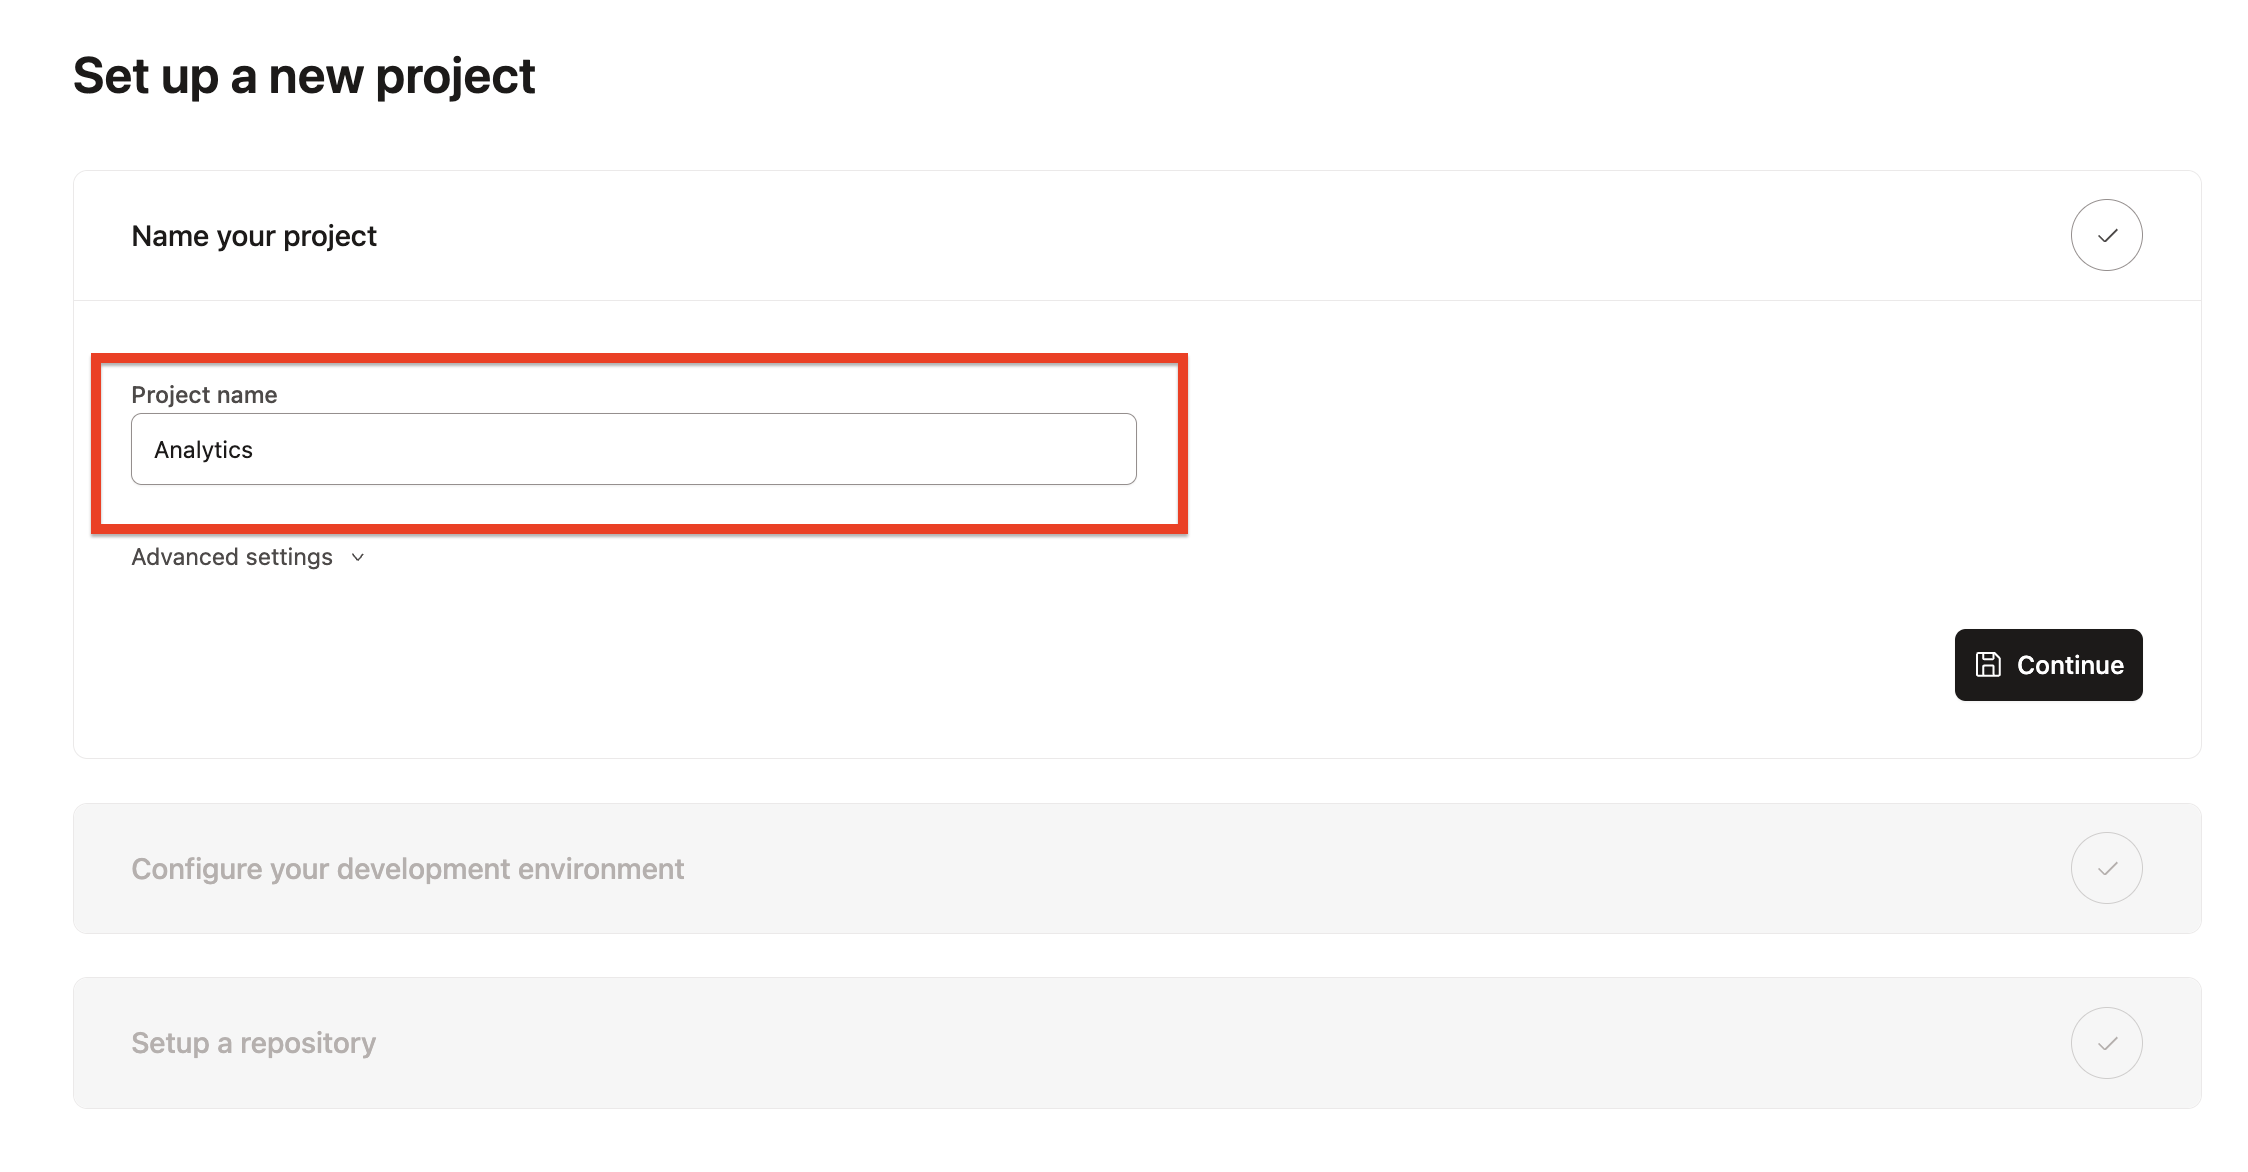 Задайте имя проекта.
 Выберите соответствующее подключение для проектов.
Создайте производственную среду
В dbt в каждом проекте можно назначить одну среду развертывания производственной («Production»). Вы должны настроить среду развертывания «Production» или «Staging» для каждого проекта, который хотите объединить в mesh. Это позволит вам использовать Catalog на последующих этапах этого руководства.
Чтобы настроить production‑окружение:
- Перейдите в Deploy -> Environments и нажмите Create New Environment.
- Выберите тип окружения Deployment.
- В разделе Set deployment type выберите Production.
- Выберите версию dbt.
- Заполните необходимые поля в разделах Deployment connection и Deployment credentials.
- Нажмите Test Connection, чтобы проверить подключение.
- Нажмите Save, чтобы создать production‑окружение.
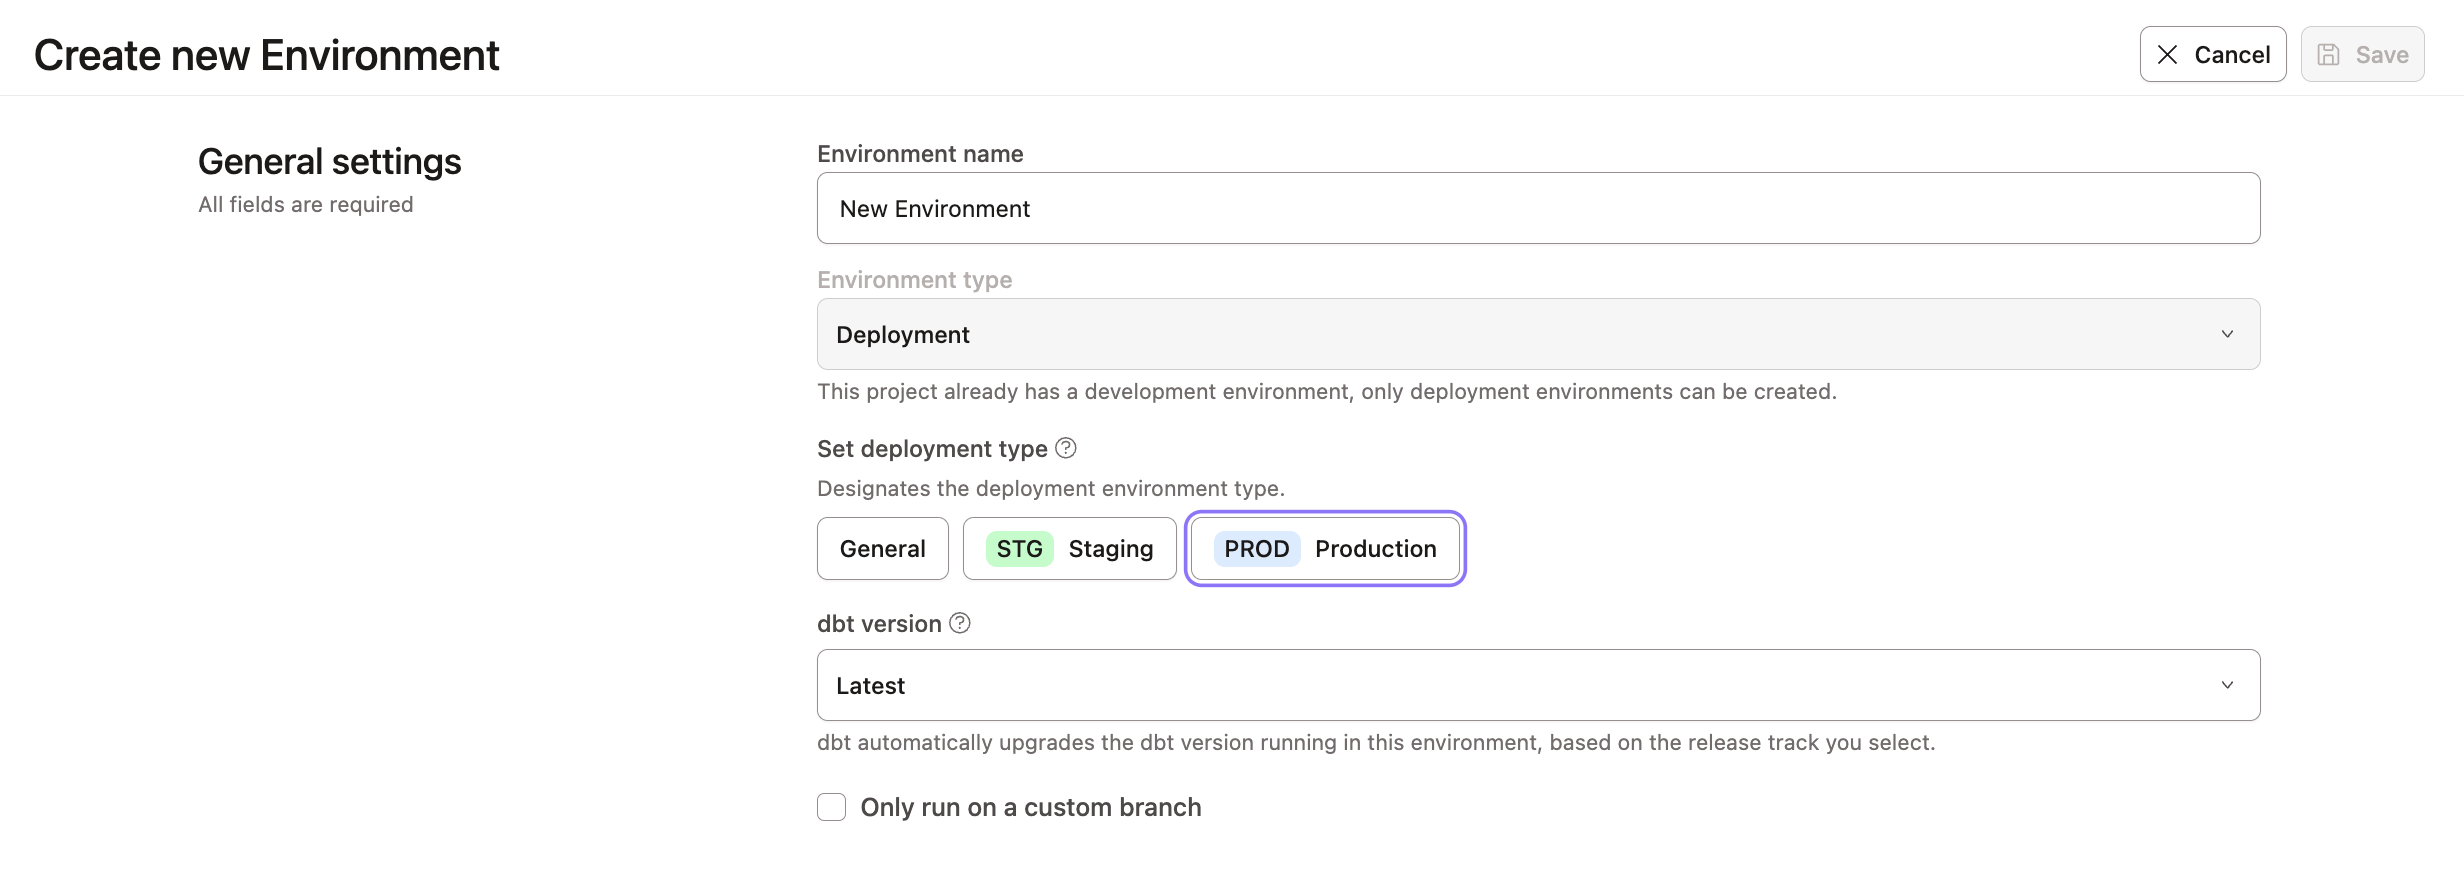 Установите производственную среду в качестве среды по умолчанию в настройках среды
Настройка базового проекта
В этом вышестоящем проекте вы создаёте основные ресурсы данных. Этот проект будет содержать источники исходных данных, модели подготовительного слоя (staging) и основную бизнес-логику.
dbt позволяет специалистам по работе с данными разрабатывать в удобном для них инструменте и предоставляет локальный dbt CLI или работающую в браузере среду Studio IDE.
В этом разделе руководства вы настроите проект «Jaffle | Data Analytics» в качестве базового проекта с помощью Studio IDE.
- Сначала перейдите на страницу Studio IDE, чтобы проверить настройки.
- Нажмите Initialize dbt project, если вы начали с пустого репозитория.
- Удалите папку
models/example. - Перейдите к файлу
dbt_project.ymlи измените имя проекта (строка 5) сmy_new_projectнаanalytics. - В файле
dbt_project.ymlудалите строки 39–42 (ссылку на модельmy_new_project). - В разделе File Catalog наведите указатель на каталог проекта и нажмите ..., затем выберите Create file.
- Создайте две новые папки:
models/stagingиmodels/core.
Подготовительный слой (staging)
Теперь, когда базовый проект настроен, приступим к созданию ресурсов данных.
- Создайте новый YAML-файл свойств
models/staging/sources.yml. - Объявите источники, скопировав следующий фрагмент в файл, и нажмите Save.
sources:
  - name: jaffle_shop
    description: This is a replica of the Postgres database used by our app
    database: raw
    schema: jaffle_shop
    tables:
      - name: customers
        description: One record per customer.
      - name: orders
        description: One record per order. Includes cancelled and deleted orders.
- Создайте файл
models/staging/stg_customers.sql, чтобы выбрать данные из таблицыcustomersисточникаjaffle_shop.
select
    id as customer_id,
    first_name,
    last_name

from {{ source('jaffle_shop', 'customers') }}
- Создайте файл
models/staging/stg_orders.sql, чтобы выбрать данные из таблицыordersисточникаjaffle_shop.
select
    id as order_id,
    user_id as customer_id,
    order_date,
    status

from {{ source('jaffle_shop', 'orders') }}
- Создайте файл
models/core/fct_orders.sqlдля построения факт‑таблицы с данными о клиентах и заказах.
with customers as (
    select *
    from {{ ref('stg_customers') }}
),

orders as (
    select *
    from {{ ref('stg_orders') }}
),

customer_orders as (
    select
        customer_id,
        min(order_date) as first_order_date
    from orders
    group by customer_id
),

final as (
    select
        o.order_id,
        o.order_date,
        o.status,
        c.customer_id,
        c.first_name,
        c.last_name,
        co.first_order_date,
        -- Note that we've used a macro for this so that the appropriate DATEDIFF syntax is used for each respective data platform
        {{ datediff('first_order_date', 'order_date', 'day') }} as days_as_customer_at_purchase
    from orders o
    left join customers c using (customer_id)
    left join customer_orders co using (customer_id)
)

select * from final
- Перейдите в Command bar и выполните
dbt build.
Прежде чем downstream‑команда сможет использовать ассеты из этого базового проекта, необходимо:
- Создать и определить как минимум одну модель с доступом “public”
- Успешно выполнить deployment‑задание
- Примечание: (Версии dbt: v2.0 и новее) это задание обновляет ресурсы в Catalog автоматически. После запуска откройте Catalog в главном меню и выберите проект, чтобы проверить граф зависимостей, тесты и документацию.
Определение публичной модели и запуск первого задания
В предыдущем разделе вы подготовили базовые строительные блоки, теперь интегрируем Mesh.
Хотя команде Finance требуется модель fct_orders для анализа платежных трендов, другие модели — особенно staging‑слой, используемый для очистки и объединения данных — downstream‑командам не нужны.
Чтобы сделать fct_orders публично доступной:
- В файле
models/core/core.ymlдобавьте параметрaccess: publicдля нужной модели, вставив и сохранив следующее:
models:
  - name: fct_orders
    config:
      access: public # changed to config in v1.10
    description: "Customer and order details"
    columns:
      - name: order_id
        data_type: number
        description: ""

      - name: order_date
        data_type: date
        description: ""

      - name: status
        data_type: varchar
        description: "Indicates the status of the order"

      - name: customer_id
        data_type: number
        description: ""

      - name: first_name
        data_type: varchar
        description: ""

      - name: last_name
        data_type: varchar
        description: ""

      - name: first_order_date
        data_type: date
        description: ""

      - name: days_as_customer_at_purchase
        data_type: number
        description: "Days between this purchase and customer's first purchase"
Примечание: по умолчанию доступ моделей установлен как “protected”, что означает, что на них можно ссылаться только внутри того же проекта. Подробнее о типах доступа и группах моделей читайте здесь.
- Перейдите на вкладку Lineage в Studio IDE, чтобы увидеть отметку Public под названием модели.
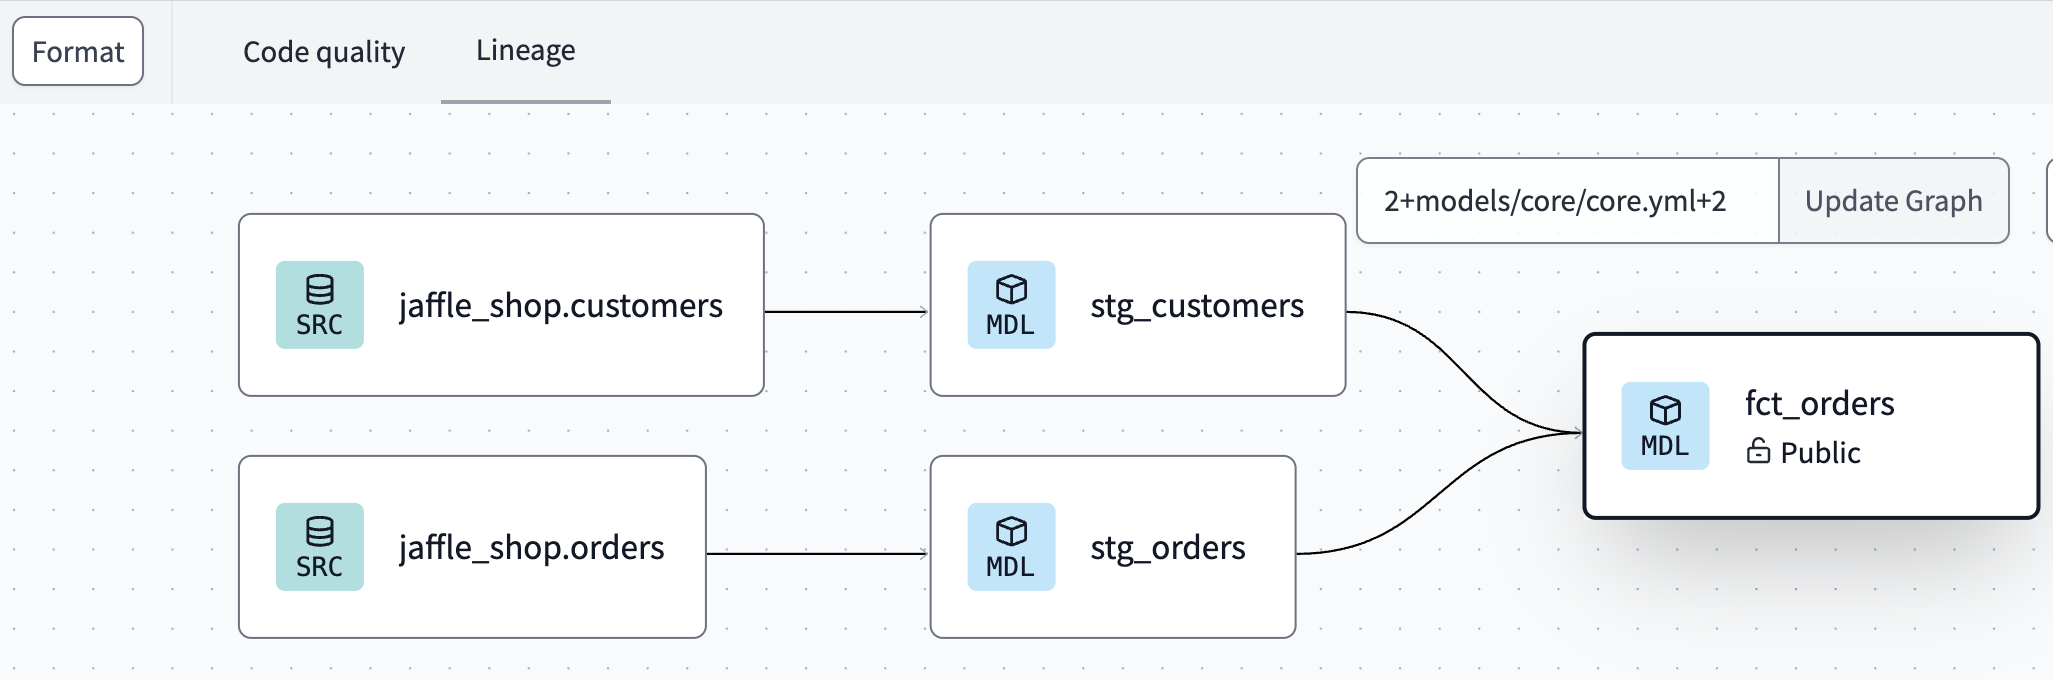 Lineage проекта Jaffle | Data Analytics
- Перейдите в Version control и нажмите Commit and Sync, чтобы закоммитить изменения.
- Слейте изменения в основную или production‑ветку.
Создание и запуск dbt‑задания
Прежде чем downstream‑команда сможет использовать ассеты из этого базового проекта, необходимо создать production‑окружение и успешно выполнить deployment‑задание.
Чтобы впервые запустить задание развертывания dbt, вам нужно создать новое задание dbt.
- Перейдите в Orchestration > Jobs.
- Нажмите Create job, а затем Deploy job.
-
(Версии dbt: v2.0 и новее) Оставьте команду
dbt build, заданную по умолчанию. При каждом запуске задания Catalog автоматически наполняется вашими метаданными.
- Нажмите Save.
- Нажмите Run now, чтобы запустить задание.
- После завершения запуска перейдите в Catalog. Теперь вы должны увидеть, что граф зависимостей, тесты и документация успешно отобразились.
Подробнее о том, как dbt использует метаданные из среды Staging для разрешения ссылок в зависимых проектах, см. в разделе Staging с зависимыми проектами.
Ссылка на публичную модель в downstream‑проекте
В этом разделе вы настроите downstream‑проект “Jaffle | Finance” и выполните межпроектную ссылку на модель fct_orders из базового проекта. Перейдите на страницу Develop, чтобы настроить проект:
- Если вы также начали работу с новым репозиторием git, нажмите Initialize dbt project в разделе Version control.
- Удалите папку
models/example. - Откройте файл
dbt_project.ymlи измените имя проекта (строка 5) сmy_new_projectнаfinance. - Откройте файл
dbt_project.ymlи удалите строки 39–42 (ссылку на модельmy_new_project). - В File Catalog наведите указатель на каталог проекта, нажмите ... и выберите Create file.
- Назовите файл
dependencies.yml. - Добавьте вышестоящий проект
analyticsи пакетdbt_utils. Нажмите Save.
packages:
  - package: dbt-labs/dbt_utils
    version: 1.1.1

projects:
  - name: analytics
Staging‑слой
Теперь, когда базовый проект настроен, начнем создавать дата‑ассеты. Настройте staging‑слой следующим образом:
- Создайте новый файл свойств
models/staging/sources.ymlи объявите источники, скопировав следующий код и нажав Save.
sources:
  - name: stripe
    database: raw
    schema: stripe
    tables:
      - name: payment
- Создайте
models/staging/stg_payments.sql, чтобы выбрать данные из таблицыpaymentисточникаstripe.
with payments as (
    select * from {{ source('stripe', 'payment') }}
),

final as (
    select
        id as payment_id,
        orderID as order_id,
        paymentMethod as payment_method,
        amount,
        created as payment_date
    from payments
)

select * from final
Ссылка на публичную модель
Теперь вы готовы добавить модель, которая анализирует, как типы платежей меняются на протяжении пути клиента. Это помогает определить, уменьшается ли использование купонных подарочных карт при повторных покупках, как ожидает маркетинговая команда, или остается стабильным.
- Чтобы сослаться на модель, используйте следующую логику:
with stg_payments as (
    select * from {{ ref('stg_payments') }}
),

fct_orders as (
    select * from {{ ref('analytics', 'fct_orders') }}
),

final as (
    select
        days_as_customer_at_purchase,
        -- we use the pivot macro in the dbt_utils package to create columns that total payments for each method
        {{ dbt_utils.pivot(
            'payment_method',
            dbt_utils.get_column_values(ref('stg_payments'), 'payment_method'),
            agg='sum',
            then_value='amount',
            prefix='total_',
            suffix='_amount'
        ) }},
        sum(amount) as total_amount
    from fct_orders
    left join stg_payments using (order_id)
    group by 1
)

select * from final
- Обратите внимание, как работает межпроектный
ref! При добавленииrefавтодополнение в распознает публичную модель как доступную.
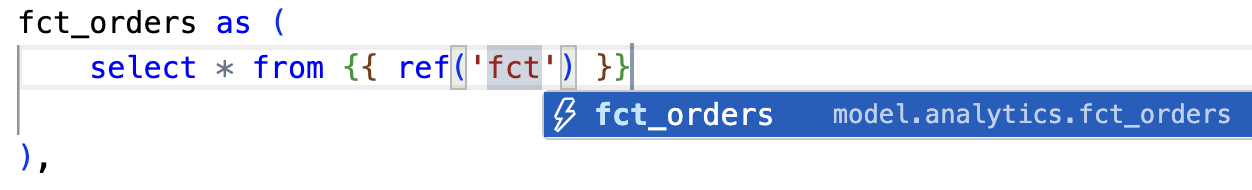 Автодополнение межпроектного ref в Studio IDE
- Это автоматически разрешает (связывает) правильные базу данных, схему и таблицу/представление, заданные в upstream‑проекте.
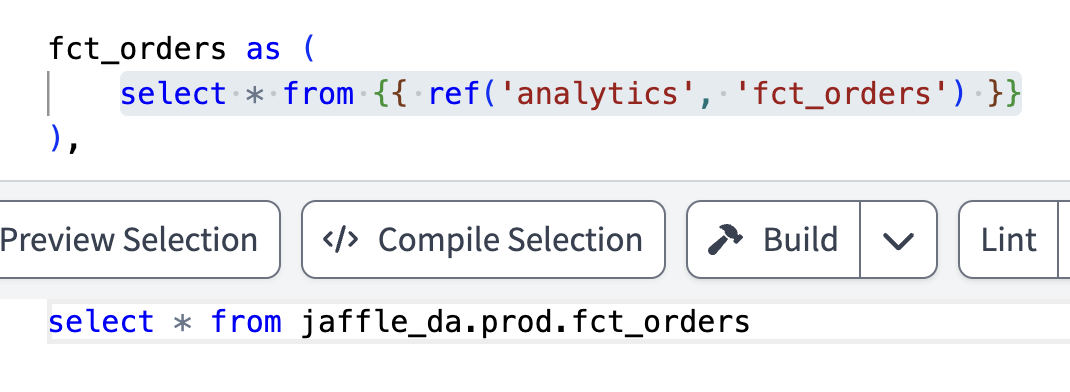 Компиляция межпроектного ref
- Вы также можете увидеть эту связь во вкладке Lineage в реальном времени.
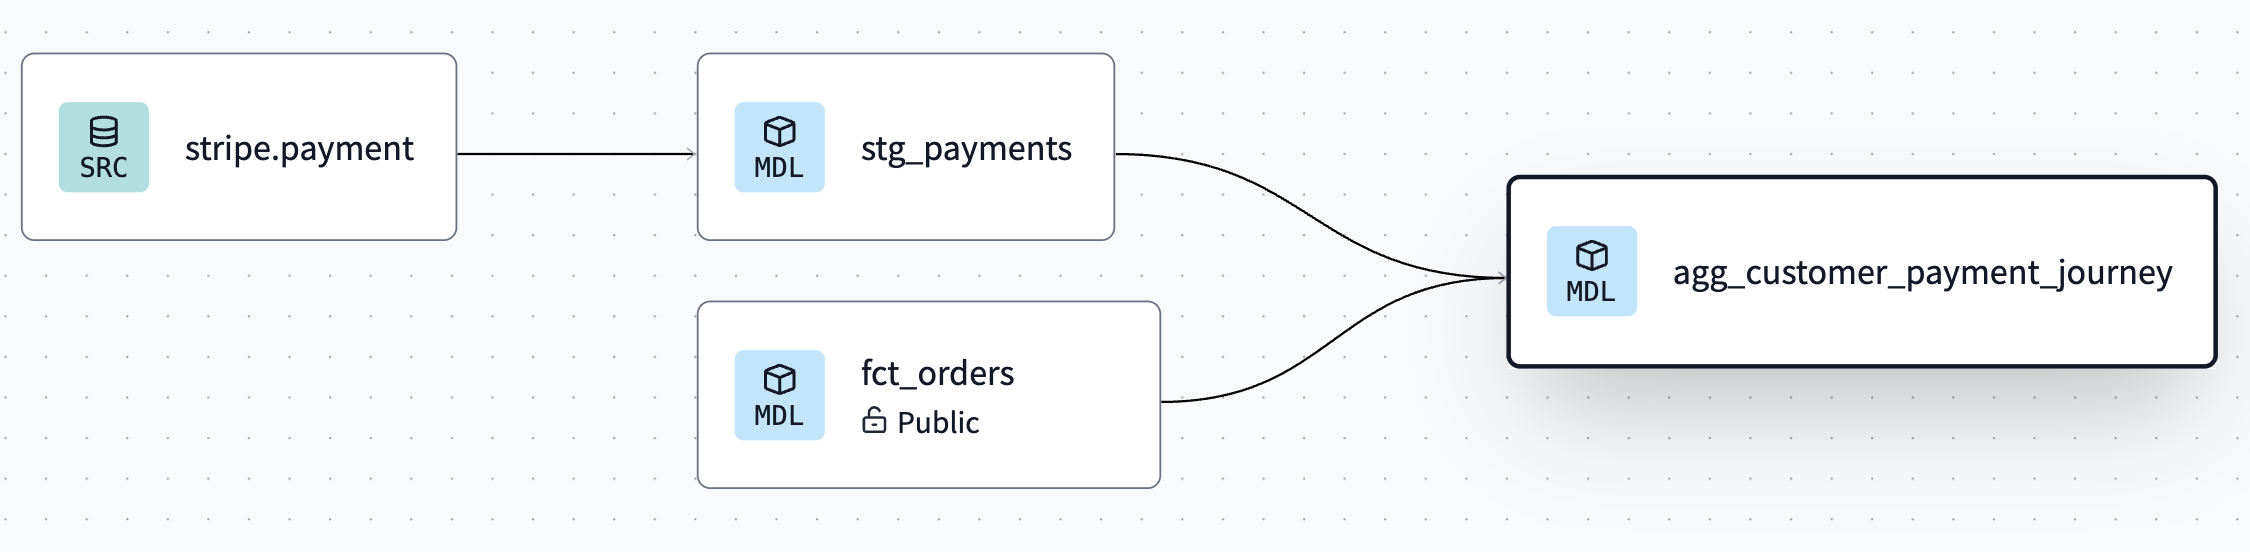 Lineage межпроектного ref
Добавление версий моделей и контрактов
Как повысить устойчивость и добавить защитные механизмы в таких межпроектных связях? Вы можете заимствовать лучшие практики из разработки ПО:
- Определение контрактов моделей — настройте model contracts в dbt, чтобы задать набор гарантий, описывающих структуру модели. При сборке dbt проверяет, что результат соответствует контракту; если нет — сборка завершается ошибкой.
- Определение версий моделей — используйте model versions для управления обновлениями и систематической обработки breaking‑changes.
Настройка контрактов моделей
Как часть команды Data Analytics, вы можете захотеть обеспечить надежность модели fct_orders для downstream‑пользователей, таких как команда Finance.
- Перейдите к
models/core/core.ymlи в описании моделиfct_ordersперед разделомcolumns:добавьте контракт данных:
models:
  - name: fct_orders
    description: “Customer and order details”
    config:
      access: public # changed to config in v1.10
      contract:
        enforced: true
    columns:
      - name: order_id
        .....
- Проверьте, что произойдет при нарушении контракта. В
models/core/fct_orders.sqlзакомментируйте колонкуorders.statusи нажмите Build.- При нарушении контракта сборка завершится ошибкой, что видно в истории командной строки.
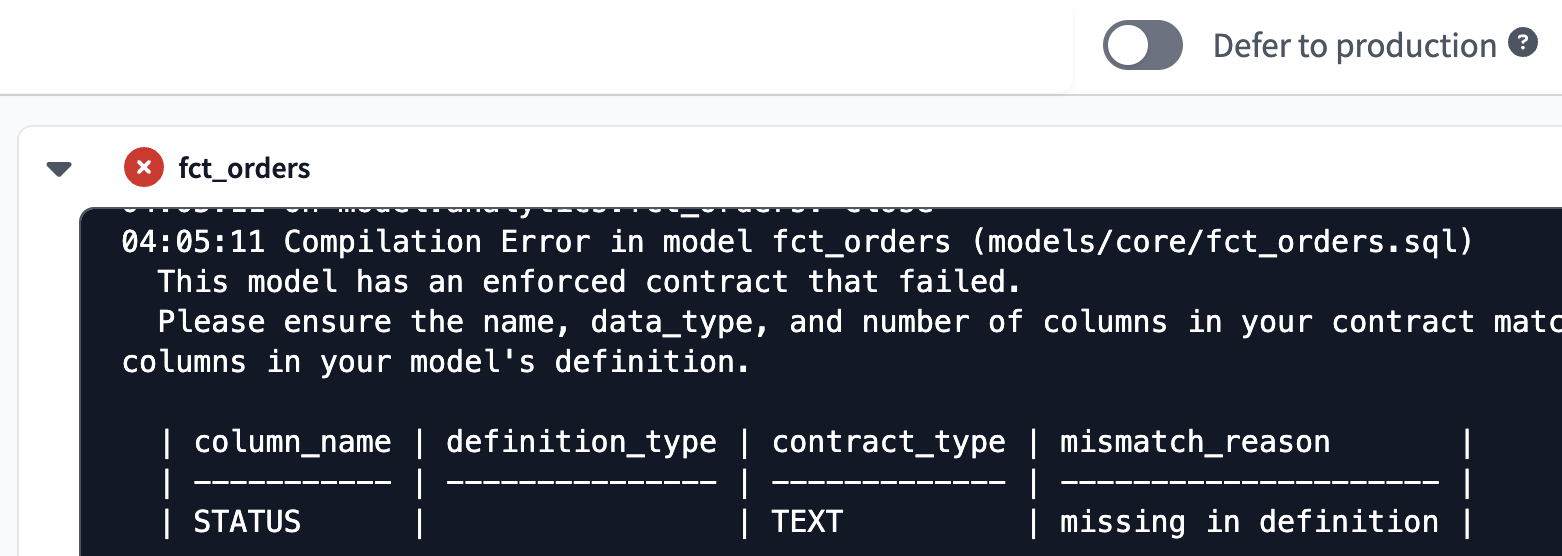 Контракт данных нарушен, сборка dbt завершилась ошибкой.
Настройка версий моделей
В этом разделе вы настроите версии моделей: команда Data Analytics обновляет модель fct_orders, сохраняя обратную совместимость и уведомляя downstream‑команду Finance о миграции.
-
Переименуйте существующий файл модели
models/core/fct_orders.sqlвmodels/core/fct_orders_v1.sql. -
Создайте новый файл
models/core/fct_orders_v2.sqlи измените схему:- Закомментируйте
o.statusв CTEfinal. - Добавьте новое поле
case when o.status = 'returned' then true else false end as is_return, указывающее, был ли заказ возвращен.
- Закомментируйте
-
Затем добавьте в файл
models/core/core.yml:- колонку
is_return - две версии модели
latest_version, чтобы указать актуальную версию (используется по умолчанию)deprecation_dateдля версии 1, чтобы указать дату вывода из эксплуатации.
- колонку
-
В итоге файл должен выглядеть так:
models:
  - name: fct_orders
    description: "Customer and order details"
    latest_version: 2
    config:
      access: public # changed to config in v1.10
      contract:
        enforced: true
    columns:
      - name: order_id
        data_type: number
        description: ""

      - name: order_date
        data_type: date
        description: ""

      - name: status
        data_type: varchar
        description: "Indicates the status of the order"

      - name: is_return
        data_type: boolean
        description: "Indicates if an order was returned"

      - name: customer_id
        data_type: number
        description: ""

      - name: first_name
        data_type: varchar
        description: ""

      - name: last_name
        data_type: varchar
        description: ""

      - name: first_order_date
        data_type: date
        description: ""

      - name: days_as_customer_at_purchase
        data_type: number
        description: "Days between this purchase and customer's first purchase"

    # Declare the versions, and highlight the diffs
    versions:

      - v: 1
        deprecation_date: 2024-06-30 00:00:00.00+00:00
        columns:
          # This means: use the 'columns' list from above, but exclude is_return
          - include: all
            exclude: [is_return]

      - v: 2
        columns:
          # This means: use the 'columns' list from above, but exclude status
          - include: all
            exclude: [status]
- Проверьте, как dbt компилирует
refс учетом обновлений. Откройте новый файл, добавьте следующие запросы и нажмите Compile. Обратите внимание, что каждыйrefкомпилируется в указанную версию (или в последнюю, если версия не указана).
select * from {{ ref('fct_orders', v=1) }}
select * from {{ ref('fct_orders', v=2) }}
select * from {{ ref('fct_orders') }}
Добавление dbt‑задания в downstream‑проект
Перед продолжением убедитесь, что вы закоммитили и смержили изменения в обоих проектах — “Jaffle | Data Analytics” и “Jaffle | Finance”.
Сотрудник финансовой команды хочет настроить запуск задания dbt для анализа процесса оплаты клиентами сразу после того, как команда аналитики данных обновит свои пайплайны.
- В проекте “Jaffle | Finance” перейдите на страницу Jobs через Orchestration > Jobs.
- Нажмите Create job, затем Deploy job.
- Задайте имя задания и прокрутите вниз до раздела Job completion.
- В разделе Triggers настройте Run when another job finishes и выберите upstream‑задание из проекта “Jaffle | Data Analytics”.
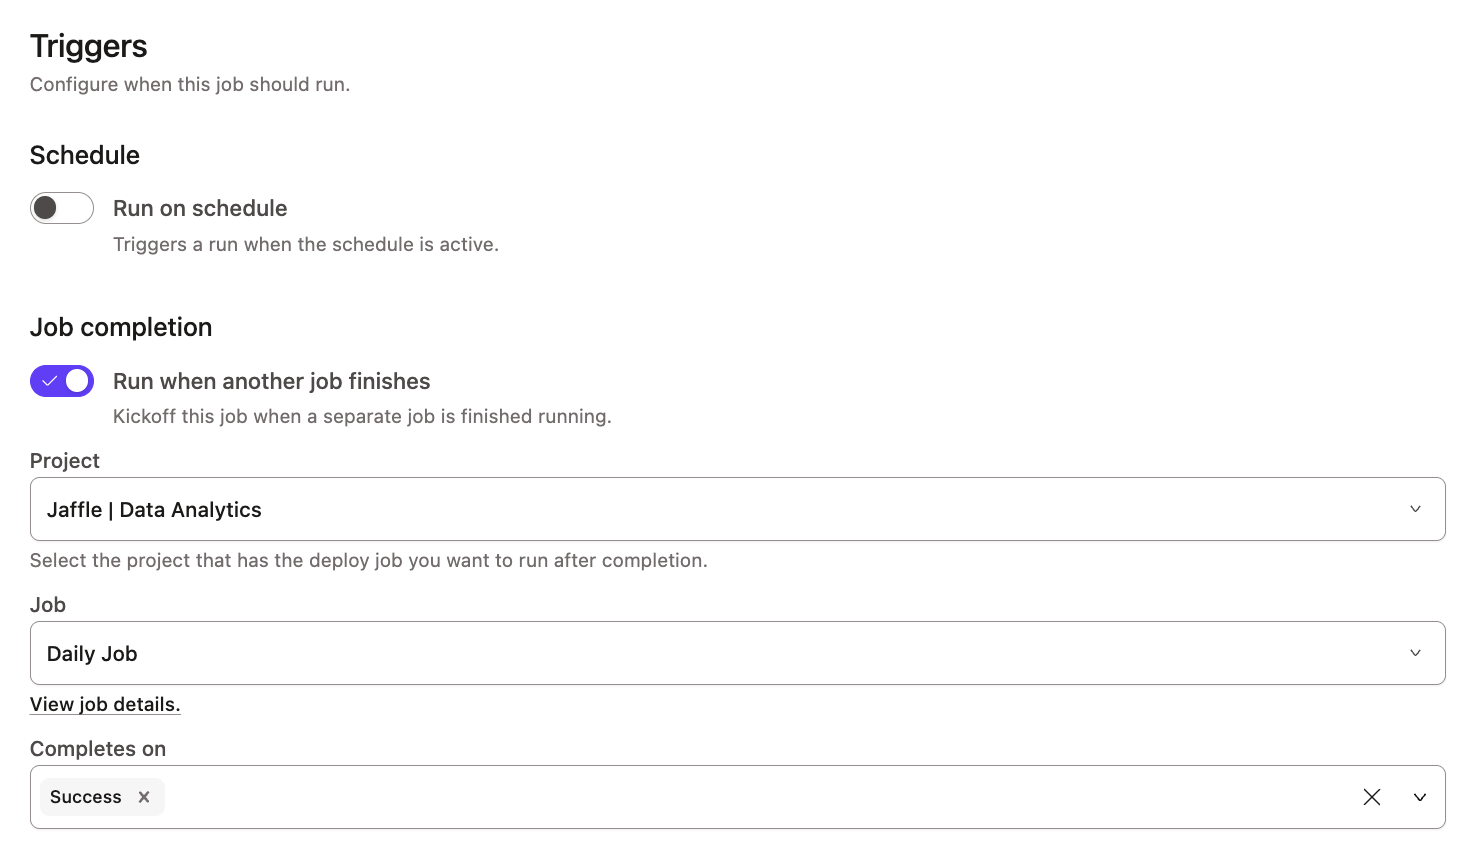 Запуск задания по завершению другого задания
- Нажмите Save и убедитесь, что задание настроено корректно.
- Перейдите на страницу заданий “Jaffle | Data Analytics”. Выберите Daily job и нажмите Run now.
- После успешного завершения вернитесь на страницу заданий “Jaffle | Finance”. Вы увидите, что задание команды Finance было запущено автоматически.
Это упрощает синхронизацию с upstream‑таблицами и устраняет необходимость в более сложной оркестрации, например, координации заданий между проектами через внешний оркестратор.
Просмотр предупреждения о выводе версии из эксплуатации
Чтобы узнать, сколько времени у команды Finance есть на миграцию с fct_orders_v1 на fct_orders_v2, выполните следующие шаги:
- В проекте “Jaffle | Finance” перейдите на страницу Develop.
- Отредактируйте межпроектный
ref, указавv=1вmodels/marts/agg_customer_payment_journey.sql:
with stg_payments as (
    select * from {{ ref('stg_payments') }}
),

fct_orders as (
    select * from {{ ref('analytics', 'fct_orders', v=1) }}
),

final as (
    select
        days_as_customer_at_purchase,
        -- we use the pivot macro in the dbt_utils package to create columns that total payments for each method
        {{ dbt_utils.pivot(
            'payment_method',
            dbt_utils.get_column_values(ref('stg_payments'), 'payment_method'),
            agg='sum',
            then_value='amount',
            prefix='total_',
            suffix='_amount'
        ) }},
        sum(amount) as total_amount
    from fct_orders
    left join stg_payments using (order_id)
    group by 1
)

select * from final
- В Studio IDE перейдите в раздел Version control, чтобы создать коммит и выполнить слияние изменений.
- Перейдите в раздел Deploy, а затем на страницу Jobs.
- Нажмите Run now, чтобы запустить задание Finance. Модель
agg_customer_payment_journeyбудет построена, и появится предупреждение о дате прекращения её поддержки.
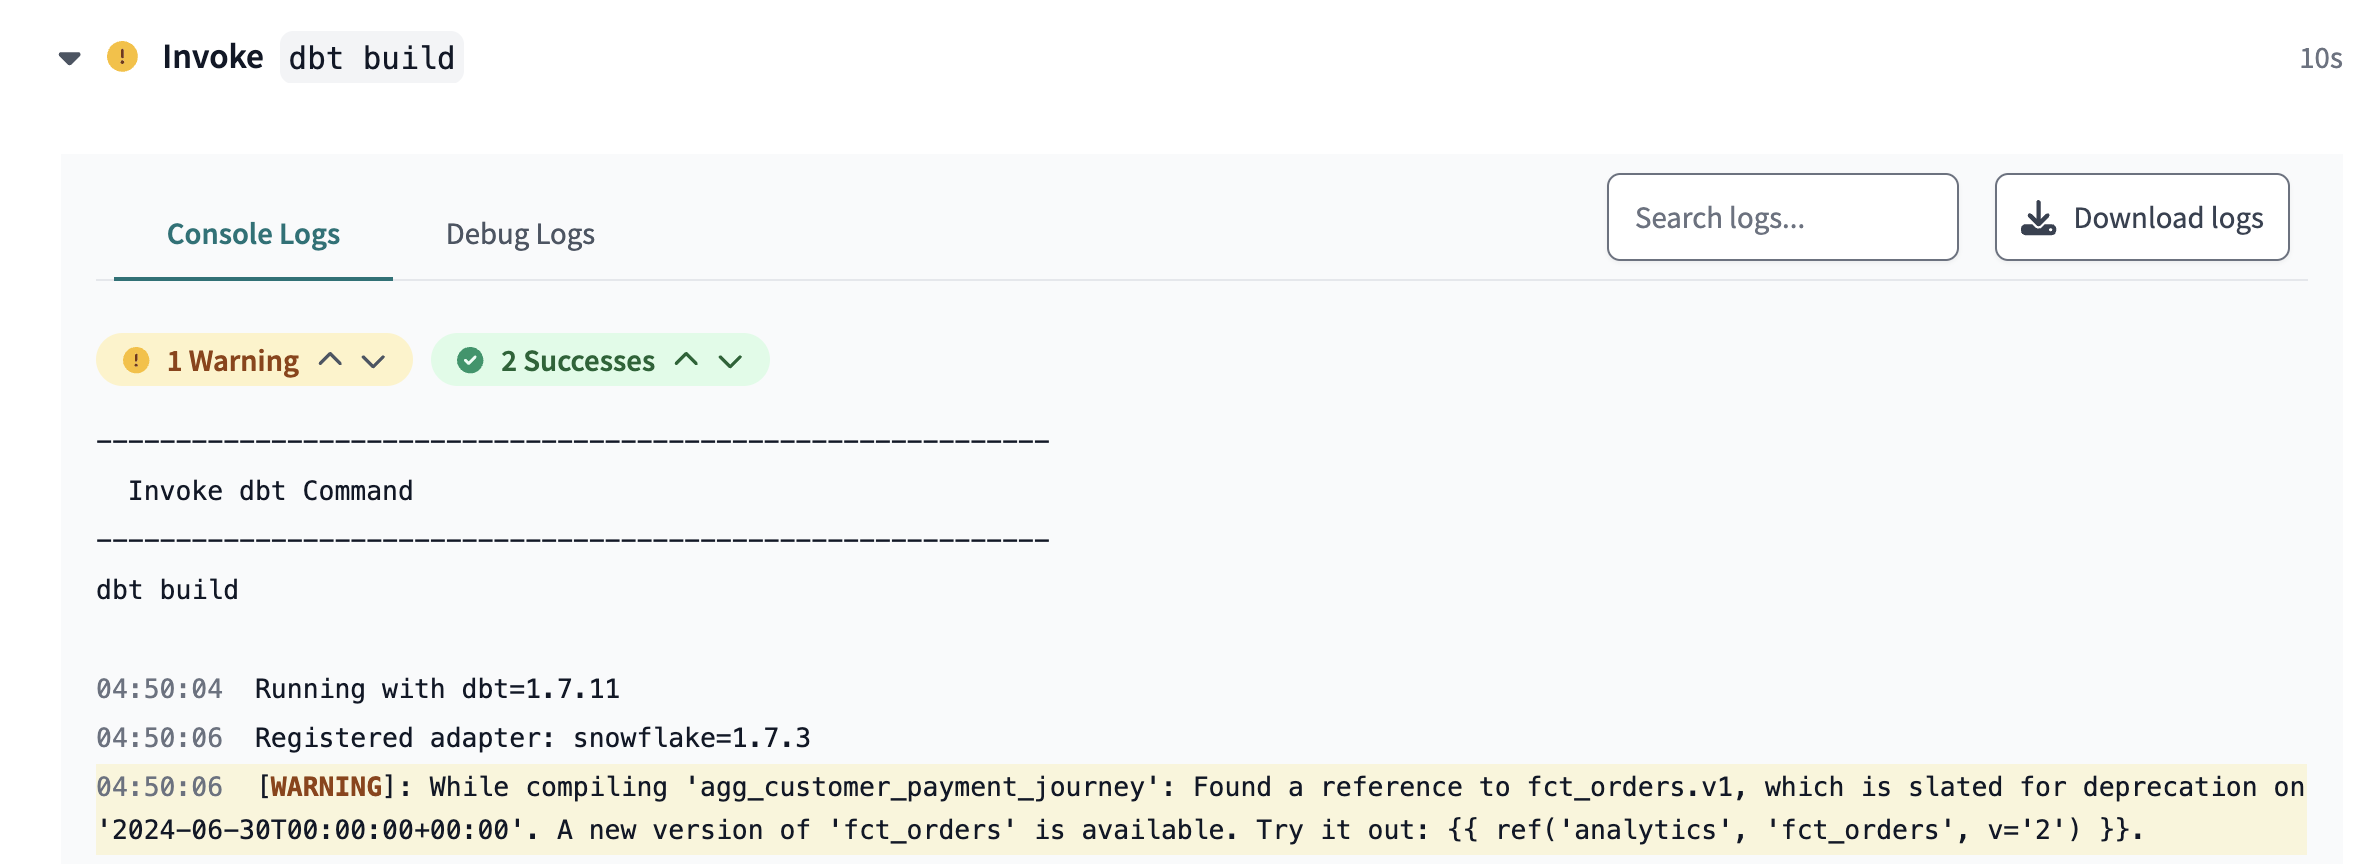 Модель отображает предупреждение о дате вывода версии из эксплуатации.
Просмотр lineage с помощью dbt Catalog
Используйте Catalog, чтобы просматривать граф зависимостей между проектами в dbt. Перейдите на страницу Explore каждого из ваших проектов — теперь вы должны видеть единый граф зависимостей между проектами.
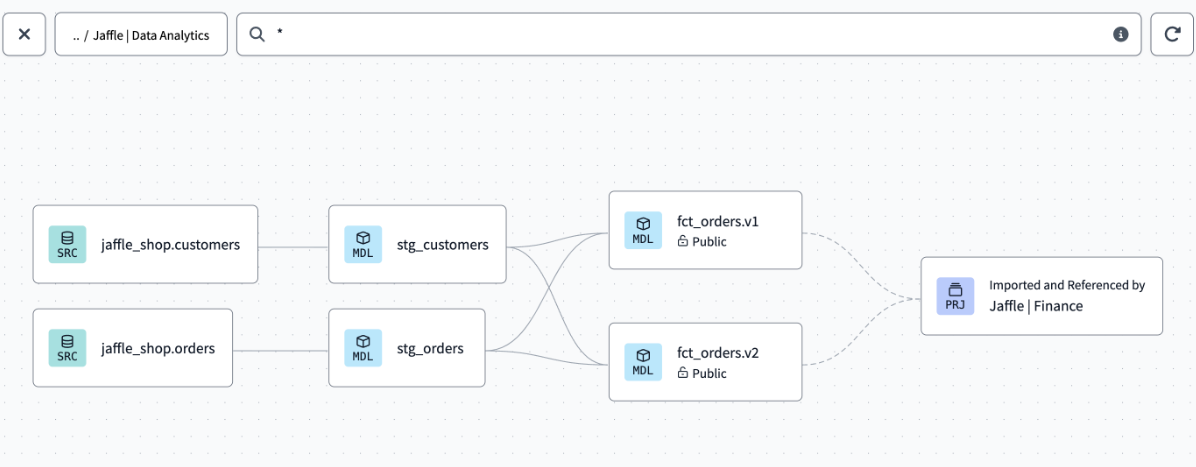 Просмотр lineage проекта 'Jaffle | Data Analytics' в dbt Catalog
Что дальше
Поздравляем 🎉! Вы готовы внедрять преимущества Mesh в вашей организации. Вы узнали:
- Как настроить базовый проект «Jaffle | Data Analytics».
- Создать зависимый проект «Jaffle | Finance».
- Настроить доступ к моделям, их версии и контракты.
- Настроить задания dbt, запускаемые по завершении вышестоящих заданий.
Вот несколько дополнительных ресурсов, которые помогут продолжить путь:
- Как мы создаём проекты dbt mesh
- Часто задаваемые вопросы о Mesh
- Внедрение Mesh с помощью Semantic Layer
- Межпроектные ссылки
- Catalog
- Гибридная разработка с dbt platform и dbt v2 — поддерживайте синхронизацию локальной среды и среды платформы: учётных данных, переменных окружения и версий dbt v2