# Настройка базы данных, схемы и алиаса моделей dbt
[Назад к гайдам](https://docs.getdbt.tech/guides.md)
[Menu ]()
## Введение
Это руководство объясняет, как настраивать соглашения об именовании [схем](https://docs.getdbt.tech/docs/build/custom-schemas.md), [баз данных](https://docs.getdbt.tech/docs/build/custom-databases.md) и [алиасов](https://docs.getdbt.tech/docs/build/custom-aliases.md) в dbt, чтобы они соответствовали требованиям управления и дизайна вашего хранилища данных.
Когда мы разрабатываем модели dbt и выполняем определённые [команды](https://docs.getdbt.tech/reference/dbt-commands.md) (например, `dbt run` или `dbt build`), объекты (такие как таблицы и представления) создаются в хранилище данных в соответствии с этими соглашениями об именовании.
Немного о терминологии
Разные хранилища данных используют разные названия для *логических баз данных*. Информация в этом документе относится к «databases» в Snowflake, Redshift и Postgres; «projects» в BigQuery; и «catalogs» в Databricks Unity Catalog.
Ниже описано поведение dbt «из коробки» по умолчанию:
* База данных, в которой создаётся объект, определяется базой данных, настроенной на [уровне окружения в dbt](https://docs.getdbt.tech/docs/dbt-platform-environments.md) или в [файле `profiles.yml`](https://docs.getdbt.tech/docs/local/profiles.yml.md) в dbt v1.
* Схема зависит от того, определили ли вы [пользовательскую схему](https://docs.getdbt.tech/docs/build/custom-schemas.md) для модели:
* Если вы не определили пользовательскую схему, dbt создаёт объект в схеме по умолчанию. В dbt это обычно `dbt_username` для разработки и схема по умолчанию для окружений развёртывания. В dbt v1 используется схема, указанная в файле `profiles.yml`.
* Если вы определили пользовательскую схему, dbt объединяет упомянутую выше схему с пользовательской.
* Например, если настроенная схема — `dbt_myschema`, а пользовательская — `marketing`, объекты будут созданы в схеме `dbt_myschema_marketing`.
* Обратите внимание: для автоматизированных заданий CI имя схемы формируется на основе номера задания и номера PR: `dbt_cloud_pr__`.
* Имя объекта зависит от того, задан ли для модели [псевдоним](https://docs.getdbt.tech/reference/resource-configs/alias.md).
* Без псевдонима dbt использует имя модели без расширения `.sql` или `.py`. Например, `fct_orders_complete.sql` в пользовательской схеме `marketing` создаст объект `prod.marketing.fct_orders_complete`, если целевая база данных — `prod`.
* При наличии псевдонима dbt использует его как имя объекта. Например, при `alias: fct_orders` та же модель создаст объект `prod.marketing.fct_orders`.
Эти правила по умолчанию являются отличной отправной точкой, и многие организации выбирают использовать их без какой-либо дополнительной кастомизации.
Значения по умолчанию позволяют разработчикам работать в изолированных схемах (sandbox) и не перезаписывать работу друг друга — даже если они работают с одними и теми же таблицами.
## Как настроить это поведение
Хотя поведение по умолчанию подходит большинству организаций, бывают случаи, когда такой подход не работает.
Например, dbt предполагает, что у него есть права на создание схем по мере необходимости (и мы рекомендуем, чтобы пользователи, запускающие dbt, имели такие права), но в вашей компании это может быть запрещено.
Или, в зависимости от архитектуры вашего хранилища, вы можете захотеть минимизировать количество схем в dev-окружении (и избежать разрастания схем за счёт отказа от создания комбинаций всех пользовательских схем и кастомных схем).
В качестве альтернативы, вы можете захотеть, чтобы dev-схемы назывались по имени feature-ветки, а не по имени разработчика.
По этой причине dbt предоставляет три макроса для настройки того, где именно объекты создаются в хранилище данных:
* [`generate_database_name()`](https://docs.getdbt.tech/docs/build/custom-databases.md#generatedatabasename)
* [`generate_schema_name()`](https://docs.getdbt.tech/docs/build/custom-schemas.md#how-does-dbt-generate-a-models-schema-name)
* [`generate_alias_name()`](https://docs.getdbt.tech/docs/build/custom-aliases.md#generate_alias_name)
Переопределяя один или несколько из этих макросов, мы можем настроить размещение объектов dbt в хранилище данных и привести его в соответствие с любыми существующими требованиями.
Ключевая концепция
Модели, запускаемые из разных контекстов, должны приводить к созданию уникальных объектов в хранилище данных.
Например, разработчик Suzie работает над улучшениями `fct_player_stats`, а Darren разрабатывает тот же самый объект.
Чтобы предотвратить перезапись работы друг друга, и Suzie, и Darren должны иметь собственные уникальные версии `fct_player_stats` в dev-окружении.
Кроме того, staging-версия `fct_player_stats` должна существовать в уникальном месте, отличном от dev-версий и production-версии.
При кастомизации этих макросов мы часто используем следующее:
* В dbt мы рекомендуем использовать [переменные окружения](https://docs.getdbt.tech/docs/build/environment-variables.md), чтобы указать, в каком окружении выполняется вызов dbt (dev/stg/prod).
* Их можно задать на уровне окружения, и все задания автоматически унаследуют значения по умолчанию. Мы добавим логику Jinja (`if/else/endif`), чтобы определить, выполняется ли запуск в dev, prod, CI или другом окружении.
* В качестве альтернативы переменным окружения можно использовать `target.name`. Дополнительные сведения см. в разделе [О переменных target](https://docs.getdbt.tech/reference/dbt-jinja-functions/target.md).
[](#)Имя целевого окружения в переменных окружения для пользовательской схемы.
Чтобы имя базы данных/схемы/объекта зависело от текущей ветки, можно использовать встроенную переменную окружения `DBT_CLOUD_GIT_BRANCH` из числа [специальных переменных окружения](https://docs.getdbt.tech/docs/build/environment-variables.md#special-environment-variables) dbt.
## Примеры использования
Ниже приведены типичные примеры, с которыми мы сталкивались у пользователей dbt, применяющих эти 3 макроса с различной логикой.
примечание
Обратите внимание, что следующие примеры не являются исчерпывающими и не покрывают все возможные варианты. Они предназначены как шаблоны для разработки собственных правил.
* [Использование кастомной схемы без конкатенации target-схемы в production](https://docs.getdbt.tech/guides/customize-schema-alias.md?step=3#1-custom-schemas-without-target-schema-concatenation-in-production)
* [Добавление идентификаторов разработчиков к таблицам](https://docs.getdbt.tech/guides/customize-schema-alias.md?step=3#2-static-schemas-add-developer-identities-to-tables)
* [Использование имени ветки в качестве префикса схемы](https://docs.getdbt.tech/guides/customize-schema-alias.md?step=3#3-use-branch-name-as-schema-prefix)
* [Использование статической схемы для CI](https://docs.getdbt.tech/guides/customize-schema-alias.md?step=3#4-use-a-static-schema-for-ci)
### 1. Кастомные схемы без конкатенации target-схемы в production
Наиболее распространённый сценарий — использование кастомной схемы без конкатенации с именем схемы по умолчанию в production.
Для этого можно создать новый файл `generate_schema_name.sql` в папке macros со следующим кодом:
macros/generate\_schema\_name.sql
```jinja
{% macro generate_schema_name(custom_schema_name, node) -%}
{%- set default_schema = target.schema -%}
{%- if custom_schema_name is none -%}
{{ default_schema }}
{%- elif env_var('DBT_ENV_TYPE','DEV') == 'PROD' -%}
{{ custom_schema_name | trim }}
{%- else -%}
{{ default_schema }}_{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}
```
Данный подход сгенерирует следующие результаты для модели `my_model` с кастомной схемой `marketing`, предотвращая пересечения объектов между запусками dbt из разных контекстов.
| Context | Target database | Target schema | Resulting object |
| ----------- | --------------- | ------------- | ------------------------------------ |
| Developer 1 | dev | dbt\_dev1 | dev.dbt\_dev1\_marketing.my\_model |
| Developer 2 | dev | dbt\_dev2 | dev.dbt\_dev2\_marketing.my\_model |
| CI PR 123 | ci | dbt\_pr\_123 | ci.dbt\_pr\_123\_marketing.my\_model |
| CI PR 234 | ci | dbt\_pr\_234 | ci.dbt\_pr\_234\_marketing.my\_model |
| Production | prod | analytics | prod.marketing.my\_model |
примечание
Мы добавили логику проверки, выполняется ли текущий запуск dbt в production. Это важно, и мы объясняем почему в разделе [What not to do](https://docs.getdbt.tech/guides/customize-schema-alias.md?step=3#what-not-to-do).
### 2. Статические схемы: добавление идентификаторов разработчиков к таблицам
Иногда мы сталкиваемся с ситуациями, когда политика безопасности организации запрещает разработчикам создавать схемы, и все разработчики вынуждены работать в одной общей схеме.
В этом случае можно:
* Создать новый файл `generate_schema_name.sql` в папке macros со следующим кодом.
* Изменить `generate_schema_name()` так, чтобы использовалась одна схема для всех разработчиков, даже если задана кастомная схема.
* Обновить `generate_alias_name()`, чтобы в dev-окружении добавлять алиас разработчика и кастомную схему в начало имени таблицы.
* Этот метод не идеален, так как приводит к длинным именам таблиц, но позволяет разработчикам видеть, в какой схеме модель будет создана в production.
macros/generate\_schema\_name.sql
```jinja
{% macro generate_schema_name(custom_schema_name, node) -%}
{%- set default_schema = target.schema -%}
{%- if custom_schema_name is none -%}
{{ default_schema }}
{%- elif env_var('DBT_ENV_TYPE','DEV') != 'CI' -%}
{{ custom_schema_name | trim }}
{%- else -%}
{{ default_schema }}_{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}
```
macros/generate\_alias\_name.sql
```jinja
{% macro generate_alias_name(custom_alias_name=none, node=none) -%}
{%- if env_var('DBT_ENV_TYPE','DEV') == 'DEV' -%}
{%- if custom_alias_name -%}
{{ target.schema }}__{{ custom_alias_name | trim }}
{%- elif node.version -%}
{{ target.schema }}__{{ node.name ~ "_v" ~ (node.version | replace(".", "_")) }}
{%- else -%}
{{ target.schema }}__{{ node.name }}
{%- endif -%}
{%- else -%}
{%- if custom_alias_name -%}
{{ custom_alias_name | trim }}
{%- elif node.version -%}
{{ return(node.name ~ "_v" ~ (node.version | replace(".", "_"))) }}
{%- else -%}
{{ node.name }}
{%- endif -%}
{%- endif -%}
{%- endmacro %}
```
Данный подход сгенерирует следующие результаты для модели `my_model` с кастомной схемой `marketing`, предотвращая пересечения объектов между запусками dbt из разных контекстов.
| Context | Target database | Target schema | Resulting object |
| ----------- | --------------- | ------------- | ------------------------------------ |
| Developer 1 | dev | dbt\_dev1 | dev.marketing.dbt\_dev1\_my\_model |
| Developer 2 | dev | dbt\_dev2 | dev.marketing.dbt\_dev2\_my\_model |
| CI PR 123 | ci | dbt\_pr\_123 | ci.dbt\_pr\_123\_marketing.my\_model |
| CI PR 234 | ci | dbt\_pr\_234 | ci.dbt\_pr\_234\_marketing.my\_model |
| Production | prod | analytics | prod.marketing.my\_model |
### 3. Использование имени ветки в качестве префикса схемы
Для команд, которые предпочитают изолировать работу по feature-веткам, можно воспользоваться специальной переменной окружения `DBT_CLOUD_GIT_BRANCH`. Обратите внимание, что разработчики будут писать в одну и ту же схему, если они находятся в одной и той же feature-ветке.
примечание
Переменная `DBT_CLOUD_GIT_BRANCH` доступна только в Studio IDE и недоступна в dbt platform CLI.
Мы также встречали организации, которые предпочитают организовывать dev-базы данных по имени ветки. Для этого требуется реализовать аналогичную логику в `generate_database_name()`, а не в макросе `generate_schema_name()`. По умолчанию dbt не создаёт базы данных автоматически.
Подробнее см. в разделе [Tips and tricks](https://docs.getdbt.tech/guides/customize-schema-alias.md?step=5).
macros/generate\_schema\_name.sql
```jinja
{% macro generate_schema_name(custom_schema_name, node) -%}
{%- set default_schema = target.schema -%}
{%- if env_var('DBT_ENV_TYPE','DEV') == 'DEV' -%}
{#- we replace characters not allowed in the schema names by "_" -#}
{%- set re = modules.re -%}
{%- set cleaned_branch = re.sub("\W", "_", env_var('DBT_CLOUD_GIT_BRANCH')) -%}
{%- if custom_schema_name is none -%}
{{ cleaned_branch }}
{%- else -%}
{{ cleaned_branch }}_{{ custom_schema_name | trim }}
{%- endif -%}
{%- else -%}
{{ default_schema }}_{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}
```
Данный подход сгенерирует следующие результаты для модели `my_model` с кастомной схемой `marketing`, предотвращая пересечения объектов между запусками dbt из разных контекстов.
| Context | Branch | Target database | Target schema | Resulting object |
| ----------- | ------------ | --------------- | ------------- | ------------------------------------ |
| Developer 1 | `featureABC` | dev | dbt\_dev1 | dev.featureABC\_marketing.my\_model |
| Developer 2 | `featureABC` | dev | dbt\_dev2 | dev.featureABC\_marketing.my\_model |
| Developer 1 | `feature123` | dev | dbt\_dev1 | dev.feature123\_marketing.my\_model |
| CI PR 123 | | ci | dbt\_pr\_123 | ci.dbt\_pr\_123\_marketing.my\_model |
| CI PR 234 | | ci | dbt\_pr\_234 | ci.dbt\_pr\_234\_marketing.my\_model |
| Production | | prod | analytics | prod.marketing.my\_model |
Когда developer 1 и developer 2 находятся на одной и той же ветке, они будут генерировать один и тот же объект в хранилище данных. Это не является проблемой, так как нахождение на одной ветке означает, что код модели будет одинаковым для обоих разработчиков.
### 4. Использование статической схемы для CI
Некоторые организации предпочитают писать результаты CI-задач в одну статическую схему, добавляя идентификатор PR в начало имени таблицы. Важно отметить, что это приводит к длинным именам таблиц.
Для этого можно создать новый файл `generate_schema_name.sql` в папке macros со следующим кодом:
macros/generate\_schema\_name.sql
```jinja
{% macro generate_schema_name(custom_schema_name=none, node=none) -%}
{%- set default_schema = target.schema -%}
{# If the CI Job does not exist in its own environment, use the target.name variable inside the job instead #}
{# {%- if target.name == 'CI' -%} #}
{%- if env_var('DBT_ENV_TYPE','DEV') == 'CI' -%}
ci_schema
{%- elif custom_schema_name is none -%}
{{ default_schema }}
{%- else -%}
{{ default_schema }}_{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}
```
macros/generate\_alias\_name.sql
```jinja
{% macro generate_alias_name(custom_alias_name=none, node=none) -%}
{# If the CI Job does not exist in its own environment, use the target.name variable inside the job instead #}
{# {%- if target.name == 'CI' -%} #}
{%- if env_var('DBT_ENV_TYPE','DEV') == 'CI' -%}
{%- if custom_alias_name -%}
{{ target.schema }}__{{ node.config.schema }}__{{ custom_alias_name | trim }}
{%- elif node.version -%}
{{ target.schema }}__{{ node.config.schema }}__{{ node.name ~ "_v" ~ (node.version | replace(".", "_")) }}
{%- else -%}
{{ target.schema }}__{{ node.config.schema }}__{{ node.name }}
{%- endif -%}
{%- else -%}
{%- if custom_alias_name -%}
{{ custom_alias_name | trim }}
{%- elif node.version -%}
{{ return(node.name ~ "_v" ~ (node.version | replace(".", "_"))) }}
{%- else -%}
{{ node.name }}
{%- endif -%}
{%- endif -%}
{%- endmacro %}
```
Данный подход сгенерирует следующие результаты для модели `my_model` с кастомной схемой `marketing`, предотвращая пересечения объектов между запусками dbt из разных контекстов.
| Context | Target database | Target schema | Resulting object |
| ----------- | --------------- | ------------- | ------------------------------------------------ |
| Developer 1 | dev | dbt\_dev1 | dev.dbt\_dev1\_marketing.my\_model |
| Developer 2 | dev | dbt\_dev2 | dev.dbt\_dev2\_marketing.my\_model |
| CI PR 123 | ci | dbt\_pr\_123 | ci.ci\_schema.dbt\_pr\_123\_marketing\_my\_model |
| CI PR 234 | ci | dbt\_pr\_234 | ci.ci\_schema.dbt\_pr\_234\_marketing\_my\_model |
| Production | prod | analytics | prod.marketing.my\_model |
## Чего делать не стоит
В этом разделе описано, каких действий следует избегать при настройке схем и алиасов из‑за возможных проблем.
### Обновление generate\_schema\_name() так, чтобы всегда использовать кастомную схему
Некоторые предпочитают использовать только кастомную схему, если она задана, вместо конкатенации схемы по умолчанию с кастомной, как это происходит в поведении «из коробки».
### Проблема
При изменении стандартного макроса `generate_schema_name()` это может привести к созданию следующей версии:
macros/generate\_schema\_name.sql
```jinja
{% macro generate_schema_name(custom_schema_name, node) -%}
{%- set default_schema = target.schema -%}
{%- if custom_schema_name is none -%}
{{ default_schema }}
{%- else -%}
# The following is incorrect as it omits {{ default_schema }} before {{ custom_schema_name | trim }}.
{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}
```
Хотя это может давать ожидаемый результат в production, где используется выделенная база данных, такое решение приведёт к конфликтам везде, где несколько людей используют одну и ту же базу данных.
Рассмотрим пример модели `my_model` с кастомной схемой `marketing`.
| Context | Target database | Target schema | Resulting object |
| ----------- | --------------- | ------------- | ------------------------ |
| Production | prod | analytics | prod.marketing.my\_model |
| Developer 1 | dev | dbt\_dev1 | dev.marketing.my\_model |
| Developer 2 | dev | dbt\_dev2 | dev.marketing.my\_model |
| CI PR 123 | ci | dbt\_pr\_123 | ci.marketing.my\_model |
| CI PR 234 | ci | dbt\_pr\_234 | ci.marketing.my\_model |
Мы видим, что и developer 1, и developer 2 получают один и тот же объект `my_model`. Это означает, что при одновременной работе над моделью невозможно понять, чья версия сейчас находится в хранилище данных.
Аналогично, разные PR будут приводить к созданию одного и того же объекта в хранилище данных. Если несколько PR открыты одновременно и изменяют одни и те же модели, с высокой вероятностью возникнут проблемы, замедляющие разработку и продвижение кода.
### Решение
Как описано в предыдущем примере, необходимо обновить макрос так, чтобы он проверял, выполняется ли dbt в production. Только в production следует убирать конкатенацию и использовать одну лишь кастомную схему.
## Советы и рекомендации
В этом разделе приведены полезные советы по корректной настройке макросов `generate_database_name()` и `generate_alias_name()`.
### Создание несуществующих баз данных из dbt
dbt автоматически пытается создать схему, если она не существует и если в неё нужно создать объект, но он не пытается автоматически создавать базу данных, если она не существует.
Поэтому, если ваша конфигурация `generate_database_name()` указывает на разные базы данных, которые могут отсутствовать, dbt завершится ошибкой при выполнении простого `dbt build`.
Тем не менее, это можно реализовать, создав макросы, которые будут проверять существование базы данных и создавать её при необходимости. Такие макросы можно вызывать либо в шаге [`dbt run-operation ...`](https://docs.getdbt.tech/reference/commands/run-operation.md) в джобах, либо как [`on-run-start` hook](https://docs.getdbt.tech/reference/project-configs/on-run-start-on-run-end.md).
### Определение контекста через переменные окружения, а не через `target.name`
Мы предпочитаем использовать [переменные окружения](https://docs.getdbt.tech/docs/build/environment-variables.md) вместо `target.name` для определения контекста вызова dbt. Подробнее см. в разделе [О переменных target](https://docs.getdbt.tech/reference/dbt-jinja-functions/target.md).
* `target.name` нельзя задать на уровне окружения. Поэтому в каждом задании внутри окружения необходимо явно переопределять значение `target.name`. Если в задании не задано подходящее значение `target.name`, база данных, схема или псевдоним могут определяться некорректно. В отличие от этого, значения переменных окружения наследуются заданиями из соответствующего окружения. При необходимости значения переменных окружения также можно переопределить в заданиях.
[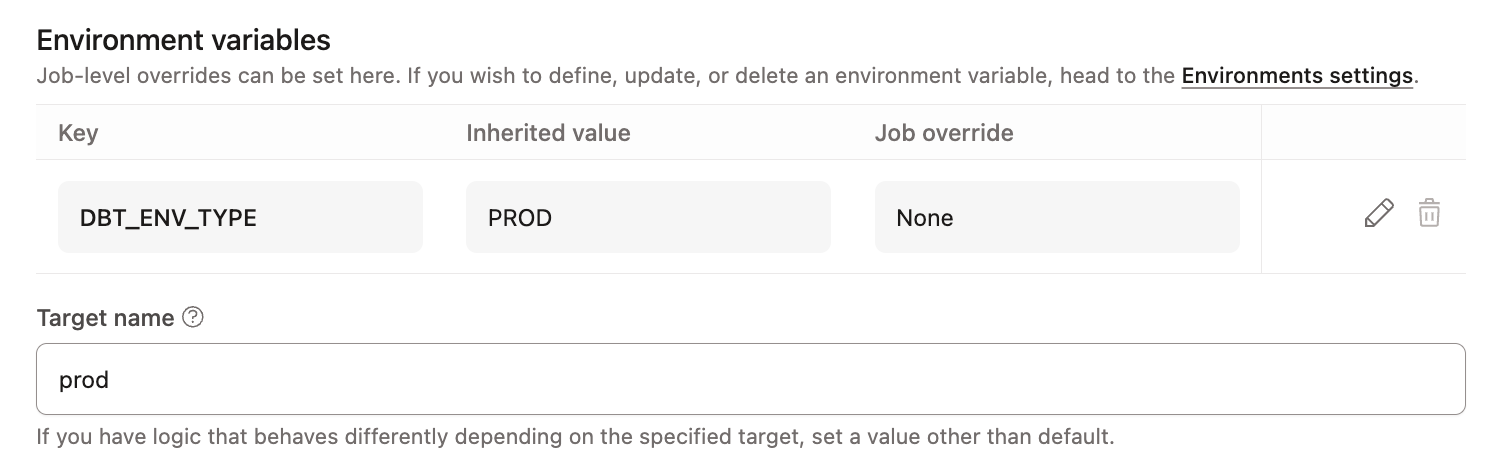](#)Настройка псевдонима схемы с помощью переменной окружения.
* При использовании `target.name` каждый разработчик должен указать одно и то же значение (обычно ‘dev’) в поле имени target в своих пользовательских учётных данных для проекта. Если у разработчика не задано подходящее имя target, его база данных, схема или псевдоним могут определяться некорректно.
[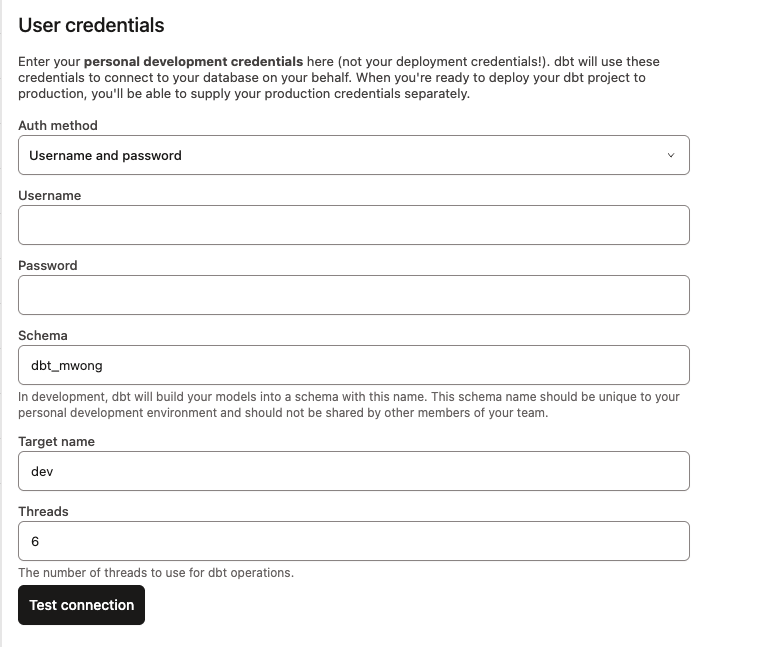](#)Учётные данные пользователя.
### Всегда требуйте указания пользовательских схем
Некоторые пользователи предпочитают принудительно задавать кастомные схемы для всех объектов в проекте. Это позволяет избежать записи в нежелательные «дефолтные» локации. Вы можете добавить соответствующую логику в макрос `generate_schema_name()`, чтобы [вызывать ошибку компиляции](https://docs.getdbt.tech/reference/dbt-jinja-functions/exceptions.md), если кастомная схема для объекта не определена.
macros/generate\_schema\_name.sql
```jinja
{% macro generate_schema_name(custom_schema_name, node) -%}
{%- set default_schema = target.schema -%}
{%- set node_custom_schema = node.config.get('schema') -%}
{%- if custom_schema_name is none and node_custom_schema is none and node.resource_type == 'model' -%}
{{ exceptions.raise_compiler_error("Error: No Custom Schema Defined for the model " ~ node.name ) }}
{%- elif custom_schema_name is none -%}
{{ default_schema }}
{%- elif env_var('DBT_ENV_TYPE','DEV') == 'PROD' -%}
{{ custom_schema_name | trim }}
{%- else -%}
{{ default_schema }}_{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}
```