Подключение к BigQuery Совместимо с dbt v2
Чтобы узнать, какие функции BigQuery поддерживаются в dbt v2 в режиме strict, см. Поддержка функций BigQuery.
Необходимые разрешения
Учетным записям пользователей dbt требуются следующие разрешения для чтения данных, а также для создания таблиц и views в проекте BigQuery:
- Редактор данных BigQuery
- Пользователь BigQuery
При сканировании наборов данных dbt получает список подпрограмм BigQuery (функций и хранимых процедур) и сведения о них. Если вы используете пользовательскую роль IAM вместо предопределённой, также предоставьте следующие разрешения:
bigquery.routines.list: получение списка подпрограмм в наборе данныхbigquery.routines.get: чтение метаданных подпрограмм
Без этих разрешений dbt может не обнаружить существующие таблицы, а некоторые операции поиска могут завершиться ошибкой. Предопределённые роли, такие как BigQuery Data Editor, обычно уже включают эти разрешения.
Для работы с BigQuery при использовании dbt v2 пользователям также нужна роль:
- BigQuery Read Session User (для доступа к Storage Read API)
Чтобы использовать функцию «История запросов», добавьте роль:
- BigQuery Resource Viewer
Для работы с BigQuery DataFrames пользователям нужны следующие дополнительные роли:
- BigQuery Job User
- BigQuery Read Session User
- Notebook Runtime User
- Code Creator
- colabEnterpriseUser
Права доступа к хранилищу данных для dbt v2
Удостоверение Google Cloud (сервисный аккаунт или пользователь), которое использует dbt v2, должно иметь разрешения IAM для запуска заданий, чтения и записи данных таблиц, а также чтения метаданных, которые dbt v2 использует для интроспекции и проверки актуальности источников.
Необходимые объекты Google Cloud
Перед подключением следующие объекты должны существовать или быть доступны:
| Объект | Термин BigQuery | Назначение |
|---|---|---|
| Проект | Проект GCP | Идентификатор вашего проекта Google Cloud |
| Набор данных | Набор данных | Целевой набор данных (эквивалент схемы) |
| Сервисный аккаунт или пользователь | Удостоверение IAM | Удостоверение для аутентификации |
| Местоположение или регион | Местоположение | Местоположение данных (например, US, EU, us-east1) |
Разрешения IAM
Для основных функций dbt необходимы следующие разрешения:
| Разрешение | Назначение |
|---|---|
bigquery.datasets.get | Доступ к метаданным набора данных |
bigquery.tables.create | Создание таблиц |
bigquery.tables.delete | Удаление или замена таблиц |
bigquery.tables.get | Чтение метаданных таблиц |
bigquery.tables.getData | Чтение данных таблиц |
bigquery.tables.list | Получение списка таблиц в наборе данных |
bigquery.tables.update | Обновление схемы таблицы |
bigquery.tables.updateData | Вставка, обновление или удаление строк |
bigquery.routines.get | Чтение метаданных подпрограмм |
bigquery.routines.list | Получение списка подпрограмм в наборе данных |
bigquery.jobs.create | Выполнение запросов |
Следующие разрешения необязательны и нужны для дополнительных функций dbt:
| Разрешение | Когда требуется |
|---|---|
bigquery.datasets.create | Автоматическое создание наборов данных |
bigquery.routines.create | Создание UDF или хранимых процедур |
bigquery.jobs.get | Отслеживание статуса заданий |
storage.objects.create | Модели Python (промежуточное хранение в GCS) |
dataproc.* | Модели Python в Dataproc |
Предопределённые роли IAM
Следующие роли обычно служат отправной точкой при настройке доступа для dbt:
| Роль | Описание | Сценарий использования |
|---|---|---|
roles/bigquery.dataEditor | Чтение и запись таблиц в наборах данных | Стандартные операции dbt |
roles/bigquery.user | Запуск заданий, создание наборов данных | Выполнение заданий |
roles/bigquery.jobUser | Только запуск заданий | Минимальные права для выполнения запросов |
Для доступа к Storage Read API с помощью dbt v2 также предоставьте роль BigQuery Read Session User (roles/bigquery.readSessionUser) на уровне проекта, как указано в разделе Подключение BigQuery.
Операции с метаданными
Для основных функций dbt необходимы следующие операции:
| Тип запроса | Используемый SQL или API | Необходимое разрешение |
|---|---|---|
| Получение схемы таблицы | API get_table_schema | bigquery.tables.get |
| Получение списка отношений | Запрос к набору данных | bigquery.tables.list, bigquery.routines.list |
| Проверка актуальности источников | Запрос к метаданным __TABLES__ | bigquery.tables.get |
| Получение статистики таблицы | Запрос к INFORMATION_SCHEMA | bigquery.tables.get |
| Создание набора данных | CREATE SCHEMA | bigquery.datasets.create |
INFORMATION_SCHEMA и представления метаданных
dbt v2 выполняет запросы к следующим системным представлениям BigQuery:
| Представление | Назначение | Область действия |
|---|---|---|
INFORMATION_SCHEMA.TABLES | Получение списка таблиц | Набор данных или регион |
INFORMATION_SCHEMA.COLUMNS | Метаданные столбцов | Набор данных или регион |
INFORMATION_SCHEMA.VIEWS | Определения представлений | Набор данных или регион |
INFORMATION_SCHEMA.PARTITIONS | Информация о секциях | Только набор данных |
__TABLES__ (устарело) | Время изменения таблиц | Набор данных |
BigQuery DataFrames (необязательно)
Для рабочих процессов BigQuery DataFrames пользователям обычно требуются дополнительные роли, такие как BigQuery Job User, BigQuery Read Session User, Notebook Runtime User, Code Creator и colabEnterpriseUser. Точные названия ролей в вашей организации уточните у администратора Google Cloud.
Аутентификация
dbt поддерживает различные методы аутентификации в зависимости от вашей среды и тарифного плана:
- Окружения для разработки поддерживают:
- Service JSON
- BigQuery OAuth Enterprise
- Окружения для деплоя поддерживают:
- Service JSON
- BigQuery Workload Identity Federation (WIF) Enterprise
Эти методы аутентификации настраиваются в глобальных настройках подключений учетной записи, а не в настройках единого входа или интеграций.
При создании нового подключения BigQuery вам будет предложено два варианта схемы подключения (оба используют один и тот же адаптер):
- BigQuery: Поддерживает все типы подключений (используйте этот вариант)
- BigQuery (Legacy): Поддерживает все типы подключений, кроме WIF (устаревшая функция. Не используйте.)
Для всех новых подключений следует выбирать BigQuery, поскольку вариант BigQuery (Legacy) будет выведен из эксплуатации. Чтобы обновить существующие подключения и учетные данные в окружении для использования нового варианта BigQuery, сначала удалите конфигурации с помощью API.
JSON keyfile
Хотя поля в подключении BigQuery можно заполнить вручную, мы рекомендуем загрузить keyfile сервисного аккаунта JSON, чтобы быстро и корректно настроить подключение к BigQuery.
Вы можете предоставить JSON ключевой файл в одном из двух форматов:
- JSON keyfile upload — Загрузите keyfile напрямую в его стандартном формате JSON.
- Base64-encoded string — Укажите keyfile в виде строки, закодированной в base64. При предоставлении строки в формате base64 dbt автоматически декодирует её и заполняет необходимые поля.
Опция JSON keyfile доступна для настройки как development, так и deployment окружений.
Загрузка корректного JSON keyfile заполнит следующие поля:
- Project ID
- Private key ID
- Private key
- Client email
- Client ID
- Auth URI
- Token URI
- Auth provider x509 cert url
- Client x509 cert url
В дополнение к этим полям, в подключении BigQuery можно настроить ещё два необязательных поля:
| Поле | Описание | Примеры |
|---|---|---|
| Timeout | Устарело; существует для обратной совместимости с более старыми версиями dbt и будет удалено в будущем. | 300 |
| Location | Местоположение, где dbt должен создавать наборы данных. | US, EU |
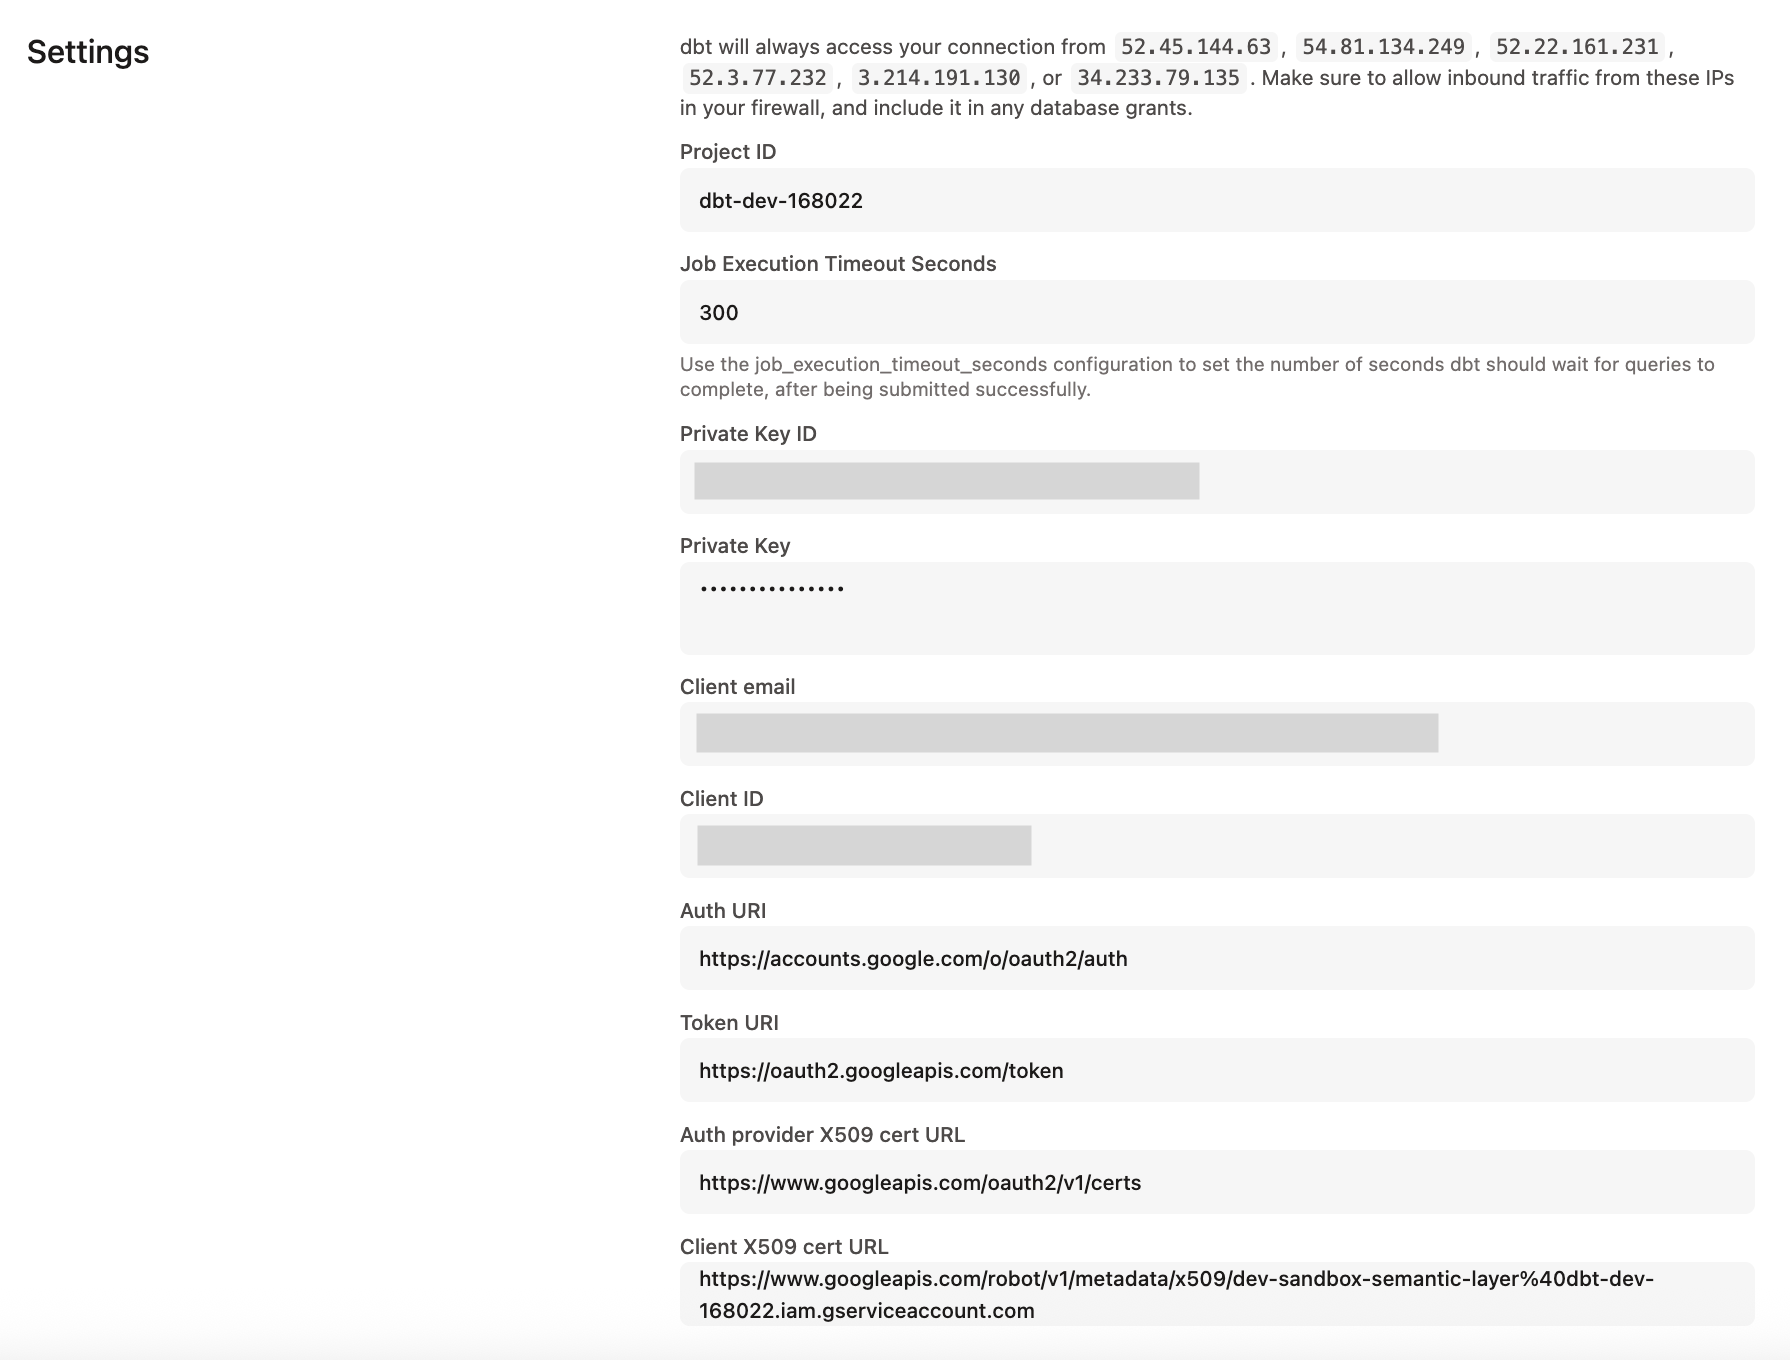 Пример корректного подключения к BigQuery
BigQuery OAuth
Доступно в: средах разработки, только в планах Enterprise
Метод аутентификации OAuth позволяет dbt выполнять запросы от имени пользователя BigQuery или рабочей нагрузки без хранения файла ключа сервисного аккаунта BigQuery в dbt. Однако для завершения настройки в dbt Cloud по-прежнему необходимо предоставить JSON или заполнить поля вручную. Чтобы обойти это требование, необязательно указывать реальные значения (например, можно указать N/A). Подробнее о первоначальной настройке подключения к BigQuery через OAuth в dbt> см. в документации по настройке BigQuery OAuth.
Если ваша организация настроила BigQuery OAuth, вы как конечный пользователь можете связать проект со своим личным аккаунтом BigQuery в своём профиле в dbt.
Федерация удостоверений рабочей нагрузки BigQuery EnterpriseПредварительная версия
Если вы используете BigQuery WIF, рекомендуем использовать его вместе с BigQuery OAuth. В противном случае необходимо создать два подключения — одно с service JSON и одно с WIF, чтобы использовать service JSON в средах разработки.
Доступно в: средах развертывания
Метод аутентификации BigQuery WIF позволяет dbt выполнять запросы при развертывании от имени сервисного аккаунта без настройки файла ключа сервисного аккаунта BigQuery в dbt. Дополнительную информацию о первоначальной настройке подключения BigQuery WIF в dbt см. в разделе Настройка Workload Identity Federation для BigQuery.
Чтобы узнать, как оптимизировать производительность с помощью конфигураций, специфичных для конкретной платформы данных, в , обратитесь к разделу Настройки BigQuery.
Чтобы узнать, как оптимизировать производительность с помощью настроек для конкретной платформы данных в dbt, обратитесь к разделу Настройки для BigQuery.
В BigQuery необязательные конфигурации позволяют настроить параметры для таких задач, как приоритет запросов, местоположение набора данных, время ожидания выполнения задания и многое другое. Эти опции дают вам больший контроль над тем, как BigQuery работает за кулисами, чтобы соответствовать вашим требованиям.
Чтобы настроить дополнительные параметры в :
Чтобы настроить необязательные параметры конфигурации в dbt:
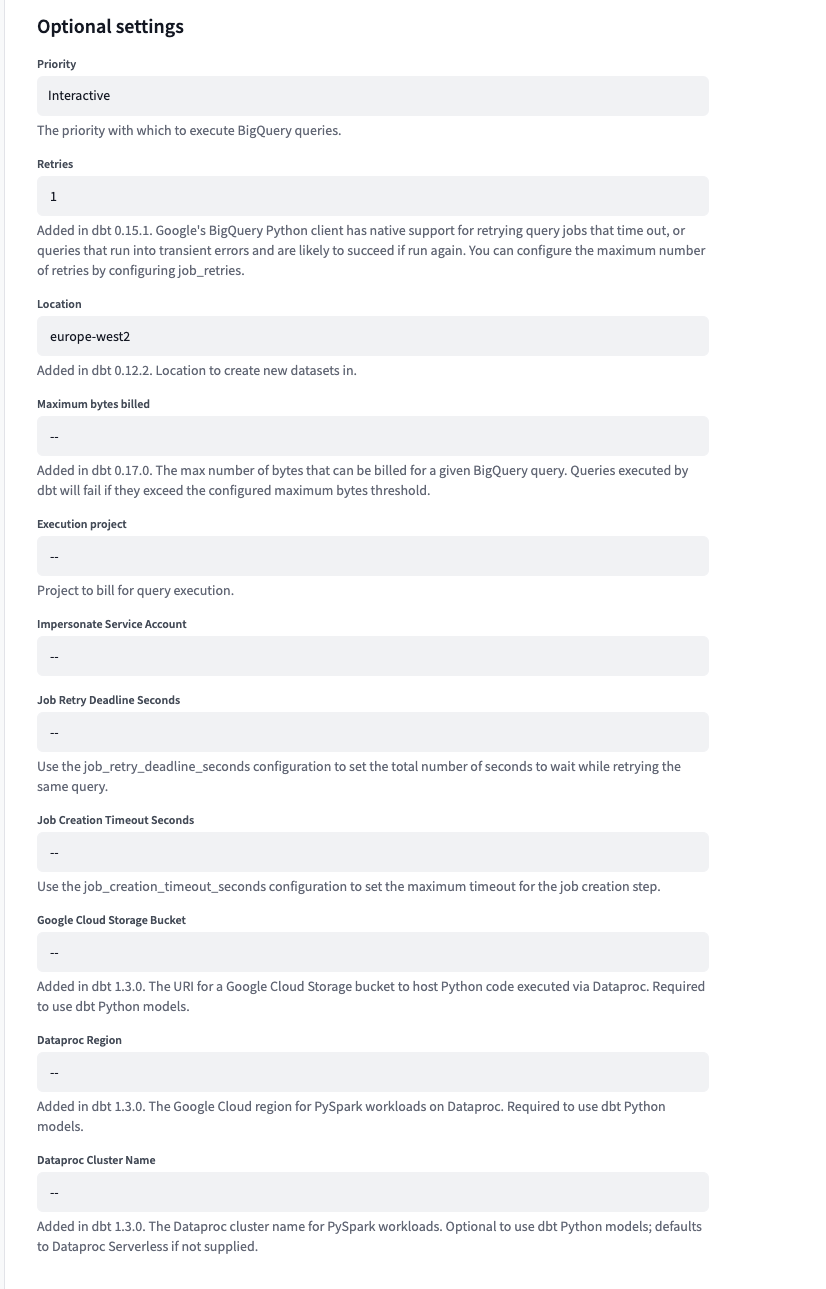 Необязательная конфигурация BigQuery
Ниже перечислены необязательные параметры конфигурации, которые вы можете задать в :
Ниже перечислены необязательные параметры конфигурации, которые можно задать в dbt:
| Параметр конфигурации | Информация | Тип | Пример |
|---|---|---|---|
| Priority | Задаёт приоритет заданий BigQuery (либо interactive, либо постановка в очередь для обработки в режиме batch) | String | batch or interactive |
| Retries | Определяет количество повторных попыток для заданий, завершившихся неудачно из‑за временных проблем | Integer | 3 |
| Location | Регион для создания новых наборов данных | String | US, EU, us-west2 |
| Maximum bytes billed | Ограничивает максимальное количество байт, за которые может быть выставлен счёт при выполнении запроса | Integer | 1000000000 |
| Execution project | Указывает идентификатор проекта, на который будет выставляться счёт за выполнение запроса | String | my-project-id |
| Impersonate service account | Позволяет пользователям, аутентифицированным локально, получать доступ к ресурсам BigQuery от имени указанного сервисного аккаунта | String | service-account@project.iam.gserviceaccount.com |
| Job retry deadline seconds | Задаёт общее количество секунд, в течение которых BigQuery будет пытаться повторно выполнить задание при сбое | Integer | 600 |
| Job creation timeout seconds | Определяет максимальный таймаут для этапа создания задания | Integer | 120 |
| Google cloud storage-bucket | Расположение для хранения объектов в Google Cloud Storage | String | my-bucket |
| Dataproc region | Указывает облачный регион для запуска заданий обработки данных | String | US, EU, asia-northeast1 |
| Dataproc cluster name | Назначает уникальный идентификатор группе виртуальных машин в Dataproc | String | my-cluster |
| Notebook Template ID | Уникальный идентификатор среды выполнения ноутбука Colab Enterprise | Integer | 7018811640745295872 |
| Compute Region | Указывает регион вычислительных ресурсов | String | US, EU, asia-northeast1 |
Запуск моделей dbt на Python в Google Cloud Platform
Для выполнения Python-моделей dbt на GCP, dbt использует вспомогательные сервисы, Dataproc и Cloud Storage, которые предлагают тесную интеграцию с BigQuery. Вы можете использовать существующий кластер Dataproc и корзину Cloud Storage или создать новые:
- https://cloud.google.com/dataproc/docs/guides/create-cluster
- https://cloud.google.com/storage/docs/creating-buckets
Подключения и управление учетными данными на уровне аккаунта
Вы можете повторно использовать подключения в нескольких проектах с помощью глобальных подключений. Подключения привязываются на уровне окружения (ранее — на уровне проекта), поэтому в одном проекте можно использовать несколько подключений (для разработки, staging, production и других задач).
В настоящее время подключения BigQuery в dbt предполагают управление учетными данными на уровне подключения (это относится только к подключениям BigQuery). Изначально такой подход был разработан, чтобы упростить создание нового подключения путем загрузки файла ключа сервисного аккаунта. Здесь описано, как переопределить эти учетные данные с помощью расширенных атрибутов, чтобы администраторы проектов могли управлять учетными данными независимо от параметров подключения на уровне аккаунта. Информацию о том, где настроить эти атрибуты для окружений развертывания и разработки, см. в разделе Расширенные атрибуты.
В этом разделе описывается, как переопределить учетные данные на уровне окружения с помощью extended attributes, чтобы администраторы проекта могли управлять учетными данными независимо от параметров подключения на уровне аккаунта, используемых для данного окружения.
Для проекта вы сначала создадите переменную среды для хранения секретного значения private_key. Затем вы используете расширенные атрибуты, чтобы переопределить весь JSON учетной записи службы (вы не можете переопределить только секретный ключ из-за ограничения расширенных атрибутов).
- Новая переменная среды
Чтобы автоматизировать развертывание, используйте следующий запрос к API администрирования, где XXXXX — номер вашей учетной записи, YYYYY — номер вашего проекта, ZZZZZ — ваш API-токен:
curl --request POST \
--url https://cloud.getdbt.com/api/v3/accounts/XXXXX/projects/YYYYY/environment-variables/bulk/ \
--header 'Accept: application/json' \
--header 'Authorization: Bearer ZZZZZ' \
--header 'Content-Type: application/json' \
--data '{
"env_var": [
{
    "new_name": "DBT_ENV_SECRET_PROJECTXXX_PRIVATE_KEY",
    "project": "Value by default for the entire project",
    "ENVIRONMENT_NAME_1": "Optional, if wanted, value for environment name 1",
    "ENVIRONMENT_NAME_2": "Optional, if wanted, value for environment name 2"
}
]
}'
- Расширенные атрибуты
Заполните блок расширенных атрибутов следующим содержимым (заменив XXX соответствующими значениями). На этой странице объясняется, где настроить их для сред развертывания и разработки:
keyfile_json:
  type: service_account
  project_id: xxx
  private_key_id: xxx
  private_key: '{{ env_var(''DBT_ENV_SECRET_PROJECTXXX_PRIVATE_KEY'') }}'
  client_email: xxx
  client_id: xxx
  auth_uri: xxx
  token_uri: xxx
  auth_provider_x509_cert_url: xxx
  client_x509_cert_url: xxx
Если вам нужно переопределить другие поля на уровне окружения с помощью расширенных атрибутов, соблюдайте требуемые отступы (порядок не имеет значения):
priority: interactive
keyfile_json:
  type: xxx
  project_id: xxx
  private_key_id: xxx
  private_key: '{{ env_var(''DBT_ENV_SECRET_PROJECTXXX_PRIVATE_KEY'') }}'
  client_email: xxx
  client_id: xxx
  auth_uri: xxx
  token_uri: xxx
  auth_provider_x509_cert_url: xxx
  client_x509_cert_url: xxx
execution_project: buck-stops-here-456
Чтобы автоматизировать развертывание, сначала необходимо создать полезную нагрузку расширенных атрибутов для выбранного проекта, а затем назначить ее определенной среде. Здесь XXXXX — номер вашего аккаунта, YYYYY — номер вашего проекта, а ZZZZZ — ваш токен API:
curl --request POST \
--url https://cloud.getdbt.com/api/v3/accounts/XXXXX/projects/YYYYY/extended-attributes/ \
--header 'Accept: application/json' \
--header 'Authorization: Bearer ZZZZZ' \
--header 'Content-Type: application/json' \
--data '{
"id": null,
"extended_attributes": {"type":"service_account","project_id":"xxx","private_key_id":"xxx","private_key":"{{ env_var('DBT_ENV_SECRET_PROJECTXXX_PRIVATE_KEY')    }}","client_email":"xxx","client_id":xxx,"auth_uri":"https://accounts.google.com/o/oauth2/auth","token_uri":"https://oauth2.googleapis.com/token","auth_provider_x509_cert_url":"https://www.googleapis.com/oauth2/v1/certs","client_x509_cert_url":"xxx"},
"state": 1
}'
Запомните id, возвращенный в сообщении. Он будет использован в следующем вызове. С EEEEE идентификатором среды, FFFFF идентификатором расширенных атрибутов:
curl --request POST \
--url https://cloud.getdbt.com/api/v3/accounts/XXXXX/projects/YYYYY/environments/EEEEE/ \
--header 'Accept: application/json' \
--header 'Authorization: Bearer ZZZZZZ' \
--header 'Content-Type: application/json' \
--data '{
  "extended_attributes_id": FFFFF
}'
