История запросов модели
История запросов моделей помогает командам по работе с данными отслеживать использование моделей за счёт анализа журналов запросов.
История запросов модели позволяет:
- Просматривать количество запросов на потребление для модели на основе логов запросов в хранилище данных.
- Предоставлять командам аналитиков информацию, чтобы они могли сосредоточить свое время и затраты на инфраструктуру на действительно используемых продуктах данных.
- Позволять аналитикам находить самые популярные модели, используемые другими людьми.
История запросов модели основана на единственном запросе потребления таблицы логов запросов в вашем хранилище данных, агрегированном на ежедневной основе.
История запросов моделей поддерживается в следующих хранилищах данных:
- Snowflake (тариф Enterprise или выше)
- BigQuery
- Redshift
- Databricks
Предварительные условия
Для доступа к этим функциям необходимо выполнить следующие требования:
- У вас есть учетная запись dbt на тарифном плане Enterprise. Пользователям учетных записей в однопользовательской среде (single-tenant) следует обратиться к своему менеджеру по работе с клиентами для настройки.
- Для каждого проекта, который вы хотите исследовать, настроена производственная среда развертывания, в которой хотя бы один запуск задания завершился успешно.
- У вас есть права администратора в dbt для изменения настроек проекта или производственной среды.
- Вы используете Snowflake, BigQuery, Redshift или Databricks в качестве хранилища данных и можете предоставить разрешения на доступ к истории запросов самостоятельно или с помощью администратора.
- Для пользователей Snowflake: у вас должна быть подписка Snowflake уровня Enterprise или выше.
Включение истории запросов в dbt
- Новые производственные среды: dbt автоматически включает историю запросов при создании новой производственной среды развертывания в разделе Orchestration (с пометкой PROD). Это относится к Snowflake, BigQuery, Redshift и Databricks на тарифных планах Enterprise. На среды разработки это не распространяется.
- Существующие производственные среды: историю запросов необходимо включить вручную в настройках среды PROD. Прежде чем выполнять действия из этого раздела, настройте права доступа учетных данных для вашего хранилища.
Чтобы включить историю запросов к моделям в dbt, выполните следующие действия:
- Перейдите в раздел Orchestration, затем в Environments.
- Выберите среду с пометкой PROD и нажмите Settings.
- Нажмите Edit и прокрутите страницу до раздела Query History.
- Нажмите кнопку Test Permissions, чтобы убедиться, что учетные данные развертывания предоставляют достаточно прав для работы истории запросов.
- Установите флажок Enable query history, чтобы включить историю запросов.
- Сохраните настройки, нажав Save.
Если не удается получить данные истории запросов, dbt автоматически отключает ее, чтобы избежать непредвиденных расходов на хранилище.
- Если сбой временный (например, превышено время ожидания сети), dbt может повторить попытку.
- Если проблема сохраняется (например, отсутствуют необходимые права доступа), dbt отключает историю запросов, чтобы клиенты не расходовали вычислительные ресурсы хранилища впустую.
Чтобы снова включить ее, нажмите Test Permissions в разделе Environment settings. Если проверка пройдет успешно, dbt снова включит историю запросов для этой среды.
 Включите историю запросов в настройках среды.
Права доступа учетных данных
В этом разделе описаны права доступа и действия, необходимые для включения и просмотра истории запросов к моделям в Catalog.
Функция истории запросов к моделям использует учетные данные производственной среды для сбора метаданных из журналов запросов вашего хранилища данных. Поэтому могут потребоваться расширенные права доступа к хранилищу. Прежде чем изменять права доступа на вашей платформе данных, проверьте настроенные права доступа в dbt:
- Перейдите в раздел Orchestration, затем в Environments.
- Выберите среду с пометкой PROD и нажмите Settings.
- Нажмите Edit.
- Нажмите значок синхронизации в разделе Connection profiles.
- Просмотрите информацию в разделе Deployment credentials.
- Примечание: запросы к истории запросов влекут расходы на хранилище / расходуют кредиты.
 Нажмите значок синхронизации в разделе Connection profiles.
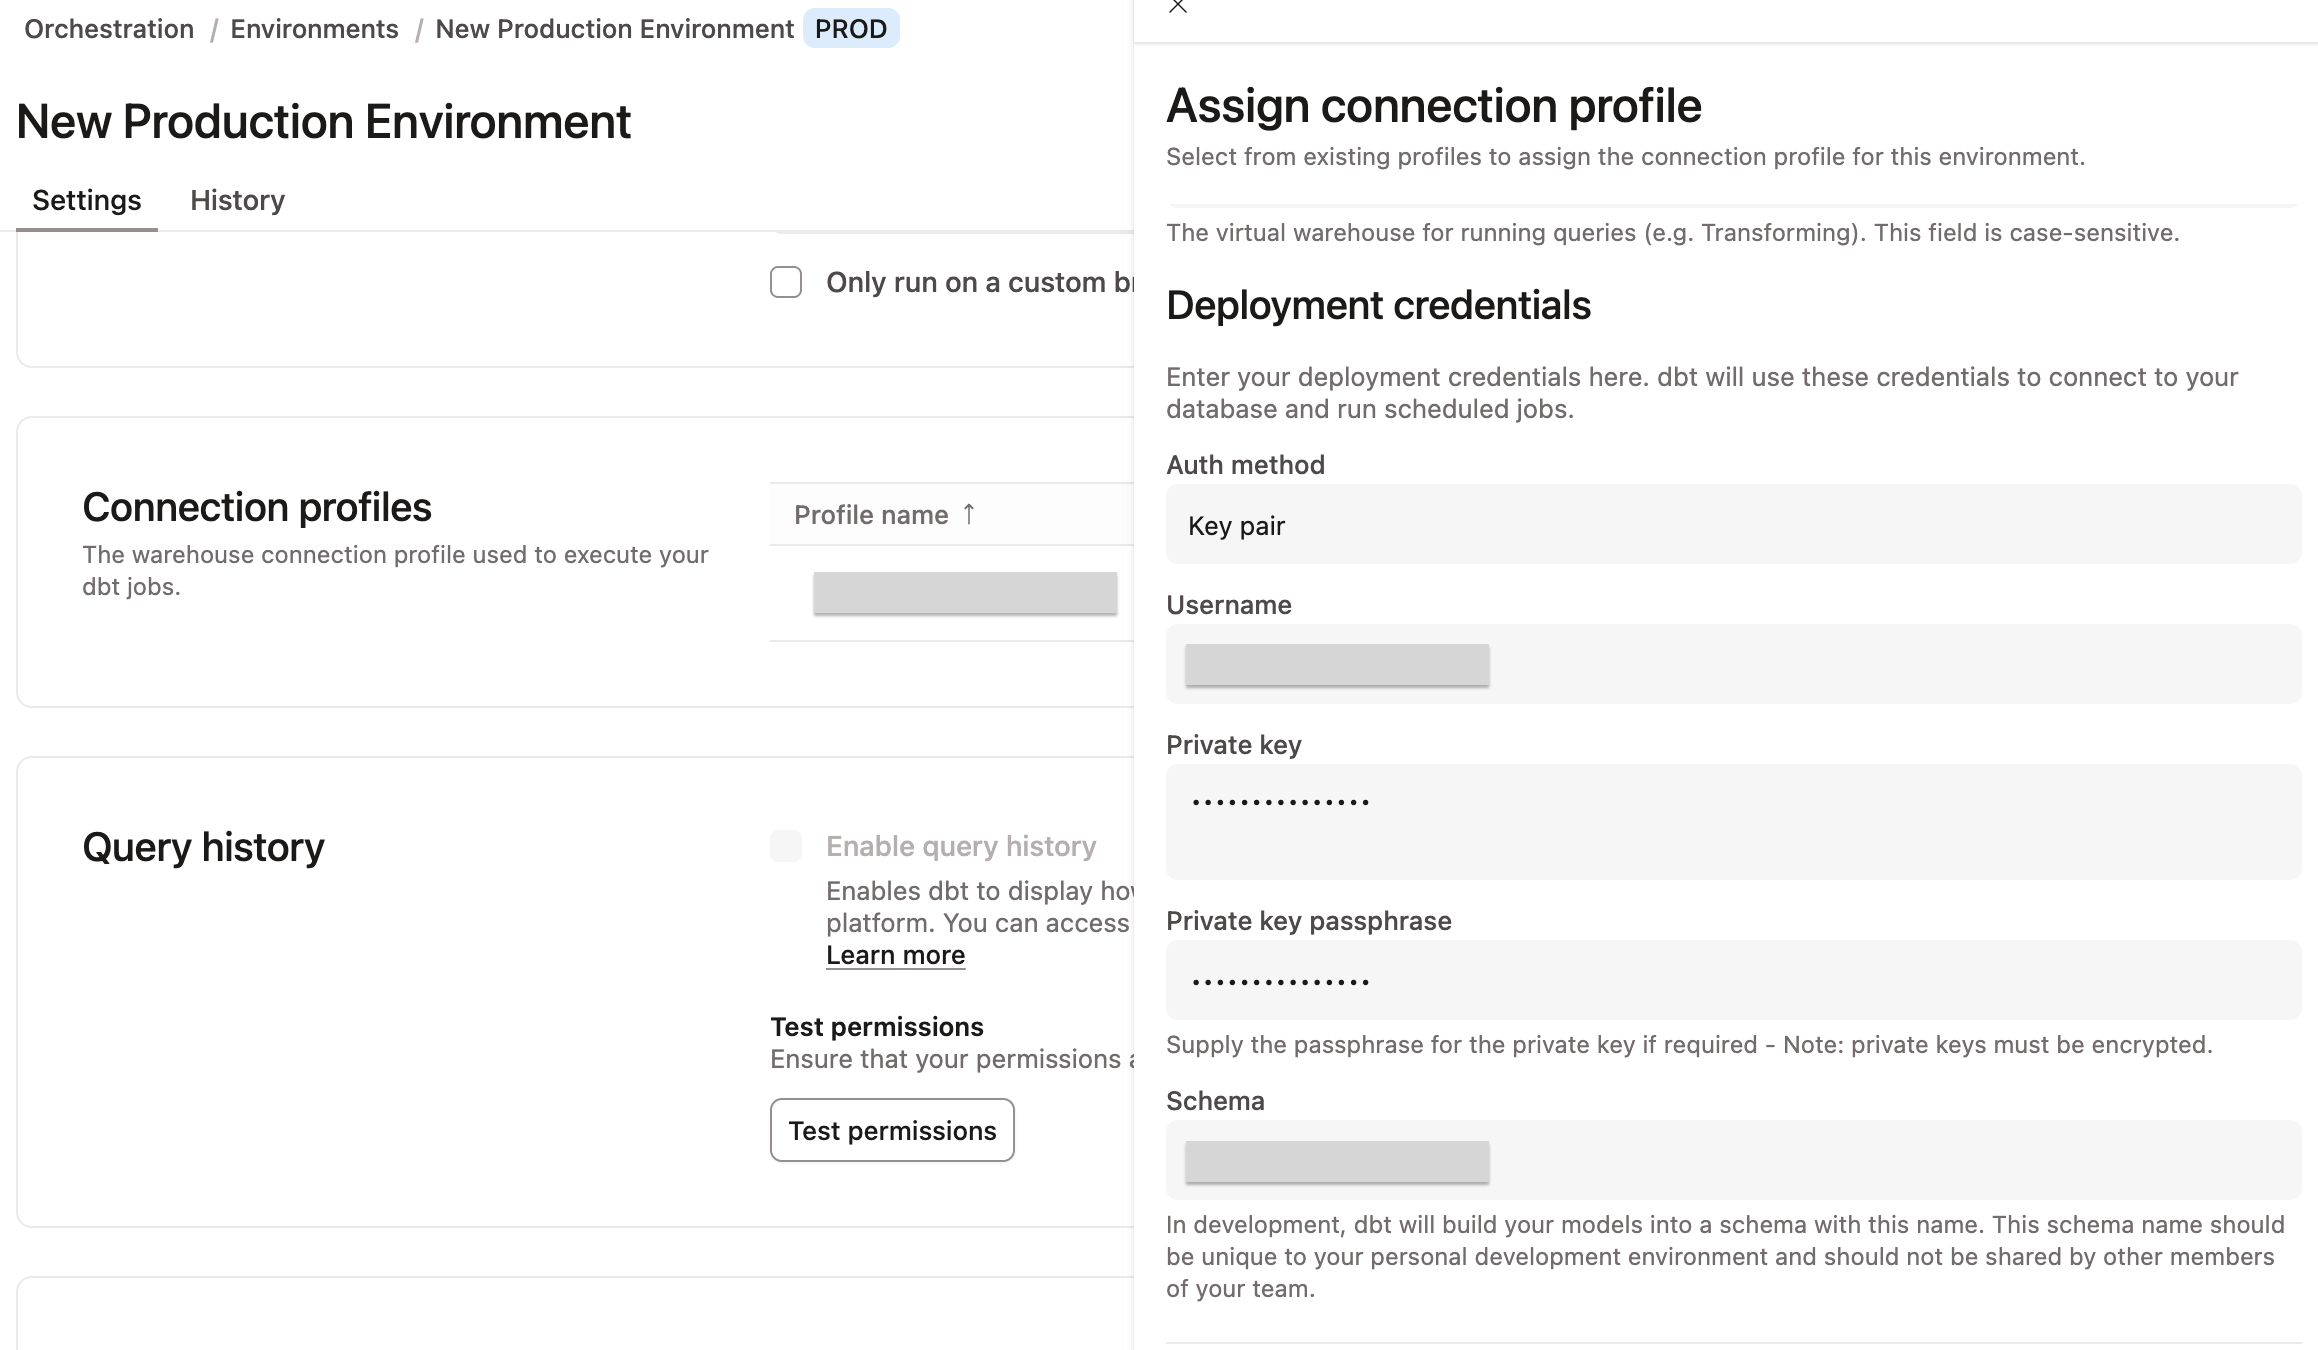 Проверьте учетные данные развертывания на странице настроек среды.
- Скопируйте сведения о правах доступа этих учетных данных или сопоставьте их с правами доступа в хранилище и предоставьте пользователю необходимые права.
История запросов к моделям в Snowflake
История запросов к моделям использует таблицы метаданных, доступные для учетных записей Snowflake редакции Enterprise и выше: QUERY_HISTORY и ACCESS_HISTORY. Для просмотра данных пользователь Snowflake в производственной среде должен иметь право доступа GOVERNANCE_VIEWER.
Прежде чем включать историю запросов к моделям, ваш ACCOUNTADMIN должен выполнить следующую команду предоставления прав в Snowflake, чтобы обеспечить доступ:
GRANT DATABASE ROLE SNOWFLAKE.GOVERNANCE_VIEWER TO ROLE <YOUR_DBT_CLOUD_DEPLOYMENT_ROLE>;
Без предоставления этих прав история запросов к моделям не будет отображать данные. Дополнительные сведения см. в документации Snowflake.
История запросов к моделям в BigQuery
История запросов к моделям использует метаданные из представления INFORMATION_SCHEMA.JOBS в BigQuery. Для доступа к этим метаданным пользователь производственной среды должен иметь соответствующую роль IAM или разрешение на доступ к этим данным:
- Если вы используете стандартную роль BigQuery, рекомендуется
roles/bigquery.resourceViewer. - Если вы используете кастомную роль, убедитесь, что она включает разрешение
bigquery.jobs.listAll.
История запросов к моделям в Redshift
История запросов к моделям использует системные представления SYS_QUERY_HISTORY и SYS_QUERY_DETAIL в Redshift. По умолчанию пользователи могут видеть в этих представлениях только собственные запросы. Чтобы отображалась история запросов всех пользователей хранилища, администратор базы данных должен предоставить пользователю, чьи учетные данные используются в производственной среде, одно из следующих разрешений:
-
Роль
sys:monitor:GRANT ROLE sys:monitor TO <YOUR_DBT_USER>; -
Неограниченный доступ к syslog для пользователя:
ALTER USER <YOUR_DBT_USER> SYSLOG ACCESS UNRESTRICTED;
Без одного из этих разрешений история запросов к моделям не будет отображать данные других пользователей. Дополнительную информацию см. в документации Redshift.
Особенности Redshift
История запросов к моделям в Redshift формируется на основе сканирований физических таблиц (SYS_QUERY_DETAIL, где step_name = 'scan'). Это означает, что данные об использовании служат надежным показателем, но не отражают точное количество запросов.
Поскольку Redshift раскрывает обычные представления во время выполнения, сканирования связываются с базовыми таблицами, а имена представлений не появляются в метаданных сканирования. На материализованные представления это ограничение не распространяется. При анализе данных об использовании учитывайте следующее:
- Для моделей с материализацией
viewпоказатели использования, скорее всего, будут нулевыми. - Для моделей с материализацией
tableилиincrementalиспользование учитывается корректно. - Использование моделей
ephemeralневозможно учесть отдельно.
Если в вашем проекте широко используются представления, показатели использования могут оказаться ниже ожидаемых. Это известное ограничение учета на основе сканирований, а не отсутствие данных.
История запросов к моделям в Databricks
История запросов к моделям использует две системные таблицы Unity Catalog: system.query.history и system.access.table_lineage. Прежде чем предоставлять доступ, убедитесь, что выполнены следующие предварительные требования:
- В вашей учетной записи есть хотя бы одно рабочее пространство с включенным Unity Catalog. Пользователи, которые по-прежнему используют устаревший Hive Metastore, не могут пользоваться историей запросов к моделям.
- Хранилище метаданных использует модель привилегий версии 1.0 (Privilege Model Version 1.0). Дополнительную информацию см. в справочнике по привилегиям Unity Catalog.
- Схемы
accessиqueryвключены в каталогеsystem. Администратор учетной записи Databricks может включить их в разделе Account Console > Settings > System tables.
Предоставьте субъекту-службе (service principal), используемому в вашей производственной среде, следующие привилегии:
GRANT USE CATALOG ON CATALOG system TO `<YOUR_SERVICE_PRINCIPAL>`;
GRANT USE SCHEMA ON SCHEMA system.access TO `<YOUR_SERVICE_PRINCIPAL>`;
GRANT USE SCHEMA ON SCHEMA system.query TO `<YOUR_SERVICE_PRINCIPAL>`;
GRANT SELECT ON TABLE system.access.table_lineage TO `<YOUR_SERVICE_PRINCIPAL>`;
GRANT SELECT ON TABLE system.query.history TO `<YOUR_SERVICE_PRINCIPAL>`;
Одной привилегии SELECT для таблиц недостаточно. Databricks также требует USE CATALOG для родительского каталога и USE SCHEMA для родительских схем.
Дополнительную информацию см. в документации по привилегиям Databricks Unity Catalog.
Особенности Databricks
При использовании истории запросов к моделям в Databricks учитывайте следующее:
- Данные об использовании могут быть неполными. Databricks фиксирует происхождение данных не для всех запросов, поэтому некоторые запросы могут не отображаться в данных об использовании. Это известное ограничение Databricks. Дополнительную информацию см. в разделе Системные таблицы происхождения данных Databricks.
- Сведения о происхождении данных обновляются не в реальном времени. Таблица
system.access.table_lineageобновляется в течение дня без гарантированных сроков. Возможны задержки до 24 часов. - Представления могут приводить к непоследовательной регистрации происхождения данных. Материализованные представления и потоковые таблицы включаются в события происхождения данных. Для обычных представлений записи о происхождении данных могут создаваться или не создаваться в зависимости от того, как Databricks Unity Catalog обрабатывает эти представления.
- Шифрование текста SQL-инструкций влияет на фильтрацию запросов. Если в Databricks включено шифрование текста SQL-инструкций, поле
statement_textвsystem.query.historyимеет значениеNULL. В этом случае запросы тестов dbt невозможно отфильтровать, и они могут учитываться как пользовательские запросы. - Сведения о происхождении данных для бессерверных вычислений могут быть неполными. Таблица
system.query.historyвключает запросы из SQL-хранилищ и бессерверных вычислительных ресурсов, но связь с исходными данными при бессерверном выполнении может фиксироваться не всегда.
Просмотр истории запросов в Catalog
Чтобы упростить исследование данных, вы можете просматривать историю запросов к моделям в различных разделах Catalog:
- Просмотр на диаграммах производительности
- Просмотр на графе зависимостей проекта
- Просмотр в списке моделей
Просмотр из графиков производительности
- Перейдите в Catalog, нажав Catalog на панели навигации.
- На главной странице Overview нажмите Performance в разделе Project details. Прокрутите страницу вниз до раздела Most consumed models.
- В раскрывающемся меню справа выберите нужный период времени. Доступны периоды в пределах последних 3 месяцев.
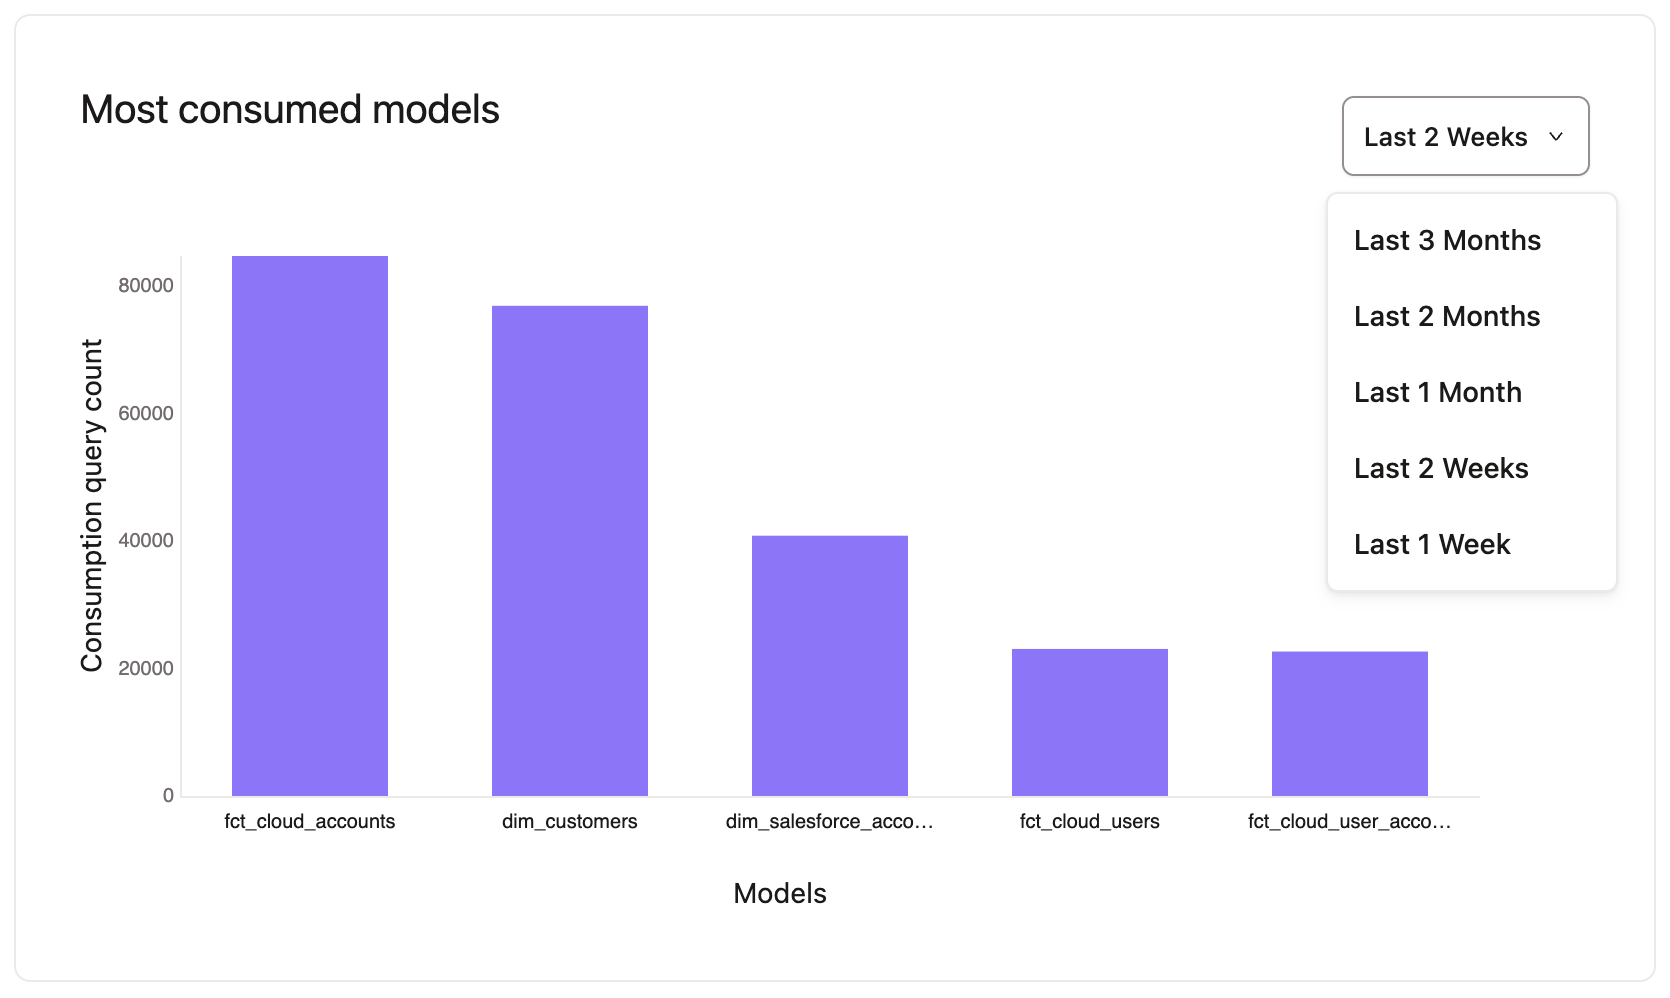 Просмотр наиболее востребованных моделей на странице «Performance» в dbt Catalog.
- Нажмите на модель, чтобы просмотреть подробную информацию, и перейдите на вкладку Performance.
- На вкладке Performance прокрутите страницу вниз до раздела Model performance.
- Выберите вкладку Consumption queries, чтобы просмотреть запросы, использующие данные этой модели, за выбранный период времени.
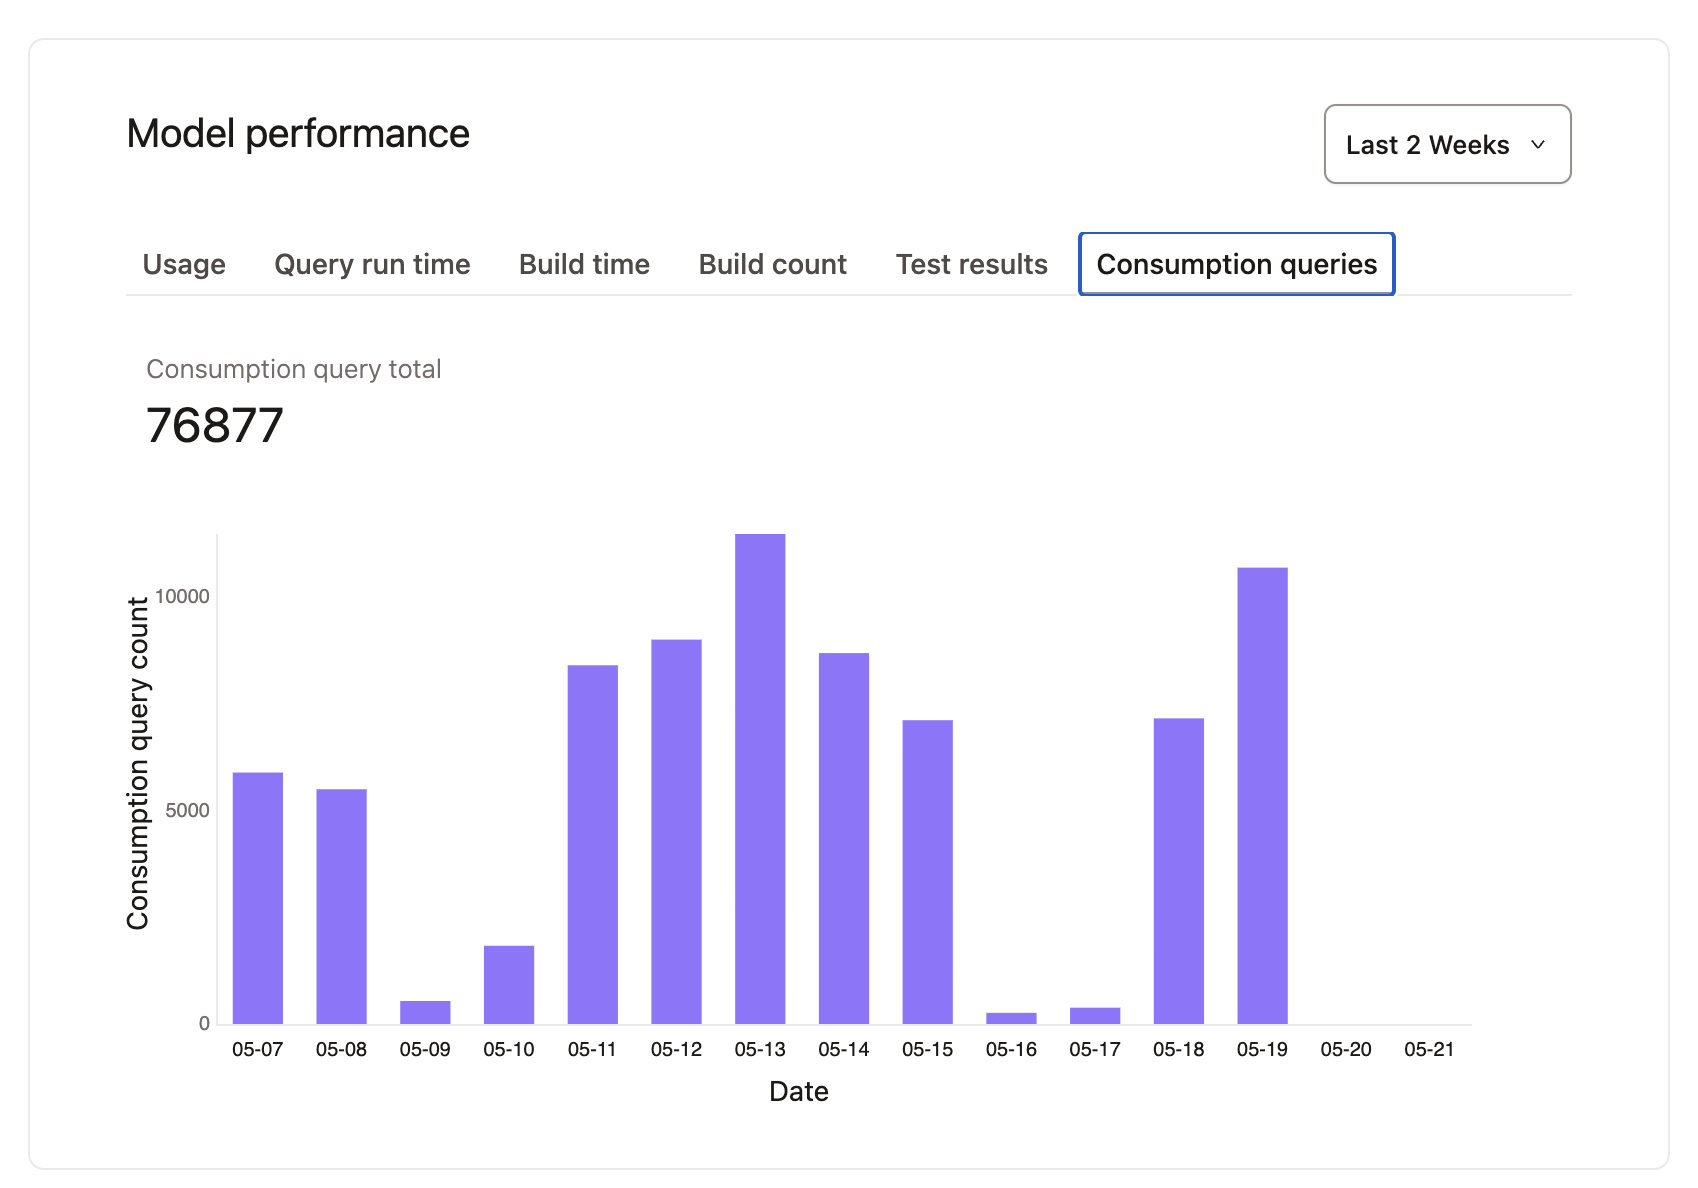 Просмотр запросов, использующих данные выбранной модели, за определённый период времени.
Просмотр из родословной проекта
- Чтобы просмотреть модель в графе зависимостей проекта, перейдите на главную страницу обзора и нажмите Граф зависимостей проекта.
- В левом нижнем углу графа зависимостей нажмите Линзы и выберите Запросы, использующие модели.
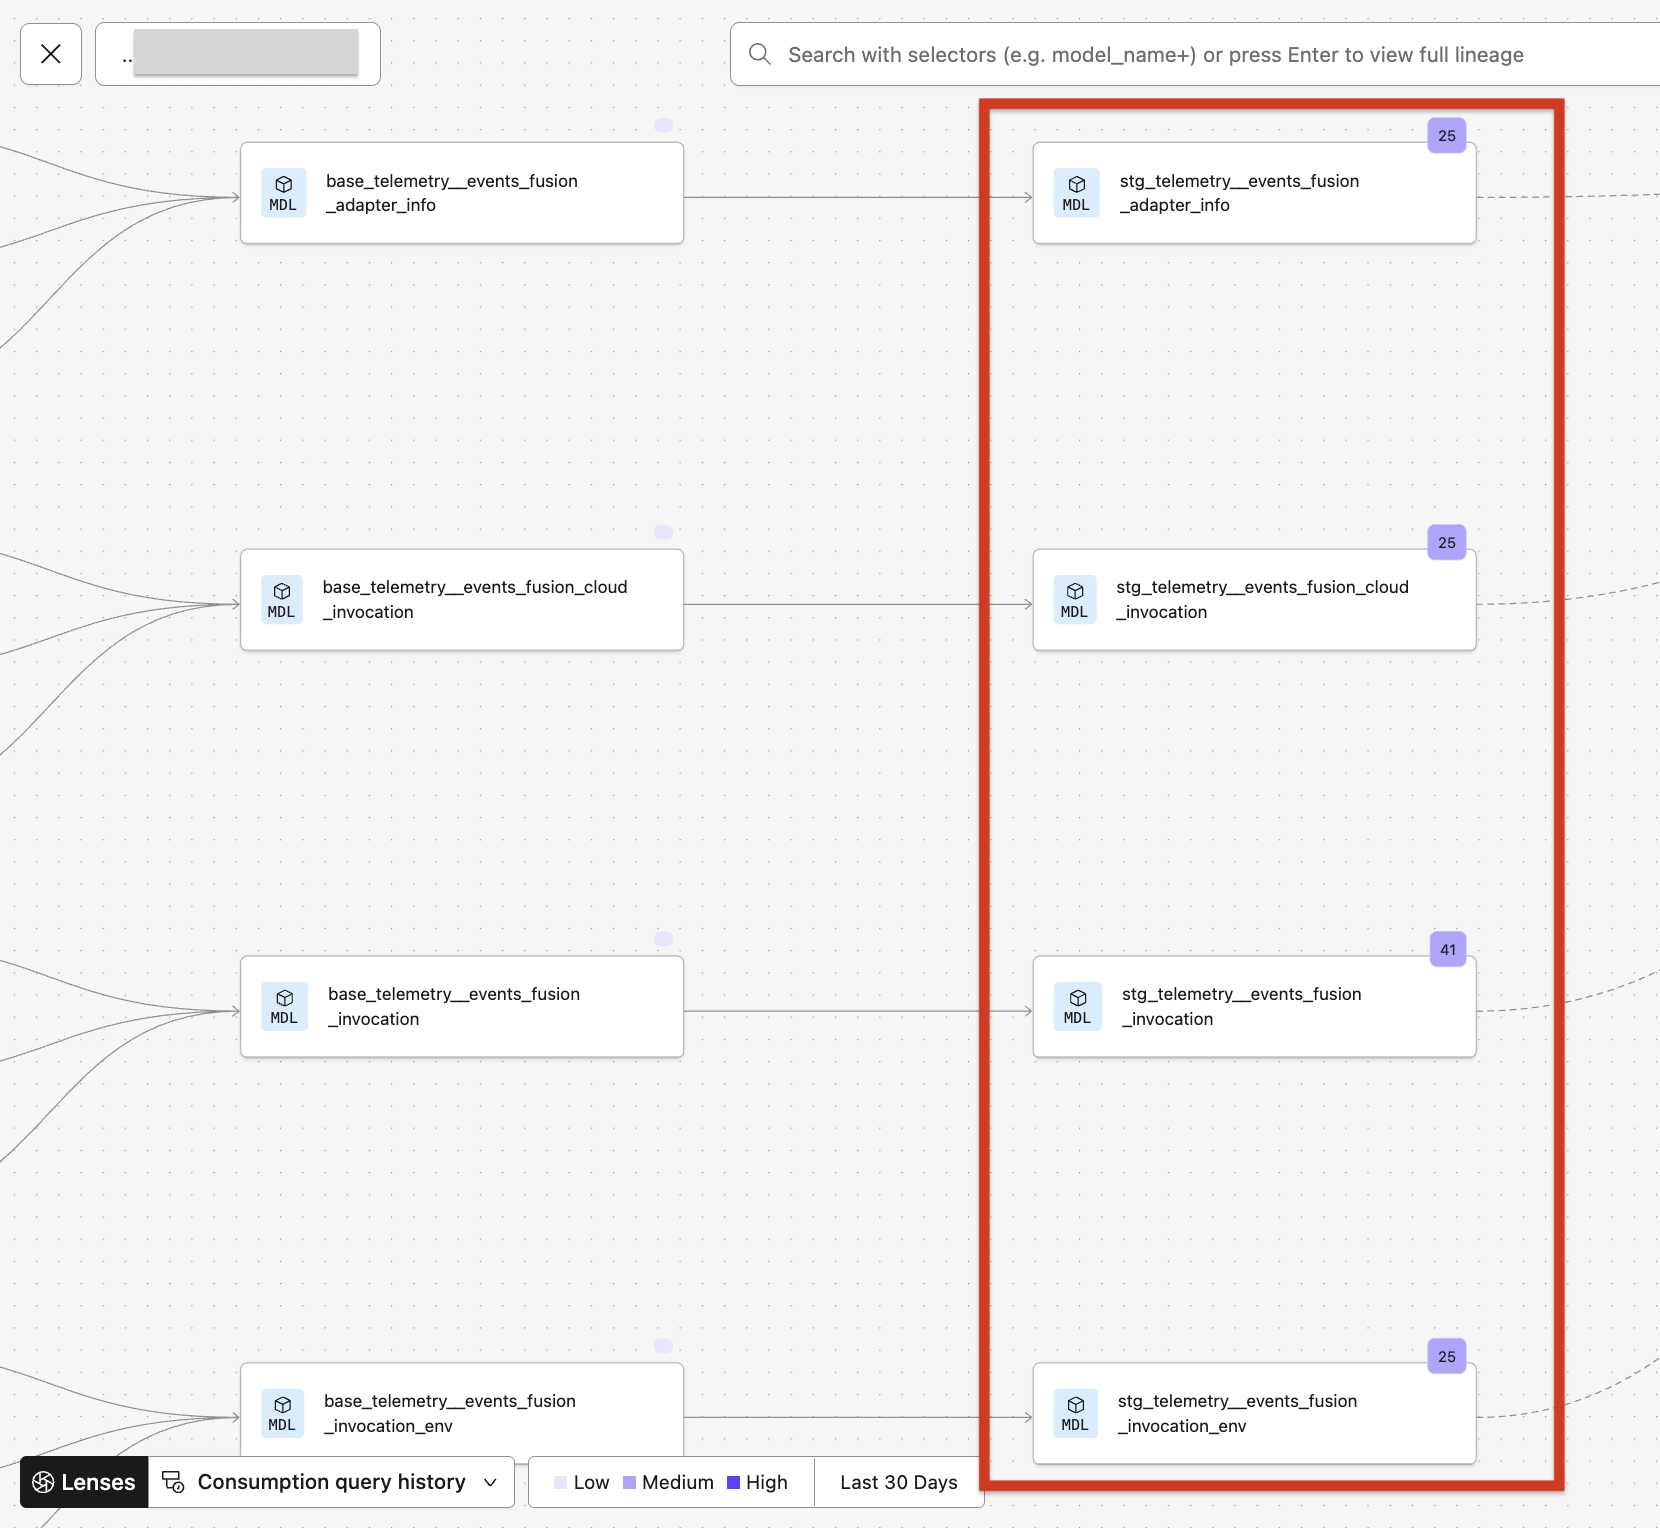 Просмотр запросов, использующих модели, в графе зависимостей с помощью функции «Линзы».
- Над каждой моделью в графе зависимостей должен появиться небольшой фиолетовый прямоугольник с количеством запросов, использующих эту модель. Это число для каждой модели отражает количество таких запросов за последние 30 дней.
Просмотр из списка моделей
- Чтобы просмотреть список моделей, перейдите на главную Overview page.
- В левой навигации перейдите на вкладку Resources и нажмите на Models, чтобы просмотреть список моделей.
- Вы можете просмотреть количество запросов на потребление для моделей и отсортировать по наиболее или наименее потребляемым. Число запросов на потребление для каждой модели представляет потребление за последние 30 дней.
 Просмотр потребления моделей на странице списка 'Models' в колонке 'Consumption'.
