Происхождение данных на уровне столбцов
Отслеживание происхождения данных на уровне столбцов (column-level lineage, CLL) позволяет подробнее изучить происхождение ваших продуктов данных. Для каждого столбца ресурса (модели, источника или снимка) в проекте dbt предоставляет сквозную информацию о происхождении данных в этом столбце с учётом того, как он используется.
 Обзор происхождения данных на уровне столбцов
Предварительные требования
Зависимости на уровне столбцов доступны в двух вариантах:
- В Catalog на dbt platform: нужен тариф Enterprise или Enterprise+ и доступ к Catalog.
- Локально с dbt v2: требуется строгий статический анализ. Доступно в расширении dbt для VS Code, dbt Docs v2 или в командной строке. Подробнее см. Информационная схема dbt.
Если вам нравятся видеокурсы, ознакомьтесь с нашим курсом по dbt Catalog, доступным по запросу, и узнайте, как наиболее эффективно исследовать свои проекты dbt!
Доступ к происхождению данных на уровне столбцов в Catalog
Для использования происхождения данных на уровне столбцов (CLL) в Catalog дополнительная настройка не требуется, если ваша учетная запись использует тарифный план Enterprise или Enterprise+ с доступом к Catalog. Открыть CLL можно из карточки столбца на вкладке Columns на странице сведений о ресурсе в Catalog для модели, источника или снимка.
dbt обновляет сведения о происхождении данных в Catalog после каждого запуска в производственной среде или среде staging. (Версии dbt: v2.0 и новее) Задания, использующие v2, автоматически обновляют эти метаданные при каждом запуске. Подробнее см. в разделе Генерация метаданных.
 Пример вкладки Columns и расположение элемента для открытия CLL
Локальный доступ к происхождению данных на уровне столбцов
При разработке с использованием dbt v2 просматривать происхождение данных на уровне столбцов можно следующими способами:
- Расширение dbt для VS Code: Щелкните правой кнопкой мыши имя файла или SQL-код модели, затем выберите dbt: View Lineage → Show column lineage. Полное описание процесса см. в разделе Подробное представление происхождения данных в контексте.
- dbt Docs v2: Выполните
dbt compile --generate-info-schema --static-analysis strict, затемdbt docs generate --no-compile. У командыdbt docs generateнет флага--static-analysis, поэтому сначала необходимо выполнить компиляцию в строгом режиме, иначе сайт не будет содержать сведения о происхождении данных на уровне столбцов. См. раздел dbt Docs v2. - Командная строка или артефакт: Выполните
dbt compile --generate-info-schema --static-analysis strict, затемdbt show --info column_lineage. Эти файлы находятся вtarget/info_schema/, и вы можете напрямую прочитать файл Parquetdbt.column_lineage.
Вы можете использовать линзу эволюции линии родословной столбцов, чтобы определить, когда столбец трансформируется или повторно используется (передача или переименование). Линза помогает различать, когда и как столбец фактически изменяется, проходя через вашу линию родословной dbt, что особенно полезно для отладки рабочих процессов.
 Пример линзы эволюции столбцов
Унаследованные описания столбцов
В столбце Transformation отображается предварительный просмотр формулы, используемой для вычисления значений столбца. Чтобы просмотреть полную формулу, выберите столбец в полном представлении происхождения данных.
Тип преобразования и формула появляются после обновления проекта и выполнения задания в среде production или staging.
Унаследованные описания столбцов
Столбцы передачи и переименования четко обозначены и имеют цветовую кодировку в линии родословной.
В следующем примере модели dim_salesforce_accounts (расположенной в конце линии родословной) описание для столбца, унаследованного от модели stg_salesforce__accounts (расположенной второй слева), указывает на его происхождение. Это помогает разработчикам быстро идентифицировать оригинальный источник столбца, облегчая внесение изменений в документацию.
 Пример линии родословной с распространенными и унаследованными описаниями столбцов.
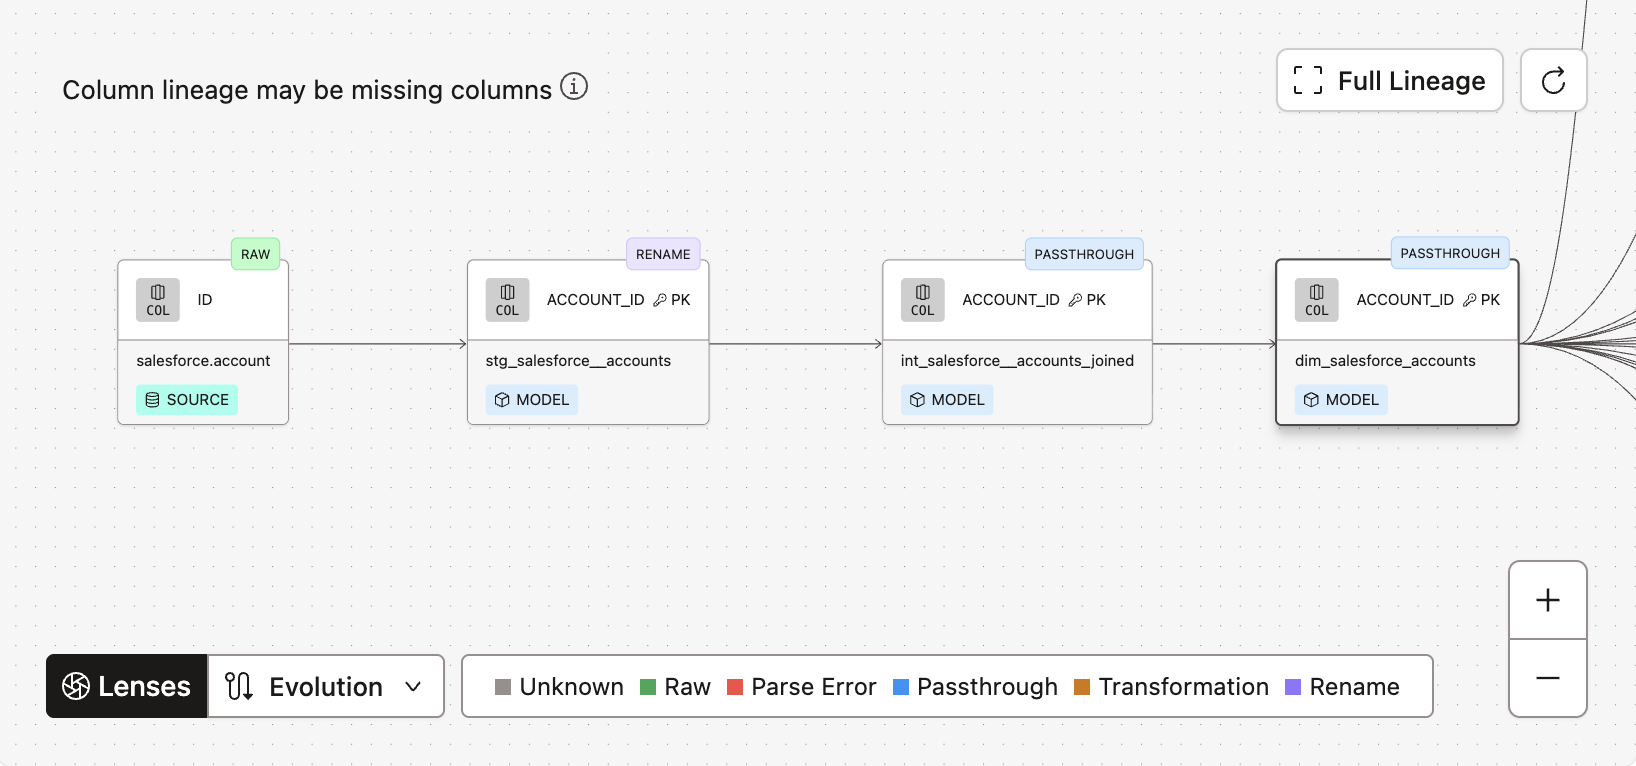 Пример графа зависимостей с распространёнными и унаследованными описаниями столбцов.
Узнайте больше о том, почему и как вы можете использовать CLL в следующих разделах.
Анализ первопричин
Когда происходит неожиданное нарушение в конвейере данных, линия родословной на уровне столбцов может быть ценным инструментом для понимания точного места, где произошла ошибка в конвейере. Например, сбой теста данных на определенном столбце в вашей модели dbt мог возникнуть из-за нетестированного столбца выше по потоку. Использование CLL может помочь быстро идентифицировать и исправить нарушения, когда они происходят.
Анализ воздействия
Во время разработки инженеры-аналитики могут использовать линию родословной на уровне столбцов, чтобы понять полный объем воздействия предлагаемых изменений. Эти знания позволяют им создавать более качественные запросы на слияние, требующие меньше правок, так как они могут предвидеть и предотвращать проблемы, которые остались бы незамеченными без детального понимания на уровне столбцов.
Сотрудничество и эффективность
При изучении ваших продуктов данных навигация по линии родословной столбцов позволяет инженерам-аналитикам и аналитикам данных легче ориентироваться и понимать происхождение и использование своих данных, что позволяет им принимать более обоснованные решения с большей уверенностью.
Предостережения
Особенности и ограничения Catalog
При работе с Catalog учитывайте следующие особенности и ограничения CLL.
Использование столбцов
Происхождение данных на уровне столбцов отражает связи из операторов select в SQL-коде ваших моделей. Оно не отражает другие способы использования столбцов, например в соединениях и фильтрах.
Разбор SQL
Происхождение данных на уровне столбцов определяется с помощью разбора SQL. Ошибки могут возникать, если разбор завершается сбоем или источник столбца неизвестен (например, при распаковке JSON, использовании латеральных соединений и т. п.). В таких случаях информация о происхождении данных может быть неполной, и dbt отобразит соответствующее предупреждение в представлении происхождения данных на уровне столбцов.
 Пример предупреждения в полном графе линии родословной
Чтобы просмотреть детали ошибки:
- Нажмите на значок Expand в правом верхнем углу, чтобы открыть граф линии родословной столбца.
- Выберите узел, чтобы открыть панель деталей столбца.
Возможные случаи ошибок:
- Ошибка разбора — Ошибка возникает, когда SQL является неоднозначным или слишком сложным для разбора. Примером неоднозначных сценариев разбора являются сложные боковые соединения.
- Ошибка Python — Ошибка возникает, когда в линии родословной используется модель Python. Из-за природы моделей Python невозможно разобрать и определить линию родословной.
- Неизвестная ошибка — Ошибка возникает, когда линию родословной невозможно определить по неизвестной причине. Примером этого может быть несоблюдение лучших практик dbt, например, использование жестко закодированных имен таблиц вместо операторов
ref.
