# Настройка оркестрации с учетом состояния [Закрытая предварительная версия](https://docs.getdbt.tech/docs/dbt-versions/product-lifecycles "Подробнее о статусе или тарифе")
Платформа dbt | Enterprise, Enterprise+
Настройте state-aware orchestration, чтобы автоматически определять, какие модели нужно собирать, обнаруживая изменения в коде или данных и собирая только изменившиеся модели при каждом запуске задания.
Оркестрация с учетом состояния теперь называется dbt State
[dbt State](https://docs.getdbt.tech/docs/deploy/dbt-state-about.md) работает со всеми движками и средами: dbt v1, dbt platform и dbt v2
Если вы использовали оркестрацию с учетом состояния до 1 июня 2026 года, вы можете продолжать ее использовать. Когда вы начнете бесплатный пробный период dbt State, он будет продлен сверх стандартных 30 дней. Если продление не применено к вашей учетной записи, обратитесь к команде по работе с вашим аккаунтом. Чтобы начать, ознакомьтесь с разделом [Переход с оркестрации с учетом состояния](https://docs.getdbt.tech/docs/deploy/dbt-state-migration.md).
Важно
dbt v2 доступен для установки в следующих средах:
* [Локальные инструменты командной строки (CLI)](https://docs.getdbt.tech/docs/local/install-dbt.md?version=2)
* [VS Code и Cursor с расширением dbt](https://docs.getdbt.tech/docs/install-dbt-extension.md)
* [Среды dbt platform](https://docs.getdbt.tech/docs/dbt-versions/upgrade-dbt-platform-version.md#dbt-v2)
Присоединяйтесь к обсуждению в канале [`#dbt-v2`](https://getdbt.slack.com/archives/C088YCAB6GH) в Slack сообщества dbt.
## Предварительные требования
Чтобы использовать state-aware orchestration, убедитесь, что выполнены следующие требования:
* У вас должна быть [учетная запись Enterprise или Enterprise+](https://www.getdbt.com/signup/) в dbt и [лицензия разработчика (Developer seat)](https://docs.getdbt.tech/docs/platform/manage-access/seats-and-users.md).
* Вы обновили среду, в которой будет выполняться оркестрация с учетом состояния, до dbt v2. Подробнее см. в разделе [Обновление до dbt v2](https://docs.getdbt.tech/docs/dbt-versions/dbt-upgrade/upgrading-to-v2.md).
* Ваша учетная запись должна иметь доступ к оркестрации с учетом состояния. Чтобы запросить доступ, обратитесь к менеджеру вашей учетной записи.
* У вас должен быть проект dbt, подключенный к [платформе данных](https://docs.getdbt.tech/docs/platform/connect-data-platform/about-connections.md).
* У вас должны быть [права доступа](https://docs.getdbt.tech/docs/platform/manage-access/about-user-access.md) для просмотра, создания, изменения или запуска заданий.
* Вы должны настроить [среду развертывания](https://docs.getdbt.tech/docs/deploy/deploy-environments.md) только типа production или staging.
* Вы должны использовать задание развертывания. Задания непрерывной интеграции (CI) и слияния в настоящее время не поддерживают оркестрацию с учетом состояния.
* (Необязательно) Чтобы настроить поведение, вы задали [расширенные настройки](#advanced-configurations) для своей модели или источника данных.
к сведению
State-aware orchestration доступна только для SQL‑моделей. Python‑модели не поддерживаются.
## Настройки по умолчанию
Как только вашему аккаунту станет доступна оркестрация с учетом состояния, каждое новое задание развертывания, которое вы создадите в среде dbt v2, будет автоматически учитывать состояние. Без дополнительной настройки задание собирает модели только при изменении кода или появлении новых данных в источнике.
## Создание задания
Новые задания по умолчанию учитывают состояние
Для существующих заданий выберите **Enable dbt v2 cost optimization features** на странице **Job settings**, чтобы включить оркестрацию с учетом состояния.
Чтобы создать state-aware задание:
1. На странице среды развертывания нажмите **Create job** и выберите **Deploy job**.
2. Параметры в разделе **Job settings**:
* **Job name**: Укажите имя, например `Daily build`.
* (Необязательно) **Description**: Добавьте описание того, что делает задание (например, какие данные задание использует и какие создает).
* **Environment**: По умолчанию выбрана среда развертывания, из которой вы создали задание с учетом состояния.
3. Параметры в разделах **Execution settings** и **Triggers**.
* Раздел **Execution settings**:
* **Commands**: По умолчанию содержит команду `dbt build`. Нажмите **Add command**, чтобы добавить другие [команды](https://docs.getdbt.tech/docs/deploy/job-commands.md), которые нужно вызывать при выполнении задания.
* **Enable dbt v2 cost optimization features**: Выберите этот параметр, чтобы включить **State-aware orchestration** (оркестрацию с учетом состояния). **Efficient testing** (эффективное тестирование) по умолчанию отключено. Разверните **More options**, чтобы включить или отключить отдельные настройки.
* Раздел **Triggers**:
* **Run on schedule**: Запускать задание развертывания по заданному расписанию.
* **Timing**: Укажите, как [настроить расписание](#create-a-job) задания развертывания: **Intervals** — запускать задание через заданное количество часов, **Specific hours** — запускать задание в определенное время суток или **Cron schedule** — запускать задание по расписанию, заданному с помощью [синтаксиса cron](#create-a-job).
* **Days of the week**: По умолчанию выбраны все дни недели, если для **Timing** задано **Intervals** или **Specific hours**.
* **Run when another job finishes**: Запускать задание развертывания, когда другое, *предшествующее*, [задание развертывания завершается](#create-a-job).
* **Project**: Укажите родительский проект, содержащий предшествующее задание развертывания.
* **Job**: Укажите предшествующее задание развертывания.
* **Completes on**: Выберите статусы выполнения задания, при которых задание развертывания будет [поставлено в очередь](https://docs.getdbt.tech/docs/deploy/job-scheduler.md#scheduler-queue).
6. (Необязательно) Параметры в разделе **Advanced settings**:
* **Environment variables**: Задайте [переменные среды](https://docs.getdbt.tech/docs/build/environment-variables.md), чтобы настроить поведение проекта при выполнении задания развертывания.
* **Target name**: Задайте [имя целевой конфигурации](https://docs.getdbt.tech/docs/build/custom-target-names.md), чтобы настроить поведение проекта при выполнении задания развертывания. Переменные среды и имена целевых конфигураций часто используются как взаимозаменяемые средства настройки.
* **Run timeout**: Отменять задание развертывания, если время выполнения превышает заданное время ожидания.
* **Compare changes against**: По умолчанию выбрано **No deferral**. Выберите **Environment** или **This Job**, чтобы указать dbt, с чем следует сравнивать изменения.
7. Нажмите **Save**.
В логах сводки запуска вы можете увидеть, какие модели dbt собирал. Модели, которые не были пересобраны, помечаются как **Reused** с пояснением, почему dbt пропустил их пересборку (и тем самым сэкономил вычислительные ресурсы). Также переиспользованные модели отображаются во вкладке **Reused**.
[](#)Пример логов для state-aware orchestration
[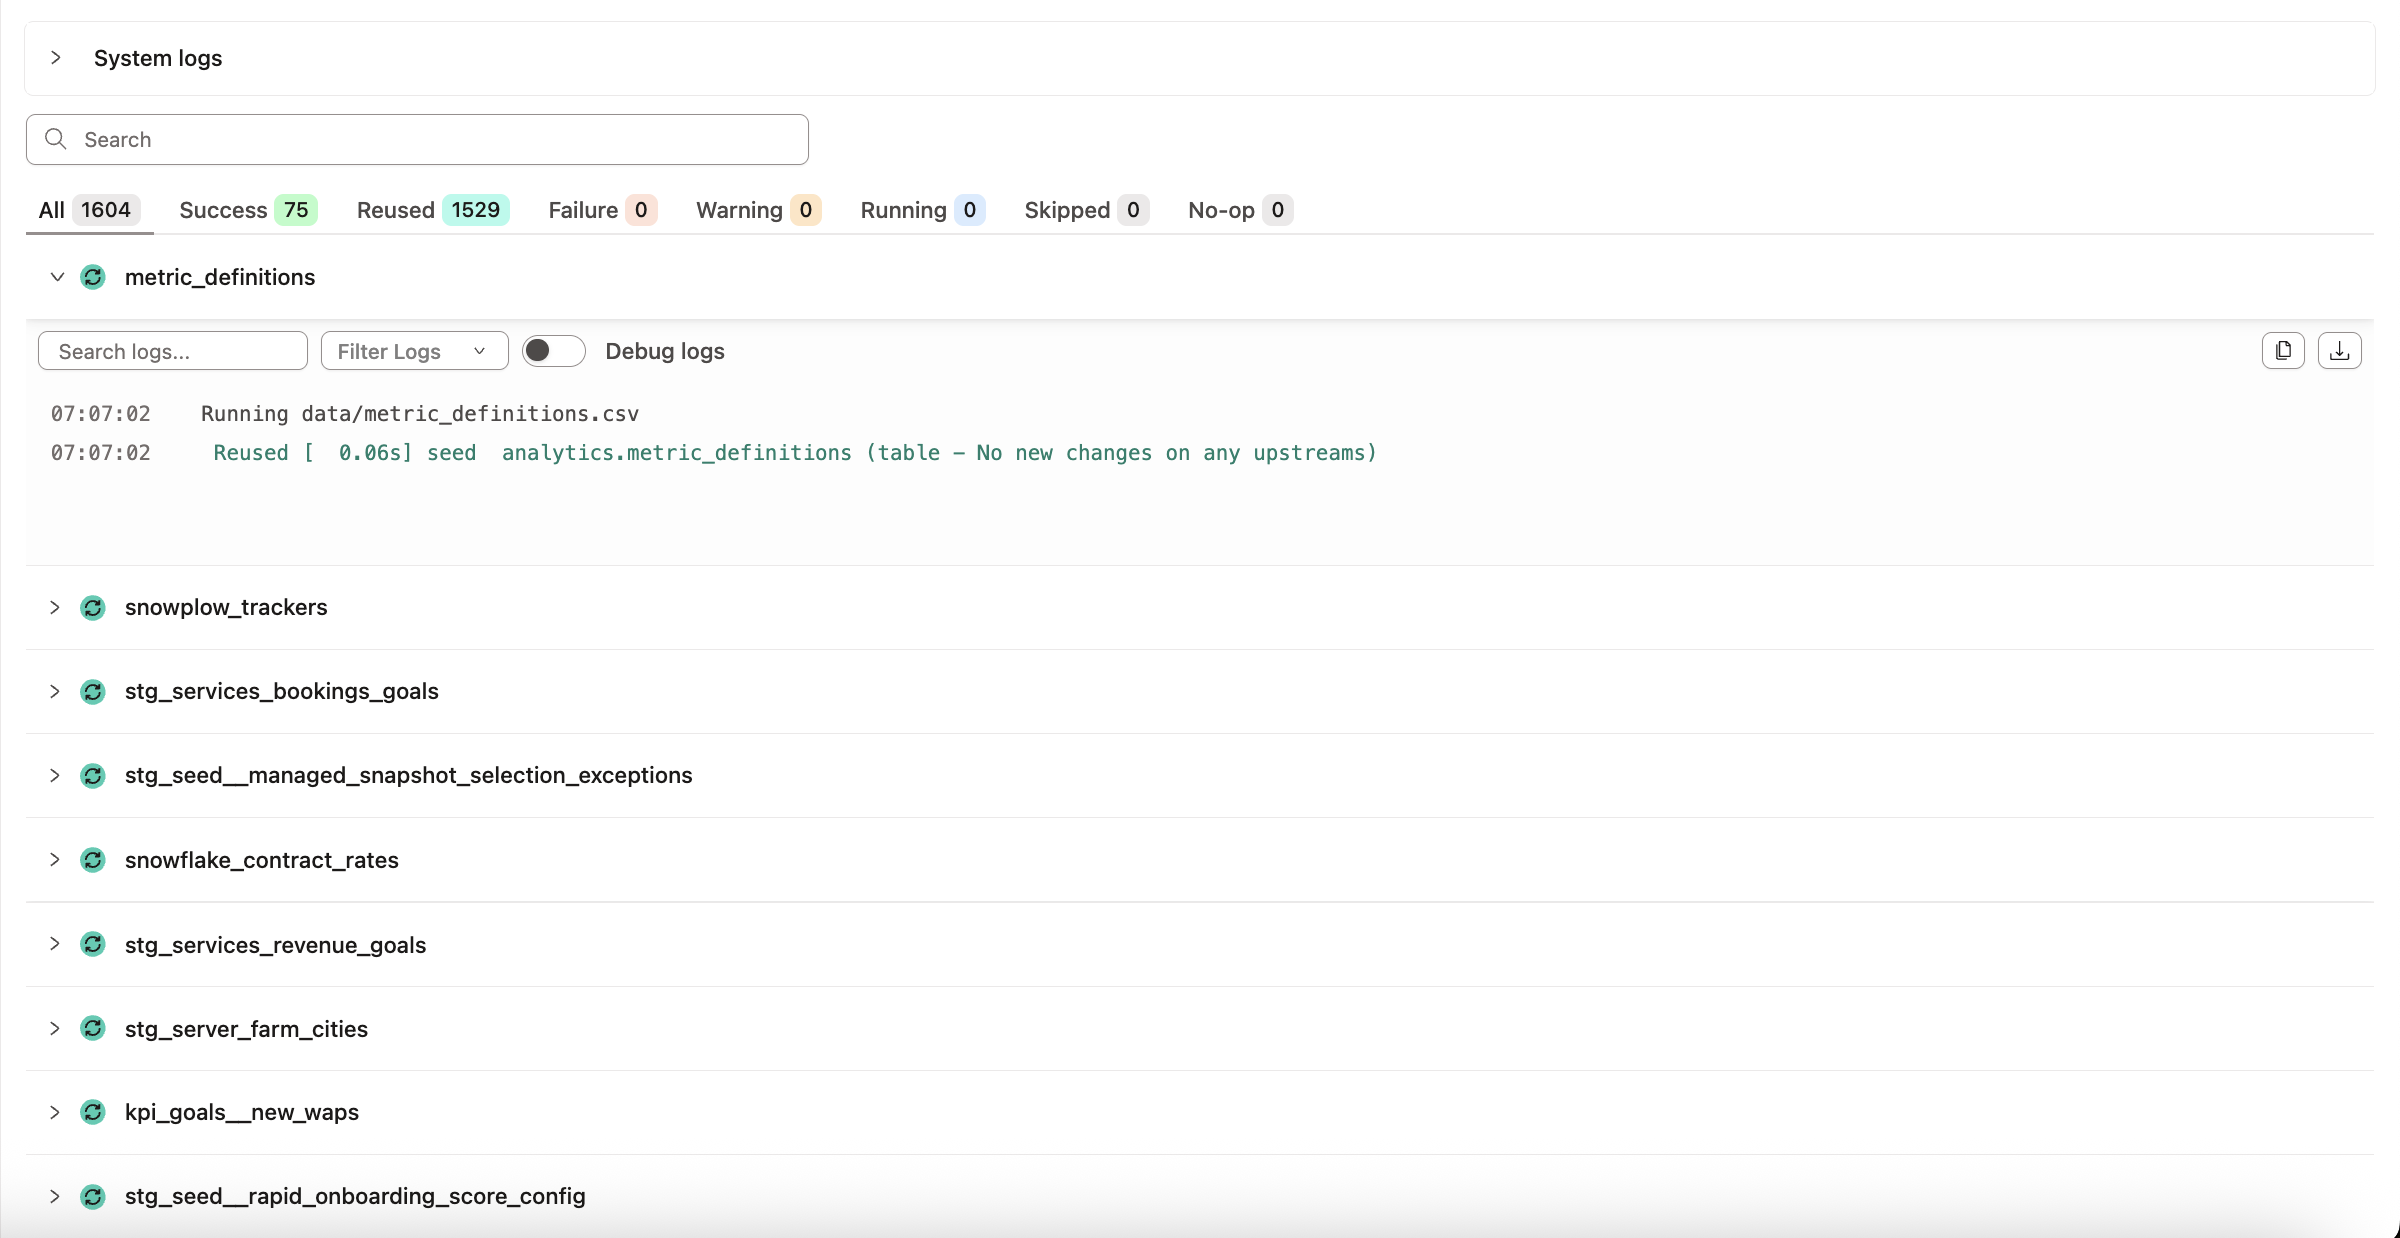](#)Пример логов для оркестрации с учетом состояния
## Удаление задания
Чтобы удалить одно или несколько заданий в dbt:
1. Нажмите **Deploy** в навигационной панели.
2. Нажмите **Jobs** и выберите задание, которое вы хотите удалить.
3. Нажмите **Settings** в правом верхнем углу страницы, затем нажмите **Edit**.
4. Прокрутите страницу вниз и нажмите **Delete job**, чтобы удалить задание.
[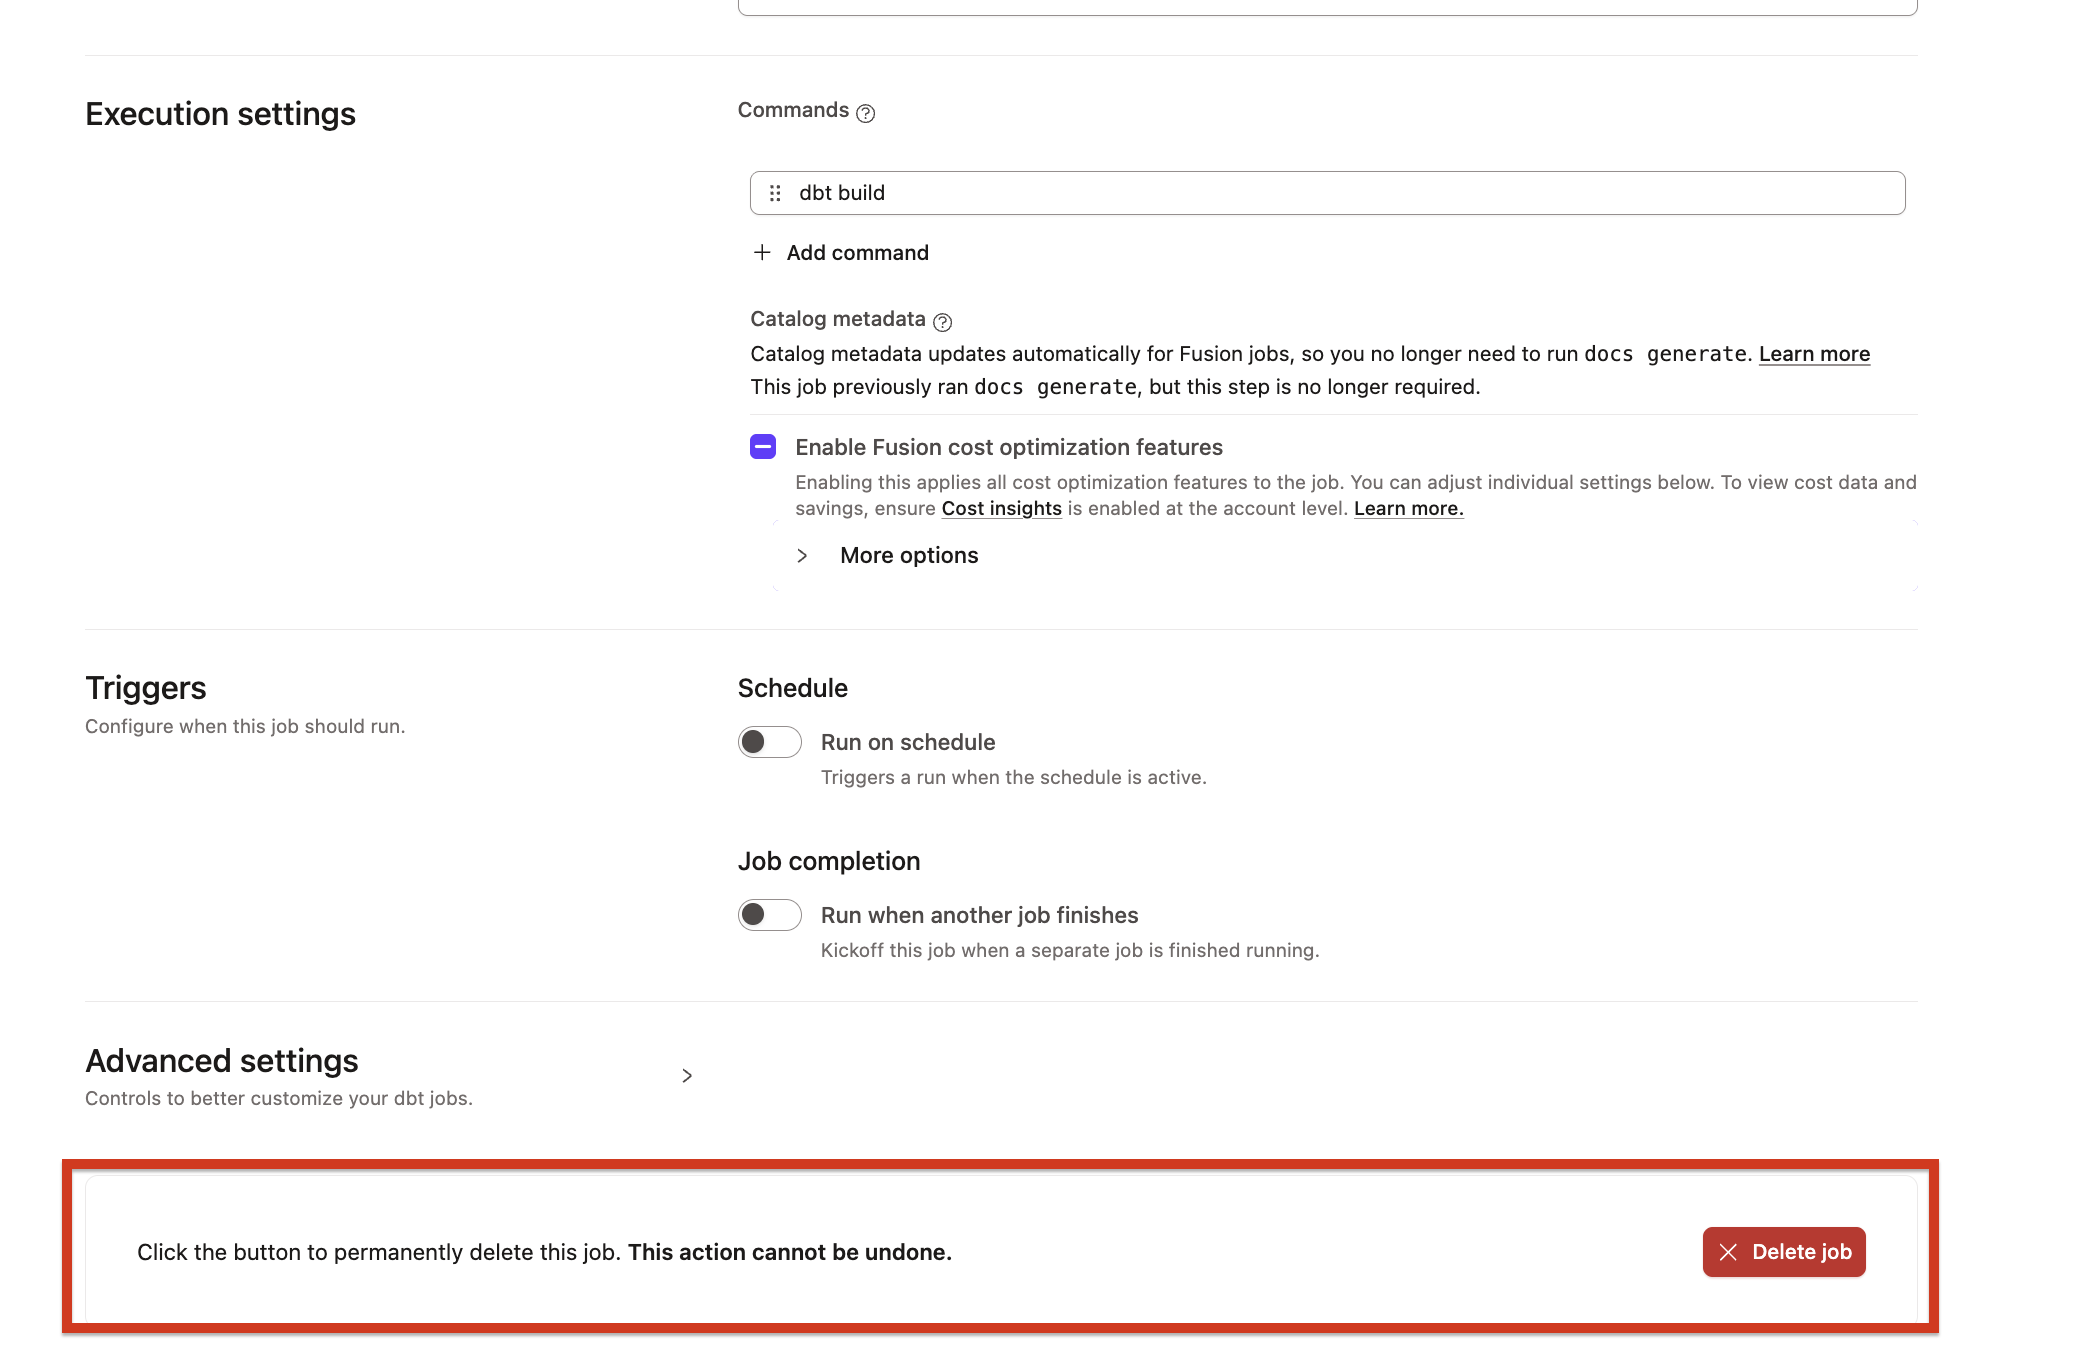](#)Delete a job
5. Подтвердите действие во всплывающем окне, нажав **Confirm delete** в правом нижнем углу, чтобы немедленно удалить задание. Это действие нельзя отменить. Однако вы можете создать новое задание с теми же параметрами, если удаление было выполнено по ошибке.
6. Обновите страницу — удалённое задание должно исчезнуть. Если вы хотите удалить несколько заданий, необходимо выполнить эти шаги для каждого задания.
Если у вас возникли какие‑либо проблемы, вы всегда можете [связаться с нами](mailto:support@getdbt.com) для получения дополнительной помощи.
## Расширенные конфигурации
По умолчанию dbt использует метаданные хранилища данных, чтобы проверять свежесть источников (или upstream‑моделей в случае Mesh). Для более сложных сценариев dbt предоставляет дополнительные возможности, позволяющие точно указать, что именно должно запускаться в рамках state-aware orchestration.
Вы можете использовать следующие необязательные параметры для настройки оркестрации с учётом состояния:
| Параметр | Описание | Допустимые значения | Поддержка Jinja |
| ------------------------ | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------- |
| `loaded_at_field` | Указывает конкретный столбец данных, который следует использовать. | Имя столбца с временной меткой. Например, `created_at`, `"CAST(created_at AS TIMESTAMP)"`. | ✅ |
| `loaded_at_query` | Определяет пользовательское условие свежести на SQL для учёта частичной загрузки или потоковых данных. | Строка SQL. Например, `"select {{ current_timestamp() }}"`. Пример многострочного запроса приведён после этой таблицы. | ✅ |
| `build_after.count` | Определяет, сколько единиц времени должно пройти, прежде чем модель можно будет построить повторно, чтобы снизить частоту построений. | Положительное целое число или выражение Jinja. Например, `4` или `"{{ var('build_after_count', 4) }}"`. | ✅ |
| `build_after.period` | Единица времени для значения count, задающая интервал между построениями. | `minute`, `hour`, `day` или выражение Jinja (например, `"{{ var('build_after_period', 'day') }}"`). | ✅ |
| `build_after.updates_on` | Определяет, запускается ли повторное построение модели при появлении свежих данных в любой вышестоящей зависимости или только тогда, когда все вышестоящие зависимости содержат свежие данные. | * `any` (по умолчанию) — Используйте это значение, если нижестоящая модель должна строиться повторно, когда *любая* из её вышестоящих зависимостей получает свежие данные, даже если остальные их ещё не получили.* `all` — Используйте это значение, если повторное построение должно запускаться только тогда, когда *все* вышестоящие зависимости содержат свежие данные, — это позволяет свести к минимуму ненужные построения и снизить затраты на вычисления. Рекомендуется для оркестрации с учётом состояния. | ❌ |
Несколько замечаний об использовании `loaded_at_field` и `loaded_at_query`:
* Можно определить либо `loaded_at_field`, либо `loaded_at_query`, но не оба параметра одновременно.
* Чтобы использовать многострочный SQL-запрос в конфигурации `loaded_at_query`, добавьте запрос в виде блока YAML, чтобы dbt мог выполнить его как пользовательский запрос проверки свежести. Например:
```yaml
loaded_at_query: |
select max(ingested_at)
from {{ this }}
where ingested_at >= current_timestamp - interval '3 days'
```
* Если источник представляет собой представление в хранилище данных, доступных метаданных обычно недостаточно для определения свежести, и dbt выдаёт предупреждение при проверках свежести. Чтобы определять свежесть источников, являющихся представлениями, добавьте в конфигурацию `loaded_at_field` или `loaded_at_query`.
Подробнее о свежести моделей и `build_after` см. в разделе [конфигурация `freshness` для моделей](https://docs.getdbt.tech/reference/resource-configs/freshness.md). Подробнее о настройках свежести источников и вышестоящих моделей см. в разделе [конфигурация `freshness` для ресурсов](https://docs.getdbt.tech/reference/resource-configs/freshness.md).
### Настройка поведения
При необходимости вы можете дополнительно настроить state-aware orchestration, чтобы более точно управлять поведением оркестрации:
* **Определение свежести источников**
По умолчанию dbt использует метаданные из хранилища данных, чтобы автоматически определять изменения в исходных данных. Для работы оркестрации с учетом состояния настройка свежести данных не требуется.
При необходимости вы можете настроить свежесть источников, чтобы:
* Получать оповещения, когда источники не обновляются в сроки, предусмотренные вашим соглашением об уровне обслуживания (SLA), с помощью `warn_after`/`error_after`.
* Указать пользовательский столбец с помощью `loaded_at_field`.
* Указать пользовательский SQL-запрос с помощью `loaded_at_query`, чтобы определить критерии свежести данных.
Свежесть источников может существенно различаться — особенно при частичных пайплайнах загрузки. Возможно, вам нужно отложить сборку модели до тех пор, пока в источники не поступит больший объём данных или пока не пройдёт определённое время.
Вы можете определить понятие «свежести» отдельно для каждого источника с помощью пользовательского запроса, что позволяет:
* Учитывать задержки поступления данных
* Откладывать определение свежести до достижения порога (например, по количеству записей или часов данных)
Следующие примеры показывают, как настроить источник, чтобы оркестрация с учетом состояния обнаруживала новые данные в вышестоящих источниках только при выполнении заданного вами условия.
### loaded\_at\_field
Оркестрация с учетом состояния считает данные источника свежими, когда максимальное значение столбца `loaded_at_field` изменяется по сравнению с предыдущим запуском:
models/sources.yml
```yaml
sources:
- name: jaffle_shop
config:
freshness:
warn_after: {count: 12, period: hour}
error_after: {count: 24, period: hour}
loaded_at_field: _etl_loaded_at
```
### loaded\_at\_query
Чтобы определить свежесть данных с помощью собственного SQL-запроса, используйте `loaded_at_query`. Оркестрация с учетом состояния выполняет запрос, чтобы получить единственную временную метку. Когда это значение изменяется по сравнению с предыдущим запуском, данные источника считаются свежими.
models/sources.yml
```yaml
sources:
- name: raw_orders
tables:
- name: orders
loaded_at_query: |
select max(ingested_at)
from {{ this }}
where ingested_at >= current_timestamp - interval '3 days'
```
В этом примере dbt выполняет пользовательский запрос `loaded_at_query`, чтобы получить единственную временную метку — самое позднее значение `ingested_at` за последние три дня. При каждом запуске dbt сравнивает эту новую максимальную временную метку со значением из предыдущего запуска. Если максимальная временная метка новее, оркестрация с учетом состояния считает, что источник содержит свежие данные, и может инициировать повторную сборку моделей.
* **Снижение частоты сборки моделей**
Некоторым моделям не требуется пересборка при каждом обновлении источников. Для этого можно:
* Задать интервал обновления для моделей, папок или всего проекта
* Избежать избыточных сборок и снизить затраты, запуская только действительно нужные процессы
* **Изменение поведения с `any` на `all`**
В зависимости от upstream‑зависимостей модели может быть предпочтительно дождаться обновления всех upstream‑моделей, а не начинать сборку при появлении любых новых данных.
* Измените ожидание оркестрации с `any` на `all` для моделей, папок или всего проекта
* Это помогает избежать лишних сборок и снижает затраты
Для настройки поведения используйте конфигурацию `build_after` в следующих местах:
* `dbt_project.yml` — на уровне проекта в YAML
* `model/properties.yml` — на уровне модели в YAML
* `model/model.sql` — на уровне модели в SQL Эти настройки дают широкие возможности: вы можете задать разумное значение по умолчанию на уровне проекта или для отдельных папок с моделями, а затем переопределить его для отдельных моделей или групп моделей, которым требуются более частые обновления.
### Обработка данных, поступающих с задержкой
Если ваши инкрементальные модели используют окно ретроспективного просмотра для обработки [данных, поступающих с задержкой](https://docs.getdbt.tech/best-practices/materializations/4-incremental-models.md#late-arriving-facts), убедитесь, что логика проверки свежести данных согласована с этим окном.
При использовании `loaded_at_field` или `loaded_at_query` оркестрация с учётом состояния использует это значение, чтобы определить, поступили ли новые данные. Если значение `loaded_at` отражает временную метку события (например, `event_date`), записи, поступившие с задержкой, могут не изменить это значение, если событие произошло в прошлом. В таких случаях оркестрация с учётом состояния может не запустить повторное построение, хотя окно ретроспективного просмотра вашей инкрементальной модели обычно включало бы эти строки.
Чтобы оркестрация с учётом состояния обнаруживала данные, поступающие с задержкой, используйте `loaded_at_query` и убедитесь, что этот запрос согласован с тем же окном ретроспективного просмотра, которое используется в вашем инкрементальном фильтре. Ниже приведены примеры окна ретроспективного просмотра и соответствующего значения `loaded_at_query`:
### Окно ретроспективного просмотра
```sql
{{
config(
materialized='incremental',
unique_key='order_id'
)
}}
select * from {{ source('raw_orders', 'orders') }}
{% if is_incremental() %}
where
ingested_at > (select max(ingested_at) from {{ this }}) - interval '3 days'
{% endif %}
```
### loaded\_at\_query
```yaml
loaded_at_query: |
select max(ingested_at)
from {{ this }}
where ingested_at >= current_timestamp - interval '3 days'
```
## Пример
Эти настройки удобны тем, что позволяют задать разумное значение по умолчанию для проекта или папок моделей и при необходимости переопределить его для отдельных моделей или групп.
Сеть Jaffle shop недавно вышла на международный рынок и захотела сократить расходы. В поисках способов экономии команда узнала об оркестрации с учетом состояния в dbt и решила пересобирать модели только при необходимости. Мэгги — инженер по аналитике — хочет настроить свой проект dbt `jaffle_shop` так, чтобы определенные модели пересобирались только в том случае, если они не обновлялись в течение последних 4 часов, даже если задание запускается чаще.
Рассмотрим пример, показывающий, как настроить проект так, чтобы модель и её родительская модель пересобирались только в том случае, если они не обновлялись в течение последних 4 часов — даже если задание запускается чаще.
Магазин Jaffle недавно расширился на глобальный рынок и решил сократить расходы. Чтобы снизить затраты, команда узнала о state-aware orchestration в и решила пересобирать модели только при необходимости. Maggie — analytics engineer — хочет настроить dbt‑проект `jaffle_shop` так, чтобы определённые модели пересобирались только если они не обновлялись последние 4 часа, даже если задание запускается чаще.
Для этого она использует конфигурацию `freshness` у модели. Эта настройка помогает state-aware orchestration определить, *когда* модель должна быть пересобрана.
Обратите внимание: для каждой настройки `freshness` необходимо указать оба значения — `count` и `period`. Это относится ко всем типам `freshness`: `freshness.warn_after`, `freshness.error_after` и `freshness.build_after`.
Ниже приведены примеры использования `freshness` в файле модели, в YAML‑файле проекта и в блоке `config` внутри `model.sql`:
### Model YAML
models/model.yml
```yaml
models:
- name: dim_wizards
config:
freshness:
build_after:
count: 4 # сколько ждать перед пересборкой
period: hour # единица времени
updates_on: all # пересобирать только если у всех upstream-зависимостей есть новые данные
- name: dim_worlds
config:
freshness:
build_after:
count: 4
period: hour
updates_on: all
```
### Project YAML file
dbt\_project.yml
```yaml
models:
:
+freshness:
build_after:
count: 4
period: hour
updates_on: all
```
### SQL file config
models/\.sql
```jinja
{{
config(
freshness={
"build_after": {
"count": 4,
"period": "hour",
"updates_on": "all"
}
}
)
}}
```
С такой конфигурацией dbt:
* Проверяет наличие новых данных в upstream‑источниках
* Проверяет, когда `dim_wizards` и `dim_worlds` собирались в последний раз
Если доступны новые данные *и* прошло не менее 4 часов, dbt перестраивает модели.
Вы можете переопределять правила свежести, заданные на более высоком уровне проекта. Например, если в YAML‑файле проекта указано:
dbt\_project.yml
```yml
models:
+freshness:
build_after:
count: 4
period: hour
jaffle_shop: # this needs to match your project `name:` in dbt_project.yml
staging:
+materialized: view
marts:
+materialized: table
```
Это означает, что для каждой модели в проекте установлен `build_after` равный 4 часам. Чтобы изменить это для отдельных моделей или групп, можно задать:
dbt\_project.yml
```yml
models:
+freshness:
build_after:
count: 4
period: hour
marts: # only applies to models inside the marts folder
+freshness:
build_after:
count: 1
period: hour
```
Если вы хотите исключить модель из правила свежести, заданного на более высоком уровне, установите `freshness: null` для этой модели. При отключённой свежести state-aware orchestration возвращается к поведению по умолчанию и собирает модель при любом изменении кода или данных upstream.
### Различия между `all` и `any`
* Так как Maggie настроила `updates_on: all`, это означает, что *обе* модели должны иметь новые upstream‑данные, чтобы запустить пересборку. Если свежие данные есть только у одной модели, сборка не произойдёт — что значительно снижает вычислительные затраты и экономит время.
* Если бы Maggie хотела пересобирать модели чаще (например, когда *любой* upstream‑источник обновился), она могла бы использовать `updates_on: any`:
models/model.yml
```yaml
freshness:
build_after:
count: 1
period: hour
updates_on: any
```
В этом случае, если у `dim_wizards` или `dim_worlds` появятся свежие upstream‑данные и пройдёт достаточно времени, dbt пересоберёт модели. Такой подход полезен, когда актуальность данных важнее стоимости вычислений.
## Связанная документация
* [Конфигурация state-aware orchestration](https://docs.getdbt.tech/docs/deploy/state-aware-about.md)
* [Артефакты](https://docs.getdbt.tech/docs/deploy/artifacts.md)
* [Jobs непрерывной интеграции (CI)](https://docs.getdbt.tech/docs/deploy/ci-jobs.md)
* [`freshness`](https://docs.getdbt.tech/reference/resource-configs/freshness.md)
* [О dbt State](https://docs.getdbt.tech/docs/deploy/dbt-state-about.md)
* [Настройка dbt State](https://docs.getdbt.tech/docs/deploy/dbt-state-setup.md)
* [Параметры dbt State](https://docs.getdbt.tech/reference/resource-configs/dbt-state-configs.md)
* [Migrate to dbt State](https://docs.getdbt.tech/docs/deploy/dbt-state-migration.md)