Сценарии использования и примеры для Discovery API
С помощью Discovery API вы можете запрашивать метаданные в dbt, чтобы лучше узнать о своих развёртываниях dbt и данных, которые они генерируют, — для их анализа и последующего улучшения.
Вы можете использовать API различными способами, чтобы получить ответы на ваши бизнес-вопросы. Ниже описаны некоторые из способов использования API, чтобы дать вам представление о вопросах, на которые этот API может помочь ответить.
| Loading table... |
Производительность
Вы можете использовать Discovery API для выявления неэффективностей в выполнении конвейера, чтобы снизить затраты на инфраструктуру и улучшить своевременность. Ниже приведены примеры вопросов и запросов, которые вы можете выполнить.
Для задач, связанных с производительностью, обычно выполняют запросы к историческому или последнему применённому состоянию по любой части DAG (например, моделям), используя эндпоинты environment, modelHistoricalRuns или эндпоинты уровня job.
Сколько времени заняло выполнение каждой модели?
Полезно понять, сколько времени требуется для построения моделей (таблиц) и выполнения тестов во время выполнения dbt. Более длительное время построения моделей приводит к более высоким затратам на инфраструктуру и более позднему поступлению свежих данных к заинтересованным сторонам. Такие анализы могут проводиться в инструментах наблюдаемости или в ad-hoc запросах, например, в блокноте.
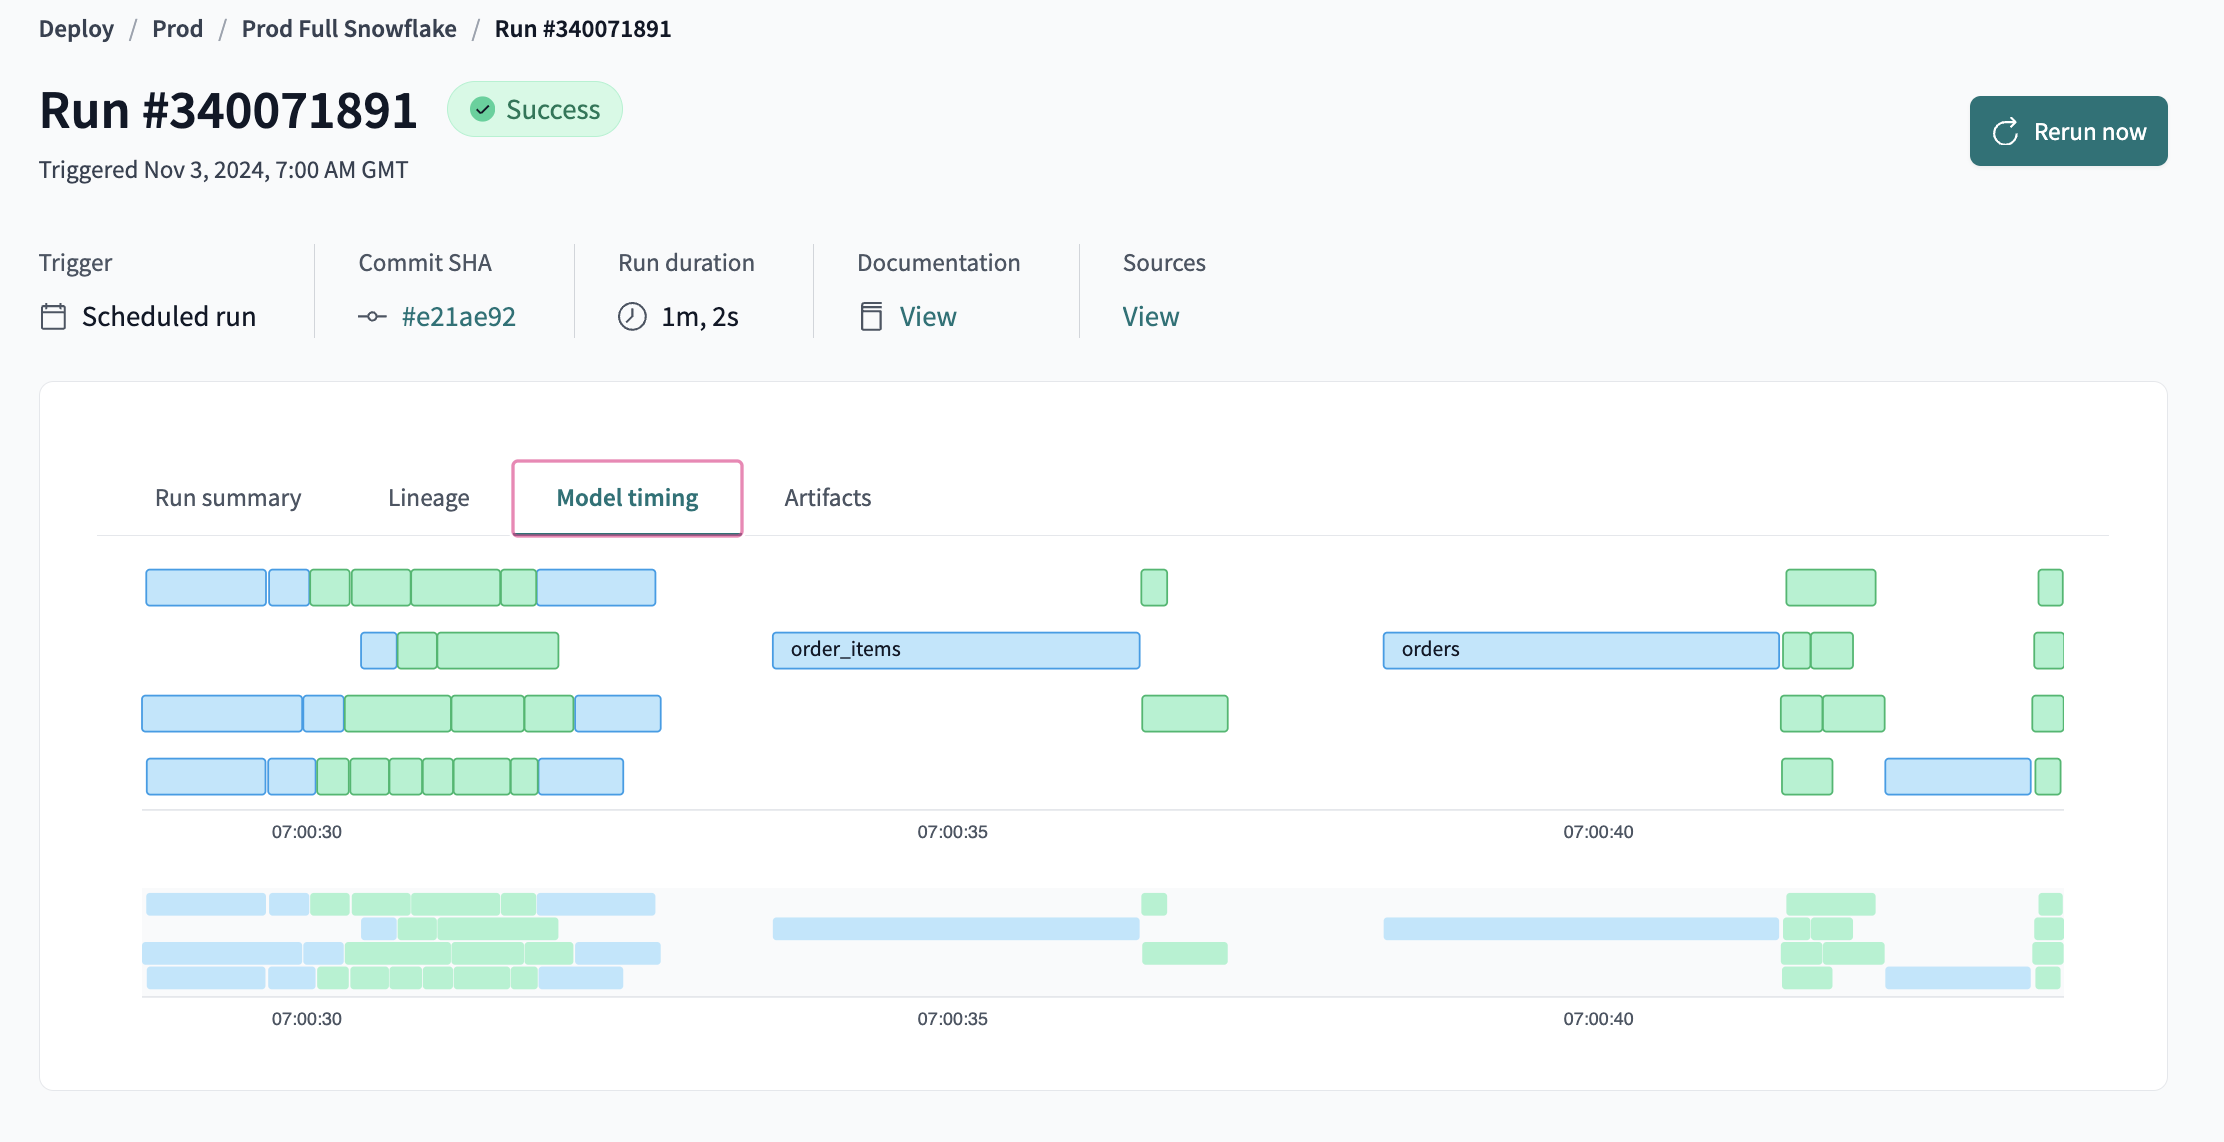 Визуализация времени выполнения моделей в dbt
Пример запроса с кодом
Команды данных могут отслеживать производительность своих моделей, выявлять узкие места и оптимизировать общий конвейер данных, получая такие детали выполнения, как executionTime и runElapsedTime:
- Используйте API на уровне последнего состояния окружения, чтобы получить список всех выполненных моделей и их время выполнения. Затем отсортируйте модели по
executionTimeв порядке убывания.
query AppliedModels($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first) {
        edges {
          node {
            name
            uniqueId
            materializedType
            executionInfo {
              lastSuccessRunId
              executionTime
              executeStartedAt
            }
          }
        }
      }
    }
  }
}
- Получите последние 20 результатов выполнения для самой длительно выполняемой модели. Просмотрите результаты модели по выполненным запускам или перейдите к самому заданию/запуску или коммиту для дальнейшего исследования.
query ModelHistoricalRuns(
  $environmentId: BigInt!
  $uniqueId: String
  $lastRunCount: Int
) {
  environment(id: $environmentId) {
    applied {
      modelHistoricalRuns(
        uniqueId: $uniqueId
        lastRunCount: $lastRunCount
      ) {
        name
        runId
        runElapsedTime
        runGeneratedAt
        executionTime
        executeStartedAt
        executeCompletedAt
        status
      }
    }
  }
}
- Используйте результаты запроса для построения графика исторического времени выполнения и трендов времени выполнения самой длительно выполняемой модели.
# Импорт библиотек
import os
import matplotlib.pyplot as plt
import pandas as pd
import requests

# Установите API-ключ
auth_token = *[SERVICE_TOKEN_HERE]*

# Запросите API
def query_discovery_api(auth_token, gql_query, variables):
    response = requests.post('https://metadata.cloud.getdbt.com/graphql',
        headers={"authorization": "Bearer "+auth_token, "content-type": "application/json"},
        json={"query": gql_query, "variables": variables})
    data = response.json()['data']

    return data

# Получите последние метаданные выполнения для всех моделей
models_latest_metadata = query_discovery_api(auth_token, query_one, variables_query_one)['environment']

# Преобразуйте в dataframe
models_df = pd.DataFrame([x['node'] for x in models_latest_metadata['applied']['models']['edges']])

# Разверните столбец executionInfo
models_df = pd.concat([models_df.drop(['executionInfo'], axis=1), models_df['executionInfo'].apply(pd.Series)], axis=1)

# Отсортируйте модели по времени выполнения
models_df_sorted = models_df.sort_values('executionTime', ascending=False)

print(models_df_sorted)

# Получите uniqueId самой длительно выполняемой модели
longest_running_model = models_df_sorted.iloc[0]['uniqueId']

# Определите переменные второго запроса
variables_query_two = {
    "environmentId": *[ENVR_ID_HERE]*
    "lastRunCount": 10,
    "uniqueId": longest_running_model
}

# Получите исторические метаданные выполнения для самой длительно выполняемой модели
model_historical_metadata = query_discovery_api(auth_token, query_two, variables_query_two)['environment']['applied']['modelHistoricalRuns']

# Преобразуйте в dataframe
model_df = pd.DataFrame(model_historical_metadata)

# Отфильтруйте dataframe, оставив только успешные выполнения
model_df = model_df[model_df['status'] == 'success']

# Преобразуйте столбцы runGeneratedAt, executeStartedAt и executeCompletedAt в datetime
model_df['runGeneratedAt'] = pd.to_datetime(model_df['runGeneratedAt'])
model_df['executeStartedAt'] = pd.to_datetime(model_df['executeStartedAt'])
model_df['executeCompletedAt'] = pd.to_datetime(model_df['executeCompletedAt'])

# Постройте график runElapsedTime по времени
plt.plot(model_df['runGeneratedAt'], model_df['runElapsedTime'])
plt.title('Run Elapsed Time')
plt.show()

# Постройте график executionTime по времени
plt.plot(model_df['executeStartedAt'], model_df['executionTime'])
plt.title(model_df['name'].iloc[0]+" Execution Time")
plt.show()
Примеры графиков:
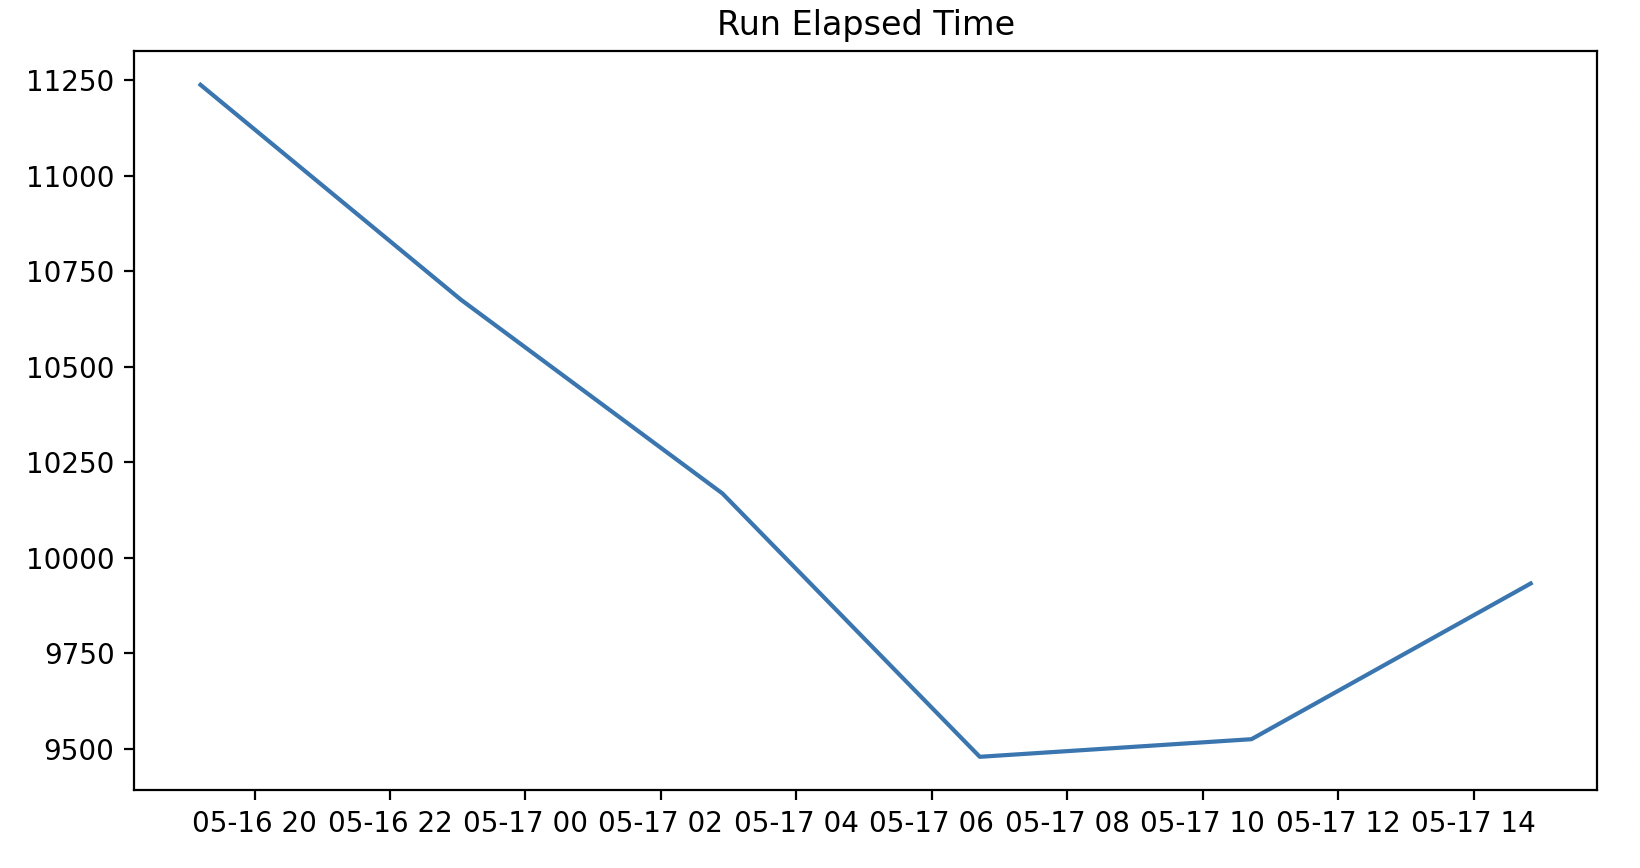 График runElapsedTime по времени
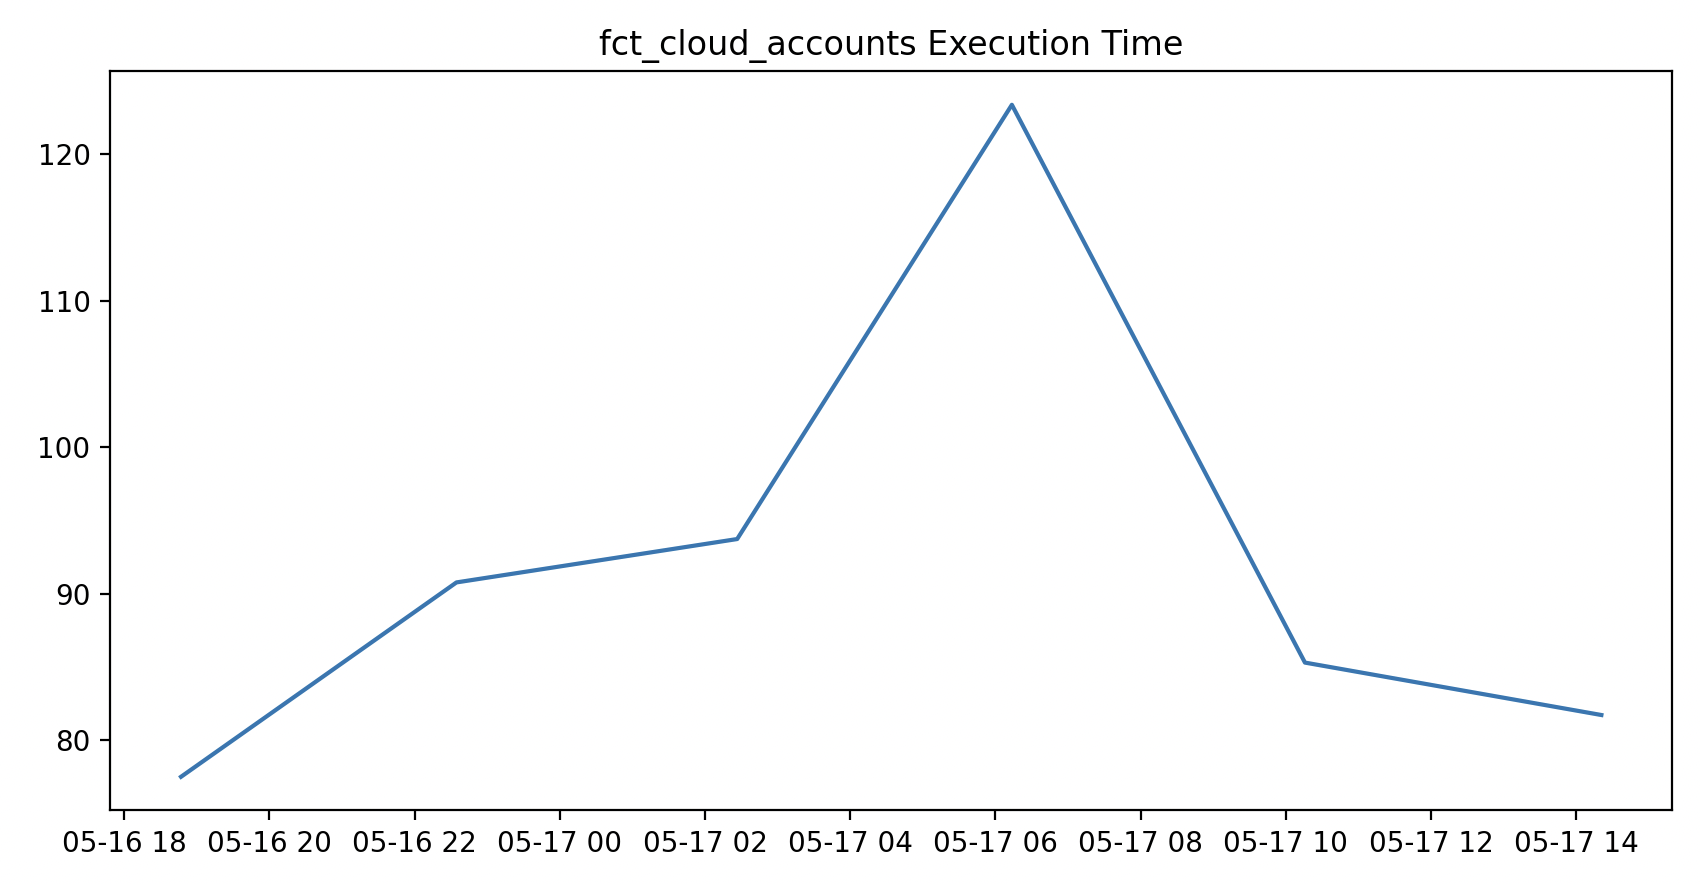 График executionTime по времени
Каково последнее состояние каждой модели?
Discovery API предоставляет информацию о примененном состоянии моделей и о том, как они достигли этого состояния. Вы можете получить информацию о статусе из последнего выполнения и последнего успешного выполнения (execution) из конечной точки environment и углубиться в исторические выполнения, используя конечные точки на основе заданий и modelByEnvironment.
Пример запроса
API возвращает полную информацию об идентификаторе (database.schema.alias) и executionInfo как для последнего выполнения, так и для последнего успешного выполнения из базы данных:
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first) {
        edges {
          node {
            uniqueId
            compiledCode
            database
            schema
            alias
            materializedType
            executionInfo {
              executeCompletedAt
              lastJobDefinitionId
              lastRunGeneratedAt
              lastRunId
              lastRunStatus
              lastRunError
              lastSuccessJobDefinitionId
              runGeneratedAt
              lastSuccessRunId
            }
          }
        }
      }
    }
  }
}
Что произошло с моим выполнением задания?
Вы можете запросить метаданные на уровне задания, чтобы просмотреть результаты для конкретных выполнений. Это полезно для исторического анализа производительности развертывания или оптимизации конкретных заданий.
Пример запроса
Устаревший пример:
query ($jobId: Int!, $runId: Int!) {
  models(jobId: $jobId, runId: $runId) {
    name
    status
    tests {
      name
      status
    }
  }
}
Новый пример:
query ($jobId: BigInt!, $runId: BigInt!) {
  job(id: $jobId, runId: $runId) {
    models {
      name
      status
      tests {
        name
        status
      }
    }
  }
}
Что изменилось с последнего выполнения?
Ненужные выполнения увеличивают затраты на инфраструктуру и нагрузку на команду данных и их системы. Модель не нужно запускать, если это представление и нет изменений в коде с момента последнего выполнения, или если это таблица/инкрементальная модель без изменений в коде с момента последнего выполнения и исходные данные не были обновлены с момента последнего выполнения.
Пример запроса
С помощью API вы можете сравнить rawCode между определением и примененным состоянием и просмотреть, когда источники были загружены в последний раз (source maxLoadedAt относительно модели executeCompletedAt) с учетом materializedType модели:
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(
        first: $first
        filter: { uniqueIds: "MODEL.PROJECT.MODEL_NAME" }
      ) {
        edges {
          node {
            rawCode
            ancestors(types: [Source]) {
              ... on SourceAppliedStateNestedNode {
                freshness {
                  maxLoadedAt
                }
              }
            }
            executionInfo {
              runGeneratedAt
              executeCompletedAt
            }
            materializedType
          }
        }
      }
    }
    definition {
      models(
        first: $first
        filter: { uniqueIds: "MODEL.PROJECT.MODEL_NAME" }
      ) {
        edges {
          node {
            rawCode
            runGeneratedAt
            materializedType
          }
        }
      }
    }
  }
}
Качество
Вы можете использовать Discovery API для мониторинга свежести источников данных и результатов тестов, чтобы диагностировать и решать проблемы и повышать доверие к данным. При использовании с вебхуками это также может помочь в обнаружении, расследовании и оповещении о проблемах. Ниже приведены примеры вопросов, на которые API может помочь ответить. Ниже приведены примеры вопросов и запросов, которые вы можете выполнить.
Для сценариев использования, связанных с качеством, обычно запрашивают историческое или последнее примененное состояние, часто в верхней части DAG (например, источники), используя конечные точки environment или environment { applied { modelHistoricalRuns } }.
Какие модели и тесты не прошли выполнение?
Фильтруя по последнему статусу, вы можете получить списки моделей, которые не удалось построить, и тестов, которые не прошли во время их последнего выполнения. Это полезно при диагностике проблем с развертыванием, которые приводят к задержке или некорректным данным.
Пример запроса с кодом
- Получите последние результаты выполнения по всем заданиям в окружении и верните только модели и тесты, которые завершились с ошибкой/неудачей.
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first, filter: { lastRunStatus: error }) {
        edges {
          node {
            name
            executionInfo {
              lastRunId
            }
          }
        }
      }
      tests(first: $first, filter: { status: "fail" }) {
        edges {
          node {
            name
            executionInfo {
              lastRunId
            }
          }
        }
      }
    }
  }
}
- Просмотрите историческое выполнение и частоту отказов тестов (до 20 запусков) для данной модели, например, часто используемого и важного набора данных.
query ($environmentId: BigInt!, $uniqueId: String!, $lastRunCount: Int) {
  environment(id: $environmentId) {
    applied {
      modelHistoricalRuns(uniqueId: $uniqueId, lastRunCount: $lastRunCount) {
        name
        executeStartedAt
        status
        tests {
          name
          status
        }
      }
    }
  }
}
- Определите выполнения и постройте графики исторических трендов частоты отказов/ошибок.
Когда данные, используемые моей моделью, были обновлены в последний раз?
Вы можете получить метаданные о последнем выполнении для конкретной модели или по всем моделям в вашем проекте. Например, исследуйте, когда каждая модель или снимок, которые питают данную модель, были выполнены в последний раз или когда источник или семя были загружены в последний раз, чтобы оценить свежесть данных.
Пример запроса с кодом
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(
        first: $first
        filter: { uniqueIds: "MODEL.PROJECT.MODEL_NAME" }
      ) {
        edges {
          node {
            name
            ancestors(types: [Model, Source, Seed, Snapshot]) {
              ... on ModelAppliedStateNestedNode {
                name
                resourceType
                materializedType
                executionInfo {
                  executeCompletedAt
                }
              }
              ... on SourceAppliedStateNestedNode {
                sourceName
                name
                resourceType
                freshness {
                  maxLoadedAt
                }
              }
              ... on SnapshotAppliedStateNestedNode {
                name
                resourceType
                executionInfo {
                  executeCompletedAt
                }
              }
              ... on SeedAppliedStateNestedNode {
                name
                resourceType
                executionInfo {
                  executeCompletedAt
                }
              }
            }
          }
        }
      }
    }
  }
}
# Извлечение узлов графа из ответа
def extract_nodes(data):
    models = []
    sources = []
    groups = []
    for model_edge in data["applied"]["models"]["edges"]:
        models.append(model_edge["node"])
    for source_edge in data["applied"]["sources"]["edges"]:
        sources.append(source_edge["node"])
    for group_edge in data["definition"]["groups"]["edges"]:
        groups.append(group_edge["node"])
    models_df = pd.DataFrame(models)
    sources_df = pd.DataFrame(sources)
    groups_df = pd.DataFrame(groups)

    return models_df, sources_df, groups_df

# Построение графа родословной со свежестью
def create_freshness_graph(models_df, sources_df):
    G = nx.DiGraph()
    current_time = datetime.now(timezone.utc)
    for _, model in models_df.iterrows():
        max_freshness = pd.Timedelta.min
        if "meta" in models_df.columns:
          freshness_sla = model["meta"]["freshness_sla"]
        else:
          freshness_sla = None
        if model["executionInfo"]["executeCompletedAt"] is not None:
          model_freshness = current_time - pd.Timestamp(model["executionInfo"]["executeCompletedAt"])
          for ancestor in model["ancestors"]:
              if ancestor["resourceType"] == "SourceAppliedStateNestedNode":
                  ancestor_freshness = current_time - pd.Timestamp(ancestor["freshness"]['maxLoadedAt'])
              elif ancestor["resourceType"] == "ModelAppliedStateNestedNode":
                  ancestor_freshness = current_time - pd.Timestamp(ancestor["executionInfo"]["executeCompletedAt"])

              if ancestor_freshness > max_freshness:
                  max_freshness = ancestor_freshness

          G.add_node(model["uniqueId"], name=model["name"], type="model", max_ancestor_freshness = max_freshness, freshness = model_freshness, freshness_sla=freshness_sla)
    for _, source in sources_df.iterrows():
        if source["maxLoadedAt"] is not None:
          G.add_node(source["uniqueId"], name=source["name"], type="source", freshness=current_time - pd.Timestamp(source["maxLoadedAt"]))
    for _, model in models_df.iterrows():
        for parent in model["parents"]:
            G.add_edge(parent["uniqueId"], model["uniqueId"])

    return G
Пример графа:
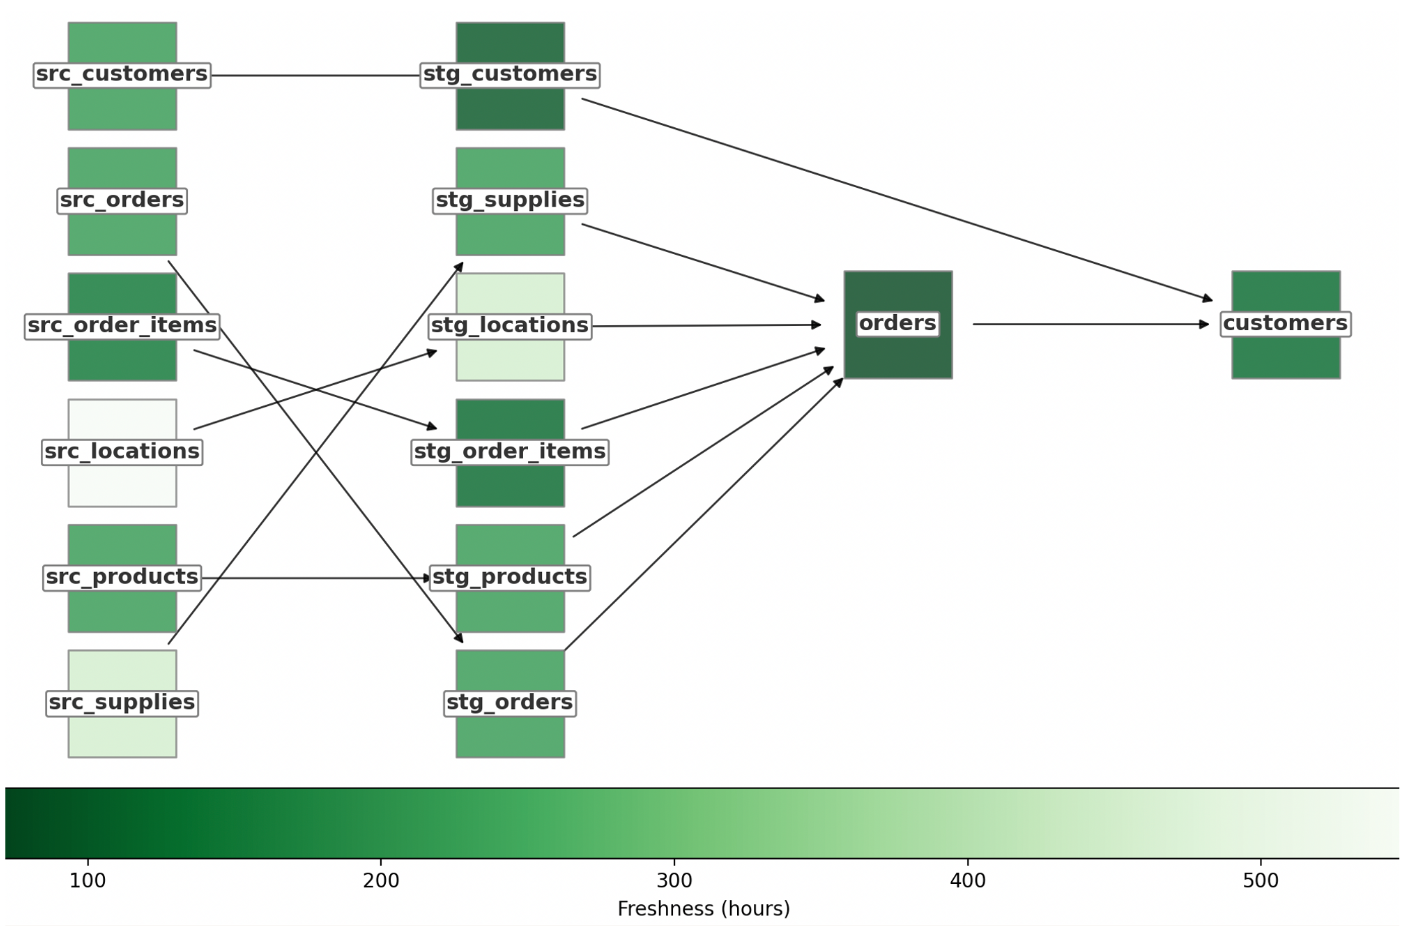 Граф родословной с информацией о свежести источников
Свежи ли мои источники данных?
Проверка свежести источников позволяет убедиться, что источники, загруженные и используемые в вашем проекте dbt, соответствуют ожиданиям. API предоставляет последние метаданные о загрузке источников и информацию о критериях проверки свежести.
Проверка source freshness позволяет убедиться, что источники данных, загружаемые и используемые в вашем проекте dbt, соответствуют заданным ожиданиям. API предоставляет актуальные метаданные о загрузке источников, а также информацию о критериях проверки свежести данных.
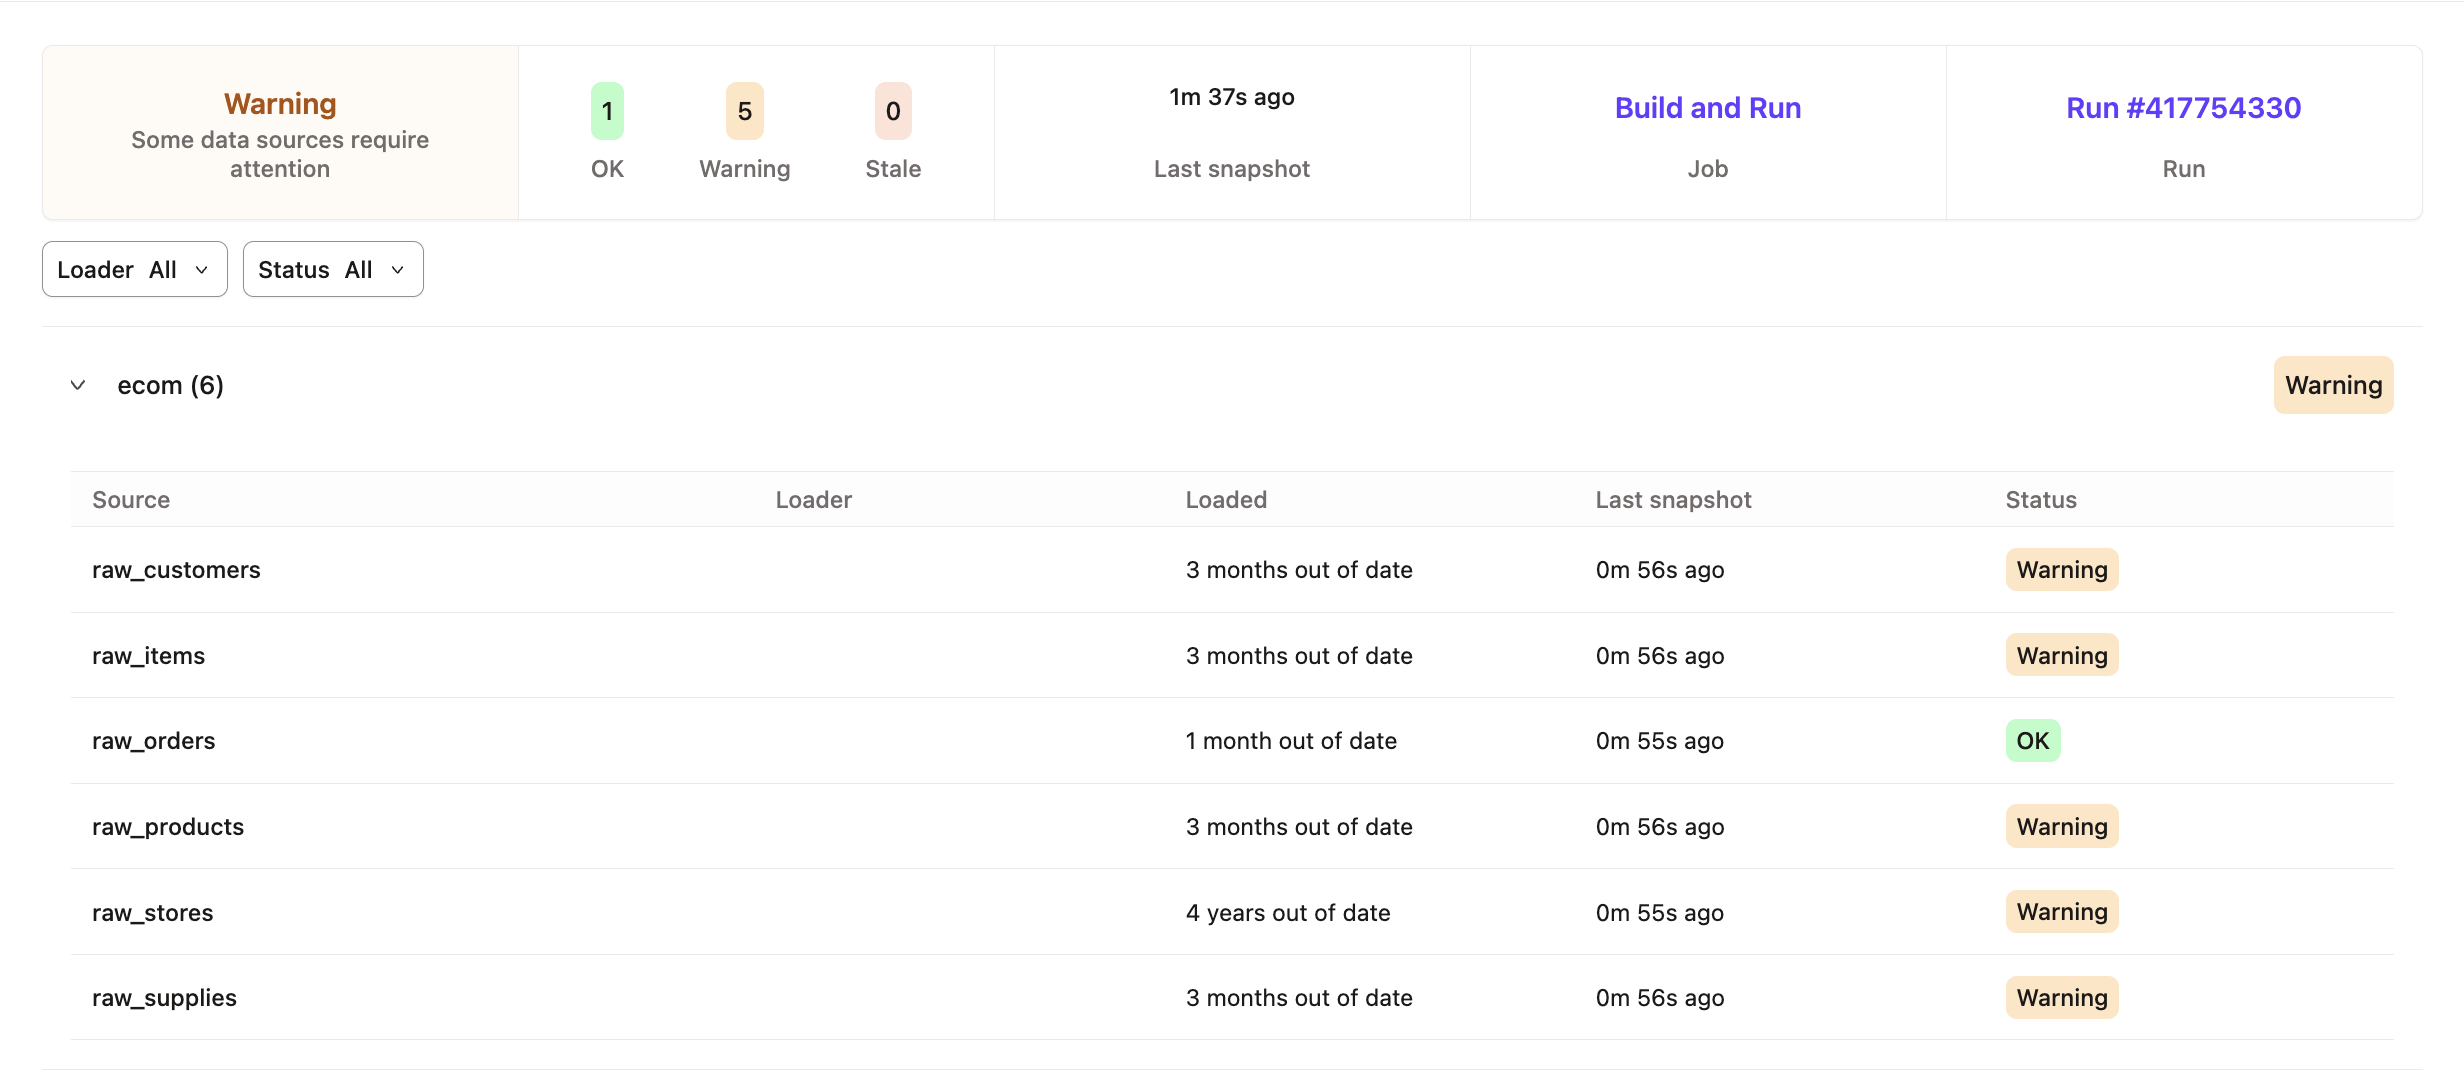 Source freshness page in dbt
Пример запроса
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      sources(
        first: $first
        filter: { freshnessChecked: true, database: "production" }
      ) {
        edges {
          node {
            sourceName
            name
            identifier
            loader
            freshness {
              freshnessJobDefinitionId
              freshnessRunId
              freshnessRunGeneratedAt
              freshnessStatus
              freshnessChecked
              maxLoadedAt
              maxLoadedAtTimeAgoInS
              snapshottedAt
              criteria {
                errorAfter {
                  count
                  period
                }
                warnAfter {
                  count
                  period
                }
              }
            }
          }
        }
      }
    }
  }
}
Каково покрытие тестами и их статус?
Data tests — это важный способ убедиться, что ваши стейкхолдеры работают с данными высокого качества. Вы можете выполнять тесты во время запуска dbt. Discovery API предоставляет полные результаты тестов для заданного окружения или задания, представляя их в виде children соответствующего протестированного узла (например, model).
Пример запроса
В следующем примере parents — это узлы (код), которые тестируются, а executionInfo описывает последние результаты тестов:
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      tests(first: $first) {
        edges {
          node {
            name
            columnName
            parents {
              name
              resourceType
            }
            executionInfo {
              lastRunStatus
              lastRunError
              executeCompletedAt
              executionTime
            }
          }
        }
      }
    }
  }
}
Как эта модель контрактируется и версионируется?
Чтобы обеспечить форму определения модели, вы можете определить контракты на модели и их столбцы. Вы также можете указать версии модели, чтобы отслеживать дискретные этапы ее эволюции и использовать соответствующую.
Пример запроса
query {
  environment(id: 123) {
    applied {
      models(first: 100, filter: { access: public }) {
        edges {
          node {
            name
            latestVersion
            contractEnforced
            constraints {
              name
              type
              expression
              columns
            }
            catalog {
              columns {
                name
                type
              }
            }
          }
        }
      }
    }
  }
}
Обнаружение
Вы можете использовать Discovery API для поиска и понимания соответствующих наборов данных и семантических узлов с богатым контекстом и метаданными. Ниже приведены примеры вопросов и запросов, которые вы можете выполнить.
Для сценариев использования, связанных с обнаружением, обычно запрашивают последнее примененное или определенное состояние, часто в нижней части DAG (например, модели mart или метрики), используя конечную точку environment.
Что означает этот набор данных и его столбцы?
Запросите Discovery API, чтобы сопоставить таблицу/представление в платформе данных с моделью в проекте dbt; затем получите метаданные о его значении, включая описательные метаданные из его YAML-файла и информацию о каталоге из его YAML-файла и схемы.
Пример запроса
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(
        first: $first
        filter: {
          database: "analytics"
          schema: "prod"
          identifier: "customers"
        }
      ) {
        edges {
          node {
            name
            description
            tags
            meta
            catalog {
              columns {
                name
                description
                type
              }
            }
          }
        }
      }
    }
  }
}
Как выглядит полная линейность данных на уровне моделей?
Discovery API предоставляет доступ к полной линейности данных на уровне моделей, предоставляя:
- Входящие зависимости моделей, включая связи с sources, seeds и snapshots
- Метаданные выполнения моделей, такие как статус запуска, время выполнения и актуальность данных
- Детали на уровне колонок, включая тесты и описания
- Ссылки между моделями для восстановления линейности данных по всему проекту
Пример запроса
Ниже приведён пример GraphQL-запроса, который извлекает полную линейность данных на уровне моделей с использованием Discovery API:
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first) {
        edges {
          node {
            name
            ancestors(types: [Model, Source, Seed, Snapshot]) {
              ... on ModelAppliedStateNestedNode {
                name
                resourceType
              }
              ... on SourceAppliedStateNestedNode {
                sourceName
                name
                resourceType
              }
            }
          }
        }
      }
    }
  }
}
Какие метрики доступны?
Вы можете определять и запрашивать метрики с помощью Semantic Layer, использовать их в целях документации (например, для каталога данных), а также вычислять агрегаты (как в BI‑инструменте, который не обращается напрямую к Semantic Layer).
Пример запроса
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    definition {
      metrics(first: $first) {
        edges {
          node {
            name
            description
            type
            formula
            filter
            tags
            parents {
              name
              resourceType
            }
          }
        }
      }
    }
  }
}
Управление
Вы можете использовать Discovery API для аудита разработки данных и содействия сотрудничеству внутри и между командами.
Для сценариев использования, связанных с управлением, люди обычно запрашивают последнее состояние определения, часто в нижней части DAG (например, публичные модели), используя конечную точку environment.
Кто отвечает за эту модель?
Вы можете определить и отобразить группы, с которыми связана каждая модель. Группы содержат информацию, такую как владелец. Это может помочь вам определить, какая команда владеет определенными моделями и с кем связаться по поводу них.
Пример запроса
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first, filter: { uniqueIds: ["MODEL.PROJECT.NAME"] }) {
        edges {
          node {
            name
            description
            resourceType
            access
            group
          }
        }
      }
    }
    definition {
      groups(first: $first) {
        edges {
          node {
            name
            resourceType
            models {
              name
            }
            ownerName
            ownerEmail
          }
        }
      }
    }
  }
}
Кто может использовать эту модель?
Вы можете предоставить людям возможность указывать уровень доступа для данной модели. В будущем публичные модели будут функционировать как API для унификации линии проекта и обеспечения повторного использования моделей с использованием перекрестных ссылок на проекты.
Пример запроса
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    definition {
      models(first: $first) {
        edges {
          node {
            name
            access
          }
        }
      }
    }
  }
}
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    definition {
      models(first: $first, filter: { access: public }) {
        edges {
          node {
            name
          }
        }
      }
    }
  }
}
Разработка
Вы можете использовать Discovery API для понимания изменений и использования наборов данных и оценки влияния для информирования определения проекта. Ниже приведены примеры вопросов и запросов, которые вы можете выполнить.
Для сценариев использования, связанных с разработкой, люди обычно запрашивают историческое или последнее определение или примененное состояние в любой части DAG, используя конечную точку environment.
Как эта модель или метрика используется в инструментах downstream?
Экспозиции предоставляют метод определения того, как модель или метрика фактически используется в панелях и других аналитических инструментах и сценариях использования. Вы можете запросить определение экспозиции, чтобы увидеть, как используются узлы проекта, и запросить результаты ее линии вверх по потоку, чтобы понять состояние данных, используемых в ней, что поддерживает такие сценарии использования, как плитка статуса свежести и качества.
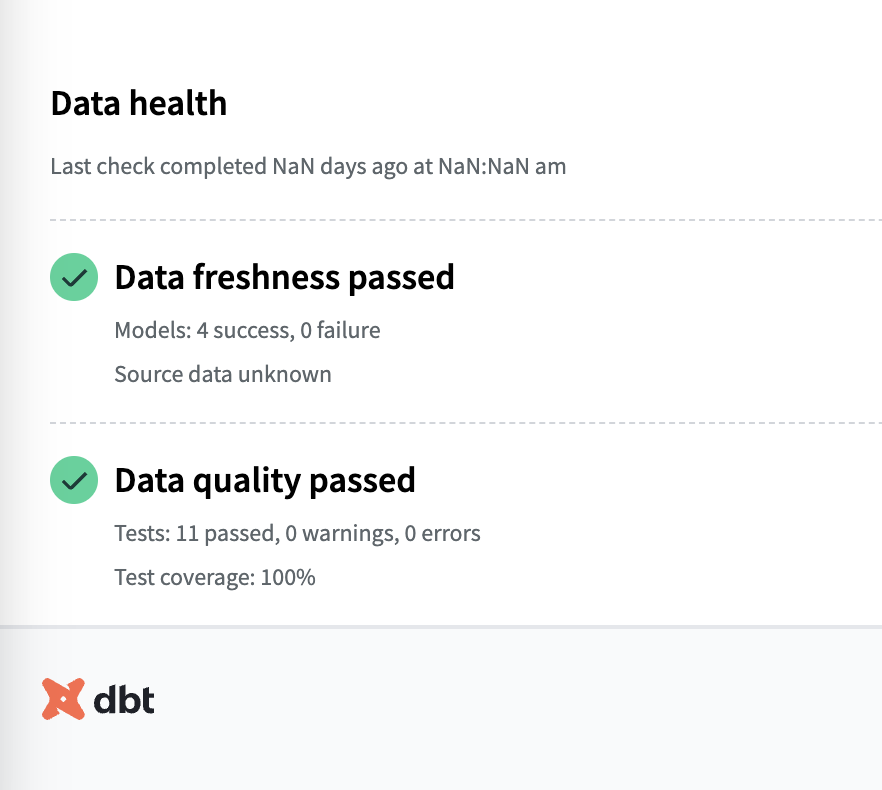 Встраивайте плитки здоровья данных в свои панели, чтобы донести сигналы доверия до потребителей данных.
Пример запроса
Ниже приведен пример, который рассматривает экспозицию и модели, используемые в ней, включая время их последнего выполнения.
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      exposures(first: $first) {
        edges {
          node {
            name
            description
            ownerName
            url
            parents {
              name
              resourceType
              ... on ModelAppliedStateNestedNode {
                executionInfo {
                  executeCompletedAt
                  lastRunStatus
                }
              }
            }
          }
        }
      }
    }
  }
}
Как эта модель изменилась со временем?
Discovery API предоставляет историческую информацию о любом ресурсе в вашем проекте. Например, вы можете увидеть, как модель эволюционировала со временем (в течение последних запусков) с учетом изменений в ее форме и содержании.
Пример запроса
Просмотрите различия в compiledCode или columns между запусками или постройте графики "Approximate Size" и "Row Count" stats по времени:
query (
  $environmentId: BigInt!
  $uniqueId: String!
  $lastRunCount: Int!
  $withCatalog: Boolean!
) {
  environment(id: $environmentId) {
    applied {
      modelHistoricalRuns(
        uniqueId: $uniqueId
        lastRunCount: $lastRunCount
        withCatalog: $withCatalog
      ) {
        name
        compiledCode
        columns {
          name
        }
        stats {
          label
          value
        }
      }
    }
  }
}
Какие узлы зависят от этого источника данных?
Линия dbt начинается с источников данных. Для данного источника вы можете посмотреть, какие узлы являются его детьми, а затем итерировать вниз по потоку, чтобы получить полный список зависимостей.
В настоящее время запросы за пределами 1 поколения (определяемого как прямой родитель-ребенок) не поддерживаются. Чтобы увидеть внуков узла, вам нужно сделать два запроса: один, чтобы получить узел и его детей, и другой, чтобы получить узлы-дети и их детей.
Пример запроса
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      sources(
        first: $first
        filter: { uniqueIds: ["SOURCE_NAME.TABLE_NAME"] }
      ) {
        edges {
          node {
            loader
            children {
              uniqueId
              resourceType
              ... on ModelAppliedStateNestedNode {
                database
                schema
                alias
              }
            }
          }
        }
      }
    }
  }
}
