Запросы к Discovery API
Discovery API поддерживает разовые запросы и интеграции. Если вы только начинаете работать с этим API, ознакомьтесь с вводной информацией в разделе О Discovery API.
Информацию о квотах запросов и механизме ограничения их частоты см. в разделе Ограничения частоты запросов API.
Используйте Discovery API для оценки состояния конвейеров данных и состояния проекта как на протяжении нескольких запусков, так и в конкретный момент времени. dbt Labs предоставляет стандартный GraphQL explorer для этого API, который позволяет выполнять запросы и просматривать схему. При этом вы также можете использовать любой другой GraphQL-клиент по своему выбору для обращения к API.
Поскольку GraphQL описывает данные, доступные в API, схема, отображаемая в GraphQL explorer, точно отражает граф и поля, доступные для запросов.
Предварительные требования
- У вас должна быть мультитенантная или однотенантная учетная запись dbt.
- Вы должны использовать тарифный план Starter, Enterprise или Enterprise+.
- Ваши проекты должны использовать каналы выпуска dbt или dbt версии 1.0 или более поздней. Инструкции по обновлению см. в разделе Обновление версии dbt в Cloud.
Авторизация
В настоящее время авторизация запросов выполняется с помощью сервисного токена. Пользователи dbt с правами администратора могут создать сервисный токен с уровнем доступа Metadata Only, который разрешает выполнение определённого запроса к Discovery API.
Создав токен, вы можете использовать его в заголовке Authorization запросов к dbt Discovery API. Обязательно укажите префикс Token в заголовке Authorization, иначе запрос завершится с ошибкой 401 Unauthorized. Обратите внимание, что в заголовке Authorization вместо Token можно использовать Bearer. Оба варианта синтаксиса эквивалентны.
Доступ к Discovery API
-
Создайте токен сервисного аккаунта для авторизации запросов. Пользователи dbt с правами администратора могут сгенерировать сервисный токен Metadata Only, который можно использовать для выполнения определённого запроса к Discovery API для авторизации запросов.
-
Определите URL API, который нужно использовать, из таблицы Discovery API endpoints.
-
По вопросам, связанным с конкретными запросами, обратитесь к документации схемы.
Выполнение запросов с помощью HTTP-запросов
Вы можете выполнять запросы, отправляя POST-запросы к Discovery API, не забыв заменить:
-
YOUR_API_URLна соответствующий Discovery API endpoint для вашего региона и тарифного плана. -
YOUR_TOKENв заголовке Authorization на ваш реальный API-токен. Обязательно указывайте префикс Token. -
QUERY_BODYна GraphQL-запрос, например{ "query": "<query text>", "variables": "<variables in json>" } -
VARIABLESна словарь с переменными вашего GraphQL-запроса, например ID job или фильтр. -
ENDPOINTна endpoint, к которому вы обращаетесь, например environment.curl 'YOUR_API_URL' \
-H 'authorization: Bearer YOUR_TOKEN' \
-H 'content-type: application/json'
-X POST
--data QUERY_BODY
Пример на Python:
response = requests.post(
    'YOUR_API_URL',
    headers={"authorization": "Bearer "+YOUR_TOKEN, "content-type": "application/json"},
    json={"query": QUERY_BODY, "variables": VARIABLES}
)

metadata = response.json()['data'][ENDPOINT]
Для каждого запроса потребуется ID окружения или задания. Вы можете получить этот ID из URL-адреса dbt или с помощью Admin API.
На этой странице приведено несколько наглядных примеров запросов. Дополнительные примеры см. в разделе Сценарии использования и примеры для Discovery API.
Конечные точки Discovery API
Найдите свой эндпоинт Discovery API в разделе Account settings → Access URLs в dbt platform. Формат зависит от типа развертывания и региона:
| Deployment type | Discovery API URL |
|---|---|
| Мультиарендная среда | https://ACCOUNT_PREFIX.metadata.REGION.dbt.com/graphql |
| Одноарендная среда | https://ACCOUNT_PREFIX.metadata.ROUTING_SUBDOMAIN.dbt.com/graphql |
- Замените следующие заполнители фактическими значениями. Дополнительную информацию о регионах и поддоменах см. в разделе Доступ, регионы и IP-адреса:
ACCOUNT_PREFIX— идентификатор вашей учетной записи (указан в Account settings в разделе Access URLs)REGION— регион вашего развертывания (например,us1для Северной Америки в AWS,eu1для EMEA,jp1для Японии,au1для APAC и т. д.)ROUTING_SUBDOMAIN— поддомен маршрутизации вашей одноарендной среды (обычно это название вашей компании. Если вы не уверены, обратитесь к команде по работе с вашей учетной записью)- Например, если вы используете AWS в Северной Америке с префиксом учетной записи
abc123, ваш URL Discovery API —https://abc123.metadata.us1.dbt.com/graphql.
Разумное использование
Использование Discovery (GraphQL) API ограничено лимитами на частоту запросов и размер ответов, чтобы поддерживать производительность и стабильность платформы метаданных и предотвращать злоупотребления.
На эндпоинты уровня задания распространяются ограничения сложности запросов. Вложенные узлы (например, parents), код (например, rawCode) и столбцы каталога считаются наиболее сложными элементами. Слишком сложные запросы следует разбивать на отдельные запросы, включая в них только необходимые поля. Для большинства сценариев использования dbt Labs рекомендует вместо этого использовать эндпоинт окружения, чтобы получать актуальные описательные метаданные и метаданные результатов для проекта dbt.
Ограничения хранения данных
Вы можете использовать Discovery API для запросов данных за последние два месяца. Например, если сегодня 1 апреля, вы сможете запрашивать данные начиная с 1 февраля.
Выполнение запросов с помощью GraphQL explorer
Вы можете выполнять ad-hoc запросы напрямую в GraphQL API explorer и использовать document explorer в левой части экрана, чтобы увидеть все доступные узлы и поля.
Информацию о настройке и авторизации GraphQL см. в документации Apollo explorer.
-
Откройте GraphQL API explorer и выберите поля, которые вы хотите запросить.
-
Внизу explorer выберите Variables и замените все поля со значением
nullна ваши уникальные значения. -
Аутентифицируйтесь, используя Bearer auth с
YOUR_TOKEN. Внизу explorer выберите Headers и нажмите +New header. -
В выпадающем списке header key выберите Authorization и в поле value укажите ваш Bearer-токен. Не забудьте включить префикс Token. Заголовок должен иметь формат:
{"Authorization": "Bearer <YOUR_TOKEN>}.
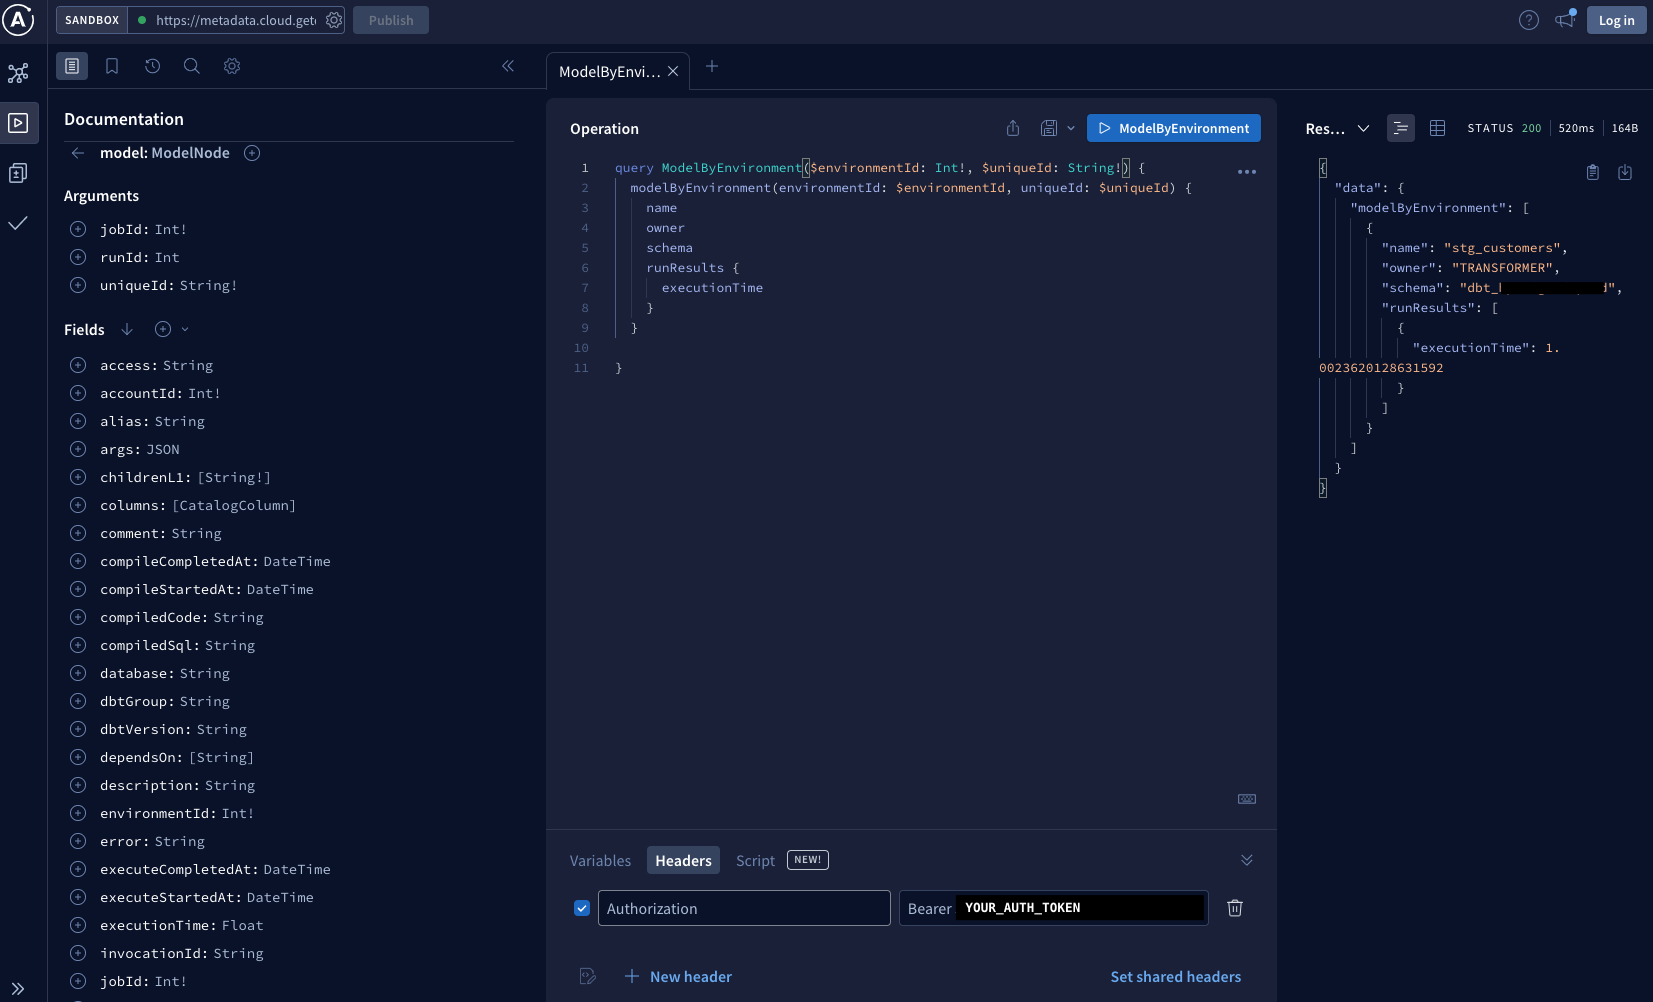 Введите ключ заголовка и значение токена аутентификации Bearer
- Запустите запрос, нажав синюю кнопку выполнения запроса в правом верхнем углу редактора Operation (справа от запроса). Справа в explorer вы должны увидеть успешный ответ на запрос.
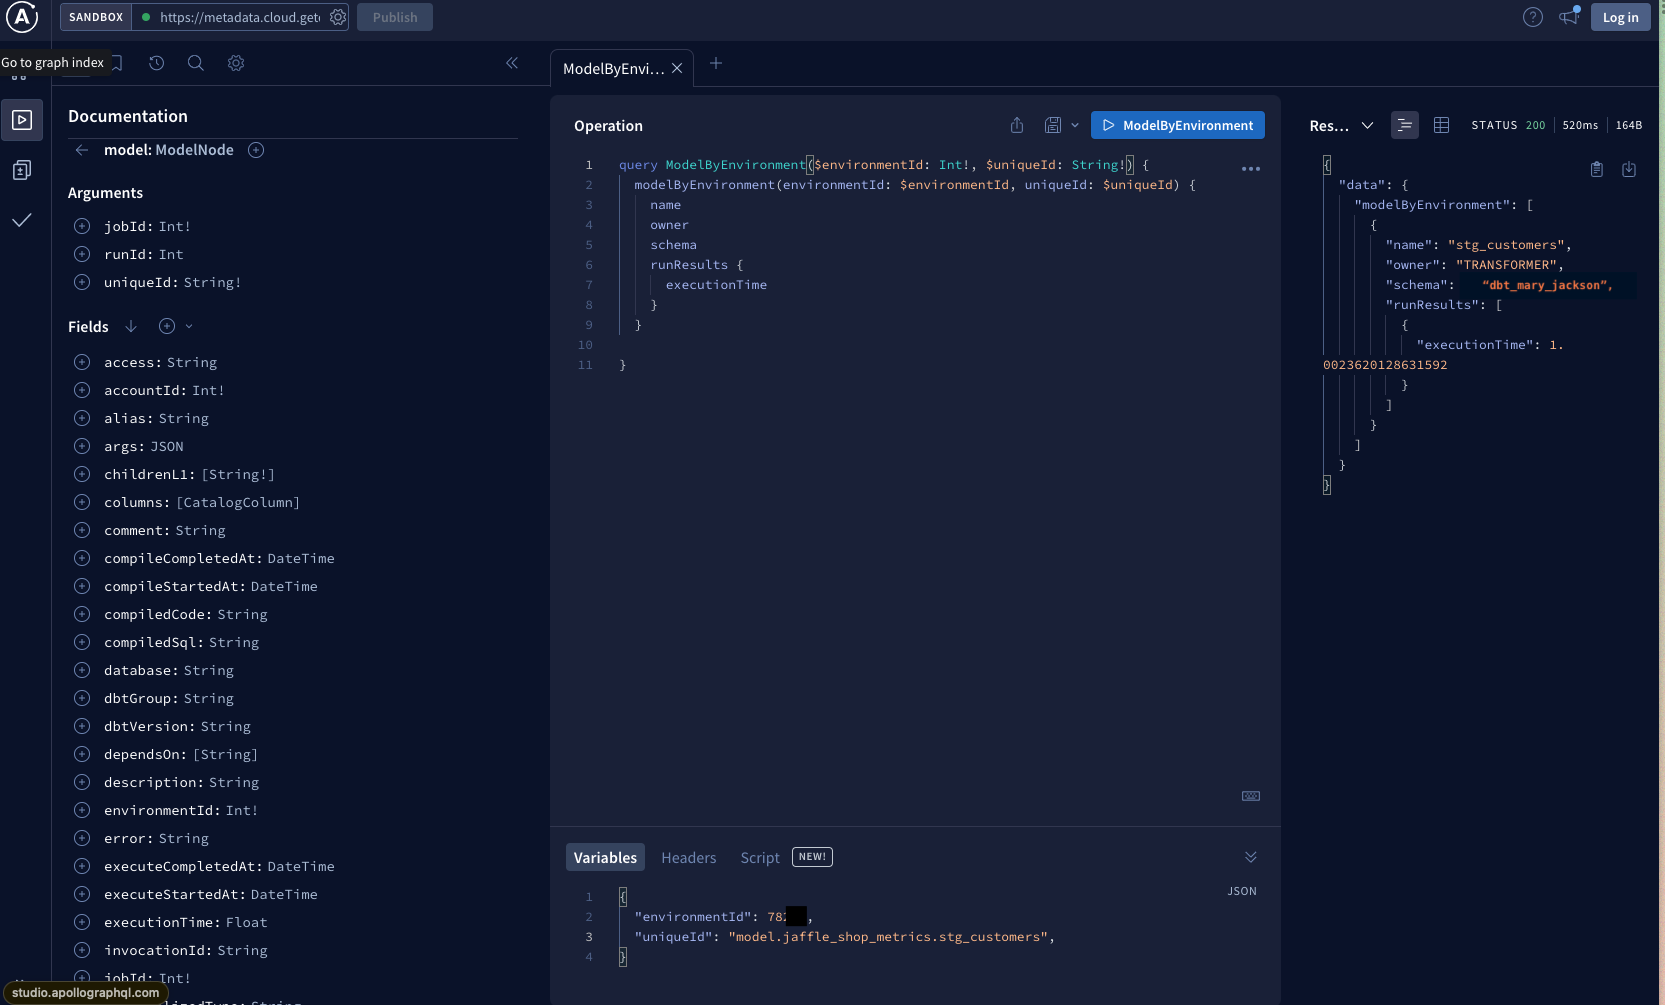 Выполнение запросов с помощью обозревателя GraphQL Apollo Server
Фрагменты
Используйте нотацию ... on для выполнения запросов по lineage и получения результатов для конкретных типов узлов.
query ($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first, filter: { uniqueIds: "MODEL.PROJECT.MODEL_NAME" }) {
        edges {
          node {
            name
            ancestors(types: [Model, Source, Seed, Snapshot]) {
              ... on ModelAppliedStateNestedNode {
                name
                resourceType
                materializedType
                executionInfo {
                  executeCompletedAt
                }
              }
              ... on SourceAppliedStateNestedNode {
                sourceName
                name
                resourceType
                freshness {
                  maxLoadedAt
                }
              }
              ... on SnapshotAppliedStateNestedNode {
                name
                resourceType
                executionInfo {
                  executeCompletedAt
                }
              }
              ... on SeedAppliedStateNestedNode {
                name
                resourceType
                executionInfo {
                  executeCompletedAt
                }
              }
            }
          }
        }
      }
    }
  }
}
Пагинация
Запросы к большим наборам данных могут влиять на производительность нескольких функций в конвейере API. Пагинация снижает нагрузку, возвращая данные меньшими порциями — по одной странице за раз. Это позволяет получать определённую часть набора данных или весь набор по частям для повышения производительности. dbt использует пагинацию на основе курсора, которая упрощает получение страниц постоянно изменяющихся данных.
Используйте объект PageInfo, чтобы получить информацию о странице. Доступные поля:
startCursorтип string — соответствует первомуnodeвedge.endCursorтип string — соответствует последнемуnodeвedge.hasNextPageтип boolean — указывает, есть ли дополнительныеnodesпосле возвращённых результатов.
При выполнении запроса доступны следующие переменные соединения:
firstтип integer — возвращает первые nnodesна странице, максимум 500.afterтип string — задаёт курсор, после которого нужно вернутьnodes. Рекомендуется указывать значениеafter, используя ID объекта изendCursorпредыдущей страницы.
Ниже приведён пример, который возвращает первые 500 моделей (first) после указанного Object ID (after) в переменных. Объект PageInfo показывает, с какого Object ID начинается курсор, где он заканчивается и есть ли следующая страница.
 Пример пагинации
Ниже приведён пример кода для объекта PageInfo:
pageInfo {
  startCursor
  endCursor
  hasNextPage
}
totalCount # Total number of records across all pages
Описанный выше подход с PageInfo и totalCount применяется к эндпоинтам environment, которые возвращают результаты в виде соединения (connection) с edges и nodes.
Пагинация эндпоинтов на уровне задания
Эндпоинты списков на уровне задания также поддерживают пагинацию на основе курсора. Используйте этот подход при запросе ресурсов внутри объекта job. Эти эндпоинты возвращают плоский список, а не соединение edges/nodes, поэтому объект PageInfo в них недоступен.
Следующие поля списков на уровне задания принимают аргументы first и after:
modelssourcesseedssnapshotstestsmacrosmetricsexposures
Передайте first, чтобы задать размер страницы (не более 100). Каждый возвращаемый элемент содержит поле paginationCursor — непрозрачное значение, индивидуальное для каждого элемента, которое нужно включить в выборку запроса. В следующем запросе передайте значение paginationCursor последнего элемента в качестве after, чтобы получить следующую страницу.
В отличие от запросов на уровне окружения, эти эндпоинты на уровне задания не возвращают объект PageInfo или поле hasNextPage. Последняя страница достигнута, если страница содержит меньше строк, чем задано в first (или меньше, чем размер страницы по умолчанию).
Рекомендуем всегда указывать first, чтобы ограничивать размер ответов. Ранее, если не указывать first и after, API возвращал все строки, соответствующие запросу. Для больших заданий рекомендуется явно передавать first и after, чтобы ваша интеграция не зависела от ответов без пагинации.
В одном из будущих обновлений запросы без first и after будут возвращать не более 100 строк. dbt Labs заранее уведомит о внедрении этого изменения.
Чтобы выполнить пример, используйте свой эндпоинт Discovery API и сервисный токен с правами Metadata Only. Получите jobId и необязательный runId из URL задания или запуска либо с помощью Admin API. Если не указать runId, API использует последний запуск задания. Выполните запрос в GraphQL explorer или с помощью HTTP-запросов.
В приведённом ниже примере используется список models задания. Те же аргументы first и after работают и для других типов ресурсов, перечисленных выше. Пример сценария использования с большим количеством полей см. в разделе Сценарии использования и примеры для Discovery API.
query JobModelsPage($jobId: BigInt!, $runId: BigInt, $first: Int!, $after: String) {
  job(id: $jobId, runId: $runId) {
    models(first: $first, after: $after) {
      uniqueId
      paginationCursor
    }
  }
}
Переменные для первой страницы:
{
  "jobId": 12345,
  "runId": 67890,
  "first": 10,
  "after": null
}
Для следующей страницы задайте в after значение paginationCursor из последней строки предыдущей страницы. Курсор — это непрозрачная закодированная строка, а не uniqueId. Повторяйте запросы, пока страница не вернёт меньше строк, чем задано в first (или меньше, чем размер страницы по умолчанию).
{
  "jobId": 12345,
  "runId": 67890,
  "first": 10,
  "after": "Y3Vyc29yOm1vZGVsLm15X3Byb2plY3QuZGltX2N1c3RvbWVycw=="
}
Фильтры
Фильтрация помогает сузить результаты запроса к API. Если вы хотите запросить и получить только модели и тесты, выполнение которых завершается с ошибкой, или найти модели, выполнение которых занимает слишком много времени, вы можете получить сведения о выполнении, такие как executionTime, runElapsedTime или status. Это помогает командам по работе с данными отслеживать производительность моделей, выявлять узкие места и оптимизировать конвейер обработки данных в целом.
Ниже приведён пример фильтрации результатов для моделей, которые успешно выполнились по значению lastRunStatus:
 Пример фильтрации
Ниже приведён пример фильтрации моделей с ошибкой на последнем запуске и тестов, которые завершились с ошибкой:
query ModelsAndTests($environmentId: BigInt!, $first: Int!) {
  environment(id: $environmentId) {
    applied {
      models(first: $first, filter: { lastRunStatus: error }) {
        edges {
          node {
            name
            executionInfo {
              lastRunId
            }
          }
        }
      }
      tests(first: $first, filter: { status: "fail" }) {
        edges {
          node {
            name
            executionInfo {
              lastRunId
            }
          }
        }
      }
    }
  }
}
