Если вы новичок в dbt, мы рекомендуем вам прочитать руководство по быстрому старту, чтобы создать ваш первый проект dbt с моделями.
Возможности Python в dbt являются расширением его возможностей с SQL моделями. Если вы новичок в dbt, мы рекомендуем сначала прочитать эту страницу, прежде чем переходить к: "Python модели".
SQL-модель — это инструкция select. Модели определяются в файлах .sql (обычно в каталоге models):
Каждый файл .sql содержит одну модель / инструкцию select
Имя модели наследуется от имени файла и должно совпадать с именем файла модели — с учётом регистра. Любое несоответствие регистра может помешать dbt корректно применить конфигурации и повлиять на метаданные в Catalog.
Мы настоятельно рекомендуем использовать в именах моделей символы подчёркивания, а не точки. Например, используйте models/my_model.sql вместо models/my.model.sql.
Модели можно размещать в подкаталогах каталога models.
Начиная с dbt v1.12, можно добавлять к файлам .sql суффиксы в стиле Jinja (.j2, .jinja, .jinja2) (например, my_model.sql.j2), включив флаг allow_jinja_file_extensions.
Чтобы посмотреть SQL, который выполняет dbt, вы можете заглянуть в:
dbt:
В выводе запуска нажмите на название модели, а затем выберите «Details»
dbt v1:
Директория target/compiled/ для скомпилированных операторов select
Директория target/run/ для скомпилированных операторов create
Файл logs/dbt.log для подробного логирования
Нужно ли создавать целевую схему перед запуском dbt?
Нет! dbt проверит, существует ли схема, когда она запускается. Если схема не существует, dbt создаст её для вас.
Если я перезапущу dbt, будет ли простой, пока модели перестраиваются?
Нет! SQL, который dbt генерирует за кулисами, гарантирует, что любые связи заменяются атомарно (т.е. ваши бизнес-пользователи не испытают никакого простоя).
Реализация этого процесса варьируется в зависимости от каждого хранилища данных, проверьте логи, чтобы увидеть, какой SQL выполняет dbt.
Что произойдет, если в моем SQL-запросе ошибка или я получу ошибку базы данных?
Если в вашем SQL есть ошибка, dbt вернет ошибку, которую возвращает ваша база данных.
$ dbt run --select customers Running with dbt=1.9.0 Found 3 models, 9 tests, 0 snapshots, 0 analyses, 133 macros, 0 operations, 0 seed files, 0 sources 14:04:12 | Concurrency: 1 threads (target='dev') 14:04:12 | 14:04:12 |1 of 1 START view model dbt_alice.customers..........................[RUN] 14:04:13 |1 of 1 ERROR creating view model dbt_alice.customers................. [ERROR in0.81s] 14:04:13 | 14:04:13 | Finished running 1 view model in1.68s. Completed with 1 error and 0 warnings: Database Error in model customers (models/customers.sql) Syntax error: Expected ")" but got identifier `your-info-12345` at [13:15] compiled SQL at target/run/jaffle_shop/customers.sql Done. PASS=0WARN=0ERROR=1SKIP=0TOTAL=1
Сообщить об ошибке в коде
Любые модели, зависящие от этой модели, также будут пропущены. Используйте сообщение об ошибке и скомпилированный SQL для отладки любых ошибок.
В каком SQL-диалекте писать мои модели? Или какой SQL-диалект использует dbt?
dbt может казаться магией, но на самом деле это не так. Под капотом он выполняет SQL в вашем собственном хранилище данных — ваши данные не обрабатываются за пределами вашего хранилища.
Таким образом, ваши модели должны использовать SQL-диалект вашей собственной базы данных. Затем, когда dbt оборачивает ваши select выражения в соответствующие DDL или DML, он будет использовать правильный DML для вашего хранилища — вся эта логика уже заложена в dbt.
Вы можете найти больше информации о базах данных, платформах и движках запросов, которые поддерживает dbt, в документации Поддерживаемые платформы данных.
Хотите углубиться в то, как это работает? Рассмотрим фрагмент SQL, который работает на каждом хранилище:
models/test_model.sql
select1as my_column
Сообщить об ошибке в коде
Чтобы заменить существующую таблица, вот иллюстративный пример SQL, который dbt выполнит на разных хранилищах (фактический SQL может быть гораздо сложнее этого!)
Redshift
BigQuery
Snowflake
-- на redshift нельзя создать или заменить, поэтому используйте транзакцию для выполнения этого атомарно begin; createtable"dbt_alice"."test_model__dbt_tmp"as( select1as my_column ); altertable"dbt_alice"."test_model"renameto"test_model__dbt_backup"; altertable"dbt_alice"."test_model__dbt_tmp"renameto"test_model" commit; begin; droptableifexists"dbt_alice"."test_model__dbt_backup"cascade; commit;
Сообщить об ошибке в коде
-- Сделайте API-вызов для создания набора данных (нет интерфейса DDL для этого)!!; createorreplacetable`dbt-dev-87681`.`dbt_alice`.`test_model`as( select1as my_column );
Конфигурации — это «настройки моделей», которые вы можете задавать в файле dbt_project.yml, а также непосредственно в файле модели с помощью блока config. Примеры таких конфигураций включают:
Изменение материализация используемого моделью — материализация определяет SQL, который dbt использует для создания модели в вашем хранилище данных.
Следующая диаграмма показывает пример структуры каталогов папки models:
models
├── staging
└── marts
    └── marketing
Сообщить об ошибке в коде
Ниже приведён пример конфигурации модели:
dbt_project.yml
name: jaffle_shop config-version:2 ... models: jaffle_shop:# это соответствует `name:`` конфигурации +materialized: view # это применяется ко всем моделям в текущем проекте marts: +materialized: table # это применяется ко всем моделям в каталоге `marts/` marketing: +schema: marketing # это применяется ко всем моделям в каталоге `marts/marketing/`
Сообщить об ошибке в коде
models/customers.sql
{{ config( materialized="view", schema="marketing" ) }} with customer_orders as...
Сообщить об ошибке в коде
Важно отметить, что конфигурации применяются иерархически — конфигурация, примененная к подкаталогу, переопределит любые общие конфигурации.
В dbt есть пять встроенных материализаций: view, table, incremental, ephemeral и materialized_view.
Подробнее о каждом из этих вариантов можно узнать в документации по материализациям.
Вы можете строить зависимости между моделями, используя функцию ref вместо имен таблиц в запросе. Используйте имя другой модели в качестве аргумента для ref.
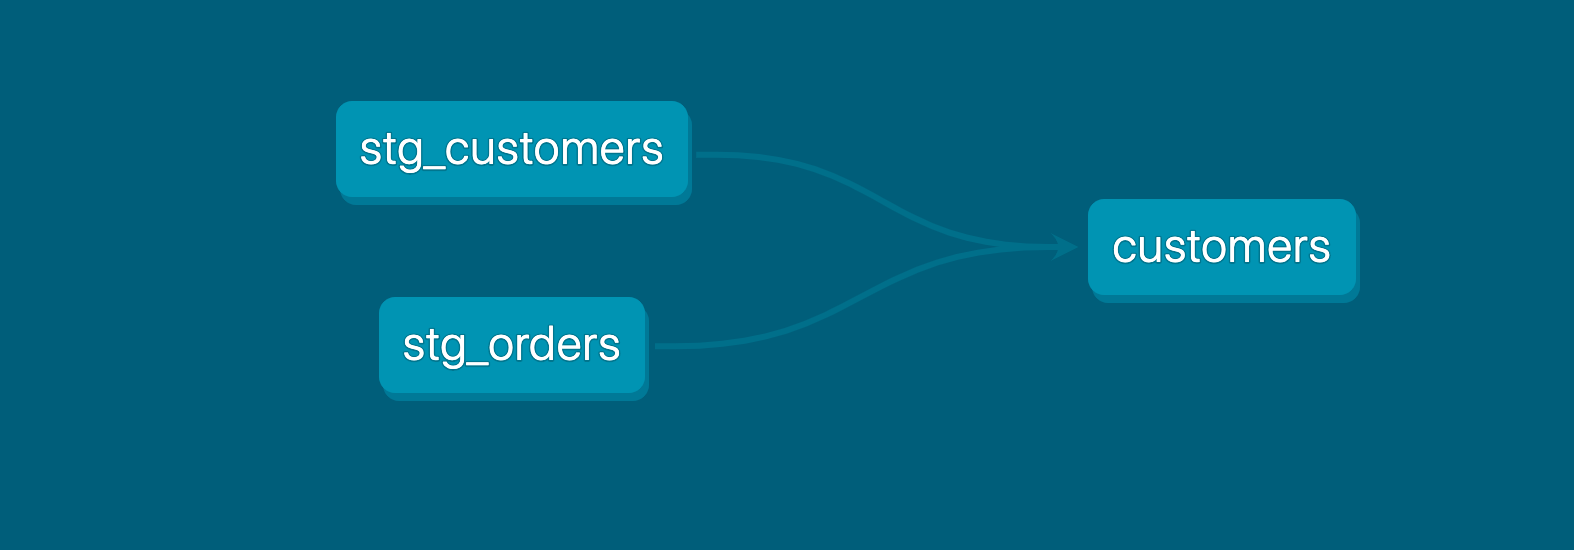
Определения порядка выполнения моделей, создавая ориентированный ациклический граф (DAG).
DAG для нашего dbt проекта
Управления отдельными средами — dbt заменит модель, указанную в функции ref, на имя базы данных для таблица (или представления). Важно, что это учитывает среду — если вы запускаете dbt с целевой схемой, названной dbt_alice, он будет выбирать из вышестоящей таблицы в той же схеме. Посмотрите на вкладки выше, чтобы увидеть это в действии.
Кроме того, функция ref поощряет вас писать модульные преобразования, чтобы вы могли повторно использовать модели и уменьшить повторяющийся код.
GitLab: Внутренний проект dbt компании GitLab имеет открытый исходный код и служит отличным примером масштабного использования dbt (исходный код)
dummy-dbt: Контейнеризированный проект dbt, который наполняет базу данных Sakila в Postgres и создает seed-данные, модели, снимки и тесты dbt. Проект можно использовать для тестирования и экспериментов (исходный код)
Google Analytics 4: Демонстрационный проект, который преобразует данные, экспортированные из Google Analytics 4 в BigQuery, в различные модели (исходный код, документация)
Make Open Data: Готовый к промышленной эксплуатации ELT-проект с тестами, документацией и CI/CD (GHA), посвященный открытым данным Франции (жилье, демография, география и т. д.). Его можно использовать для обучения работе с большими объемами неоднозначных данных. Приветствуется участие в развитии проекта (исходный код.
Если у вас есть пример проекта, который вы хотите добавить в этот список, предложите правку, нажав Edit this page ниже.
Могу ли я хранить свои модели в директории, отличной от `models`, в моем проекте?
По умолчанию dbt ожидает, что файлы, определяющие ваши модели, будут находиться в поддиректории models вашего проекта.
Чтобы изменить это, обновите настройку model-paths в файле dbt_project.yml
следующим образом:
dbt_project.yml
model-paths:["transformations"]
Сообщить об ошибке в коде
Могу ли я создавать свои модели в схеме, отличной от целевой, или распределять модели по нескольким схемам?
Да! Используйте конфигурацию schema в файле dbt_project.yml или в блоке config:
dbt_project.yml
name: jaffle_shop
...

models:
  jaffle_shop:
    marketing:
+schema: marketing # модели в подкаталоге `models/marketing/` будут использовать схему marketing
Сообщить об ошибке в коде
models/customers.sql
{{
  config(
    schema='core'
  )
}}
Сообщить об ошибке в коде
Должны ли имена ресурсов, используемых в ref, быть уникальными?
В рамках одного проекта: да! Чтобы построить зависимости между ресурсами (такими как модели, семена и снимки), вам нужно использовать функцию ref и передать в нее имя ресурса в качестве аргумента. dbt использует это имя ресурса для уникального разрешения ref на конкретный ресурс. В результате, эти имена ресурсов должны быть уникальными, даже если они находятся в разных папках.
Ресурс в одном проекте может иметь то же имя, что и ресурс в другом проекте (установленном как зависимость). dbt использует имя проекта для уникальной идентификации каждого ресурса. Мы называем это "пространством имен". Если вы используете ref для ресурса с дублированным именем, он будет разрешен в ресурс в том же пространстве имен (пакет или проект) или вызовет ошибку из-за неоднозначной ссылки. Используйте двухаргументный ref для устранения неоднозначности ссылок, указав пространство имен.
Эти ресурсы все равно должны размещаться в разных местах в хранилище данных. Прочтите документацию по пользовательским псевдонимам и пользовательским схемам для получения подробной информации о том, как этого добиться.
Как удалить удаленные модели из моего хранилища данных?
Если вы удаляете модель из вашего dbt проекта, dbt не удаляет автоматически связь из вашей схемы. Это означает, что в схемах, которые создает dbt, могут остаться лишние объекты, что может запутать других пользователей.
(Это также может произойти, когда вы переключаете модель с представление или таблица на эфемерную)
Когда вы удаляете модели из вашего dbt проекта, вам следует вручную удалить связанные связи из вашей схемы.
Как я должен организовать свой проект, когда создаю больше моделей? Как я должен называть свои модели?
Нет единственного лучшего способа структурировать проект! Каждая организация уникальна.
Если модели могут быть только `select` запросами, как вставлять записи?
Для тех, кто приходит из парадигмы ETL (Extract Transform Load), часто возникает желание писать преобразования в виде операторов insert и update. В сравнении с этим, dbt обернет ваш select запрос в оператор create table as, что может показаться контрпродуктивным.
Если вы хотите использовать операторы insert для повышения производительности (то есть для уменьшения объёма обрабатываемых данных), рассмотрите возможность использования инкрементальных моделей
Если вы хотите использовать операторы insert, поскольку ваши исходные данные постоянно меняются (например, для создания «медленно изменяющихся измерений типа 2»), рассмотрите возможность создания снимков исходных данных и построения моделей на основе этих снимков.
Почему я не могу просто писать DML в своих трансформациях?
Диалекты SQL, как правило, больше всего расходятся в DML и DDL (а не в операторах select) — посмотрите пример здесь. Пишя меньше SQL, вы можете облегчить миграцию на новую технологию баз данных.
Если вам действительно нужно написать пользовательский DML, в dbt есть способы сделать это с помощью пользовательских материализаций.
Как задать типы столбцов?
Просто приведите столбец к нужному типу в вашей модели:
select id, created::timestampas created from some_other_table
Сообщить об ошибке в коде
Этот вопрос может возникнуть, если вы привыкли выполнять такие запросы:
createtable dbt_alice.my_table id integer, created timestamp; insertinto dbt_alice.my_table ( select id, created from some_other_table )
Сообщить об ошибке в коде
В сравнении, dbt создаст эту таблица с помощью оператора create table as:
createtable dbt_alice.my_table as( select id, created from some_other_table )
Сообщить об ошибке в коде
Пока ваши запросы в модели возвращают столбцы с правильным типом, создаваемая таблица также будет иметь правильный тип столбцов.
Для определения дополнительных параметров столбцов:
Вместо того чтобы применять ограничения уникальности и not-null к вашим столбцам, используйте функциональность тестирования данных в dbt, чтобы проверить, что ваши утверждения о модели верны.
Вместо создания значений по умолчанию для столбца, используйте SQL для выражения значений по умолчанию (например, coalesce(updated_at, current_timestamp()) as updated_at)
В редких случаях, когда вам действительно нужно изменить столбец (например, кодирование на уровне столбца в Redshift), рассмотрите возможность реализации этого через post-hook.
 DAG для нашего dbt проекта
