Без постоянного присмотра — по крайней мере, сегодня
Недавно мы выпустили dbt Wizard — CLI для работы с данными в dbt с помощью ИИ-агентов. Эта среда создана специально для работы с данными, поэтому мне не терпелось выделить день и опробовать dbt Wizard на личном проекте примерно со 100 моделями, который я уже давно поддерживаю. На примере этого проекта можно наглядно увидеть некоторые отличительные особенности Wizard, в частности то, как работает цикл валидации.
Работа над проектами данных никогда не заканчивается, и у меня накопилось несколько задач, которые я всё откладывал:
- Миграция с MotherDuck на Iceberg + BigQuery
- Обновление с dbt Core до dbt Fusion
- Миграция с dbt Core на dbt platform
- Создание семантического слоя
Здесь удачно сочетаются вполне типичные задачи по работе с данными (вы уже провели свою ежегодную миграцию?) и задачи, специфичные для dbt. Хорошая неформальная проверка, которая позволяет ответить на главный вопрос о любом инструменте разработки: работает ли он?
Опыт меня приятно удивил: мне не пришлось постоянно присматривать за Wizard или выстраивать поверх него дополнительные рабочие процессы. Он изначально понимает, что такое проект dbt, и умеет настраивать субагентов валидации под конкретную задачу. Поэтому я мог подключаться только по мере необходимости, не следить за всем процессом непрерывно и в итоге достиг всех поставленных целей.
Репозиторий открыт, так что вы можете посмотреть PR, которые подготовил Wizard:
- Миграция с MotherDuck на BigQuery + Apache Iceberg
- Подготовка оркестрации в dbt Platform и Fusion
- Исправление Semantic Layer для обнаружения метрик в Fusion
О проекте
Этот проект — платформа экономических данных. Данные Федеральной резервной системы, Бюро статистики труда, исторические цены акций, ETF и сырьевых товаров, а также данные Казначейства поступают через ресурсы Dagster, преобразуются с помощью dbt и передаются набору аналитических агентов. DuckDB и MotherDuck отлично справлялись, но я хотел оценить удобство разработки и стоимость использования Iceberg, а также движок dbt Fusion.
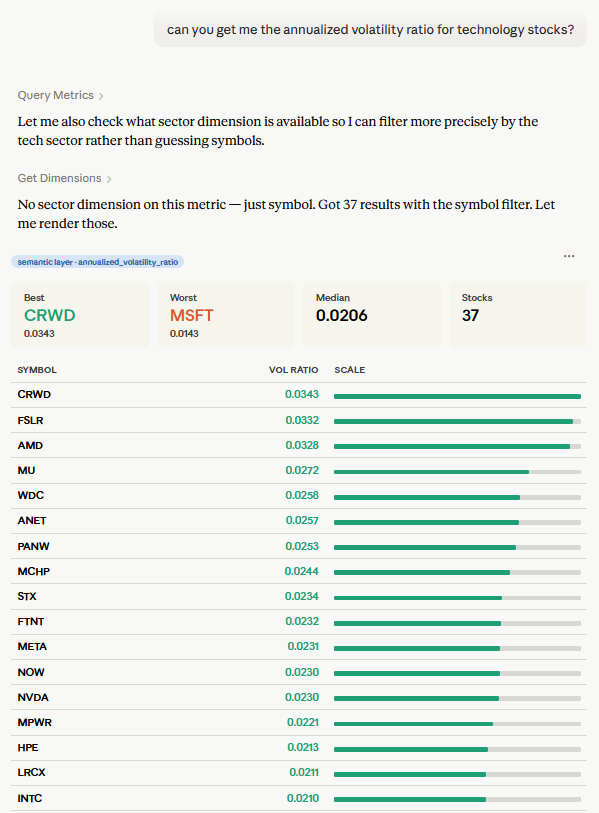
Основной интерфейс, через который я работаю с этими данными, — плагин Claude: я задаю вопросы о состоянии рынка, о том, на каком этапе экономического цикла мы находимся, запускаю бэктесты и делаю другие подобные вещи. Это помогает мне проверять новые инвестиционные и торговые идеи, и диалог с ИИ для таких задач довольно удобен. В прошлом у меня возникали проблемы с качеством данных, поэтому повышение точности и воспроизводимости для меня важно. Я также поручил Wizard создать первоначальный Semantic Layer и метрики.
Цикл валидации на практике
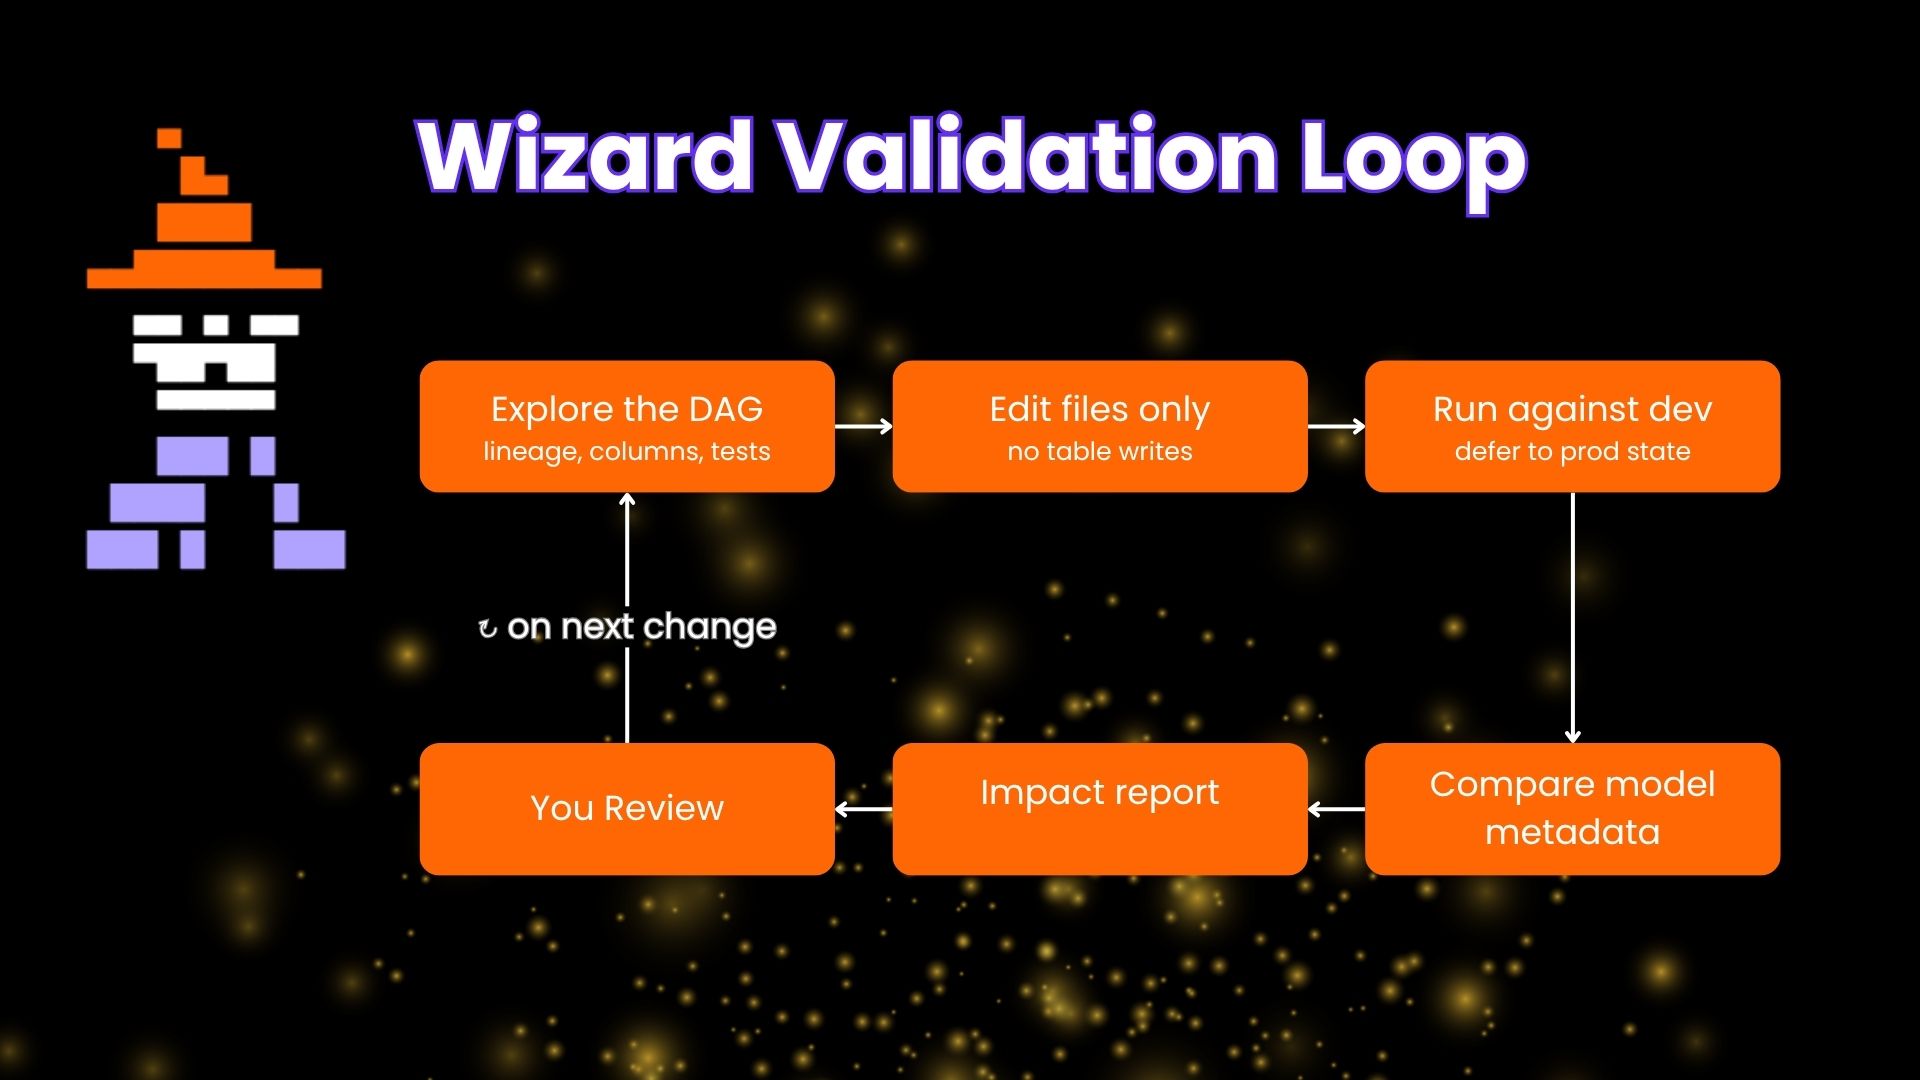
В Wizard встроен цикл валидации: он начинает с намеченного изменения, реализует наиболее разумный вариант и проверяет, работает ли он в проекте. Если проверка завершается неудачей или выявляет несоответствие, Wizard корректирует реализацию.
Одна из метрик, на которые я часто смотрю при анализе финансового рынка, — волатильность, или вариативность цены. Чтобы корректно сравнивать активы между собой, необходимо нормализовать показатели с учётом номинальных цен. Расчёт выглядит так:
V = σ_1yr / P_current

where:
  σ_1yr     = trailing one-year standard deviation of the price
  P_current = the latest close
Возьмите стандартное отклонение цены за последний год, разделите его на текущую цену — и получите безразмерный показатель волатильности, который можно сравнивать между активами с совершенно разными уровнями цен.
- name: annualized_volatility_ratio
  type: ratio
  type_params:
    numerator:
      name: price_volatility_proxy
    denominator:
      name: max_close_price
Это была первая попытка Wizard — довольно простая. Она не прошла цикл валидации из-за двух проблем моделирования:
Max_close_priceне совсем соответствовало нужному мне выражению: требовалась текущая\последняя цена, а не максимальная цена закрытия в текущем окне.- Решение зависело от ссылок между метриками в metrics.yml, которые стали ненадёжными после того, как Wizard перенёс метрики непосредственно в определения моделей для поддержки Fusion.
При валидации Wizard должен был учитывать следующие ограничения:
- Fusion должен был обнаруживать метрики, размещённые вместе с YAML моделей.
- dbt Core/Dagster должны были разбирать проект без ошибок из-за нового семантического синтаксиса. (В итоге я исправил это позже, полностью переведя проект на Fusion, но было интересно посмотреть, как Wizard справится с такой задачей.)
- Для CI требовался стабильный способ разбора и сборки проекта.
- Для dbt Platform требовались развёрнутые артефакты, которые размещённый в облаке Semantic Layer действительно мог предоставить для использования.
Wizard попробовал ещё раз, используя более старую структуру в стиле MetricFlow. Это оказалось не лучшим вариантом: один парсер с ней работал, а другой — нет.
Для одного парсера стало лучше, для другого — хуже. Теперь сбой возникал на другой стороне — именно такие результаты при ручной работе могут отнять весь день.
Итоговый вариант оказался самым незамысловатым из трёх, но он работал.
- name: annualized_volatility_ratio
  label: Annualized Volatility Ratio
  description: Average ratio of 1-year price StdDev to close price, a dimensionless proxy for annualized volatility. Higher means more volatile relative to price level.
  type: simple
  agg: average
  expr: std_diff_1yr / nullif(current_price, 0)
Логика расчёта отношения переместилась в expr, nullif устраняет деление на ноль, а само определение успешно разбирается и в Fusion, и в dbt Core и проходит CI проекта. То, что Wizard сам выполнил цикл валидации и разобрался в тонких различиях между dbt Core и Fusion, сэкономило мне массу времени.
В процессе мне не пришлось обращаться к документации, а уточнить что-либо у Wizard понадобилось лишь несколько раз — в основном для собственного понимания. Для меня это успех: теперь у меня есть простая метрика, которая соответствует ожидаемой формуле, совместима с обоими парсерами и может быть развёрнута в облачном семантическом слое. К тому же мне пришлось посмотреть только один diff — итоговый. Тупиковые попытки и итерации остались за кадром, так что подключаться нужно было лишь по необходимости.
Почему он мог работать без присмотра
Это стало возможным благодаря трём вещам. Некоторые из них можно воспроизвести в других средах для агентов с помощью навыков, MCP, хуков и других средств автоматизации, но здесь всё это было доступно из коробки.
Он знал граф ещё до начала работы. Wizard использует dbt Information Schema — структурированное представление связей происхождения данных, моделей, тестов и определений метрик, которое формируется ещё до первого запроса. Когда он добавлял std_diff_1yr и current_price в это выражение expr, ему не пришлось искать нужные имена по SQL-файлам с помощью grep: он быстро определил подходящие поля.
Валидация выполнялась по умолчанию. Я ни разу не говорил: «Проверь, что это компилируется». Цикл запускается при операциях записи независимо от того, просите вы об этом или нет. Если эта возможность вам не нужна, её можно отключить.
Он не выходил за заданные границы. Задача состояла в создании первоначального набора метрик для предметной области рынков. Он не отвлекался на рефакторинг посторонних моделей и не переписывал мои ресурсы Dagster. Он определил границы изменений, выполнял итерации в этих пределах и представил diff на проверку. Без моего одобрения ничего не сохранялось. Именно такие строгие рамки позволяют спокойно «отойти и вернуться», не рискуя получить взрывной рост технического долга.
Какое подтверждение мне было нужно
Успешная компиляция не доказывает, что изменение в Semantic Layer работает. Она говорит лишь о том, что YAML имеет правильную структуру, но не о том, что метрику можно обнаружить и запросить в вашем реальном хранилище. Поэтому после слияния PR и выполнения заданий dbt platform я проверил облачный слой напрямую: диалект BIGQUERY, обнаружено 43 метрики, статус запроса SUCCESSFUL. Затем я выполнил настоящий запрос к метрике через dbt MCP и получил реальные числа из BigQuery.
Но главным подтверждением для меня стало то, что перед чередой встреч я смог дать Wizard определённый набор аналитических задач, а он последовательно выполнил их без существенного вмешательства с моей стороны. Самое приятное — в итоге всё работало, а во время встреч я мог полноценно участвовать в обсуждениях, не испытывая желания проверить, не сбился ли мой агент с пути. Возможно, настоящей проверкой были друзья, которых мы обрели по дороге.
С чем ещё он хорошо справился
Ещё несколько небольших успехов за тот же период работы:
- Он не стал разбираться с ошибкой, которая уводила не туда. Локальная команда выдала ошибку аутентификации Snowflake в проекте BigQuery. Wizard отделил облачную среду, где правильно использовался BigQuery, от устаревшего пути к учётным данным Snowflake на моём ноутбуке. В результате задача превратилась из «сломалась production-среда» в «устарели локальные учётные данные», а это разница между часом и целым днём работы.
- Он понимал, что «слито» и «доступно» — разные состояния. Слияние PR не означает, что Semantic Layer обновился. Wizard выяснил, что недостающий шаг — выполнение заданий dbt platform, запустил задания развёртывания, а затем подтвердил доступность метрик.
- Он разместил определения рядом. Изначально метрики были разбросаны по отдельным файлам. Wizard перенёс их в
schema.ymlсоответствующих моделей, так что теперь каждая метрика находится рядом со столбцами, которые она измеряет. Semantic Layer перестал быть изолированным островком метаданных. - Он прагматично сократил объём изменений. Некоторые сохранённые запросы оказались нестабильными после миграции метрик. Вместо того чтобы блокировать изменения, он убрал эти запросы, сначала обеспечил стабильное обнаружение метрик, а работу над запросами отложил на потом. Я бы потратил час на борьбу с ними. Исключить их было правильным решением.
Попробуйте сами
Репозиторий открыт, если вам интересно посмотреть на сами метрики и слитые PR. Установите Wizard CLI и запустите его для проекта, который использует Fusion или dbt Core:
curl -fsSL https://public.cdn.getdbt.com/dbt-wizard/install/install-wizard.sh | sh
В документации Wizard описана настройка, а в разделе о принципах работы подробнее разобран цикл валидации. Если попробуете его для собственной миграции, расскажите мне об этом в канале #dbt-wizard в Slack-сообществе dbt.