Внутри обвязки dbt Wizard: создаём агента, который мыслит DAG
Попросите инженера-аналитика переименовать столбец, и он начнёт не с SQL. Сначала он проверит, что читает этот столбец ниже по графу зависимостей, какие тесты и дашборды сломаются, выполнит сборку только изменившихся объектов и сравнит данные ещё до того, как кто-то приступит к ревью. Сервер dbt MCP и навыки агентов могут научить агента для работы с кодом этим шагам, но не могут гарантировать, что он будет выполнять их каждый раз, собирать только изменившиеся объекты или показывать вам различия в данных перед проверкой изменений.
Мы построили dbt Wizard вокруг другой идеи. Wizard работает как инженер-аналитик: мыслит DAG, проверяет и исправляет свою работу и не отвлекает вас от задач, чтобы вы проверяли работающее изменение, а не первый черновик. Всё это обеспечивает не модель, а обвязка, рабочие процессы и пользовательский интерфейс, которые мы создали вокруг неё.
Запускайте агентов параллельно, просматривайте различия в данных и граф происхождения данных рядом с кодом и проверяйте изменения в своём хранилище. Запишитесь в список ожидания Wizard Desktop.
Что делает обвязка агента
LLM — это механизм рассуждений. Обвязка — всё остальное: какой контекст загружается до того, как модель начнёт думать, как она взаимодействует с файловой системой и кодовой базой, какие инструменты может вызывать, что происходит, если её результат не проходит компиляцию, когда ей следует остановиться и обратиться к человеку и как она соблюдает принятые в вашей команде соглашения.
Представьте обвязку как среду выполнения, которая для каждой задачи отвечает на вопросы:
- Что агент знает об этом проекте прямо сейчас?
- Какие инструменты он может вызывать и что ему запрещено?
- Когда и как он проверяет свою работу?
- Когда он останавливается и обращается к человеку?
- Какой контекст загружается и каким образом?
- Можно ли разделить эту задачу между узкоспециализированными вспомогательными агентами?
- Что происходит, если сгенерированный код не работает?
Обвязка Wizard состоит из нескольких слоёв: метаданные и контекст, инструменты, навыки и память, оркестрация субагентов, безопасность и проверка изменений. Но самое интересное — не сами слои, а циклы обратной связи.
 Обвязка охватывает каждый шаг цикла агента: контекст поступает в модель, модель вызывает инструменты с проверкой разрешений, а готовая работа проходит валидацию в заданных границах, прежде чем вы проверите влияние изменений и различия в данных.
Валидация внутри цикла
По мере того как агенты генерируют всё больше кода, проверка корректности изменений и результатов становится важнейшим условием быстрого создания надёжных систем. Именно поэтому в Wizard изначально встроен цикл валидации, использующий собственные механизмы dbt.
Находим ошибки до того, как вы их увидите
Wizard выполняет валидацию в два этапа.
-
Во время работы агент проверяет свои изменения с помощью встроенных инструментов dbt: компилирует SQL, разрешает ссылки
ref()и читает структурированные сообщения об ошибках, если что-то идёт не так. Ошибки компилятора и базы данных поступают прямо в модель с указанием точной строки и предлагаемого исправления, чтобы она могла внести правки ещё до того, как вы что-либо увидите. -
Когда изменение готово, Wizard подводит итог проделанной работы и предлагает область валидации. Способ её выполнения зависит от того, где вы используете Wizard:
- Wizard Desktop и CLI: выберите глубину валидации — от быстрой компиляции и запуска тестов до полного сравнения production-окружения с окружением разработки. В Desktop начните с панели Validation. Специальный агент валидации выполняет сборки и тесты только для одобренных вами моделей. Он не расширяет выборку, не меняет целевые окружения и не выполняет полное обновление.
- Платформа dbt: Wizard использует более простой и проактивный подход. Он сам решает, какие команды нужны для проверки изменений, и запускает их автоматически, если вы уже разрешили их выполнение.
 План валидации Wizard с глубиной Medium: компиляция и проверка линтером, материализация, тестирование и сборка зависимых нижестоящих моделей для выбранной области, с автоматическим применением deferral.
Если какая-либо проверка завершается неудачей, обвязка передаёт информацию об этом обратно в модель как контекст, модель вносит исправления, и цикл повторяется.
Основная идея в том, что модель что-то пишет, dbt предоставляет ей реальную обратную связь от компилятора и тестов (ещё лучше, если вы используете статический анализ), а обвязка управляет этим циклом обратной связи до того, как человек увидит результат. В итоге люди проверяют результат, который уже прошёл компиляцию и валидацию, а не первый черновик.
Сдерживаем расходы на хранилище
Ещё одна причина, по которой цикл валидации занимает центральное место в жизненном цикле агента, — стоимость. Wizard изучает ваш проект и проверяет свою работу тщательнее, чем обычный агент, поэтому мы строго контролируем, какие команды он может выполнять. В наших экспериментах агенты, особенно с более высоким уровнем рассуждений, охотно выполняли компиляцию и сборку всей схемы разработки для проверки каждого изменения. Это расходует вычислительные ресурсы хранилища и перегружает среды разработки. Доступ к командам dbt через сервер MCP или оболочку сам по себе этого не предотвращает.
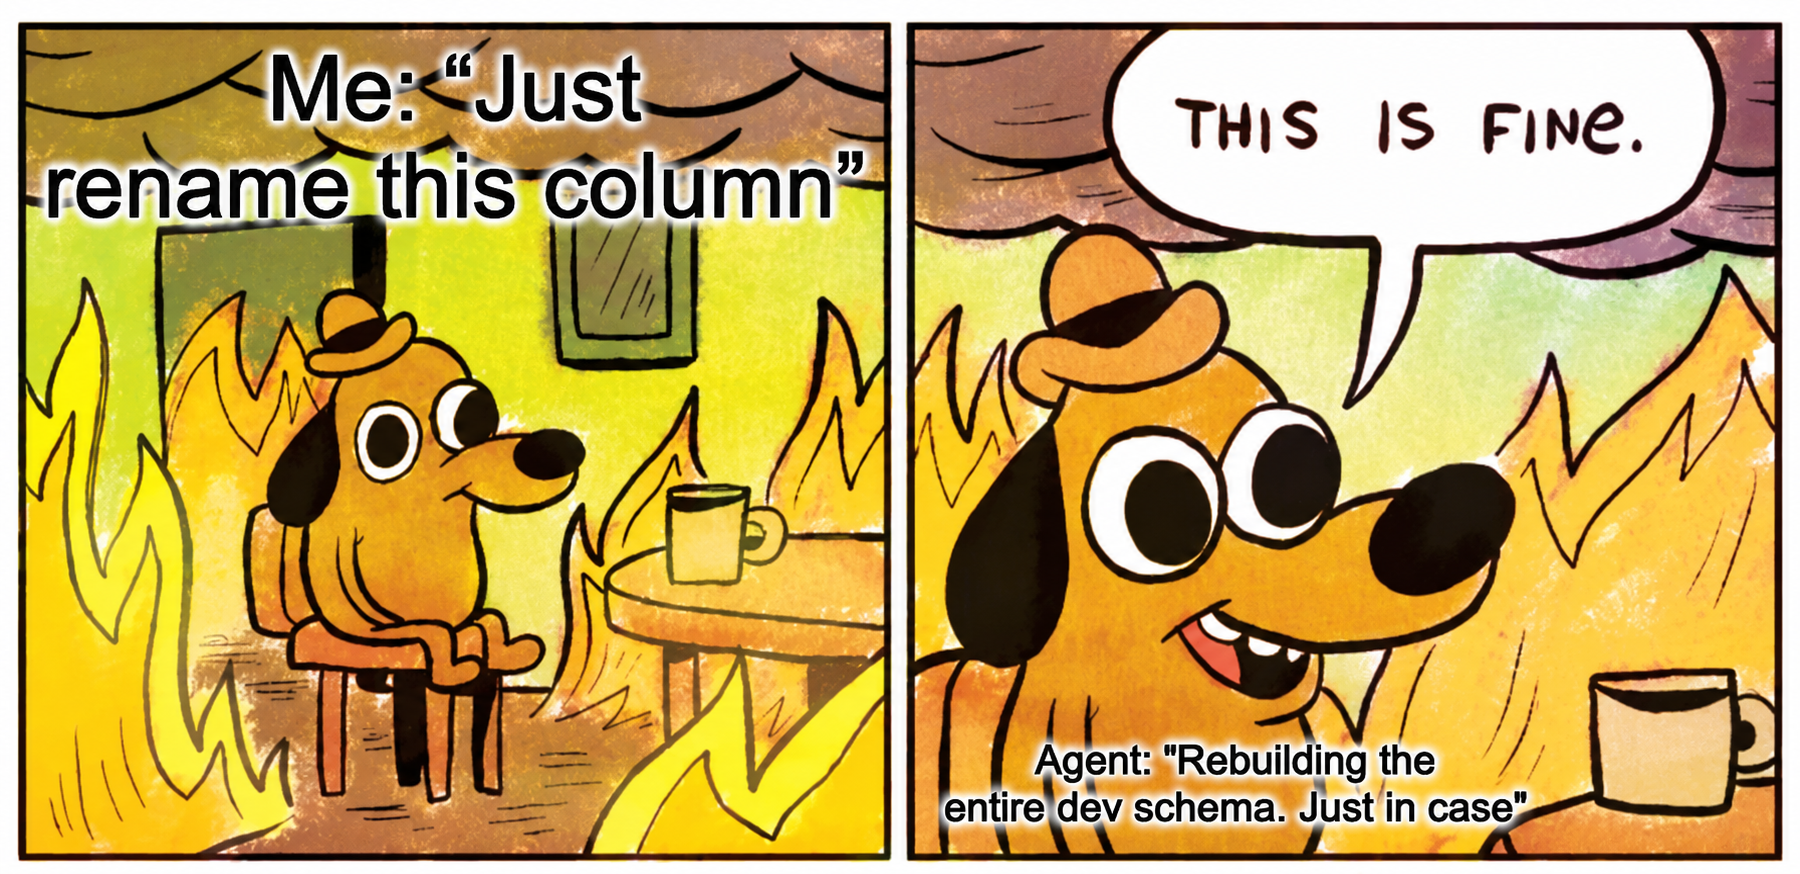 Агент пересобирает всю схему разработки в ответ на просьбу переименовать один столбец 🥲
Чтобы избежать такого поведения, Wizard направляет каждую команду dbt через собственные инструменты, а не через оболочку, автоматически применяет deferral и ограничивает запуски валидации одобренной областью.
Deferral — чрезвычайно мощная возможность, и Wizard обеспечивает её полноценную поддержку. Если вы работаете над моделью на третьем уровне вашего DAG, а агент пересобирает все вышестоящие зависимости в окружении разработки, вы напрасно тратите вычислительные ресурсы хранилища и время. При выполнении определённых команд это может повториться несколько раз за одну задачу. Wizard собирает только необходимые объекты в окружении разработки, а для неизменённых вышестоящих моделей использует их production-состояние через deferral. Там, где это полезно, он также сравнивает поведение в разработке и production и проверяет влияние на нижестоящие объекты.
По умолчанию Wizard управляет deferral за вас, а также работает с dbt State или с ручной настройкой, если она у вас уже есть. В любом случае валидация выполняется на реалистичном состоянии без затрат на полную пересборку.
 Как Wizard использует deferral: после изменения fct_orders агентом полная пересборка создаёт четыре модели в окружении разработки, а deferral на production повторно использует вышестоящие production-копии, собирает только изменённую модель и добавляет сравнение данных и проверку влияния на нижестоящие объекты.
Валидация в dbt никогда не сводилась к вопросу «можно ли разобрать этот файл?». Настоящий вопрос — сможет ли изменение выполняться в реальном хранилище, не приводя к резкому росту затрат и времени выполнения и не нарушая зависимости, контракты или нижестоящие модели. Именно на этот вопрос и должен отвечать цикл валидации.
Эффект на практике
Специалисты по данным тратят большую часть времени на сопровождение пайплайнов и тушение пожаров. Такая реактивная работа может изматывать команды и мешать им браться за новые проекты и удовлетворять запросы заинтересованных сторон.
По мере того как агенты пишут всё больше кода, вопрос смещается с «это работает?» на «это работает правильно?». Чтобы посмотреть, как это выглядит на практике, один из нас (Алекс) изучил семь месяцев истории своей личной платформы торговых данных. Она построена на Dagster, dbt и BigQuery, содержит 239 активов данных (из них 174 — модели dbt) и 1 114 проверок качества данных, а большую часть кода для неё пишут ИИ-агенты. История охватывает 24 388 запусков и 405 влитых PR за период с 1 марта по 3 октября 2026 года.
Исправления составляли 57% всех влитых PR. По мере роста платформы эта доля почти не менялась. Число PR с исправлениями практически точно следовало за общим числом влитых PR от недели к неделе (ρ 0,96), тогда как примерно стократное увеличение числа записываемых строк не оказало измеримого влияния на частоту исправлений. Пайплайны ломались из-за роста сложности и отсутствия удобного способа выявлять такие проблемы качества данных до запуска.
Когда запуск завершается с ошибкой, дефект обнаруживается быстро: в этом случае медианное время составило один день. Другое дело — успешный запуск с неверным числом в результате. В выборке хорошо документированных дефектов медианное время обнаружения скрытых ошибок составило 65 дней, а некоторые оставались незамеченными до 361 дня. Одна метрика ликвидности (к которой никто не обращался с запросами) была ошибочной в 1 000 раз на протяжении 210 дней. Заметная доля этих дефектов была вызвана проблемами качества исходных данных поставщика.
 Медианное число дней до обнаружения дефекта: явные дефекты, при которых запуск завершался с ошибкой, находили за 1 день, а скрытые дефекты, при которых запуск был успешным, но число — неверным, обнаруживали за 65 дней.
В самую загруженную неделю этого периода, когда к платформе подключили аналитического агента, было влито 104 PR, а доля успешных запусков оставалась на уровне 98%. На ту же неделю пришлось 36 исправлений корректности — треть от общего числа за месяц. Успешного прохождения CI тоже недостаточно: около 90% PR, написанных агентами, проходили CI с первой попытки независимо от того, какая модель их создала. Самые дорогостоящие дефекты проходили и CI, и ревью кода.
С августа Wizard (на базе GLM 5.3) стал играть более заметную роль в подготовке любых изменений, затрагивающих платформу. Мы предполагали, что цикл валидации и встроенное понимание проекта помогут раньше находить проблемы качества данных и вносить меньше ошибок. Чтобы проверить это, мы проанализировали каждый PR за этот период с разбивкой по обвязке и модели. У Wizard с GLM доля изменений, потребовавших последующего исправления, составила 5% — ниже, чем у любой другой измеренной нами комбинации модели и обвязки, включая передовые модели с более сильными способностями к рассуждению. Это существенно повышает продуктивность разработчиков и доверие заинтересованных сторон, а также снижает общий расход токенов ИИ, минут CI и ресурсов хранилища.
 PR, потребовавшие последующего исправления в течение 14 дней, с разбивкой по модели и обвязке: у Wizard самая низкая доля — 5%.
Сначала метаданные, а не файлы
Один из ключевых инструментов, которые мы добавили, чтобы помочь Wizard находить контекст, — dbt Information Schema для вашего проекта dbt. Она заранее сформирована и готова ещё до вашего первого запроса, поэтому вместо чтения файлов ради выяснения устройства проекта Wizard обращается к dbt Information Schema. Перед изменением кода он также проверяет вышестоящие и нижестоящие зависимости.
 Артефакты сборки dbt (manifest, catalog, run results и semantic manifest) поступают в dbt Information Schema — набор представлений DuckDB над артефактами в формате parquet, к которым Wizard обращается для анализа влияния, проверки состояния, планирования валидации и профилирования данных.
Эти метаданные включают модели, столбцы, ссылки ref, происхождение данных (включая происхождение на уровне столбцов), тесты, контракты, семантические определения, результаты запусков и состояние моделей. Когда вы спрашиваете Wizard «что сломается, если я переименую этот столбец?», он может сразу ответить на основе графа проекта — без необходимости искать каждую модель в цепочке зависимостей и читать её содержимое целиком.
Во-первых, это даёт модели точный, структурированный контекст вместо необработанного содержимого файлов. Когда вы просите добавить тесты к stg_customers, она уже знает, какие файлы нужно посмотреть, в каком YAML-файле схемы описана модель, где stg_customers находится в графе происхождения данных и что уже проверяют тесты похожих staging-моделей в вашем проекте.
Во-вторых, это экономит входные токены — как с точки зрения стоимости, так и с точки зрения активного контекстного окна. Токены, которые ушли бы на выяснение зависимостей, вместо этого используются для самого изменения, и с ростом проекта это становится всё важнее.
Инструменты, созданные для агентов
Консольный вывод dbt рассчитан на людей: строки прогресса для каждого узла, цвета, баннеры и сводки. Это удобно в терминале, но для агента по большей части является шумом. Поэтому, когда Wizard запускает инструмент или команду dbt, в контекст модели попадает только полезная информация.
Wizard запускает dbt со структурированным журналированием в JSON и преобразует результат в компактный отчёт: число успешных, неуспешных и пропущенных операций, а затем только узлы с ошибками и сообщения об этих ошибках. В примере сборки с неуспешным тестом агент видит около 150 токенов вместо примерно 1 300 в обычном выводе dbt или, что ещё хуже, 21 000 в интерактивном сеансе терминала. Ошибка SQL поступает как точное сообщение базы данных, строка и предлагаемый столбец — ничего лишнего.
Тот же принцип применяется ко всем командам. Во время долгой сборки агенту не нужен статус каждой модели по мере её завершения, поэтому Wizard периодически запрашивает сводку вместо потоковой передачи каждой строки. Wizard также удаляет цвета, индикаторы загрузки и другой вывод, предназначенный для людей. Для каждой операции dbt мы добиваемся того, чтобы Wizard возвращал только самую значимую информацию. При выполнении сборок Wizard видит, какие именно модели были собраны и с каким статусом. При запуске тестов он видит только количество выполненных тестов, список неуспешных тестов и сведения об их ошибках.
Навыки: настраиваемые и переносимые
Многие ваши соглашения Wizard усваивает из графа проекта: как называются, тестируются и материализуются модели. Навыки охватывают всё остальное — например, шаблон документации, чек-лист ревью или правило именования, которому старые модели пока не следуют.
Навыки используют открытый формат Agent Skills, поэтому навыки, которыми ваша команда уже пользуется, включая навыки агентов от dbt, работают в Wizard, а навыки, написанные для Wizard, работают и в других инструментах. Wizard поставляется со встроенными навыками dbt, загружает только те, которые нужны для задачи, и позволяет навыкам вашего проекта переопределять стандартные.
Оркестрация субагентов
Некоторые задачи слишком велики для одного контекстного окна. В Wizard есть команда субагентов, способных выполнять сложные задачи: рефакторинг множества моделей, обновление целых наборов тестов, масштабное документирование и обновление контрактов. Для этого мы распределяем работу между узкоспециализированными вспомогательными субагентами, которые работают параллельно, освобождая контекст основного агента для координации задачи.
Встроенные роли отражают наше представление о рабочих процессах инженеров-аналитиков:
- explorer: работает только на чтение, отвечает на конкретные вопросы о проекте, используя граф происхождения данных и метаданные
- worker: вносит изменения в файлы
- validation: выполняет структурированную валидацию dbt, включая проверки SQL,
dbt run --defer, сравнение production-окружения с окружением разработки и анализ влияния - test_writer: находит пробелы в покрытии тестами и пишет тесты схемы
Так что вместо того, чтобы заставлять одного агента держать весь рефакторинг в голове (под остроконечной шляпой), Wizard выступает координатором, который передаёт сложную работу специалистам.
Wizard Desktop поднимает этот подход ещё на один уровень. Субагенты делят между собой одну задачу, а параллельные чаты позволяют запускать несколько задач одновременно. В одном чате можно рефакторить модель, в другом — разбираться с падающим тестом, а в третьем — отвечать на вопрос о данных. Каждый чат изолирован и в репозитории, и в хранилище, поэтому параллельные задачи не конфликтуют и не записывают данные в одни и те же таблицы.
Desktop также позволяет выбирать глубину валидации изменения: от быстрой компиляции и запуска тестов до полного сравнения production-окружения с окружением разработки. А если что-то не так, можно оставить комментарий к конкретной строке, ячейке таблицы или диаграмме и передать эту обратную связь прямо агенту. Чтобы попробовать, запишитесь в список ожидания Wizard Desktop.
Модель безопасности
Работа с dbt влияет на production-пайплайны данных. Неудачное слияние может сломать дашборды, испортить метрики или незаметно изменить числа, на которых основаны бизнес-решения. Поэтому модель безопасности решает две задачи: ограничивает действия агента и показывает последствия изменения до того, как вы его примете.
Песочница и режимы разрешений
По умолчанию Wizard:
- Показывает правки в виде различий и запрашивает разрешение перед их применением.
- Выполняет команды оболочки в песочнице с доступом только на чтение.
- Всегда требует явного одобрения, независимо от других настроек, для разрушительных команд, таких как
--full-refresh,git reset --hard, и любых действий, способных привести к необратимым изменениям.
Вы независимо управляете двумя вещами: к чему агент может обращаться (от доступа только на чтение до полного доступа) и как часто он предварительно запрашивает разрешение (от каждого изменения до полного отсутствия запросов).
В Wizard Desktop это простой выбор между режимами Plan changes, Ask for approval и Auto. Для исследовательской работы можно ослабить ограничения, а для изменений, близких к production, — усилить. Но по умолчанию подход консервативный: агент предлагает, человек одобряет. Полный набор настроек описан в документации по конфигурации и разделе об одобрении и песочнице.
Видим последствия до одобрения
Работа с данными по своей природе визуальна. Самые болезненные ошибки обычно не вызывают сообщения об ошибке. Пайплайн выполняется, PR одобряют, но число на дашборде оказывается неверным. Одобрение изменений в коде полезно только тогда, когда видно, к чему они приведут. Поэтому рядом с кодом Wizard показывает:
- Анализ влияния: какие нижестоящие модели, тесты, exposures и метрики затронет изменение; эта информация берётся из графа проекта и доступна для просмотра в графе происхождения данных.
- Логику преобразований: расширенное представление различий в SQL и (на платформе dbt) визуальный DAG преобразований, который разбивает логику на более привычные шаги — соединения, фильтры, агрегации и проекции, — чтобы вы могли понять, как изменилась модель, а не только увидеть изменения в исходном коде.
- Различия в данных: что изменение на самом деле сделало с данными, на основе сравнения окружения разработки с production, чтобы вы видели не только SQL, который успешно компилируется.
В Wizard Desktop всё это находится рядом с чатом: граф происхождения данных, представление dbt-compare, показывающее влияние изменения на данные, и различия для каждой затронутой модели. Если что-то выглядит неправильно, оставьте комментарий к соответствующей строке, ячейке таблицы или диаграмме, и агент его получит.
Вы проверяете, что изменение делает с вашими данными и DAG, а не только с файлами.
Работа с данными — это не только код
Агент с сервером dbt MCP и навыками может сделать немало. Он способен читать проект, запускать dbt и следовать соглашениям вашей команды. Но внесение изменения в dbt никогда не сводилось к написанию SQL. Нужно знать, что находится ниже по графу зависимостей, проверять изменение на реальных данных, держать расходы на хранилище в разумных пределах и видеть, что именно изменилось, прежде чем одобрять результат. Многое из этого требует визуального представления, а возможности стены текста в окне чата ограничены.
Именно для этой части работы мы создали Wizard. Он начинает с графа вашего проекта, проверяет свою работу в вашем хранилище с включённым deferral и показывает граф происхождения данных и различия в данных рядом с кодом, когда наступает ваша очередь проверять результат. Вы тратите меньше времени на отладку первых черновиков и поиск чисел, которые незаметно стали неверными, и больше — на работу, которой действительно ждут заинтересованные стороны.
dbt Wizard доступен на платформе dbt, в виде CLI и как Wizard Desktop (запишитесь в список ожидания).
Чтобы увидеть, как Wizard решает реальные задачи в личном проекте, прочитайте «Сегодня — без присмотра». Подробнее о создании собственных навыков для вашей команды читайте в документации dbt Wizard.