Дьявол кроется в документации
«Да-да, продолжайте двигаться с черепашьей скоростью». — Миранда Пристли, «Дьявол носит Prada»
В фильме «Дьявол носит Prada» есть ещё одна сцена, о которой я думаю чаще, чем об этой. Если вы его ещё не видели, постараюсь обойтись без спойлеров. Миранда поворачивается к Энди (своей ассистентке) и с нескрываемым нетерпением объясняет, что небесно-голубой цвет её «мешковатого свитера» взялся не из ниоткуда — за ним стоит цепочка осознанных решений в мире моды, принятых за несколько лет до этого людьми, которые тщательно обдумывали каждый выбор. Свитер, который Энди купила в магазине, стал конечным результатом долгой цепочки осознанного отбора, тщательно скрытой ради иллюзии, будто он появился сам собой.
Именно так я бы описала документацию, особенно в эпоху ИИ. Пользователь — разработчик, аналитик, инженер данных или технический писатель 😜 — задаёт вопрос ИИ-инструменту и получает ответ. Ему необязательно видеть каждое решение в стоящей за ним цепочке: что включить, как выстроить структуру, где есть пробелы, что нужно обновить. Но эти решения формируют каждый получаемый им ответ. Где-то в начале этой цепочки команда документации делает тщательно продуманный, осознанный выбор, последствия которого доходят до самого момента, когда ответ появляется в редакторе пользователя.
В этой статье мы расскажем, как команды документации стараются приблизить эти решения к пользователям — и почему в эпоху ИИ такая архитектура важна как никогда.
Начните с руководства по быстрому старту с dbt MCP или загляните в справочник инструментов для документации продукта, если вы уже подключились.
Пробел: документация была, но встроенного доступа к ней не было
Вспомните Энди из «Дьявол носит Prada» — она постоянно получает запросы на информацию, которую теоретически могла бы найти, но каждый раз вынуждена лихорадочно искать, потому что под рукой её нет. Дело не в том, что она ничего не знает. Просто в нужный момент у неё нет доступа к нужному источнику.
Примерно так же обстояли дела с MCP-сервером dbt и документацией:
- Документация с открытым исходным кодом на docs.getdbt.com тщательно поддерживается (командой документации и нашим замечательным сообществом dbt), остаётся актуальной и отформатирована для людей, а теперь и для ИИ.
- Есть индекс
llms.txt, единый текстовый файл с полным содержимым и версия каждой страницы в Markdown. - Есть файл
AGENTS.md, в котором описано, как получать доступ к документации через веб-запросы. - Источник был надёжным и доступным.
- Есть индекс
- MCP-сервер dbt — мощный инструмент, с помощью которого пользователи dbt взаимодействуют с dbt через ИИ-инструменты. У него также был доступ к документации через веб-поиск и обучающие данные.
- В нём восемь категорий инструментов: CLI, Semantic Layer, Discovery, Admin API, SQL, Codegen, Fusion, Server Metadata.
- Но ни одна из них не подключалась напрямую к актуальной документации по умолчанию. Наша документация не была его основным источником.
Поэтому, когда агенту задавали вопрос «Как настроить инкрементальные модели?», теоретически он вполне мог добраться до документации с помощью собственных инструментов просмотра веб-страниц, но результат был непредсказуемым. Иногда он получал страницу через веб-поиск, иногда опирался на обучающие данные или собирал ответ по частям; а когда всё-таки загружал страницу, то обычно получал отрендеренный HTML, а не исходный Markdown — более тяжёлый, зашумлённый и менее экономный с точки зрения токенов. Внутри сервера не было прямого встроенного пути, который по умолчанию направлял бы агентов к эталонной документации в её самом чистом виде.
 Миранда злится на ИИ за галлюцинации об инкрементальных моделях (а вообще это реальный ответ ИИ, который я получила, когда добавляла инструменты документации на MCP-сервер)
Исследование: принимаем более взвешенные решения на основе данных
Помните, как Энди наконец начинает готовиться к работе в Runway — изучать дизайнеров, историю, разбираться, кто есть кто, — чтобы предугадывать потребности Миранды ещё до того, как та о чём-то попросит? Именно такой подход требовался на этом этапе: собрать данные, взвесить варианты и принять осознанное решение, прежде чем браться за реализацию.
В начале этого года мы обсуждали данные документации и то, как ИИ-инструменты теперь получают их для ответов на вопросы. Прозвучал термин «эталонная документация», и мне было непросто понять, что он означает и чем отличается от той документации, которую мы уже создавали. Но потом Google анонсировала новый API документации и MCP-сервер — и всё встало на свои места! Теперь документация — источник истины (эталонный источник), и в эпоху ИИ она очень важна 💃💃💃!
Мы обсудили это и рассмотрели несколько вариантов:
- Создать новый MCP-сервер документации, то есть начать с нуля и построить всю инфраструктуру с самого начала
- Добавить инструменты документации в существующий MCP-сервер dbt, то есть добавить категорию инструментов документации в уже работающий MCP-сервер dbt (который уже настроен и у которого есть пользователи)
- Оставить всё как есть, поскольку документация уже доступна через dbt agent skills (спасибо команде DX за потрясающую работу!), и именно этот путь подходит пользователям, устанавливающим dbt agent skills
Но всё ещё оставался вопрос: как приблизить документацию к пользователям так, чтобы решением было удобно пользоваться и его было легко поддерживать.
Мы выполнили несколько SQL-запросов в нашем внутреннем аналитическом проекте на платформе dbt, используя Fusion в расширении dbt для VS Code, а также воспользовались Insights для исследовательского анализа.
Мы увидели следующие преимущества MCP-сервера dbt:
- Им уже активно пользовались, и значительная часть инфраструктуры была готова. Добавление инструментов документации стало бы естественным продолжением, предоставив пользователям доступ к документации прямо там, где они уже работают.
- Уже было восемь категорий инструментов, но ни одна из них не обеспечивала прямого доступа к docs.getdbt.com.
- Открытый исходный код и бесплатность также означали, что каждый пользователь автоматически получит доступ к документации.
Но проблема заключалась в том, что, когда агенту нужно было ответить на вопрос «Как настроить инкрементальные модели?», гарантированного пути к главному источнику истины — актуальной документации — не было.
Как уже упоминалось, у нас была прочная основа для документации, доступной для чтения ИИ:
docs.getdbt.com/llms.txt— индекс страниц для ИИ-системdocs.getdbt.com/llms-full.txt— полное содержимое документации в одном файле- Поддержка суффикса
.mdна любой странице документации для получения чистого Markdown - Файл
AGENTS.md, в котором описано, как получать доступ к документации через веб-запросы - Опубликованный навык
fetching-dbt-docs, который объясняет ИИ-агентам, как получать доступ к нашей документации через веб-запросы, и используется в Claude Code, Copilot, Gemini CLI и других инструментах
Подход с навыками отлично работает, но требует, чтобы кто-то установил навык, а агент знал о его существовании. Нам же было интересно понять, что поможет ещё больше приблизить документацию к пользователям.
Решение: доставить Книгу
В «Дьявол носит Prada» есть ритуал. Каждый вечер «Книгу» — секретную папку с макетом будущего номера Runway — доставляют в квартиру Миранды. Пробные отпечатки фотографий, макеты статей, размещение рекламы — все решения, которые редакторы, стилисты и фотографы приняли за день, собраны в одном месте. Ей не нужно ехать за этим в офис. Книгу приносят к ней, в её пространство, именно тогда, когда она нужна. Миранда просматривает её, делает пометки, и то, что она одобрит, отправляется в печать и выходит в свет.
Книга наглядно показывает, как выглядит передача цепочки тщательно продуманных решений — собранных в одном месте и доставленных туда, где будет принято следующее решение.
Именно к такому стандарту мы стремились. Разработчикам не должно быть нужно прерывать рабочий процесс ради поиска документации. Документация — вместе со всеми тщательно продуманными решениями, которые в неё заложены, — должна появляться в уже используемом инструменте в тот момент, когда нужно что-то оценить и двигаться дальше.
MCP-сервер dbt уже умел искать связи происхождения данных, запускать тесты, выполнять запросы к Semantic Layer и помогать с отладкой заданий. Но спросите его: «Какой синтаксис у стратегии snapshot?» — и он мог ответить правильно, ошибиться или начать импровизировать. Веб-поиск. Обучающие данные или наиболее вероятная догадка. Стабильной «доставки» Книги не было.
✨ Решение: мы добавили в MCP-сервер dbt два инструмента в новой категории «Product Docs» — девятой категории инструментов✨:
search_product_docs— выполняет поиск по docs.getdbt.com и возвращает заголовки, URL и описания страниц, соответствующих запросу, с ранжированием по релевантности.get_product_doc_pages— получает полное содержимое одной или нескольких страниц документации в Markdown по пути или URL.
Процесс повторяет то, как человек пользуется документацией: сначала поиск подходящих материалов, затем получение полного содержимого. Разница в том, что всё происходит внутри уже используемого ИИ-инструмента, без мучительного переключения контекста.
При этом dbt agent skills остаются лучшим вариантом для агентов, не подключённых через MCP. Эти два подхода дополняют друг друга: навык подтвердил востребованность, а инструменты MCP стали встроенным решением.
Как это меняет повседневную работу
- Раньше: пишете макрос, встречаете незнакомую функцию, переключаетесь в браузер через Alt+Tab, ищете документацию, читаете страницу, возвращаетесь в редактор и пытаетесь вспомнить, на чём остановились. Или спрашиваете ИИ и получаете ответ, который может не опираться на эталонную актуальную документацию.
- Теперь: спрашиваете Claude или свой ИИ-инструмент напрямую, получаете ответ на основе эталонной актуальной документации и продолжаете писать код! Документация 🤝 эталонный источник.
Мы также добавили набор инструментов документации продукта в Developer agent в dbt — приблизив документацию к пользователям платформы dbt и Studio IDE. 🎉
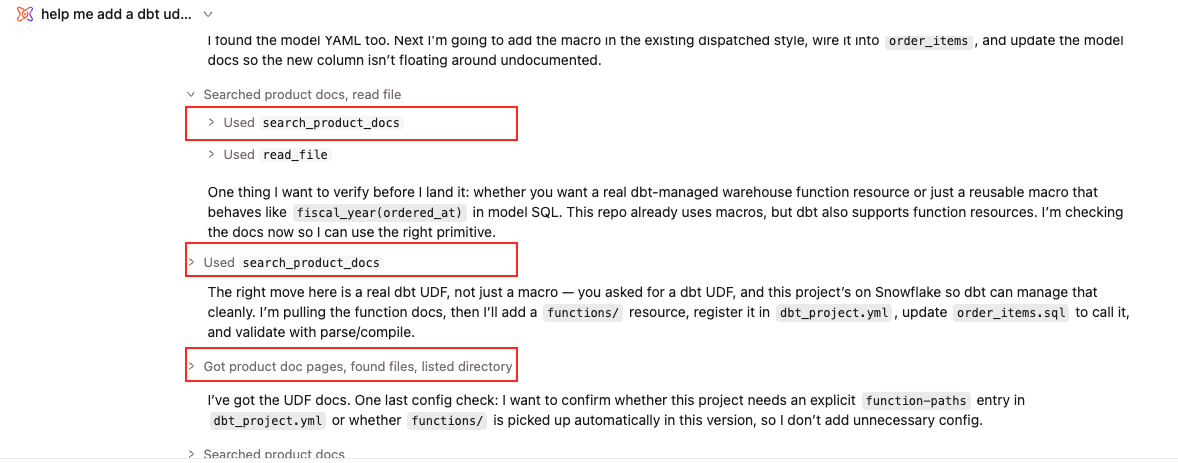 Developer agent использует инструменты документации продукта
Книга доставлена. Переключать контекст не пришлось.
С момента добавления инструментов документации в марте пользователи из более чем 1000 уникальных аккаунтов dbt обращались к документации через MCP-сервер dbt — и каждый такой вызов означает, что пользователю не пришлось прерывать рабочий процесс, чтобы найти нужную документацию. Это победа и для пользователей, и для команды документации.
И использование быстро растёт: 338 вызовов инструментов документации в марте (месяце запуска), 1 113 в апреле и уже более 6 000 в мае.
И большинство этих вызовов поступает от агентов — автономных инструментов, которые выполняют многошаговые задачи и получают документацию от имени пользователя по ходу работы. Это иной сценарий использования, чем разовый ответ чат-ассистента: документацию не просто просматривают, её включают в сам рабочий процесс.
Для аналитиков, изучающих общий проект, это возможность понять, что делает модель, не переходя на отдельную вкладку. Для команд, работающих с разными конфигурациями dbt, — согласованные и достоверные ответы независимо от того, где они работают и кто задаёт вопрос. Для команды документации это значит, что наш труд по написанию и поддержке docs.getdbt.com приносит больше пользы, чем раньше, — достигая пользователей именно там, где они работают.
 Эмили радуется, что документация теперь доступна через MCP-сервер
Что дальше
Это лишь первая страница новой главы. Но, продолжая улучшать работу с документацией, мы уже планируем несколько следующих шагов:
- Получение документации с учётом версии: сейчас эти инструменты возвращают актуальную документацию. Разработчик на dbt Core v1.10, спрашивающий об инкрементальных стратегиях, получает документацию 2026 года. Маршрутизация с учётом версии — возврат нужной страницы для нужной версии dbt — станет следующим существенным улучшением, и мы уже работаем над этим!
- Более умное ранжирование поиска: релевантность — это хорошо. Релевантность, настроенная с учётом специфических понятий dbt и типичных запросов, была бы ещё лучше.
- Пробелы в документации как сигнал: данные об использовании показывают, какие страницы хорошо отвечают на вопросы, а какие заставляют пользователей продолжать поиски. Если находить отсутствующие, недостаточно подробные или устаревшие материалы и исправлять их, следующий пользователь получит более точный ответ.
- Отдельный API или MCP-сервер документации dbt: возможно? Сейчас это не лучшее решение — правильнее начать с единого продукта и существующего активно используемого сервера, — но в будущем отдельный сервер документации, возможно, сможет охватить все MCP-клиенты независимо от того, используют ли они MCP-сервер dbt вообще?
Попробуйте!
-
Если вы впервые работаете с MCP-сервером, руководство по быстрому старту поможет настроить как локальное, так и удалённое подключение.
-
Если вы уже подключены к MCP-серверу dbt, инструменты документации продукта доступны прямо сейчас. Подробности — в справочнике доступных инструментов MCP.
Будем рады вашим отзывам! Создайте issue в github.com/dbt-labs/docs.getdbt.com, чтобы сообщить об ошибках, опечатках, неверной информации и т. п., — или найдите меня в Slack-сообществе dbt.
Заключение
На самом деле слова Миранды о небесно-голубом свитере были не о моде. Они были о невидимых цепочках — последствия каждого осознанного решения простираются дальше, чем может увидеть принявший его человек, а качество источника определяет всё, что происходит дальше.
Именно в такой точке сейчас находится документация. Раньше решения команды документации — что включить, как выстроить структуру, где есть пробелы — распространялись медленно. Разработчик мог столкнуться с ними через поиск Google, ссылку на Stack Overflow или вообще никогда! Теперь эти решения приходят в ИИ-инструмент разработчика, собранные в материал, на основе которого можно действовать, — так же, как Книга прибывает в квартиру Миранды. Разработчики просматривают его, принимают решение и выпускают код. Им не нужно видеть каждое решение в цепочке. Нужно лишь, чтобы цепочка до них дошла.
Мы больше не движемся с черепашьей скоростью. Поток несётся быстро. А дьявол? Он кроется в документации.
Мирна Вонг — технический писатель в dbt Labs, которая любит длинные тире, отсылки к поп-культуре и писать о dbt и ИИ. Документация продуктов dbt имеет открытый исходный код — ваши изменения и сообщения о проблемах всегда приветствуются в github.com/dbt-labs/docs.getdbt.com.