Перейти к основному содержимому

Data ecosystem

Walkthroughs of how top data practitioners use tools in the modern data stack.

Посмотреть все теги

dbt_context_engineering: моделирование контекста, который читают ваши ИИ-агенты
· 14 мин. чтения
Stephen Thibeault
Senior Resident Architect

Сейчас каждая компания пытается применить ИИ к собственным данным, и большинство сталкивается с одной и той же проблемой: самое сложное — не модель. Качество ответа агента всегда ограничено качеством стоящего за ним контекста, а в большинстве организаций этот контекст никогда не моделировали для машинного чтения.

Традиционно перед нашим сообществом ставили задачу создавать аналитические системы, с помощью которых команды могли бы оценивать измеримые результаты своей работы, и эта работа уже приносит пользу ИИ: сегодня агент может получить управляемую, протестированную метрику через семантический слой. Но причины, стоящие за цифрами, скрыты в расшифровках звонков, обсуждениях с поддержкой и договорах, до которых аналитические инструменты раньше не могли добраться. У подготовки этих данных к тому, чтобы ИИ мог их находить, доверять им и ссылаться на них, есть название: инженерия контекста. Мы считаем, что сообщество dbt обладает уникальными возможностями, чтобы возглавить развитие этой практики.

В основе этого убеждения — наблюдение: инженерия контекста не новая дисциплина, которую нужно осваивать с нуля. Это аналитическая инженерия, ориентированная на нового потребителя. Практики, которые сделали ваши метрики надежными (контроль версий, тестирование, документирование, отслеживание происхождения данных), — именно то, чего сегодня не хватает контексту для ИИ. Поэтому мы выпускаем dbt_context_engineering — пакет с открытым исходным кодом, который переносит первый набор паттернов инженерии контекста в уже знакомый вам фреймворк. В этой статье мы расскажем, что входит в пакет, какие возможности он открывает и почему остальные подходы мы хотим вырабатывать вместе с сообществом.
В чём разница между dbt и dbt OSS?

· 10 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

В рамках выпуска общедоступной версии dbt v2 мы переименовали два дистрибутива, чтобы отразить их место в экосистеме. Движок dbt Fusion теперь называется просто dbt, а dbt Core v2 теперь называется dbt OSS. Мы ожидаем, что большинство пользователей, переходящих на dbt v2, выберут основной дистрибутив dbt, который можно бесплатно использовать и устанавливать локально.

Изменение названий не меняет нашей приверженности открытому исходному коду: полностью открытая реализация стандарта dbt существует и будет существовать всегда. Весь код, который мы перевели с ELv2 или проприетарных лицензий на Apache 2.0 в июне, остаётся под этой лицензией, а переход на общую основу (вместо сохранения dbt Core на устаревшем движке Python) делает версию dbt с открытым исходным кодом сильнее.

Переход к двум свободно используемым дистрибутивам с общей основой — главный источник путаницы, с которым мы столкнулись во время бета-тестирования v2. Эта статья поможет объяснить различия между dbt и dbt OSS и подскажет, какой дистрибутив вам стоит выбрать.

dbt v2.0 выходит в общедоступный релиз

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

После 18 месяцев разработки, обратной разработки, разбора и повторной сборки движок dbt Fusion вышел в общедоступный релиз под новым именем: dbt. (Подробнее об этом читайте здесь). Эта полностью переписанная версия dbt решает ряд давних проблем реализации dbt v1 и закладывает основу для следующего десятилетия развития. Раньше:

  • dbt не понимал SQL, который генерировал, поэтому не мог предупреждать о некорректном коде без его выполнения и расходования вычислительных ресурсов.
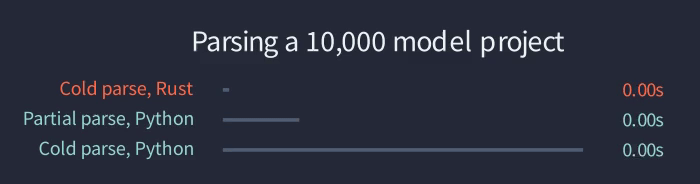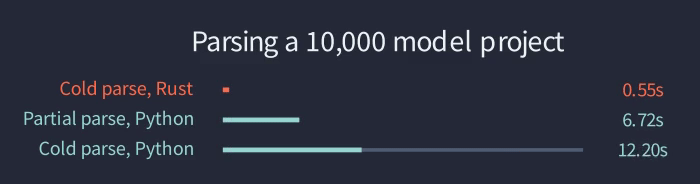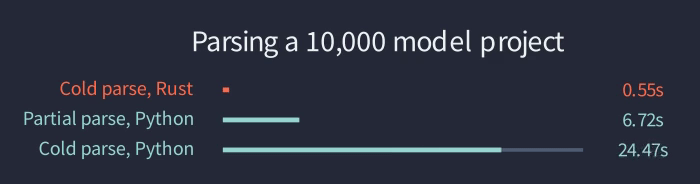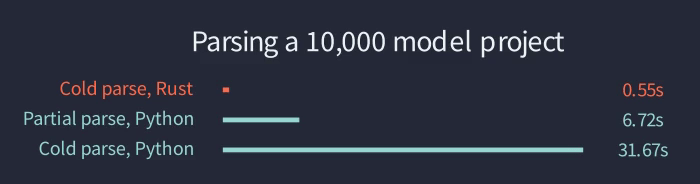
  • В крупных проектах разбор проекта в dbt мог занимать до 20 минут, прежде чем можно было приступить к выполнению.
  • Артефакты dbt затрудняли взаимодействие между инструментами: единственным способом передачи данных из одного продукта в другой были огромные JSON-файлы.
  • Многие команды не могли пользоваться dbt docs из-за проблем с масштабированием и производительностью.

Новый dbt v2:

  • Глубоко понимает SQL и позволяет обнаруживать ошибки в коде до его отправки в хранилище, экономя время и деньги разработчиков и обеспечивая агентам циклы работы с проверяемыми результатами.
  • Создан с упором на скорость во всех аспектах благодаря переходу на оптимизированный исполняемый файл на Rust и использованию современных технологий, таких как ADBC. Мы видели проекты, разбор которых раньше занимал 20 минут, а теперь завершается менее чем за минуту. Проекты более типичного размера тоже получат значительное ускорение в повседневной работе (например, компиляция станет быстрее в 2 раза или более).
  • Представляет dbt Information Schema, которая описывает весь проект в виде стандартных файлов Parquet. Это позволяет уменьшить размер файлов более чем в 10 раз, при этом предоставляя более полные данные, и обеспечивает быстрое выполнение запросов через dbt show --info, внешние инструменты, такие как DuckDB, и совершенно новую функцию checks.
  • Включает совершенно новую версию dbt docs, которая гораздо лучше масштабируется.

MCP-сервер dbt теперь в Claude: управляемый контекст — достаточно войти в аккаунт

· 7 мин. чтения
Alex Noonan
Senior Developer Experience Advocate

Когда мы открыли исходный код MCP-сервера dbt в апреле 2025 года, это был экспериментальный проект для локального запуска с чёткой идеей: структурированные данные будут глубоко интегрированы в рабочие процессы с ИИ, а dbt станет слоем, предоставляющим управляемый контекст, на котором эти процессы основаны. Anthropic помогла подтвердить нашу гипотезу. Естественным следующим шагом стала облачная версия с удалённой аутентификацией через OAuth, чтобы вы могли использовать её с любым удобным для вас ИИ-инструментом.

Теперь удалённый MCP-сервер dbt работает внутри dbt platform, и вы можете подключить его к Claude за одну-две минуты: достаточно войти в аккаунт и пройти аутентификацию. Вы добавляете dbt как коннектор, подтверждаете нужные права доступа, и Claude получает доступ к вашим управляемым данным и обширным метаданным dbt.

В этой статье мы рассмотрим, какие возможности удалённый сервер открывает в Claude, для каких рабочих процессов людей и агентов он подходит и как инструменты взаимодействуют, оказавшись в одном диалоге.

Встречайте dbt Core v2: по-прежнему с открытым исходным кодом, теперь на новой основе для будущего

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Grace Goheen
Product Manager, dbt Core at dbt Labs

Сегодня мы опубликовали первую альфа-версию dbt Core 2.0, подняв планку того, чего пользователи dbt могут ожидать от своего инструмента трансформации данных. Как и прежде, исходный код dbt Core полностью открыт под лицензией Apache 2.0. Этот выпуск особенно важен потому, что dbt Core 2.0 теперь построен на той же основе, что и движок dbt Fusion: мы впервые открыли исходный код значительной части Fusion.

Выпуск dbt Core 2.0 включает ряд важных функциональных улучшений:

  • Значительное сокращение времени разбора, особенно для самых крупных проектов dbt
  • Строго определённая спецификация языка, которая не позволит случайно задать desciptin вместо description и предоставляет всем, кто создаёт интеграции с экосистемой dbt (включая собственную команду разработки dbt!), стабильный интерфейс для разработки.
  • Новые артефакты в формате Parquet как высокопроизводительная альтернатива большим JSON-файлам, к которым можно напрямую обращаться с запросами через DuckDB или агента на ваш выбор
  • Полностью переработанная локальная документация, которая использует новые артефакты и масштабируется для проектов любого размера.
  • Более простой способ создания новых адаптеров на базе ADBC и экосистемы Arrow
  • Упрощённый процесс установки, избавляющий от необходимости бороться с виртуальными окружениями Python

Помогите своему ИИ лучше работать с данными с помощью навыков агентов dbt

· 13 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

Создание и развитие лучших практик силами сообщества — пожалуй, главная движущая сила роста dbt и аналитической инженерии: рабочие процессы и подходы, которые можно перенимать, позволяют каждому создавать и распространять знания внутри организации. На заре развития dbt файл dbt_style_guide.md от dbt Labs Fishtown Analytics содержал основополагающие рекомендации для всех, кто впервые знакомился с подходом dbt.

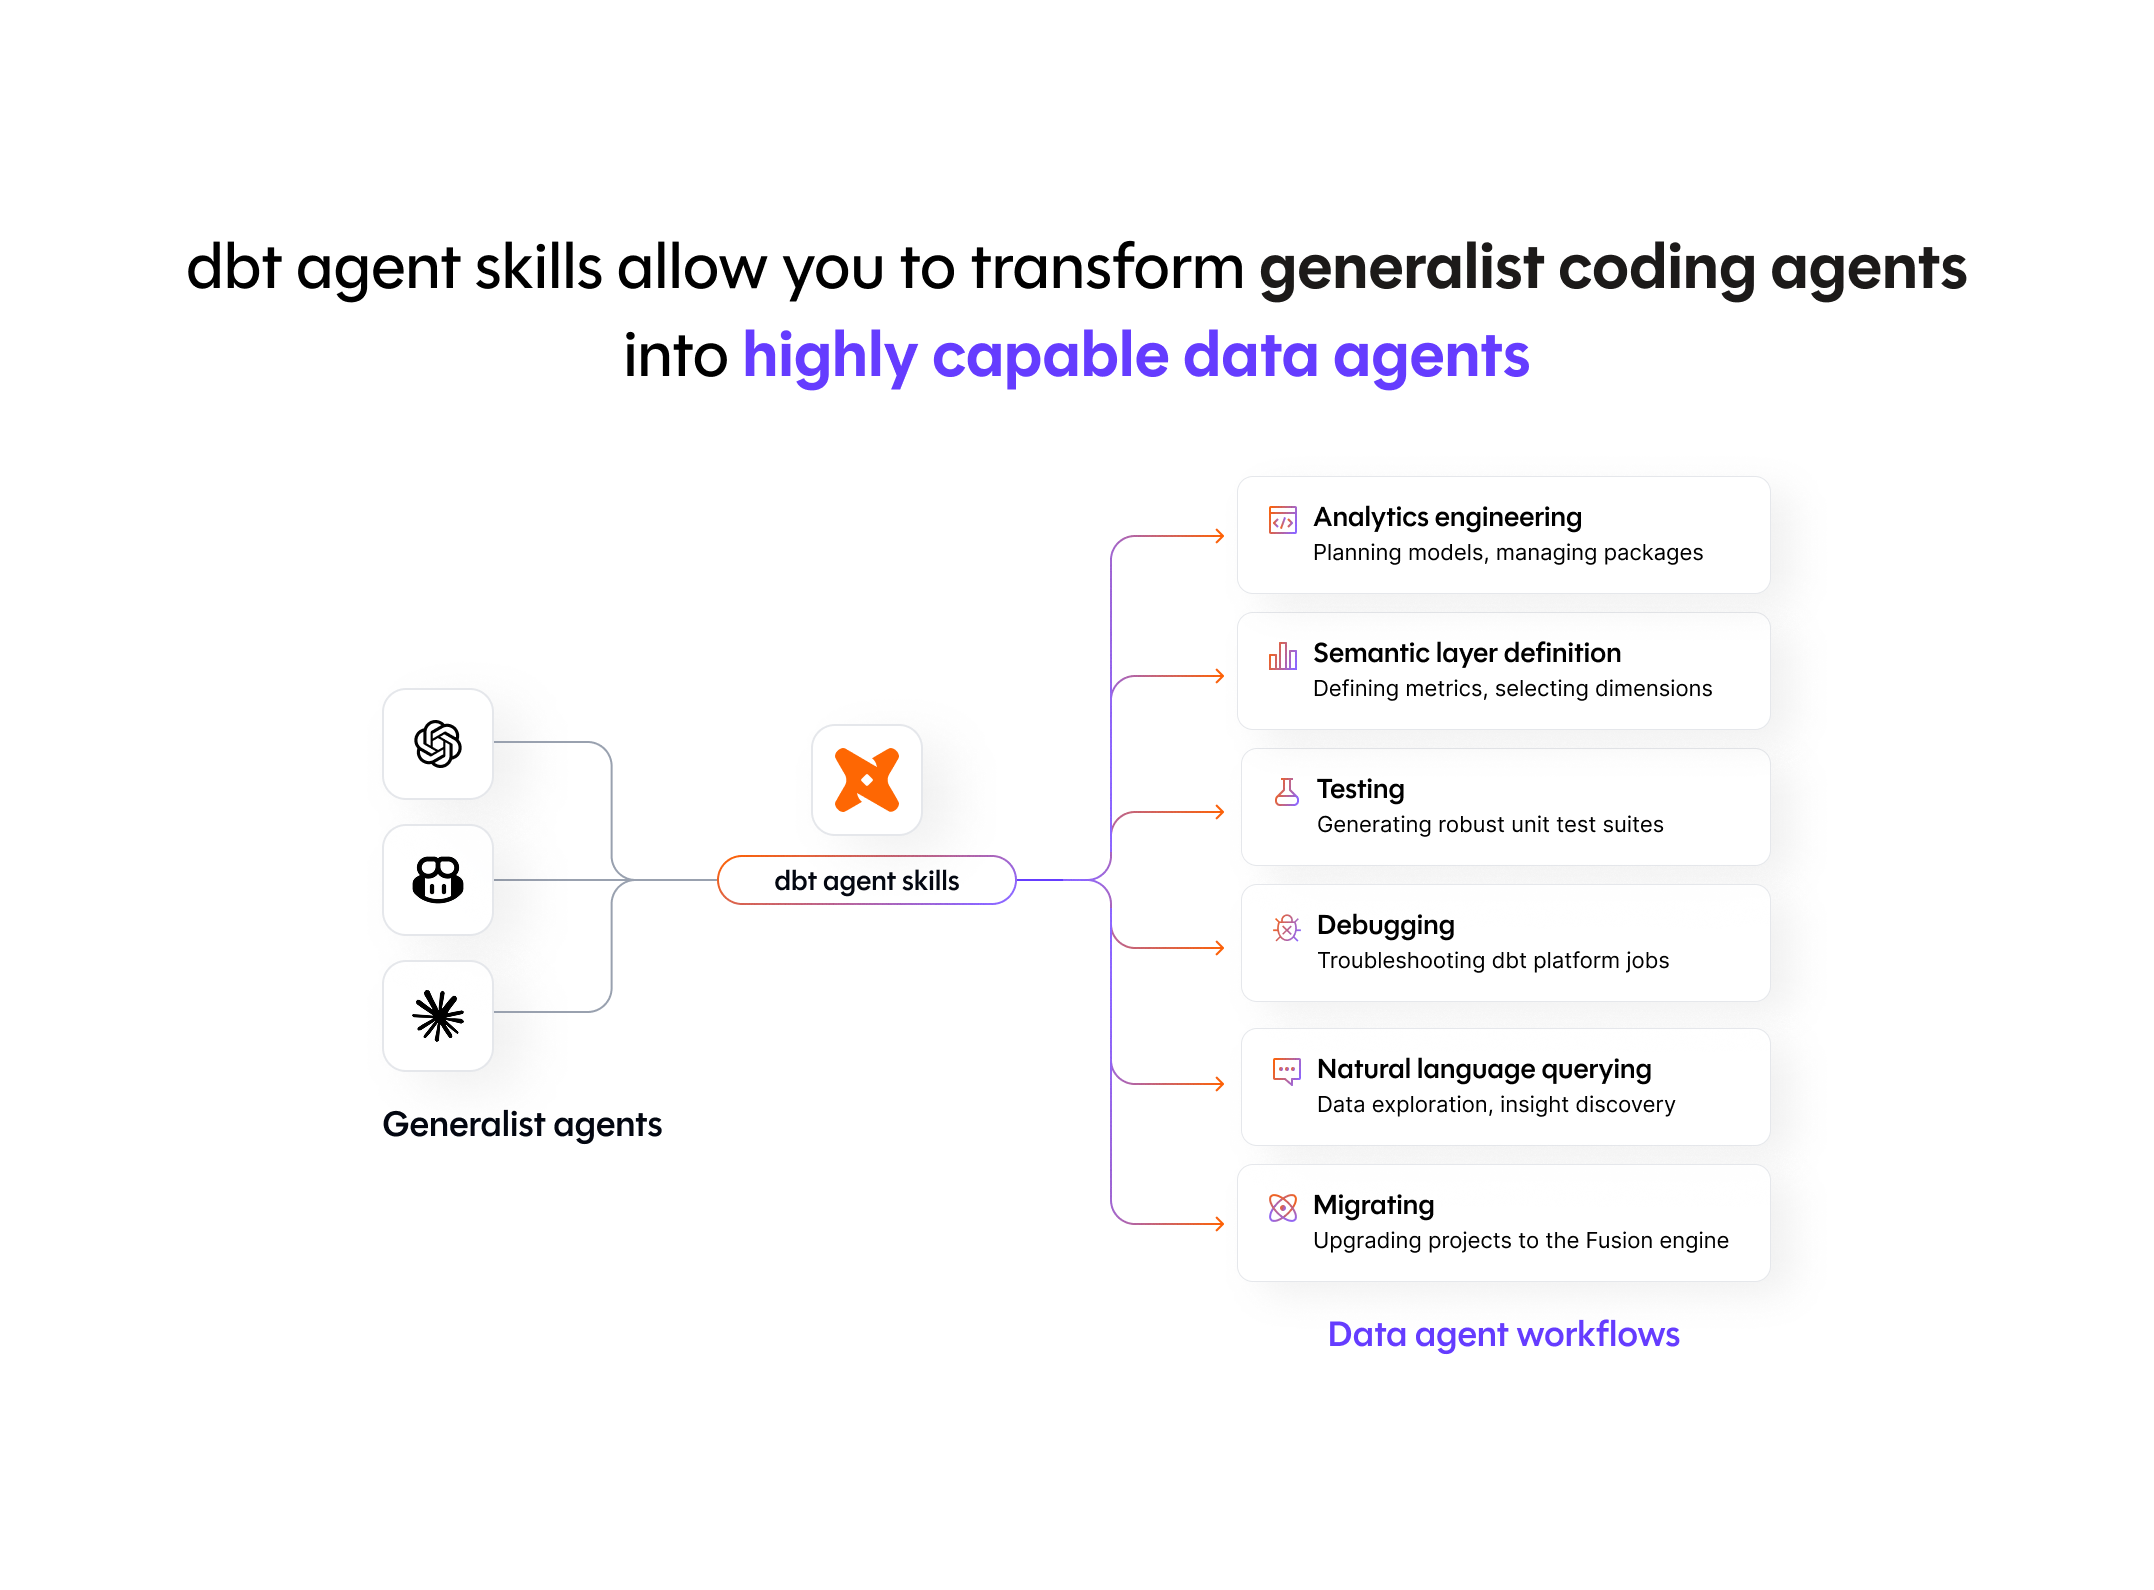
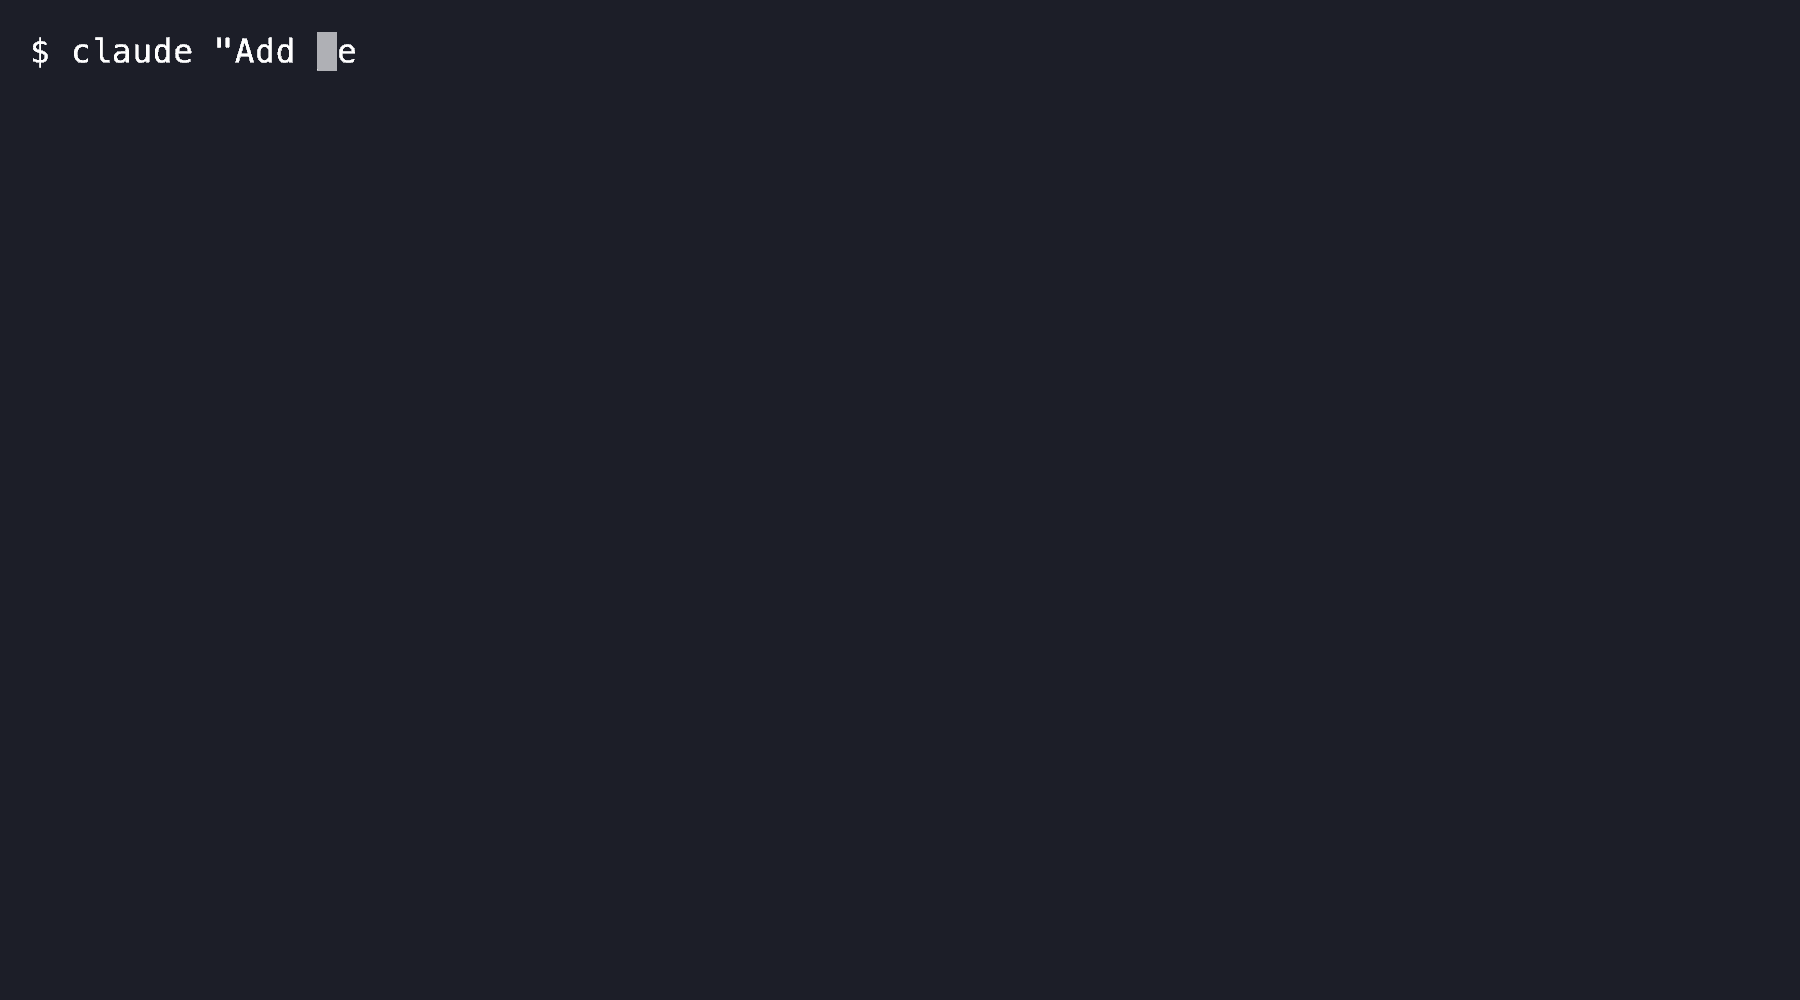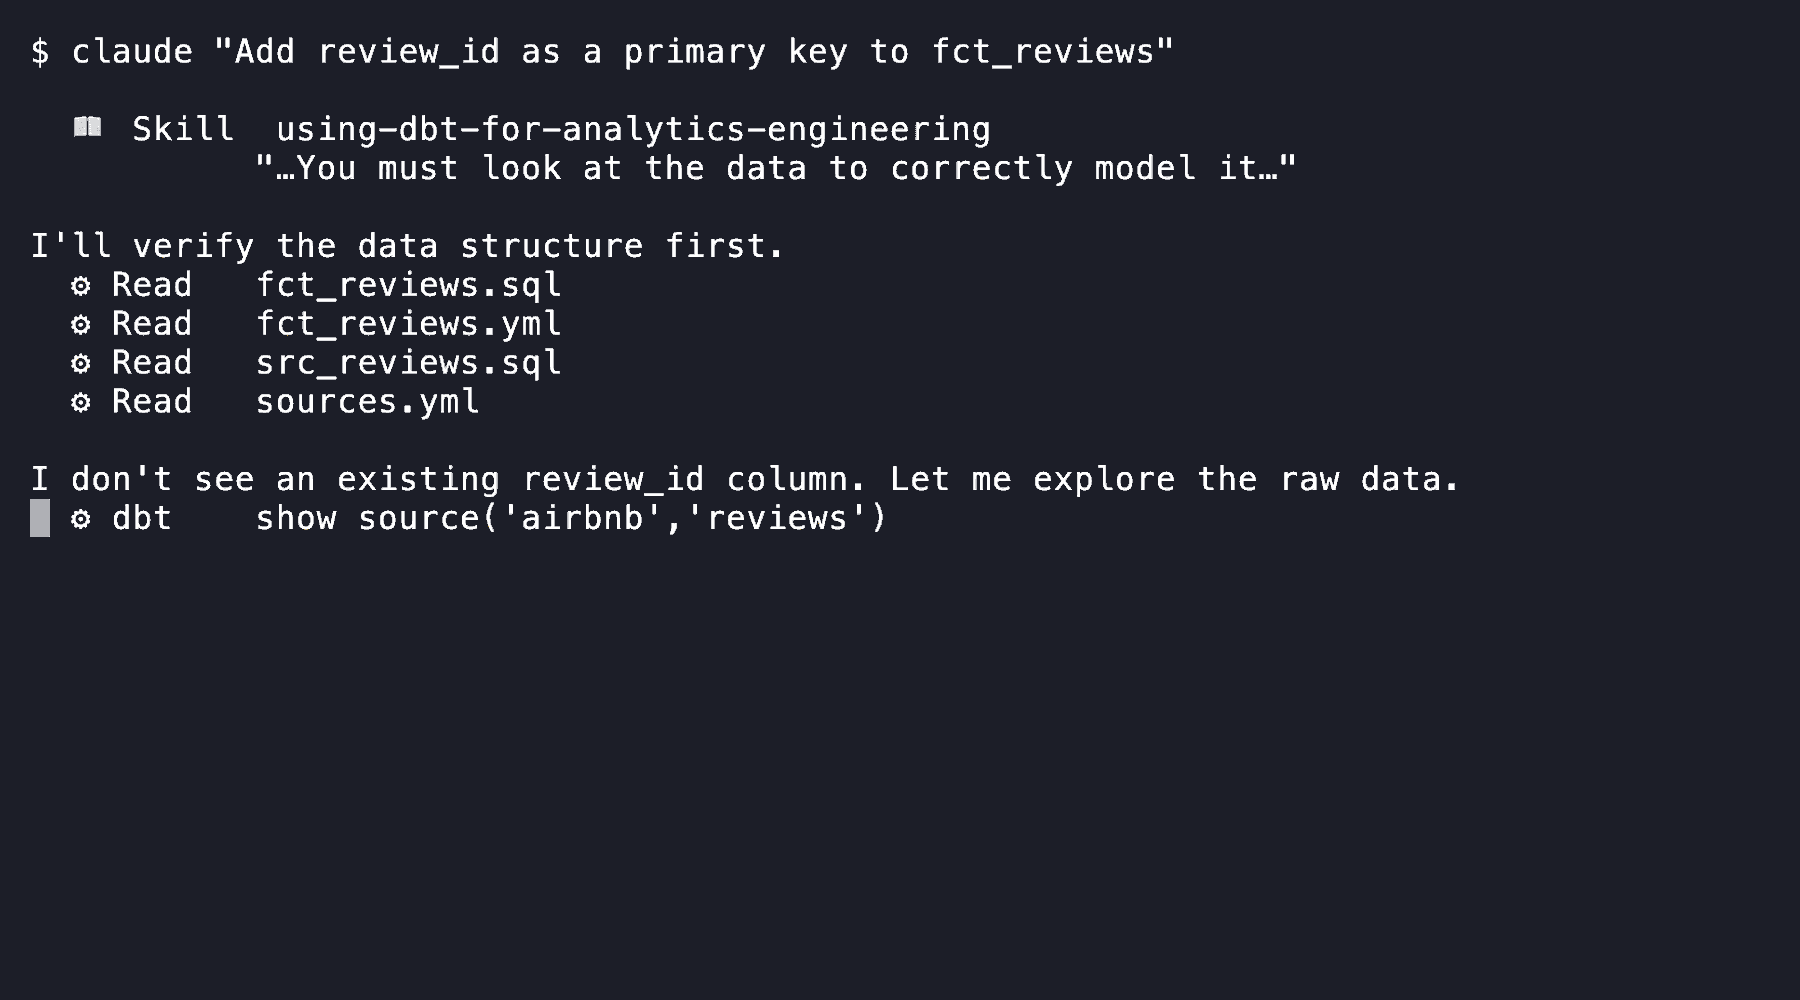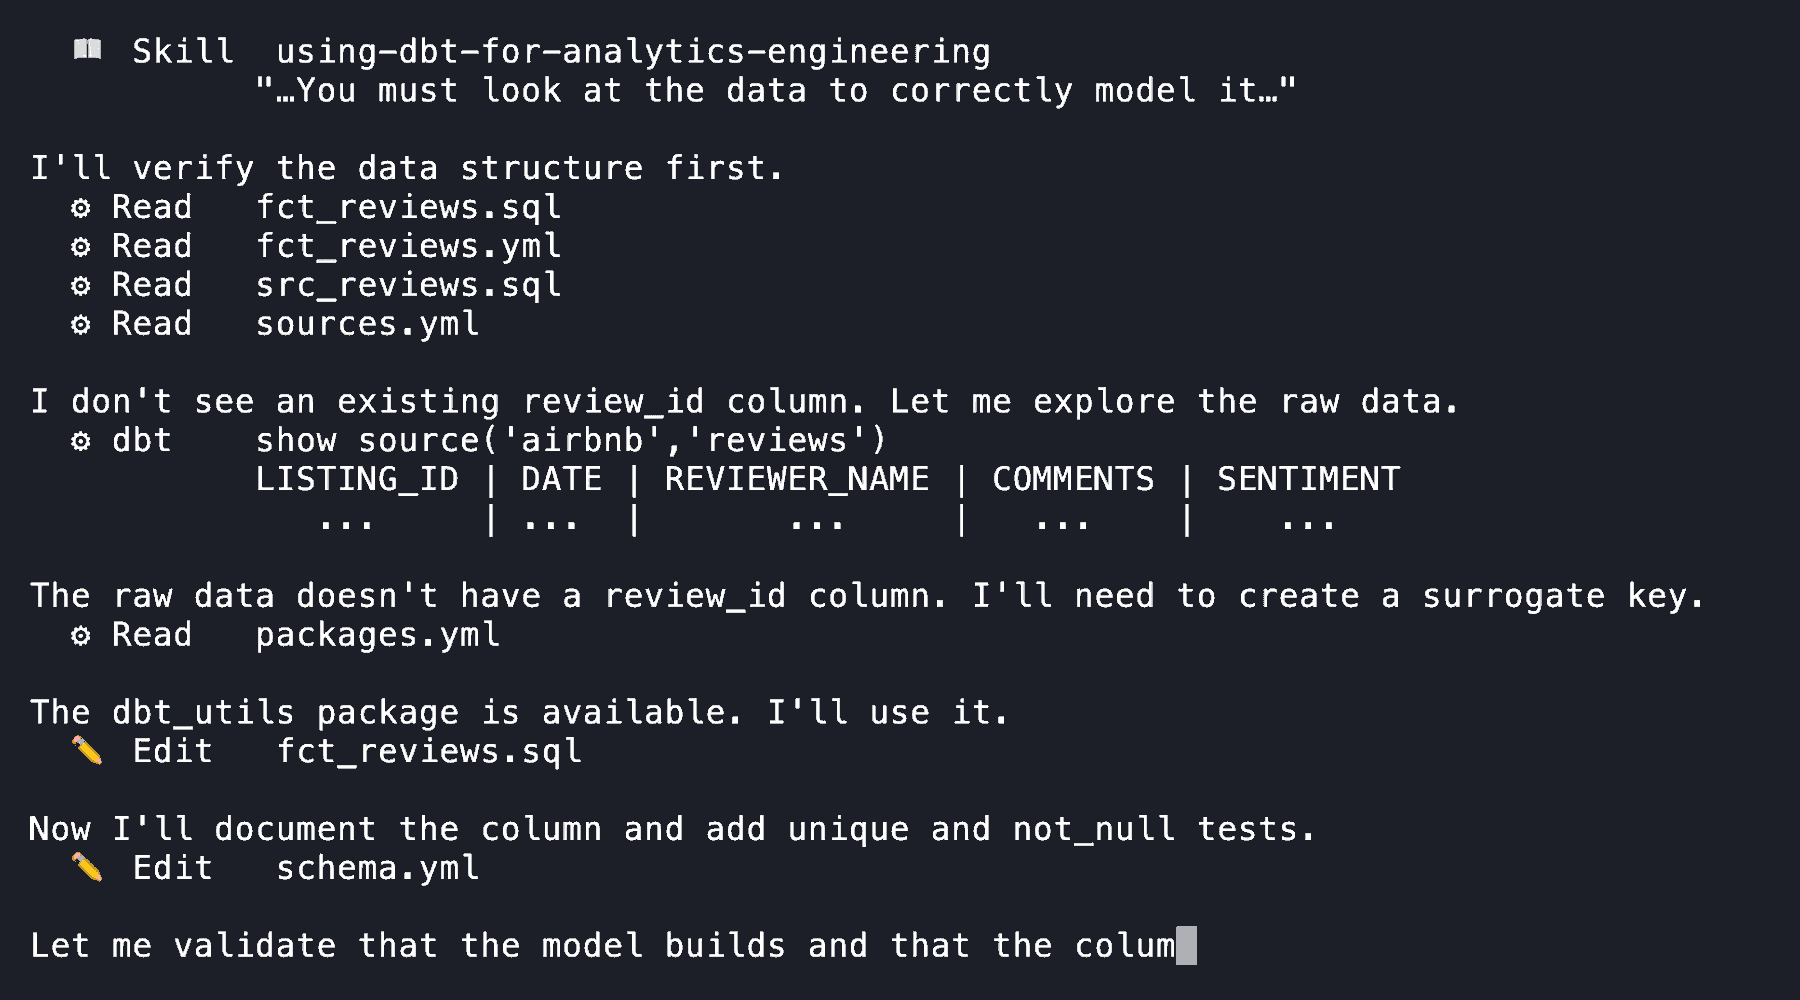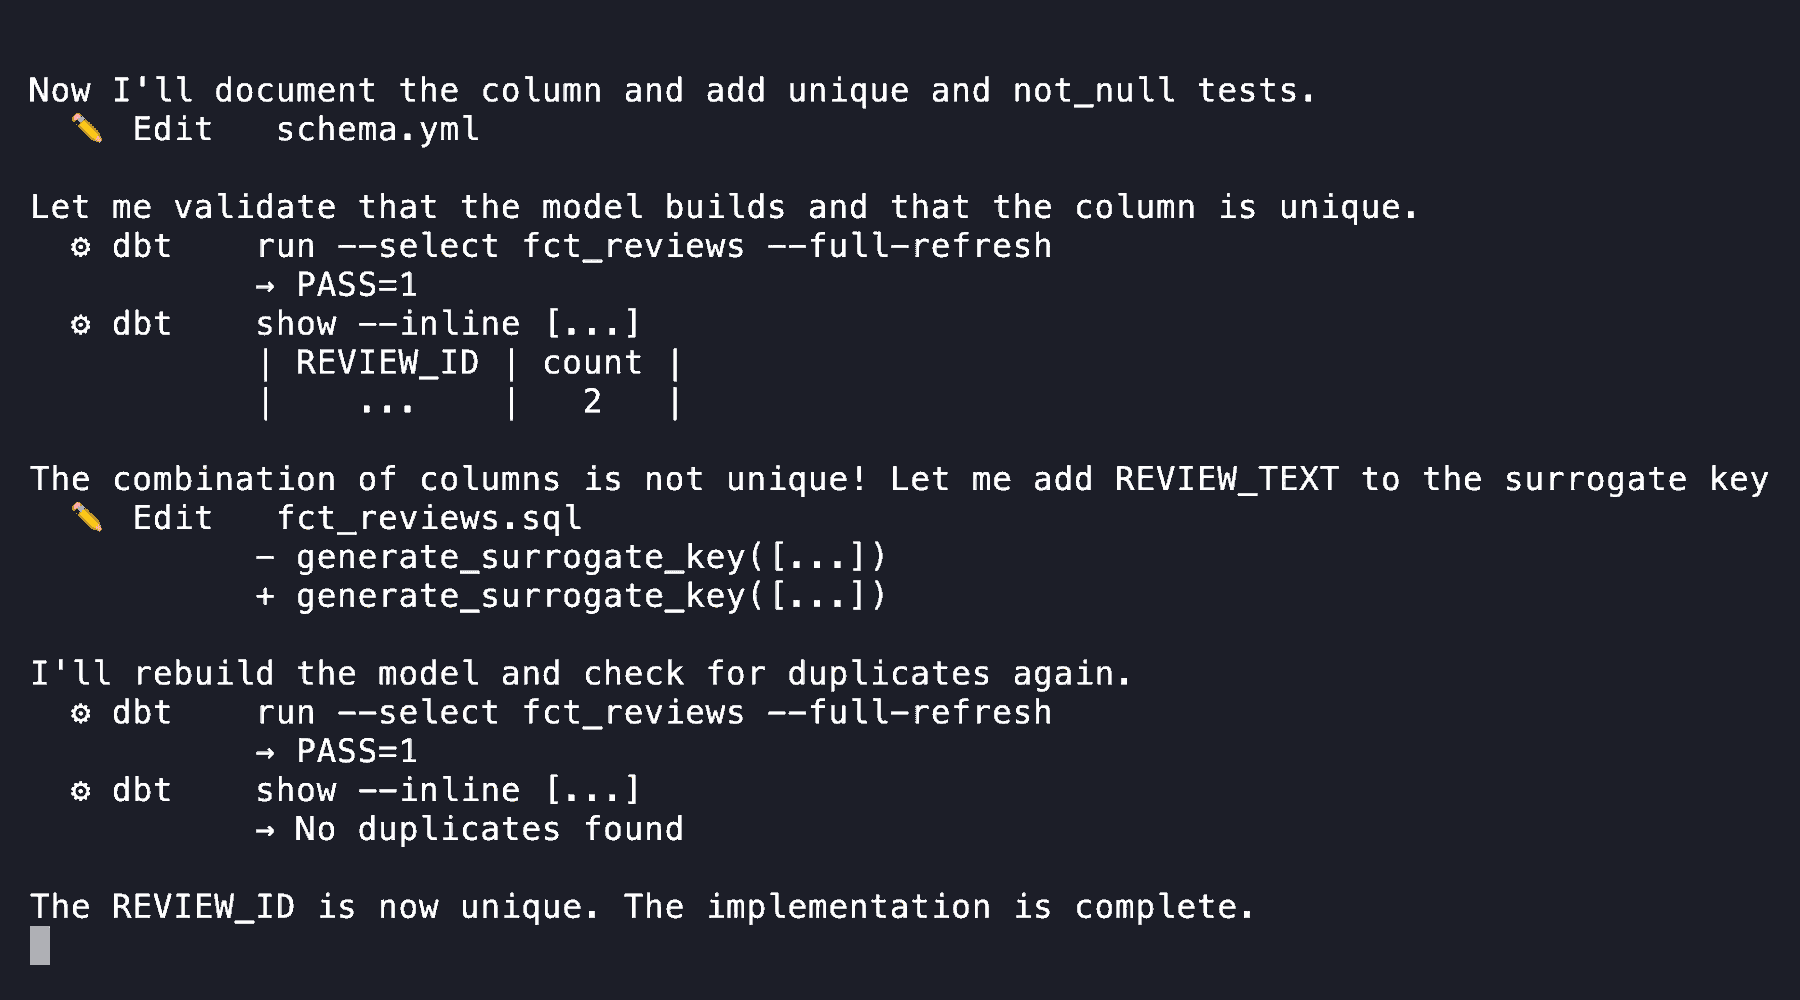
Сегодня мы выпустили набор навыков агентов dbt, чтобы ИИ-агенты (такие как Claude Code, Codex от OpenAI, Cursor, Factory или Kilo Code) могли следовать тем же лучшим практикам dbt, которых вы ожидаете от любого участника, работающего с вашей кодовой базой. Это важно, потому что, расширяя базовые возможности агентов, навыки позволяют превратить универсальных агентов для программирования в высококвалифицированных агентов для работы с данными.

Схема, показывающая, как навыки агентов dbt превращают универсальных агентов для программирования в специализированных агентов для работы с данными, способных заниматься аналитической инженерией, определением семантического слоя, тестированием, отладкой, запросами на естественном языке и миграциейНавыки агентов dbt позволяют превратить универсальных агентов для программирования в высококвалифицированных агентов для работы с данными

Эти навыки объединяют обширные знания, накопленные сообществом dbt и командой Developer Experience в dbt Labs на основе практического опыта. За ними стоят десятки часов целенаправленной работы экспертов dbt, подкреплённые годами использования dbt.

Анимация, показывающая, как Claude использует навык аналитической инженерии для проверки своей работыИмея доступ к навыкам, такие агенты, как Claude, подходят к задачам системно

Модернизация спецификации Semantic Layer

· 5 мин. чтения
Dave Connors
Product Manager at dbt Labs

Новый движок — кто это у нас?​

Вряд ли кто-то из читателей этого блога ещё не слышал о новом движке dbt Fusion — о нём говорят все в мире данных с января прошлого года, а кульминацией стала легендарная живая демонстрация Элиаса на Coalesce 2025, показавшая невероятные возможности, которые открывает встроенное понимание SQL в dbt. Если вы были на Coalesce или уже перевели свой проект на Fusion, то, скорее всего, слышали и об изменениях, которые мы внесли в средства описания проектов dbt (то есть непосредственно в код, который вы пишете в проекте). Выпуская новую мажорную версию, мы воспользовались возможностью упростить и стандартизировать язык конфигурации dbt, чтобы он был готов к масштабированию в новую эпоху аналитической инженерии.

В частности, мы хотели пересмотреть подход к определению метрик в dbt Semantic Layer. На протяжении многих лет мы слышали от участников сообщества, что определять метрики попросту сложно. Обсудив это с внутренними и внешними пользователями, а также с нашими новыми друзьями из SDF, мы разработали обновлённую спецификацию YAML: она проще, лучше вписывается в привычный и любимый нами подход к настройке dbt и рассчитана на будущее.

Создание удалённого dbt MCP Server

· 7 мин. чтения
Devon Fulcher
Senior Software Engineer at dbt Labs

В апреле мы выпустили локальный dbt MCP (Model Context Protocol) server как open source‑проект для подключения AI‑агентов и LLM к доверенным dbt‑ассетам с прямым, управляемым доступом. dbt MCP server предоставляет универсальный, открытый стандарт для соединения AI‑систем с вашим структурированным контекстом, что позволяет сохранять точность, управляемость и надежность агентов. Подробнее — в разделе About dbt Model Context Protocol.

С момента релиза локального dbt MCP server сообщество dbt применяло его самыми разными способами, включая агентную разговорную аналитику, исследование дата‑каталога и рефакторинг dbt‑проектов. Однако одним из ключевых отзывов от AI‑инженеров стало то, что локальный dbt MCP server сложно развертывать и хостить для мультиарендных (multi‑tenant) нагрузок, из‑за чего становится трудно строить приложения поверх dbt MCP server.

Именно поэтому мы рады представить новый способ интеграции с dbt MCP — remote dbt MCP server. Remote dbt MCP server не требует установки зависимостей или запуска dbt MCP server в вашей инфраструктуре, что делает разработку и запуск агентов проще, чем когда‑либо. Он доступен уже сегодня в public beta для пользователей с тарифами dbt Starter, Enterprise или Enterprise+, и готов к использованию для создания AI‑приложений.

Новый плагин dbt для VS Code: опыт, которого мы все ждали

· 7 мин. чтения
Bruno Souza de Lima
Lead Data Engineer at phData

Привет, сообщество!

Меня зовут Бруно, и, возможно, вы видели мои посты про dbt в LinkedIn. Если нет — давайте познакомимся. Я начал работать с dbt более 3 лет назад. В то время я только осваивал этот инструмент и, чтобы лучше в нём разобраться, начал создавать материалы, которые помогали мне учиться. Один из них — шпаргалка по dbt — и стал отправной точкой моего пути в сообществе.

От этой шпаргалки я перешёл к созданию самых разных материалов, участию и активному взаимодействию с сообществом, и в итоге дважды получил награду dbt community award. Я очень благодарен за это и по-настоящему горжусь.

С момента приобретения SDF Labs компанией dbt Labs я ждал дня, когда мы увидим результат слияния этих двух компаний. Спойлер: это dbt Fusion engine — и он оказался даже лучше, чем я ожидал.

Компоненты движка dbt Fusion и то, как они сочетаются друг с другом

· 10 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Сегодня мы анонсировали движок dbt Fusion.

Fusion — это не какая‑то одна вещь. Это набор взаимосвязанных компонентов, которые вместе обеспечивают работу следующего поколения аналитической инженерии.

В этом посте мы разберём каждый элемент архитектуры Fusion, объясним, как они сочетаются друг с другом, и проясним, что именно доступно вам в зависимости от того, компилируете ли вы Fusion из исходного кода, используете наши готовые бинарные сборки или разрабатываете внутри продукта, построенного на dbt Fusion.

От движка на Rust до расширения VS Code, от новых адаптеров на базе Arrow до базовых технологий под лицензией Apache — мы подробно разберём, что делает каждый компонент, под какой лицензией он распространяется (о причинах см. сопутствующий пост Тристана), а также как вы можете начать использовать Fusion и принять участие уже сегодня.

Путь к GA: как движок dbt Fusion проходит путь от беты к продакшену

· 12 мин. чтения
Jeremy Cohen
Principal Product Manager at dbt Labs
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Сегодня мы объявили, что движок dbt Fusion доступен в бета-версии.

  • Если Fusion уже работает с вашим проектом — отлично! Вас ждёт много приятного 😄
  • Если это ваш первый день с dbt — добро пожаловать! Начинайте сразу с Fusion — вас тоже ждёт приятный опыт.

Сегодня — Launch Day, первый день новой эры: Эпохи Fusion. Мы ожидаем, что многие команды с существующими проектами столкнутся как минимум с одной проблемой, которая помешает использовать движок dbt Fusion в продакшене. И это нормально!

Мы активно работаем над тем, чтобы разблокировать всё больше команд, и берём на себя обязательство, что к моменту достижения Fusion статуса General Availability:

  • Мы будем поддерживать Snowflake, Databricks, BigQuery, Redshift — а также, вероятно, Athena, Postgres, Spark и Trino — с новым паттерном адаптеров Fusion.
  • Мы покроем (практически) весь функционал dbt Core. Некоторые вещи сложно или нецелесообразно воспроизводить вне Python, а некоторые используются настолько редко, что мы будем реагировать на них по мере необходимости. При этом многие существующие поведения dbt Core будут улучшены за счёт уникальных возможностей движка dbt Fusion — таких как скорость и глубокое понимание SQL. Вы увидите обсуждения этого в соответствующих GitHub issues, на многие из которых мы ссылаемся ниже.
  • Репозиторий с открытым исходным кодом dbt-fusion будет содержать больше функциональности, чем доступно в dbt Core сегодня. (Подробнее об этом здесь.)
  • Опыт разработчика станет ещё быстрее и интуитивнее.

Пока что всё это ещё не реализовано — но вы можете видеть, куда мы движемся. Для этого и существуют беты, это путь, по которому мы идём вместе, и именно поэтому мы хотим вовлечь вас всех.

Знакомьтесь с dbt Fusion Engine: новый индустриальный движок для dbt на Rust

· 9 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

TL;DR: что нужно знать​

  • Привычный интерфейс разработки dbt остаётся неизменным, но лежащий в его основе движок выполнения полностью обновлён.
  • Новый движок называется dbt Fusion engine — он полностью переписан на Rust на основе технологии SDF. Движок dbt Fusion значительно быстрее dbt Core и оснащён встроенной технологией понимания SQL, которая обеспечивает поддержку рабочих процессов аналитической инженерии нового поколения.
  • Движок dbt Fusion сейчас находится в стадии бета-тестирования. Вы можете попробовать его уже сегодня, если используете Snowflake, — поддержка дополнительных адаптеров начнёт появляться в начале июня. Ознакомьтесь с нашим планом выхода в общую доступность (GA) и попробуйте руководство по быстрому началу работы.
  • Чтобы использовать Fusion, не обязательно быть клиентом dbt Labs — пользователи dbt Core уже сегодня могут бесплатно использовать движок dbt Fusion в своей локальной среде.
  • Вы можете использовать dbt v2 с новым расширением dbt для VS Code, непосредственно через CLI или в dbt Studio.
  • Это начало новой эры аналитической инженерии. Чтобы узнать, какие возможности движок Fusion откроет в ближайшие 1–2 года, прочитайте эту статью.

Представляем dbt MCP Server — структурированные данные для AI-воркфлоу и агентов

· 12 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

dbt — это стандарт для создания управляемых и надежных датасетов поверх структурированных данных. MCP (Model Context Protocol) демонстрирует всё больший потенциал в качестве стандарта предоставления контекста для LLM, позволяя им эффективно работать в реальных, операционных сценариях.

Сегодня мы открываем исходный код экспериментальной версии dbt MCP server. Мы ожидаем, что в ближайшие годы структурированные данные станут глубоко интегрированы в AI‑воркфлоу, а dbt будет играть ключевую роль в создании и предоставлении этих данных.

Парсер. Лучше. Быстрее. Сильнее: взгляд на новый движок dbt

· 4 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Помните, каким dbt ощущался, когда у вас был небольшой проект? Вы нажимали Enter — и всё начинало происходить практически мгновенно. Мы возвращаем это ощущение.

Совет по бенчмаркингу: всегда старайтесь получать данные, которые достаточно хороши, чтобы вам не пришлось делать по ним статистикуСовет по бенчмаркингу: всегда старайтесь получать данные, которые достаточно хороши, чтобы вам не пришлось делать по ним статистику

После серии подробных разборов, посвящённых внутреннему устройству понимания SQL, давайте немного поговорим о скорости. А именно — об одном из самых раздражающих замедлений по мере роста проекта: парсинге проекта.

Если после запуска dbt вы ждёте несколько секунд или даже минут, прежде чем что-то начнёт происходить, — это потому, что парсинг ещё не завершён. Но в демо SDF от Лукаса на вебинаре в прошлом месяце такого длительного ожидания не было. Почему?

Ключевые технологии, лежащие в основе понимания SQL

· 13 мин. чтения
Dave Connors
Product Manager at dbt Labs

Вы когда‑нибудь задумывались, что на самом деле происходит в базе данных, когда вы отправляете туда (идеальный, эффективный, полный инсайтов) SQL‑запрос?

Ладно, скорее всего — нет 😅. Как бы то ни было, в dbt Labs мы очень много говорим об инструментах SQL Comprehension после приобретения SDF Labs и считаем, что сообществу тоже будет полезно участвовать в этом разговоре. Недавно мы опубликовали пост в блоге о разных уровнях инструментов SQL Comprehension. Если вы его читали, то могли столкнуться с несколькими новыми терминами, с которыми раньше были не очень знакомы.

В этом посте мы подробнее разберём технологии, лежащие в основе инструментов SQL Comprehension. Надеемся, что в итоге у вас появится более глубокое понимание — и уважение — к той непростой работе, которую выполняет компьютер, превращая ваши SQL‑запросы в прикладные бизнес‑инсайты!

Три уровня понимания SQL: что это такое и почему важно о них знать

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

С тех пор как dbt Labs на прошлой неделе приобрела SDF Labs, я с головой погрузился в их технологии, пытаясь во всём разобраться. Главным, что я знал на входе, было: «SDF понимает SQL». Фраза короткая и ёмкая, но детали за ней — по-настоящему захватывающие.

Чтобы следующий этап развития Analytics Engineering оказался таким же трансформирующим, как и предыдущий, dbt должен выйти за рамки строкового препроцессора и начать полноценно понимать SQL. Впервые именно SDF предоставляет технологии, которые делают это возможным. Сегодня мы подробно разберёмся, что вообще означает «понимание SQL» и почему это так важно для того, что нас ждёт дальше.

Почему я хотел бы иметь control plane для моего ремонта

· 4 мин. чтения
Mark Wan
Senior Solutions Architect at dbt Labs

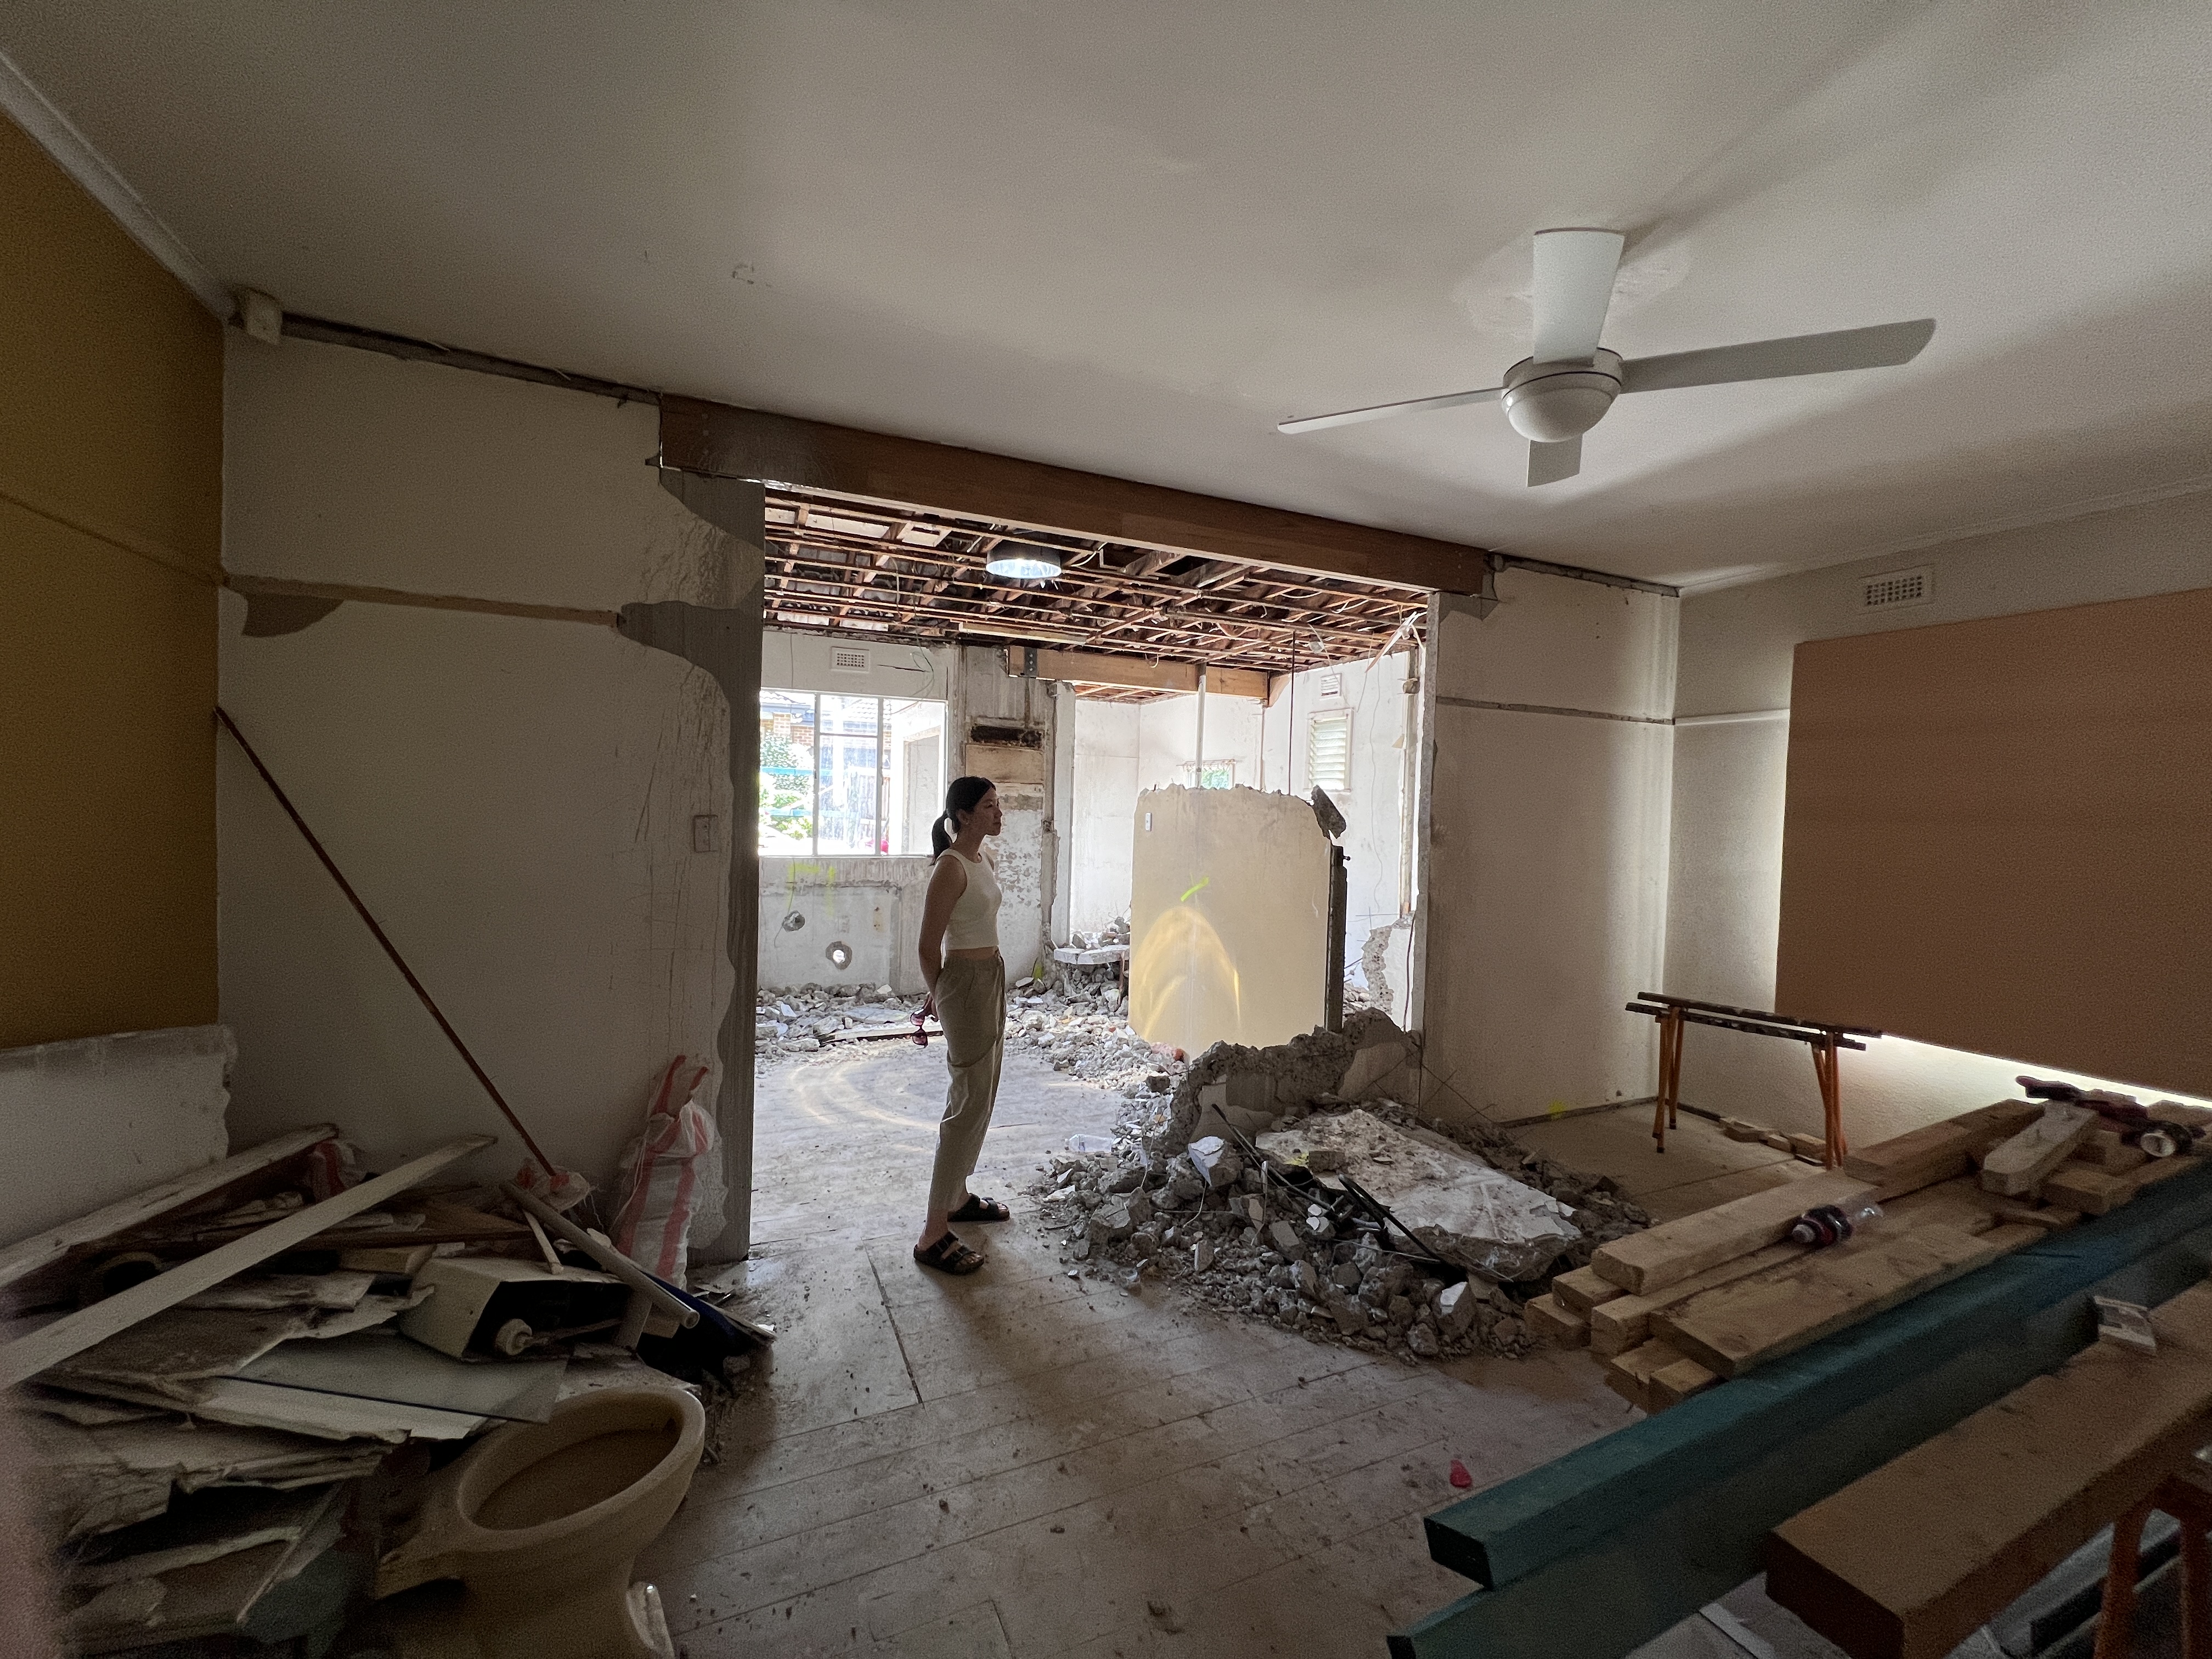
Когда мы с женой делали ремонт дома, мы решили взять на себя роль owner-builder. Это было смелое (и во многом наивное) решение, но нам хотелось контролировать каждый аспект проекта. Чего мы не осознавали, так это того, насколько сложным и изматывающим окажется управление таким количеством движущихся частей.

Моя жена размышляет о нашей вменяемостиМоя жена размышляет о нашей вменяемости

Нам приходилось координировать множество элементов:

  • Архитекторов, которые проектировали планировку, интерьер и экстерьер.
  • Архитектурные планы, описывающие, как должен выглядеть дом.
  • Строителей, которые воплощали эти планы в жизнь.
  • Инспекторов, муниципальные органы и энергоаудиторов, которые проверяли соответствие требованиям и стандартам.

Оптимизация материализованных представлений с помощью dbt

· 10 мин. чтения
Amy Chen
Product Manager at dbt Labs
примечание

Этот блог был обновлен 18 декабря 2023 года, чтобы охватить поддержку MVs на dbt-bigquery и обновления по тестированию MVs.

Введение​

Год был 2020. Я жила в доме, где были только котята, а dbt Labs все еще называлась Fishtown Analytics. Один из корпоративных клиентов, с которым я работала, Jetblue, попросил меня помочь запускать их модели dbt каждые 2 минуты, чтобы соответствовать SLA в 5 минут.

После преодоления первоначального ужаса мы обсудили случай использования и вскоре поняли, что есть лучший вариант. Вместе с моей командой я создала lambda views, чтобы удовлетворить потребность.

Перенесемся в 2023 год. Я пишу это, пока мой огромный пес храпит рядом со мной (не волнуйтесь, коты тоже размножились). Jetblue переросла lambda views из-за ограничений производительности (представление может быть только настолько производительным), и мы находимся на очередной вехе в пути dbt к поддержке потоковой передачи. Какое время!

Сегодня мы объявляем, что теперь поддерживаем материализованные представления в dbt. Итак, что это значит?

Создавайте документацию и тесты для dbt в 10 раз быстрее с ChatGPT

· 7 мин. чтения
Pedro Brito de Sa
Product Analyst at Sage

Независимо от того, создаете ли вы свои конвейеры в dbt впервые или просто добавляете новую модель время от времени, хорошая документация и тестирование всегда должны быть приоритетом для вас и вашей команды. Почему же мы избегаем этого как чумы? Потому что это хлопотно — записывать каждое отдельное поле, его описание простыми словами и выяснять, какие тесты следует провести, чтобы убедиться, что данные в порядке. Как мы можем сделать этот процесс быстрее и менее болезненным?

К настоящему времени все знают о чудесах моделей GPT для генерации кода и парного программирования, так что это не должно быть сюрпризом. Но ChatGPT действительно выделяется в определении контекста полей с длинными названиями из схем таблиц базы данных. Поэтому в этом посте я помогу вам ускорить создание документации и тестов в 10 раз, используя ChatGPT для выполнения большей части работы за вас.

Data Vault 2.0 с dbt Cloud

· 13 мин. чтения
Rastislav Zdechovan
Analytics Engineer at Infinite Lambda
Sean McIntyre
Senior Solutions Architect at dbt Labs

Data Vault 2.0 — это техника моделирования данных, разработанная для масштабирования крупных проектов по созданию хранилищ данных. Это строгая, предписывающая система, подробно описанная в книге, ставшей библией для этой техники.

Так почему же Data Vault? Вы сталкивались с проектом по созданию хранилища данных с более чем 50 источниками данных, с более чем 25 разработчиками данных, работающими на одной платформе данных, или с данными, охватывающими более 5 лет с двумя или более поколениями исходных систем? Если нет, то может быть сложно изначально понять преимущества Data Vault, и, возможно, моделирование по Кимбаллу будет лучше для вас. Но если вы находитесь в любой из перечисленных ситуаций, то эта статья для вас!