Перейти к основному содержимому

Analytics craft

The art of being an analytics practitioner.

Посмотреть все теги

Без постоянного присмотра — по крайней мере, сегодня
· 8 мин. чтения
Alex Noonan
Senior Developer Experience Advocate

Недавно мы выпустили dbt Wizard — CLI для работы с данными в dbt с помощью ИИ-агентов. Эта среда создана специально для работы с данными, поэтому мне не терпелось выделить день и опробовать dbt Wizard на личном проекте примерно со 100 моделями, который я уже давно поддерживаю. На примере этого проекта можно наглядно увидеть некоторые отличительные особенности Wizard, в частности то, как работает цикл валидации.

Работа над проектами данных никогда не заканчивается, и у меня накопилось несколько задач, которые я всё откладывал:

  • Миграция с MotherDuck на Iceberg + BigQuery
  • Обновление с dbt Core до dbt Fusion
  • Миграция с dbt Core на dbt platform
  • Создание семантического слоя

Здесь удачно сочетаются вполне типичные задачи по работе с данными (вы уже провели свою ежегодную миграцию?) и задачи, специфичные для dbt. Хорошая неформальная проверка, которая позволяет ответить на главный вопрос о любом инструменте разработки: работает ли он?

Опыт меня приятно удивил: мне не пришлось постоянно присматривать за Wizard или выстраивать поверх него дополнительные рабочие процессы. Он изначально понимает, что такое проект dbt, и умеет настраивать субагентов валидации под конкретную задачу. Поэтому я мог подключаться только по мере необходимости, не следить за всем процессом непрерывно и в итоге достиг всех поставленных целей.
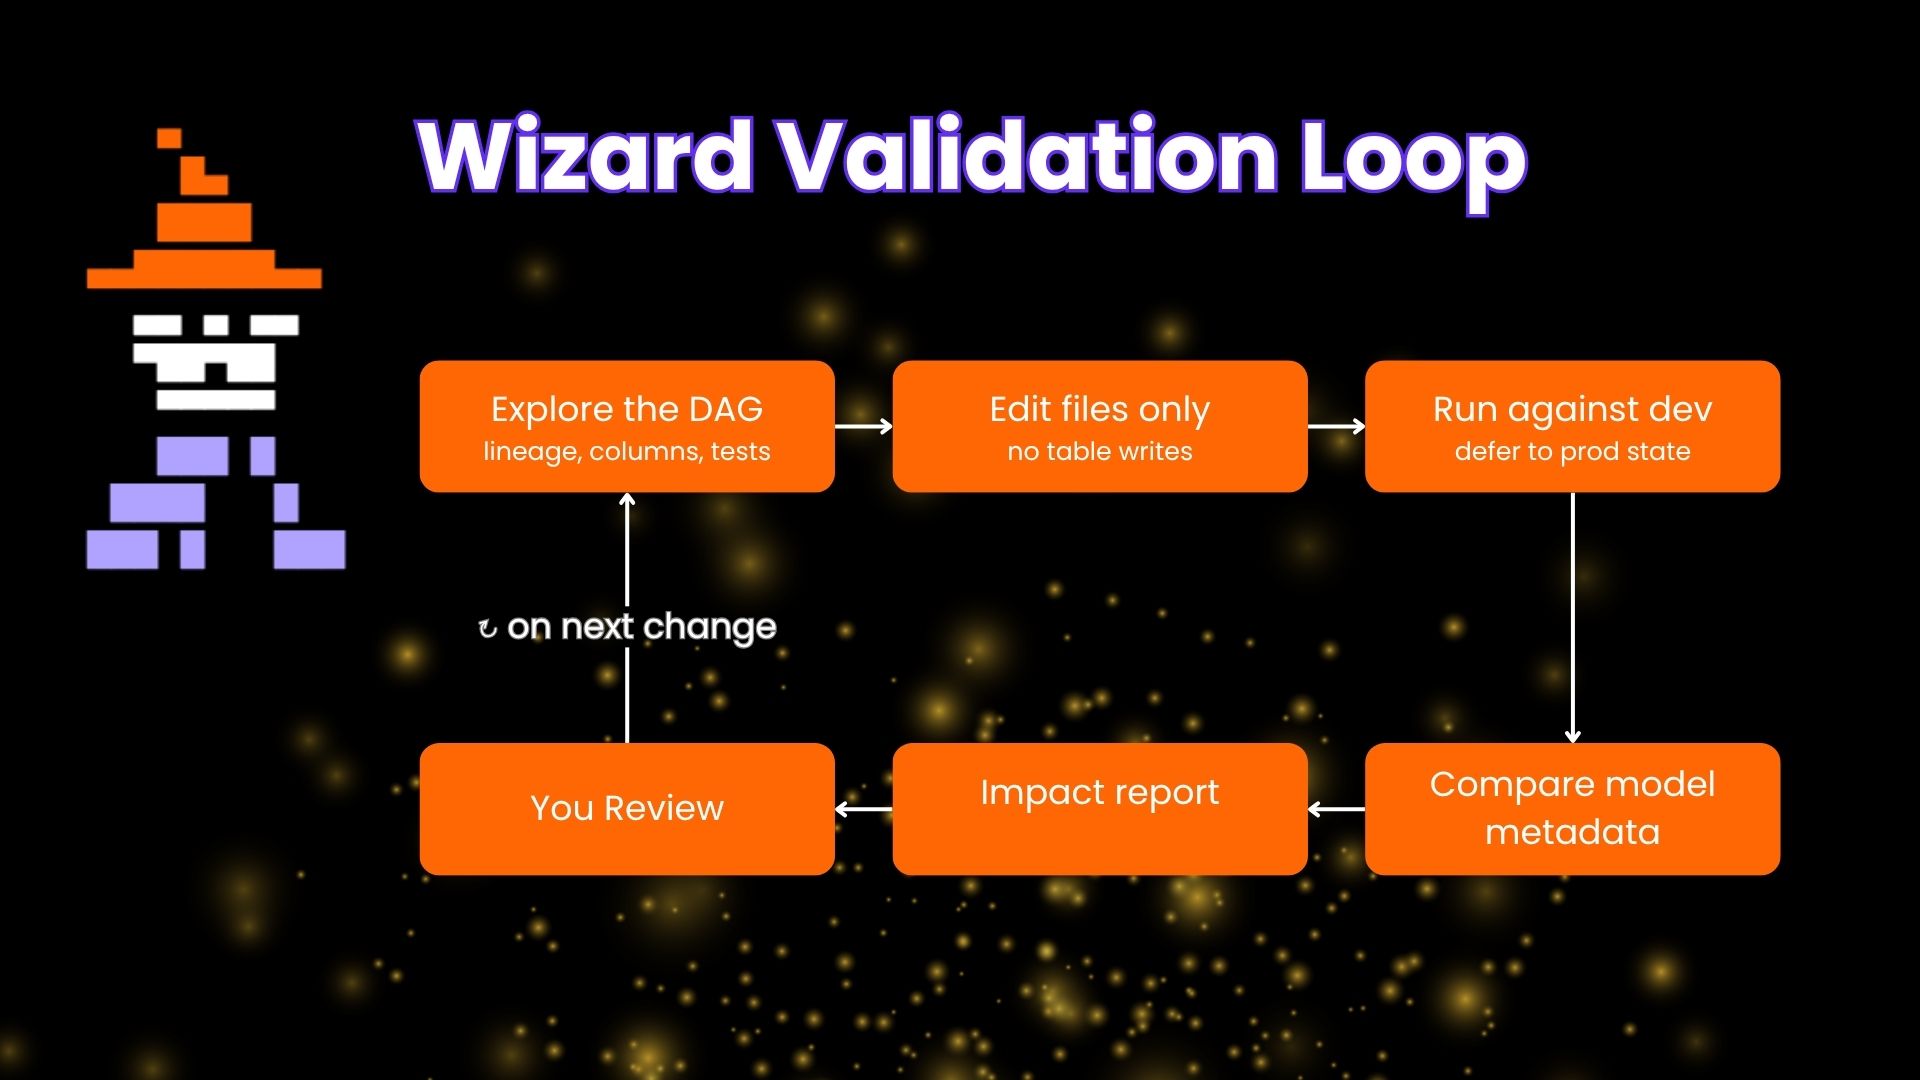
цикл, показывающий, как Wizard проверяет изменения

Как на самом деле работает dbt State и помогает снизить затраты на вычисления

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Toby Mao
Director, Engineering at Fivetran

При создании проекта dbt вы начинаете с самой простой стратегии и добавляете сложность, только когда требуется повысить скорость или снизить затраты. На уровне отдельных моделей это переход от материализации view к table, а затем к incremental. На уровне всего проекта оптимизации раньше требовали куда большей сложности: чтобы перестраивать только нужные части проекта, приходилось тратить немало умственных усилий на комбинирование селекторов вроде state:modified, source_status:fresher или config.materialized:view и следить за тем, чтобы актуальные JSON-артефакты были доступны всем в организации.

dbt State одновременно повышает скорость, снижает затраты и упрощает работу. Он работает везде, где работаете вы: в dbt Core или Fusion, локально или в любом выбранном вами оркестраторе. Поскольку в его основе лежит новый платный сервис с бесплатным пробным периодом на 30 дней, вам не нужно переходить на всю платформу dbt, чтобы получить эту экономию. dbt State приходит на смену оркестрации с учетом состояния, для которой требовались подписка на платформу dbt и переход на Fusion.

Самая интересная с технической точки зрения часть — процесс нормализации запросов1, благодаря которому запуск новой команды dbt lint не приводит сразу к полной пересборке. Но прежде чем углубляться в синтаксические деревья, давайте вспомним, что именно dbt State делает для конечного пользователя.

Базовый рабочий процесс dbt State​

При запуске dbt проверяет на сервере dbt State, выполняется ли для модели одно из условий:

  • она уже существует в целевой схеме и может быть использована повторно;
  • она уже существует в другой схеме и может быть использована повторно;
  • ее необходимо построить с нуля.

Как обучить модель линейной регрессии с помощью dbt и BigFrames

· 5 мин. чтения
Jialuo Chen
Software Engineer at Google

Введение в dbt и BigFrames​

dbt: Фреймворк для трансформации данных в современных аналитических хранилищах с использованием модульного SQL или Python. dbt позволяет аналитическим командам совместно и эффективно разрабатывать аналитический код, применяя лучшие практики программной инженерии — такие как контроль версий, модульность, переносимость, CI/CD, тестирование и документация. Подробнее см. What is dbt?

BigQuery DataFrames (BigFrames): Open-source Python-библиотека от Google. BigFrames масштабирует обработку данных на Python, транслируя распространённые API из мира data science (pandas и scikit-learn) в SQL-запросы BigQuery.

Подробнее можно узнать в официальном руководстве BigFrames и в публичном репозитории BigFrames на GitHub.

Комбинируя dbt и BigFrames через адаптер dbt-bigquery (далее — «dbt-BigFrames»), вы получаете:

  • Модульное моделирование на SQL и Python в dbt, управление зависимостями с помощью dbt.ref(), конфигурацию окружений и тестирование данных. При использовании облачной платформы dbt также доступны планирование и мониторинг джобов.
  • Возможность BigFrames выполнять сложные Python-трансформации (включая машинное обучение) непосредственно в BigQuery.

dbt-BigFrames использует службу выполнения ноутбуков Colab Enterprise в проекте GCP для запуска Python-моделей. Эти ноутбуки исполняют код BigFrames, который затем переводится в SQL для BigQuery.

Новый плагин dbt для VS Code: опыт, которого мы все ждали

· 7 мин. чтения
Bruno Souza de Lima
Lead Data Engineer at phData

Привет, сообщество!

Меня зовут Бруно, и, возможно, вы видели мои посты про dbt в LinkedIn. Если нет — давайте познакомимся. Я начал работать с dbt более 3 лет назад. В то время я только осваивал этот инструмент и, чтобы лучше в нём разобраться, начал создавать материалы, которые помогали мне учиться. Один из них — шпаргалка по dbt — и стал отправной точкой моего пути в сообществе.

От этой шпаргалки я перешёл к созданию самых разных материалов, участию и активному взаимодействию с сообществом, и в итоге дважды получил награду dbt community award. Я очень благодарен за это и по-настоящему горжусь.

С момента приобретения SDF Labs компанией dbt Labs я ждал дня, когда мы увидим результат слияния этих двух компаний. Спойлер: это dbt Fusion engine — и он оказался даже лучше, чем я ожидал.

Компоненты движка dbt Fusion и то, как они сочетаются друг с другом

· 10 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Сегодня мы анонсировали движок dbt Fusion.

Fusion — это не какая‑то одна вещь. Это набор взаимосвязанных компонентов, которые вместе обеспечивают работу следующего поколения аналитической инженерии.

В этом посте мы разберём каждый элемент архитектуры Fusion, объясним, как они сочетаются друг с другом, и проясним, что именно доступно вам в зависимости от того, компилируете ли вы Fusion из исходного кода, используете наши готовые бинарные сборки или разрабатываете внутри продукта, построенного на dbt Fusion.

От движка на Rust до расширения VS Code, от новых адаптеров на базе Arrow до базовых технологий под лицензией Apache — мы подробно разберём, что делает каждый компонент, под какой лицензией он распространяется (о причинах см. сопутствующий пост Тристана), а также как вы можете начать использовать Fusion и принять участие уже сегодня.

Знакомьтесь с dbt Fusion Engine: новый индустриальный движок для dbt на Rust

· 9 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

TL;DR: что нужно знать​

  • Привычный интерфейс разработки dbt остаётся неизменным, но лежащий в его основе движок выполнения полностью обновлён.
  • Новый движок называется dbt Fusion engine — он полностью переписан на Rust на основе технологии SDF. Движок dbt Fusion значительно быстрее dbt Core и оснащён встроенной технологией понимания SQL, которая обеспечивает поддержку рабочих процессов аналитической инженерии нового поколения.
  • Движок dbt Fusion сейчас находится в стадии бета-тестирования. Вы можете попробовать его уже сегодня, если используете Snowflake, — поддержка дополнительных адаптеров начнёт появляться в начале июня. Ознакомьтесь с нашим планом выхода в общую доступность (GA) и попробуйте руководство по быстрому началу работы.
  • Чтобы использовать Fusion, не обязательно быть клиентом dbt Labs — пользователи dbt Core уже сегодня могут бесплатно использовать движок dbt Fusion в своей локальной среде.
  • Вы можете использовать dbt v2 с новым расширением dbt для VS Code, непосредственно через CLI или в dbt Studio.
  • Это начало новой эры аналитической инженерии. Чтобы узнать, какие возможности движок Fusion откроет в ближайшие 1–2 года, прочитайте эту статью.

Оценка ИИ в dbt

· 6 мин. чтения
Kyle Dempsey
Senior Director, Partner Engineering
Luis Leon
Partner Solutions Architect at dbt Labs

Революция AI уже здесь — но готовы ли мы?
По всему миру ажиотаж вокруг AI трудно не заметить. Повсеместно обсуждают большие языковые модели, агентные workflow и то, как AI изменит каждую отрасль. Однако реальных примеров использования AI в продакшене по‑прежнему немного.

Одной из ключевых проблем, мешающих переводу AI‑кейсов в продакшен, является отсутствие возможности систематически и управляемо оценивать корректность ответов AI. Переход от прототипов к продакшену требует строгой оценки, и у большинства организаций нет фреймворка, который гарантировал бы, что AI‑результаты остаются качественными, надёжными и пригодными для принятия решений.

Как начать работать со стратегиями ветвления в git и dbt

· 29 мин. чтения
Christine Berger
Resident Architect at dbt Labs
Carol Ohms
Resident Architect at dbt Labs
Taylor Dunlap
Senior Solutions Architect at dbt Labs
Steve Dowling
Senior Solutions Architect at dbt Labs

Привет! Мы — Кристин и Кэрол, Resident Architects в dbt Labs. Наша повседневная работа связана с тем, чтобы помогать командам достигать как технических, так и бизнес-ориентированных целей. Работая с самым разным кругом клиентов — от небольших стартапов до крупных корпораций — мы накопили ценный опыт в сопровождении команд при внедрении архитектуры, которая решает их ключевые болевые точки.

Информация, которой мы собираемся поделиться, основана не только на нашем опыте — мы регулярно сотрудничаем с другими экспертами, такими как Taylor Dunlap и Steve Dowling, которые внесли значительный вклад в формирование этих рекомендаций. Их работа заключается в том, чтобы быть критически важным мостом для команд между реализацией и бизнес-результатами, в конечном итоге помогая выработать целостное техническое видение через выявление проблем и решений.

Зачем мы здесь?
Мы помогаем командам с архитектурой dbt, которая включает в себя инструменты, процессы и конфигурации, используемые для начала разработки и деплоя с dbt. За кулисами происходит множество решений, направленных на стандартизацию этих составляющих — и во многом они определяются тем, каким мы хотим видеть процесс разработки. Стремление к идеальному workflow часто приводит к тому, что команды застревают в бесконечном планировании и обсуждениях, что замедляет или даже полностью останавливает разработку. Если вам это знакомо, мы надеемся, что наши рекомендации помогут вам чувствовать себя увереннее и начать разблокировать разработку — даже если пока не всё до конца продумано!

Почему я хотел бы иметь control plane для моего ремонта

· 4 мин. чтения
Mark Wan
Senior Solutions Architect at dbt Labs

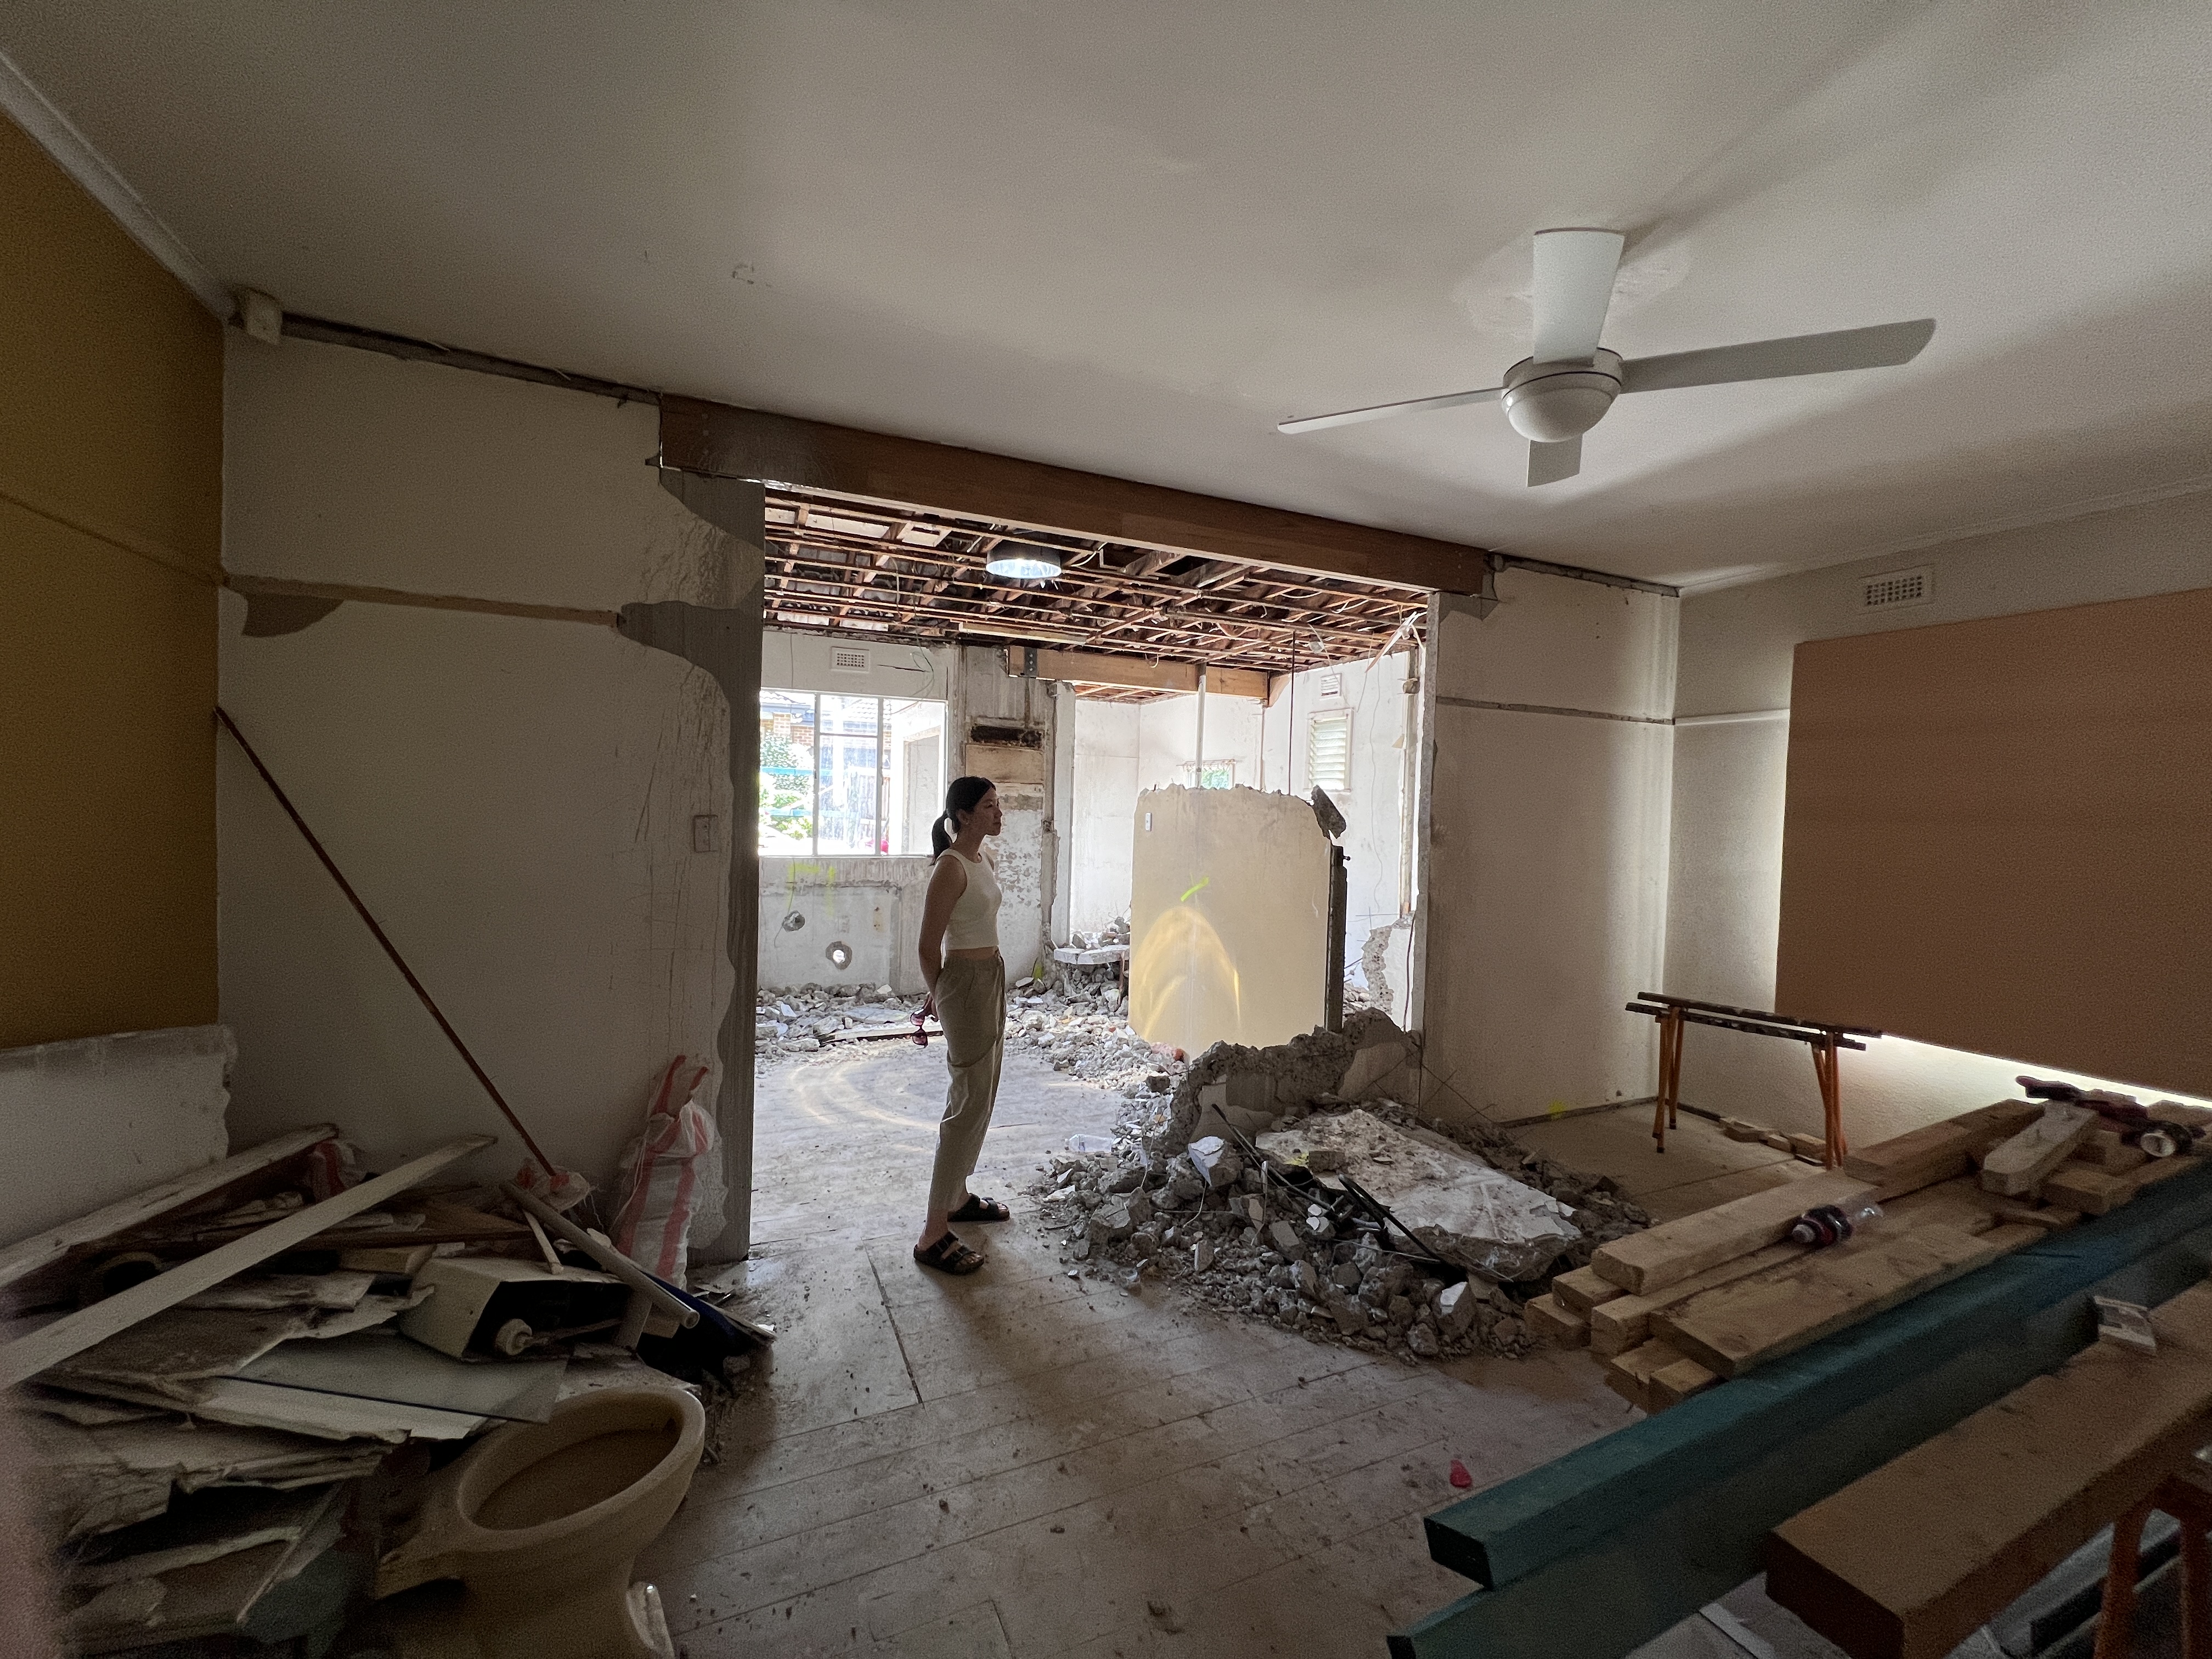
Когда мы с женой делали ремонт дома, мы решили взять на себя роль owner-builder. Это было смелое (и во многом наивное) решение, но нам хотелось контролировать каждый аспект проекта. Чего мы не осознавали, так это того, насколько сложным и изматывающим окажется управление таким количеством движущихся частей.

Моя жена размышляет о нашей вменяемостиМоя жена размышляет о нашей вменяемости

Нам приходилось координировать множество элементов:

  • Архитекторов, которые проектировали планировку, интерьер и экстерьер.
  • Архитектурные планы, описывающие, как должен выглядеть дом.
  • Строителей, которые воплощали эти планы в жизнь.
  • Инспекторов, муниципальные органы и энергоаудиторов, которые проверяли соответствие требованиям и стандартам.

Тестируйте умнее, а не усерднее: Где должны находиться тесты в вашем конвейере?

· 8 мин. чтения
Faith McKenna
Senior Technical Instructor at dbt Labs
Jerrie Kumalah Kenney
Resident Architect at dbt Labs

👋 Приветствуем, dbt’еры! Это Фейт и Джерри, и мы снова здесь, чтобы предложить тактические советы о том, где разместить тесты в вашем конвейере.

В нашем первом посте о совершенствовании лучших практик тестирования мы разработали приоритетный список проблем с качеством данных. Мы также задокументировали первые шаги по отладке каждой проблемы. Этот пост поможет вам определить, где конкретные тесты должны находиться в вашем конвейере данных.

Обратите внимание, что мы строим это руководство на основе того, как мы структурируем данные в dbt Labs. Вы можете использовать другой подход к моделированию — это нормально! Примените наши рекомендации к форме ваших данных и дайте нам знать в комментариях, какие изменения вы внесли.

Сначала вот наши мнения о том, где должны находиться конкретные тесты:

  • Тесты источников должны касаться проблем с качеством данных, которые можно исправить. См. вставку ниже для пояснения, что мы имеем в виду под "исправимыми".
  • Тесты на этапе подготовки должны быть ориентированы на бизнес-аномалии, специфичные для отдельных таблиц, такие как допустимые диапазоны или обеспечение последовательных значений. В дополнение к этим тестам, ваш слой подготовки должен очищать любые null, дубликаты или выбросы, которые вы не можете исправить в вашей системе источника. Обычно вам не нужно тестировать ваши усилия по очистке.
  • Тесты промежуточного и витринного слоев должны быть ориентированы на бизнес-аномалии, возникающие в результате объединений или вычислений. Вы также можете рассмотреть возможность добавления дополнительных тестов на первичный ключ и отсутствие null в столбцах, где особенно важно защитить зернистость.

Тестируйте умнее, а не усерднее: добавьте правильные тесты в ваш проект dbt

· 11 мин. чтения
Faith McKenna
Senior Technical Instructor at dbt Labs
Jerrie Kumalah Kenney
Resident Architect at dbt Labs

Цикл разработки аналитики (ADLC) — это рабочий процесс для улучшения зрелости и скорости работы с данными. Тестирование является ключевой фазой здесь. Многие разработчики dbt склонны сосредотачиваться на первичных ключах и свежести источников. Мы считаем, что существует более целостный и глубокий путь. Тестирование — это ключевой элемент ADLC, и оно должно способствовать качеству данных.

В этом блоге мы рассмотрим план определения качества данных. Это будет выглядеть следующим образом:

  • выявление проблем гигиены данных
  • выявление проблем аномалий, ориентированных на бизнес
  • выявление проблем аномалий, ориентированных на статистику

После того как мы определим качество данных, мы перейдем к приоритизации этих проблем. Мы будем:

  • обдумывать каждую проблему с точки зрения широты воздействия
  • решать, должна ли каждая проблема иметь уровень ошибки или предупреждения

Как гибридная Mesh разблокирует масштабное сотрудничество в dbt

· 6 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

Одной из самых важных функций dbt является возможность для команд сотрудничать в создании и распространении организационных знаний.

Ранее это выглядело как работа команды в одном проекте dbt для создания набора преобразованных объектов в их платформе данных.

Когда dbt был принят более крупными организациями и начал управлять рабочими нагрузками в глобальном масштабе, стало ясно, что нам нужны механизмы, позволяющие командам работать независимо друг от друга, создавая и делясь моделями данных между командами — dbt Mesh.

Как построить семантический слой по частям: пошаговое руководство для занятых инженеров-аналитиков

· 9 мин. чтения
Gwen Windflower
Senior Developer Experience Advocate

Семантический слой dbt основан на идее, что преобразование данных должно быть как гибким, позволяя выполнять агрегации на лету, сгруппированные и отфильтрованные по определяемым измерениям, так и контролируемым по версиям и тестируемым. Как и в любой другой кодовой базе, вы должны быть уверены, что ваши преобразования правильно выражают бизнес-логику вашей организации. Исторически сложилось так, что вам приходилось выбирать между этими опциями, но семантический слой dbt объединяет их. Однако это потребовало новых парадигм для того, как вы выражаете свои преобразования.

Модульное тестирование в dbt для разработки, управляемой тестами

· 9 мин. чтения
Doug Beatty
Senior Developer Experience Advocate at dbt Labs

Вам когда-нибудь снились кошмары о "плохих данных"? Или я единственный, у кого такие повторяющиеся кошмары? 😱

Вот один из них, который мне приснился прошлой ночью:

Все началось с ночной охоты на баги. Угрожающее насекомое заперло моих коллег в подземелье, и они умоляют меня помочь им выбраться. Найти ключ оказывается сложно, и он всегда кажется чуть-чуть недосягаемым. Стресс ощутим, как физический груз на моей груди, пока я соревнуюсь со временем, чтобы освободить их.

Конечно, я просыпаюсь, так и не спасая их, но все равно чувствую облегчение. И у меня были похожие кошмары, связанные с героической переработкой кода или запуском новой модели или функции.

Хорошие новости: начиная с dbt v1.8, мы вводим полноценный фреймворк модульного тестирования, который может справиться с каждым из сценариев из моих кошмаров о данных.

Прежде чем углубиться в детали, давайте быстро посмотрим, как мы к этому пришли.

Максимальная настройка: Конфигурирование уникальных подключений в dbt Cloud

· 6 мин. чтения
Gwen Windflower
Senior Developer Experience Advocate

В dbt Cloud теперь доступен набор новых функций для точной настройки отдельных подключений к платформам данных на уровне среды и пользователя. Они позволяют реализовывать более сложные конфигурации: например, подключать проект к нескольким аккаунтам хранилищ данных, полноценно работать с промежуточными средами (staging) и переопределять версию dbt для отдельных пользователей. Это даёт разработчикам dbt Cloud необходимые инструменты для решения более сложных задач, таких как организация рабочих процессов Write-Audit-Publish (WAP) и безопасное тестирование обновлений версии dbt. Вы по-прежнему настраиваете подключение по умолчанию на уровне проекта и для каждого разработчика, но теперь у вас есть инструменты для безопасной реализации более сложных конфигураций. Вскоре dbt Cloud расширит эти возможности ещё больше: функция глобальных подключений позволит настраивать несколько подключений на глобальном уровне и использовать их повторно.

Линейная зависимость на уровне столбцов, производительность моделей и рекомендации: создавайте надежные продукты данных с dbt Explorer

· 8 мин. чтения
Dave Connors
Product Manager at dbt Labs

Что такое платформа данных?​

Создание проекта dbt — это тяжелая работа. Мы, как специалисты по данным, вложили много усилий в создание успешных и здоровых продуктов данных, и мы должны гордиться теми инсайтами, которые они принесли. Конечно, это было не без трудностей — мы помним ужасные два года, когда мы усердно работали, чтобы платформа просто начала работать. Мы помним тревожные подростковые годы, когда тесты постоянно проваливались, как будто назло нам. Много крови, пота и слез пролито в служении чистым данным!

Когда проект смог самостоятельно одеваться и питаться, мы также усердно работали, чтобы заручиться поддержкой наших коллег, которые доверяли нашему маленькому проекту. Без глубокого доверия и понимания того, что мы построили, наши коллеги, которые зависят от ваших данных (или даже те, кто участвует в их разработке вместе с вами — в конце концов, это требует усилий всей команды!), скорее всего, будут обращаться к вам с вопросами, чем использовать свои BI-инструменты для генерации инсайтов.

Когда наши коллеги спрашивают, откуда берутся данные в их отчетах, насколько они свежи или как правильно рассчитать метрику, это радость! Это означает, что они хотят использовать то, что мы построили, с пользой — проблема в том, что, исторически, ответить на эти вопросы было не так уж просто. Это часто означало ручной, кропотливый процесс проверки журналов выполнения и вашего сайта документации dbt, чтобы предоставить заинтересованной стороне необходимую информацию.

Встречайте dbt Explorer! dbt Explorer централизует документацию, зависимость и метаданные выполнения, чтобы уменьшить объем работы, необходимой для быстрой доставки надежных продуктов данных.

Больше времени на кодинг, меньше времени на ожидание: Осваиваем defer в dbt

· 8 мин. чтения
Dave Connors
Product Manager at dbt Labs

Представьте себе — у вас огромный проект dbt, тысячи моделей работают, создавая полезные инсайты для ваших заинтересованных сторон. Вам поступает запрос — модель нужно переработать! "Нет проблем," думаете вы, "Я просто внесу изменения и протестирую их локально!" Вы смотрите на свою родословную и понимаете, что эта модель находится на многих уровнях глубоко, погребенная под длинной цепочкой таблиц и представлений.

"Хорошо," думаете вы дальше, "Я просто выполню dbt build -s +my_changed_model, чтобы убедиться, что у меня все построено в моей dev-схеме, и я могу протестировать свои изменения". Вы запускаете команду. Ждете. Ждете еще. Берете кофе и полностью выходите из своего потока разработки dbt. Много времени и денег потрачено впустую, чтобы добраться до точки, где вы можете начать свою работу. Это не годится!

К счастью, функциональность defer в dbt позволяет вам строить только то, что вам нужно, и ничего больше. Эта функция помогает разработчикам тратить меньше времени и денег на разработку, помогая быстрее выпускать надежные продукты данных. dbt Cloud предлагает нативную поддержку этого рабочего процесса в разработке, так что вы можете начать использовать defer без дополнительных затрат!

Клонировать или откладывать, вот в чем вопрос

· 6 мин. чтения
Kshitij Aranke
Senior Software Engineer at dbt Labs
Doug Beatty
Senior Developer Experience Advocate at dbt Labs

Привет всем, я Кшитидж, старший инженер-программист в команде Core в dbt Labs. Одним из самых крутых моментов в моей карьере здесь было внедрение новой команды dbt clone в рамках выпуска dbt-core v1.6.

Однако один из самых частых вопросов, которые я получаю, касается рекомендаций о том, "когда" клонировать, выходящих за рамки документации о "как" клонировать. В этом блоге я постараюсь дать эти рекомендации, ответив на следующие часто задаваемые вопросы:

  1. Что такое dbt clone?
  2. Чем это отличается от откладывания?
  3. Должен ли я откладывать или клонировать?

Оптимизация материализованных представлений с помощью dbt

· 10 мин. чтения
Amy Chen
Product Manager at dbt Labs
примечание

Этот блог был обновлен 18 декабря 2023 года, чтобы охватить поддержку MVs на dbt-bigquery и обновления по тестированию MVs.

Введение​

Год был 2020. Я жила в доме, где были только котята, а dbt Labs все еще называлась Fishtown Analytics. Один из корпоративных клиентов, с которым я работала, Jetblue, попросил меня помочь запускать их модели dbt каждые 2 минуты, чтобы соответствовать SLA в 5 минут.

После преодоления первоначального ужаса мы обсудили случай использования и вскоре поняли, что есть лучший вариант. Вместе с моей командой я создала lambda views, чтобы удовлетворить потребность.

Перенесемся в 2023 год. Я пишу это, пока мой огромный пес храпит рядом со мной (не волнуйтесь, коты тоже размножились). Jetblue переросла lambda views из-за ограничений производительности (представление может быть только настолько производительным), и мы находимся на очередной вехе в пути dbt к поддержке потоковой передачи. Какое время!

Сегодня мы объявляем, что теперь поддерживаем материализованные представления в dbt. Итак, что это значит?

Создавайте документацию и тесты для dbt в 10 раз быстрее с ChatGPT

· 7 мин. чтения
Pedro Brito de Sa
Product Analyst at Sage

Независимо от того, создаете ли вы свои конвейеры в dbt впервые или просто добавляете новую модель время от времени, хорошая документация и тестирование всегда должны быть приоритетом для вас и вашей команды. Почему же мы избегаем этого как чумы? Потому что это хлопотно — записывать каждое отдельное поле, его описание простыми словами и выяснять, какие тесты следует провести, чтобы убедиться, что данные в порядке. Как мы можем сделать этот процесс быстрее и менее болезненным?

К настоящему времени все знают о чудесах моделей GPT для генерации кода и парного программирования, так что это не должно быть сюрпризом. Но ChatGPT действительно выделяется в определении контекста полей с длинными названиями из схем таблиц базы данных. Поэтому в этом посте я помогу вам ускорить создание документации и тестов в 10 раз, используя ChatGPT для выполнения большей части работы за вас.