Перейти к основному содержимому

AI and agentic coding

Using AI-powered workflows to build better data products.

Посмотреть все теги

Постиг ли навыки dbt «горький урок»?
· 20 мин. чтения
Alex Noonan
Senior Developer Experience Advocate
Смерть с косой с надписью «Горький урок» уже побывала у дверей «Обработка естественного языка» и «Промпт-инжиниринг», а теперь стучится в дверь «Навыки»Смерть с косой с надписью «Горький урок» уже побывала у дверей «Обработка естественного языка» и «Промпт-инжиниринг», а теперь стучится в дверь «Навыки»

Помните, каково было писать код с ИИ в это же время год назад? Модели умели писать SQL, но плохо принимали решения. Они упускали многие профессиональные нюансы, которые учитывают опытные инженеры-аналитики. Навыки казались очевидным решением: дать агенту знания, необходимые для конкретной задачи, чтобы не начинать каждый раз с нуля и не набивать один AGENTS.md всем, что только может пригодиться. Навыки появились в Claude в октябре 2025 года, а в декабре того же года стали открытым стандартом. Мы создали собственный набор навыков dbt для агентов, чтобы дать агентам для написания кода недостающие соглашения, команды и шаблоны.

С тех пор модели заметно улучшились, и всегда стоит помнить о «горьком уроке» ИИ: изощрённые решения в долгосрочной перспективе проигрывают простому наращиванию вычислительных ресурсов для решения задачи. Поэтому я захотел проверить, оправдана ли ещё эта ставка. Могут ли новейшие модели создавать и поддерживать dbt-проект реального масштаба без навыков? И если да, то где навыки по-прежнему полезны?

Я потратил пару дней по несколько часов на создание прототипа системы оценки, чтобы это выяснить: 22 запуска агентов, до 12 задач в каждом, dbt-проект о «Формуле-1» в Snowflake. Выяснилось, что хорошие запуски от плохих отличал процесс работы, а не знание dbt. Я бы не назвал этот вывод окончательным, но в условиях столь быстрых изменений он уже повлиял на моё отношение к навыкам.

Пройденные проверки во втором раунде по моделям и вариантам эксперимента. На результат повлияло поколение модели, а не навыкиПройденные проверки во втором раунде по моделям и вариантам эксперимента. На результат повлияло поколение модели, а не навыки
  • Разброс между запусками больше любого эффекта от навыков. Один и тот же вариант — Sonnet 5.5 с доступными навыками — набрал 61%, 100% и 67% в трёх запусках.
  • Модели 5.5 уже знают dbt. В 12 из 19 запусков Claude 5.5 были пройдены все проверки, а без навыков каждая модель 5.5 прошла не менее 92%.
  • Агенты редко открывали навыки по собственной инициативе, а когда открывали, то чаще всего для незнакомых областей, таких как Semantic Layer или dbt Mesh.
  • Новое поколение модели даёт больше, чем навык. Sonnet 4.5 набрала 38% без навыков и 17% с обязательным использованием навыков — два самых низких результата среди всех запусков, причём в обязательном варианте модель прочитала навыки ещё до написания первой модели dbt. (Тот самый «горький урок».)
  • Преобладали ошибки процесса: тест, зафиксировавший сегодняшние ответы, неудачные попытки восстановления из резервной копии, игнорирование определений, неверно выбранные окна ретроспективной обработки.

Если вы поддерживаете навыки для команды: уберите документацию, объясняющую, как работает dbt, оставьте материалы о возможностях, которые ещё не полностью интегрированы в ваш стек, и создайте новые навыки о том, как ваша команда тестирует, развёртывает и проверяет изменения. В дальнейшем команды, которые понимают свой процесс и знают, как его поддерживать и улучшать, смогут гораздо эффективнее использовать передовые модели.
Внутри обвязки dbt Wizard: создаём агента, который мыслит DAG

· 15 мин. чтения
Jason Lin
Senior Software Engineer
Alex Noonan
Senior Developer Experience Advocate
Sam Ferguson
Staff Product Designer

Попросите инженера-аналитика переименовать столбец, и он начнёт не с SQL. Сначала он проверит, что читает этот столбец ниже по графу зависимостей, какие тесты и дашборды сломаются, выполнит сборку только изменившихся объектов и сравнит данные ещё до того, как кто-то приступит к ревью. Сервер dbt MCP и навыки агентов могут научить агента для работы с кодом этим шагам, но не могут гарантировать, что он будет выполнять их каждый раз, собирать только изменившиеся объекты или показывать вам различия в данных перед проверкой изменений.

Мы построили dbt Wizard вокруг другой идеи. Wizard работает как инженер-аналитик: мыслит DAG, проверяет и исправляет свою работу и не отвлекает вас от задач, чтобы вы проверяли работающее изменение, а не первый черновик. Всё это обеспечивает не модель, а обвязка, рабочие процессы и пользовательский интерфейс, которые мы создали вокруг неё.

Попробуйте Wizard Desktop

Запускайте агентов параллельно, просматривайте различия в данных и граф происхождения данных рядом с кодом и проверяйте изменения в своём хранилище. Запишитесь в список ожидания Wizard Desktop.

dbt_context_engineering: моделирование контекста, который читают ваши ИИ-агенты

· 14 мин. чтения
Stephen Thibeault
Senior Resident Architect

Сейчас каждая компания пытается применить ИИ к собственным данным, и большинство сталкивается с одной и той же проблемой: самое сложное — не модель. Качество ответа агента всегда ограничено качеством стоящего за ним контекста, а в большинстве организаций этот контекст никогда не моделировали для машинного чтения.

Традиционно перед нашим сообществом ставили задачу создавать аналитические системы, с помощью которых команды могли бы оценивать измеримые результаты своей работы, и эта работа уже приносит пользу ИИ: сегодня агент может получить управляемую, протестированную метрику через семантический слой. Но причины, стоящие за цифрами, скрыты в расшифровках звонков, обсуждениях с поддержкой и договорах, до которых аналитические инструменты раньше не могли добраться. У подготовки этих данных к тому, чтобы ИИ мог их находить, доверять им и ссылаться на них, есть название: инженерия контекста. Мы считаем, что сообщество dbt обладает уникальными возможностями, чтобы возглавить развитие этой практики.

В основе этого убеждения — наблюдение: инженерия контекста не новая дисциплина, которую нужно осваивать с нуля. Это аналитическая инженерия, ориентированная на нового потребителя. Практики, которые сделали ваши метрики надежными (контроль версий, тестирование, документирование, отслеживание происхождения данных), — именно то, чего сегодня не хватает контексту для ИИ. Поэтому мы выпускаем dbt_context_engineering — пакет с открытым исходным кодом, который переносит первый набор паттернов инженерии контекста в уже знакомый вам фреймворк. В этой статье мы расскажем, что входит в пакет, какие возможности он открывает и почему остальные подходы мы хотим вырабатывать вместе с сообществом.

MCP-сервер dbt теперь в Claude: управляемый контекст — достаточно войти в аккаунт

· 7 мин. чтения
Alex Noonan
Senior Developer Experience Advocate

Когда мы открыли исходный код MCP-сервера dbt в апреле 2025 года, это был экспериментальный проект для локального запуска с чёткой идеей: структурированные данные будут глубоко интегрированы в рабочие процессы с ИИ, а dbt станет слоем, предоставляющим управляемый контекст, на котором эти процессы основаны. Anthropic помогла подтвердить нашу гипотезу. Естественным следующим шагом стала облачная версия с удалённой аутентификацией через OAuth, чтобы вы могли использовать её с любым удобным для вас ИИ-инструментом.

Теперь удалённый MCP-сервер dbt работает внутри dbt platform, и вы можете подключить его к Claude за одну-две минуты: достаточно войти в аккаунт и пройти аутентификацию. Вы добавляете dbt как коннектор, подтверждаете нужные права доступа, и Claude получает доступ к вашим управляемым данным и обширным метаданным dbt.

В этой статье мы рассмотрим, какие возможности удалённый сервер открывает в Claude, для каких рабочих процессов людей и агентов он подходит и как инструменты взаимодействуют, оказавшись в одном диалоге.

Без постоянного присмотра — по крайней мере, сегодня

· 8 мин. чтения
Alex Noonan
Senior Developer Experience Advocate

Недавно мы выпустили dbt Wizard — CLI для работы с данными в dbt с помощью ИИ-агентов. Эта среда создана специально для работы с данными, поэтому мне не терпелось выделить день и опробовать dbt Wizard на личном проекте примерно со 100 моделями, который я уже давно поддерживаю. На примере этого проекта можно наглядно увидеть некоторые отличительные особенности Wizard, в частности то, как работает цикл валидации.

Работа над проектами данных никогда не заканчивается, и у меня накопилось несколько задач, которые я всё откладывал:

  • Миграция с MotherDuck на Iceberg + BigQuery
  • Обновление с dbt Core до dbt Fusion
  • Миграция с dbt Core на dbt platform
  • Создание семантического слоя

Здесь удачно сочетаются вполне типичные задачи по работе с данными (вы уже провели свою ежегодную миграцию?) и задачи, специфичные для dbt. Хорошая неформальная проверка, которая позволяет ответить на главный вопрос о любом инструменте разработки: работает ли он?

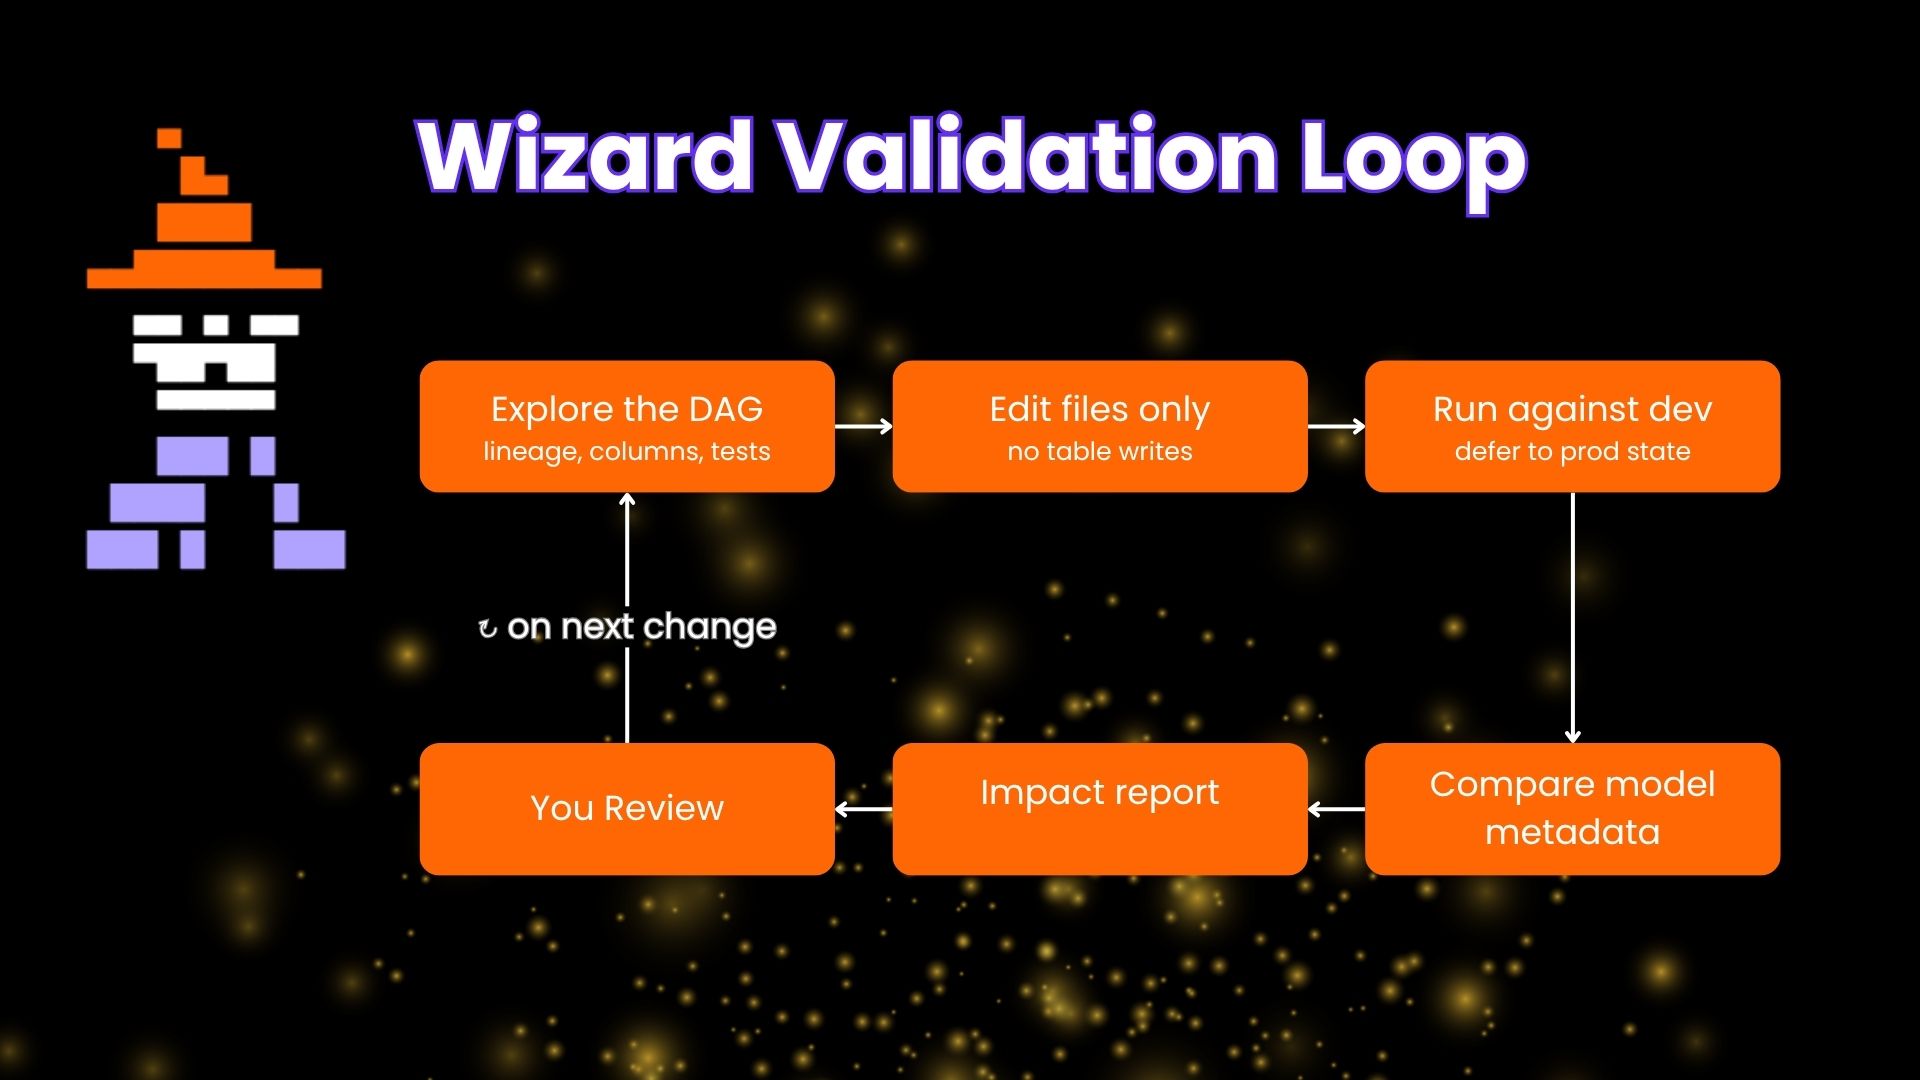
Опыт меня приятно удивил: мне не пришлось постоянно присматривать за Wizard или выстраивать поверх него дополнительные рабочие процессы. Он изначально понимает, что такое проект dbt, и умеет настраивать субагентов валидации под конкретную задачу. Поэтому я мог подключаться только по мере необходимости, не следить за всем процессом непрерывно и в итоге достиг всех поставленных целей.

цикл, показывающий, как Wizard проверяет изменения

Дьявол кроется в документации

· 11 мин. чтения
Mirna Wong
Senior Technical Writer at dbt Labs

«Да-да, продолжайте двигаться с черепашьей скоростью». — Миранда Пристли, «Дьявол носит Prada»

В фильме «Дьявол носит Prada» есть ещё одна сцена, о которой я думаю чаще, чем об этой. Если вы его ещё не видели, постараюсь обойтись без спойлеров. Миранда поворачивается к Энди (своей ассистентке) и с нескрываемым нетерпением объясняет, что небесно-голубой цвет её «мешковатого свитера» взялся не из ниоткуда — за ним стоит цепочка осознанных решений в мире моды, принятых за несколько лет до этого людьми, которые тщательно обдумывали каждый выбор. Свитер, который Энди купила в магазине, стал конечным результатом долгой цепочки осознанного отбора, тщательно скрытой ради иллюзии, будто он появился сам собой.

Именно так я бы описала документацию, особенно в эпоху ИИ. Пользователь — разработчик, аналитик, инженер данных или технический писатель 😜 — задаёт вопрос ИИ-инструменту и получает ответ. Ему необязательно видеть каждое решение в стоящей за ним цепочке: что включить, как выстроить структуру, где есть пробелы, что нужно обновить. Но эти решения формируют каждый получаемый им ответ. Где-то в начале этой цепочки команда документации делает тщательно продуманный, осознанный выбор, последствия которого доходят до самого момента, когда ответ появляется в редакторе пользователя.

В этой статье мы расскажем, как команды документации стараются приблизить эти решения к пользователям — и почему в эпоху ИИ такая архитектура важна как никогда.

Готовы попробовать?

Создаём более качественный бенчмарк для агентов по работе с данными

· 14 мин. чтения
Benn Stancil
Founder at Mode

Это вопрос на триллионы долларов, который не даёт покоя всем: от старших разработчиков ПО и начинающих юристов до голливудских сценаристов и, конечно же, аналитиков и инженеров данных. Могут ли роботы выполнять нашу работу?

Для нас, специалистов по данным самых разных направлений, сигналы неоднозначны. Согласно недавнему исследованию Anthropic, специалисты по анализу данных уже используют ИИ, чтобы помогать себе выполнять или автоматизировать 46 процентов своей работы. За два года большие языковые модели (LLM) научились хорошо писать код; теперь они ещё и очень хорошо пишут SQL.1

Но, как знает любой специалист по данным, наша работа — не в написании запросов; по крайней мере, не совсем в этом. К лучшему или к худшему (и, возможно, к лучшему, если великий переворот в написании кода уже наступил), наша работа, как выразилась Кейтлин Мурман более шести лет назад, — это связующая работа. Мы сопоставляем данные одной команды с целями другой; связываем вопросы, возникающие здесь, с тенденциями, наблюдаемыми там. Мы разбираемся с неоднозначностью; говорим: «Всё зависит от обстоятельств». Мы говорим людям «нет».

Semantic Layer и Text-to-SQL: обновление бенчмарка за 2026 год

· 11 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs
Benoit Perigaud
Staff Developer Experience Advocate at dbt Labs

Сегодня есть два основных способа получать ответы на вопросы по данным с помощью LLM: поручить модели писать SQL напрямую или выполнять запросы через структурированную онтологию, такую как dbt Semantic Layer. Оба способа работают. Компании получают реальную пользу от каждого из них. Но ошибки у них совершенно разные, и именно понимание этих ошибок по-настоящему важно при выборе подхода.

В 2023 году мы провели бенчмарк, сравнив эти два подхода, и Semantic Layer одержал уверенную победу. Но по меркам развития LLM 2023 год был примерно 10 миллионов лет назад. Модели стали значительно лучше писать SQL. Поэтому мы повторили бенчмарк с моделями последнего поколения, чтобы выяснить, сократился ли разрыв.

Помогите своему ИИ лучше работать с данными с помощью навыков агентов dbt

· 13 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

Создание и развитие лучших практик силами сообщества — пожалуй, главная движущая сила роста dbt и аналитической инженерии: рабочие процессы и подходы, которые можно перенимать, позволяют каждому создавать и распространять знания внутри организации. На заре развития dbt файл dbt_style_guide.md от dbt Labs Fishtown Analytics содержал основополагающие рекомендации для всех, кто впервые знакомился с подходом dbt.

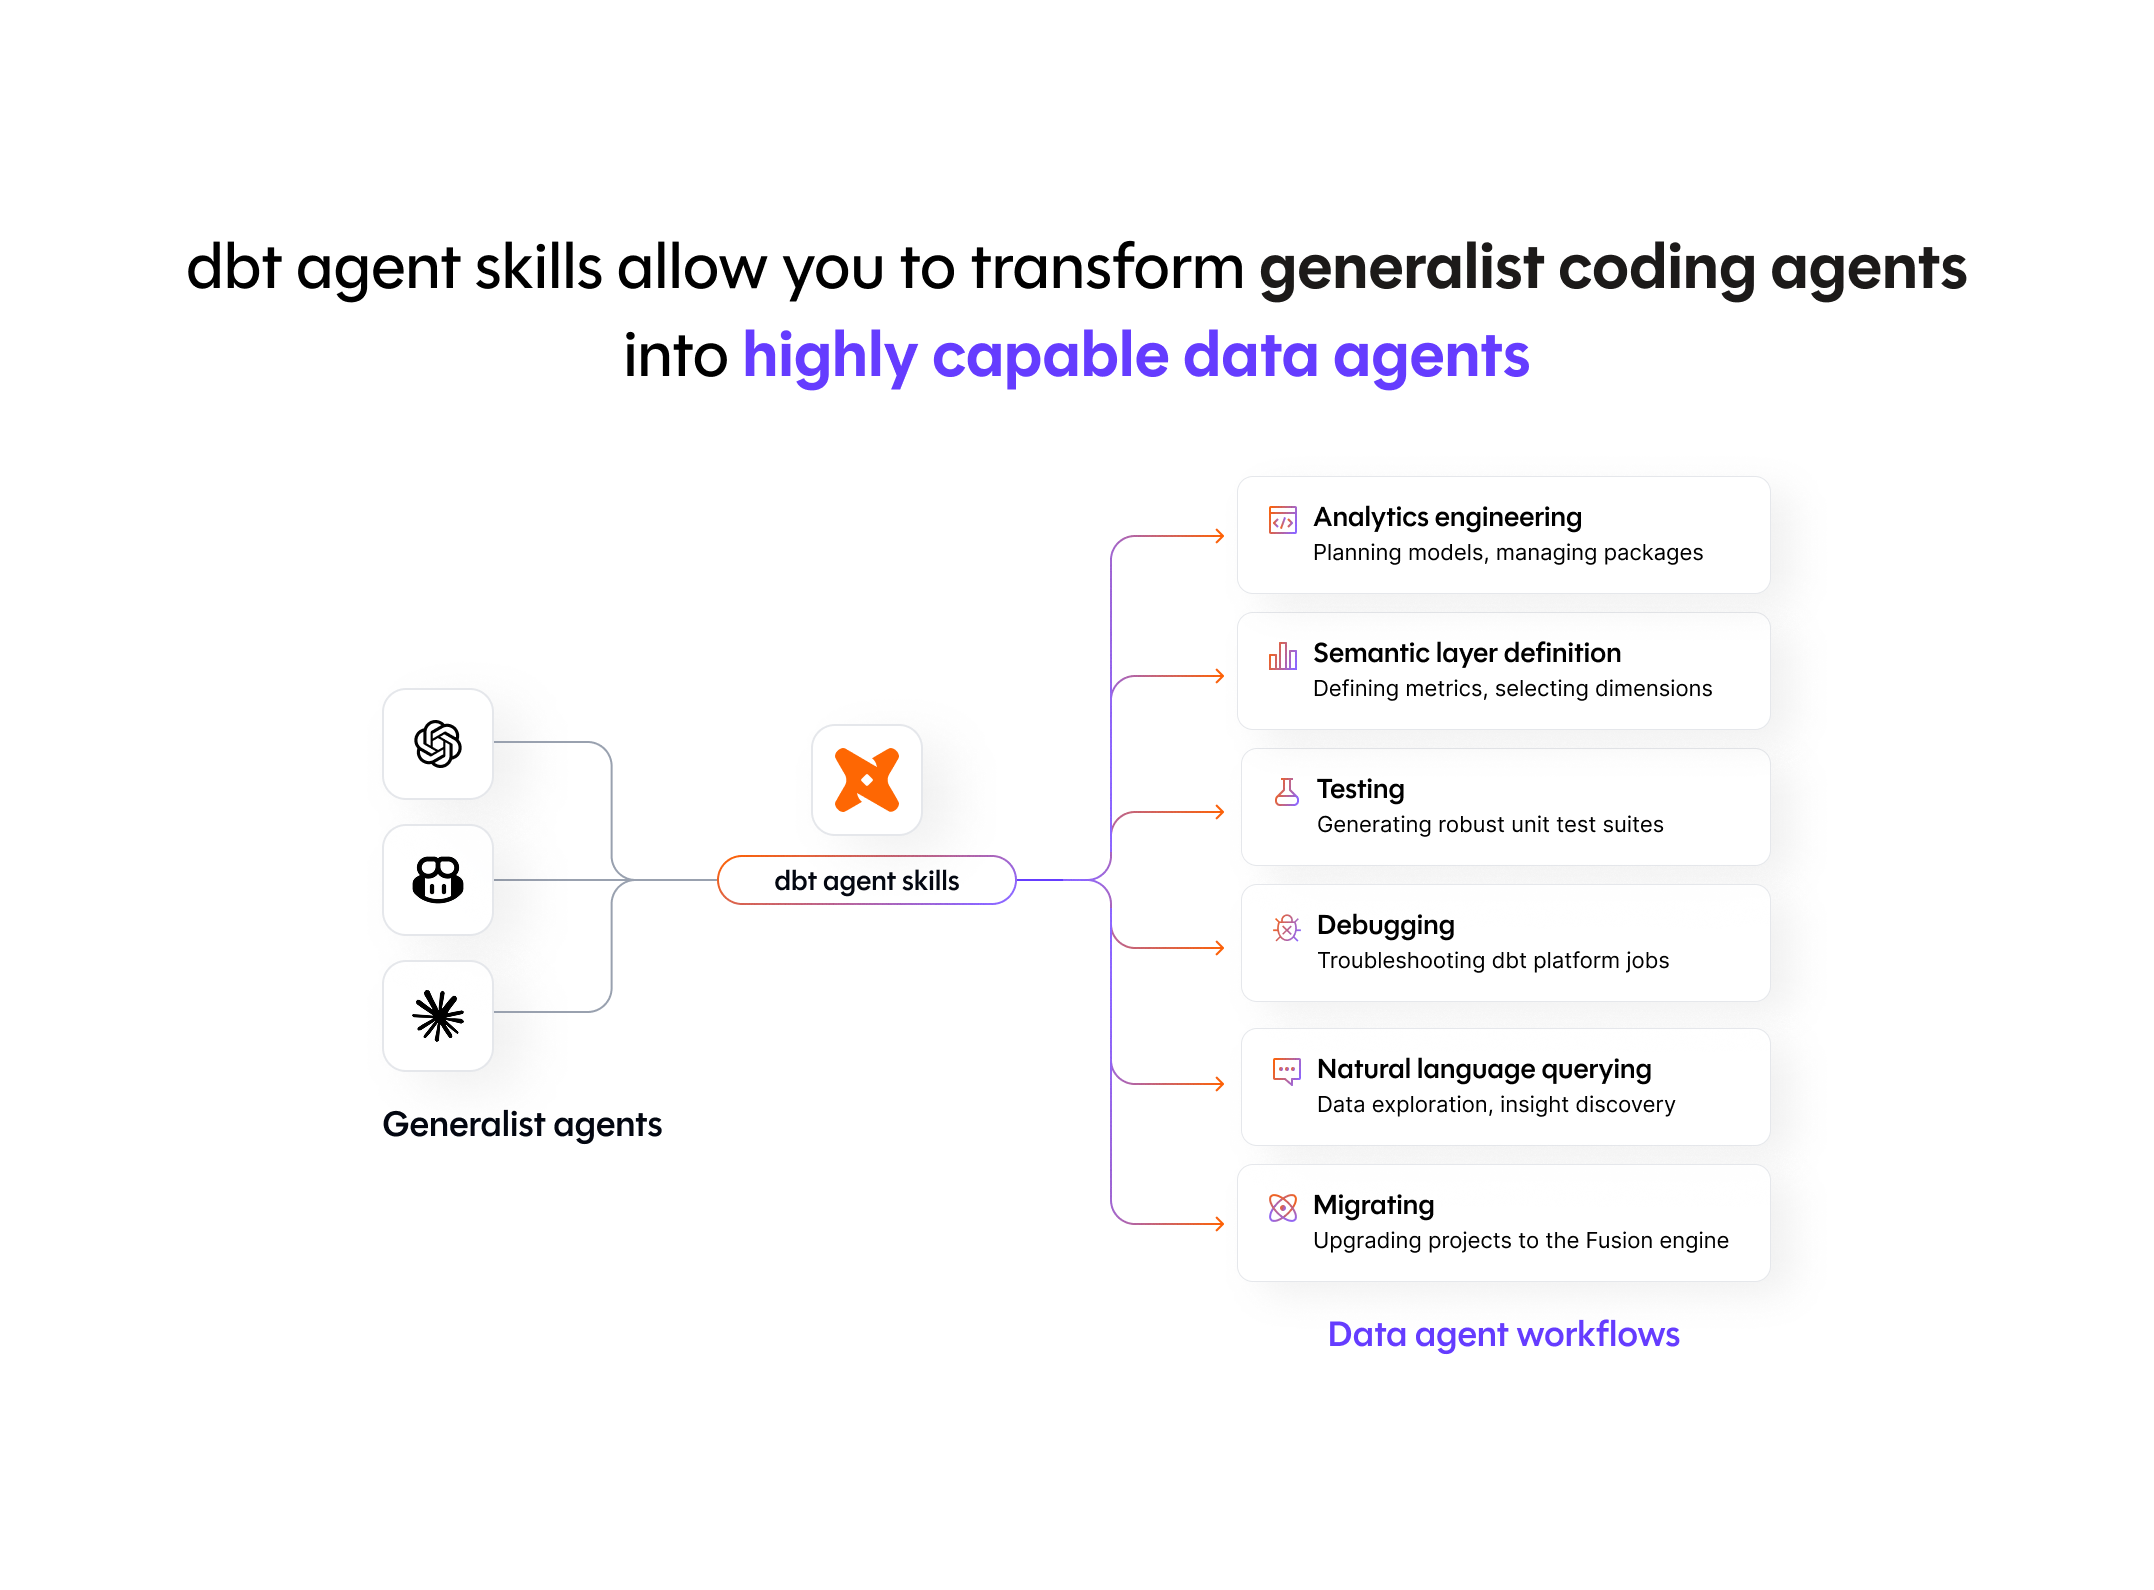
Сегодня мы выпустили набор навыков агентов dbt, чтобы ИИ-агенты (такие как Claude Code, Codex от OpenAI, Cursor, Factory или Kilo Code) могли следовать тем же лучшим практикам dbt, которых вы ожидаете от любого участника, работающего с вашей кодовой базой. Это важно, потому что, расширяя базовые возможности агентов, навыки позволяют превратить универсальных агентов для программирования в высококвалифицированных агентов для работы с данными.

Схема, показывающая, как навыки агентов dbt превращают универсальных агентов для программирования в специализированных агентов для работы с данными, способных заниматься аналитической инженерией, определением семантического слоя, тестированием, отладкой, запросами на естественном языке и миграциейНавыки агентов dbt позволяют превратить универсальных агентов для программирования в высококвалифицированных агентов для работы с данными

Эти навыки объединяют обширные знания, накопленные сообществом dbt и командой Developer Experience в dbt Labs на основе практического опыта. За ними стоят десятки часов целенаправленной работы экспертов dbt, подкреплённые годами использования dbt.

Анимация, показывающая, как Claude использует навык аналитической инженерии для проверки своей работыИмея доступ к навыкам, такие агенты, как Claude, подходят к задачам системно

Модернизация спецификации Semantic Layer

· 5 мин. чтения
Dave Connors
Product Manager at dbt Labs

Новый движок — кто это у нас?​

Вряд ли кто-то из читателей этого блога ещё не слышал о новом движке dbt Fusion — о нём говорят все в мире данных с января прошлого года, а кульминацией стала легендарная живая демонстрация Элиаса на Coalesce 2025, показавшая невероятные возможности, которые открывает встроенное понимание SQL в dbt. Если вы были на Coalesce или уже перевели свой проект на Fusion, то, скорее всего, слышали и об изменениях, которые мы внесли в средства описания проектов dbt (то есть непосредственно в код, который вы пишете в проекте). Выпуская новую мажорную версию, мы воспользовались возможностью упростить и стандартизировать язык конфигурации dbt, чтобы он был готов к масштабированию в новую эпоху аналитической инженерии.

В частности, мы хотели пересмотреть подход к определению метрик в dbt Semantic Layer. На протяжении многих лет мы слышали от участников сообщества, что определять метрики попросту сложно. Обсудив это с внутренними и внешними пользователями, а также с нашими новыми друзьями из SDF, мы разработали обновлённую спецификацию YAML: она проще, лучше вписывается в привычный и любимый нами подход к настройке dbt и рассчитана на будущее.

Создание удалённого dbt MCP Server

· 7 мин. чтения
Devon Fulcher
Senior Software Engineer at dbt Labs

В апреле мы выпустили локальный dbt MCP (Model Context Protocol) server как open source‑проект для подключения AI‑агентов и LLM к доверенным dbt‑ассетам с прямым, управляемым доступом. dbt MCP server предоставляет универсальный, открытый стандарт для соединения AI‑систем с вашим структурированным контекстом, что позволяет сохранять точность, управляемость и надежность агентов. Подробнее — в разделе About dbt Model Context Protocol.

С момента релиза локального dbt MCP server сообщество dbt применяло его самыми разными способами, включая агентную разговорную аналитику, исследование дата‑каталога и рефакторинг dbt‑проектов. Однако одним из ключевых отзывов от AI‑инженеров стало то, что локальный dbt MCP server сложно развертывать и хостить для мультиарендных (multi‑tenant) нагрузок, из‑за чего становится трудно строить приложения поверх dbt MCP server.

Именно поэтому мы рады представить новый способ интеграции с dbt MCP — remote dbt MCP server. Remote dbt MCP server не требует установки зависимостей или запуска dbt MCP server в вашей инфраструктуре, что делает разработку и запуск агентов проще, чем когда‑либо. Он доступен уже сегодня в public beta для пользователей с тарифами dbt Starter, Enterprise или Enterprise+, и готов к использованию для создания AI‑приложений.

Представляем dbt MCP Server — структурированные данные для AI-воркфлоу и агентов

· 12 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

dbt — это стандарт для создания управляемых и надежных датасетов поверх структурированных данных. MCP (Model Context Protocol) демонстрирует всё больший потенциал в качестве стандарта предоставления контекста для LLM, позволяя им эффективно работать в реальных, операционных сценариях.

Сегодня мы открываем исходный код экспериментальной версии dbt MCP server. Мы ожидаем, что в ближайшие годы структурированные данные станут глубоко интегрированы в AI‑воркфлоу, а dbt будет играть ключевую роль в создании и предоставлении этих данных.