Semantic Layer и Text-to-SQL: обновление бенчмарка за 2026 год
Сегодня есть два основных способа получать ответы на вопросы по данным с помощью LLM: поручить модели писать SQL напрямую или выполнять запросы через структурированную онтологию, такую как dbt Semantic Layer. Оба способа работают. Компании получают реальную пользу от каждого из них. Но ошибки у них совершенно разные, и именно понимание этих ошибок по-настоящему важно при выборе подхода.
В 2023 году мы провели бенчмарк, сравнив эти два подхода, и Semantic Layer одержал уверенную победу. Но по меркам развития LLM 2023 год был примерно 10 миллионов лет назад. Модели стали значительно лучше писать SQL. Поэтому мы повторили бенчмарк с моделями последнего поколения, чтобы выяснить, сократился ли разрыв.
Кратко
| Модель | Метод | Точность, % |
|---|---|---|
| claude-sonnet-4-6 | Text-to-SQL | 90.0% |
| claude-sonnet-4-6 | Semantic Layer | 98.2% |
| gpt-5.3-codex | Text-to-SQL | 84.1% |
| gpt-5.3-codex | Semantic Layer | 100.0% |
- Модели всё лучше справляются с преобразованием текста в SQL. Прогресс по сравнению с эпохой GPT-4 огромен.
- Для запросов, которые поддерживает грамотно спроектированный Semantic Layer, точность приближается к 100% или достигает этого значения. Детерминированная генерация запросов в Semantic Layer не позволяет LLM выдавать результаты с незаметными ошибками.
- Качество моделирования данных чрезвычайно важно для обоих подходов. Даже минимальное моделирование поверх исходных таблиц улучшило результаты во всех случаях.
- Наша рекомендация: Text-to-SQL — для разовых исследований и небольших наборов данных. Semantic Layer — для корпоративных сценариев, где точность критична, а наборы данных велики, сложны или плохо организованы.
Эти показатели будут и дальше улучшаться, но мы ожидаем, что базовые принципы сохранят свою актуальность. Если вы просто хотите самостоятельно запустить бенчмарк или изучить подробные данные и связанные с ним затраты, переходите в репозиторий. А если нет — читайте дальше: мы подробно расскажем о методологии и полученных выводах.
Как на самом деле работают эти два подхода
Прежде чем перейти к цифрам, кратко напомним, что происходит под капотом.
Text-to-SQL — более прямолинейный подход. Вы предоставляете LLM некоторый объём информации о схеме и просите сгенерировать SQL-запрос, отвечающий на вопрос на естественном языке. LLM должна вывести семантику ваших данных из структурных подсказок: имён таблиц, имён столбцов, связей. Затем она каждый раз пишет запрос с нуля. Это обеспечивает гибкость (можно задать любой вопрос, если нужные данные существуют), но одновременно делает подход ненадёжным. LLM может неправильно соединить таблицы, неверно истолковать значение столбца или создать запрос, который успешно выполнится, но вернёт неверные результаты. Между вопросом и сгенерированным SQL нет защитных механизмов.
Подходы на основе онтологии, такие как dbt Semantic Layer, работают иначе. Вместо того чтобы просить LLM писать SQL напрямую, вы определяете структурированную онтологию (метрики, измерения, сущности и связи между ними), которая формализует вашу бизнес-логику. Задача LLM сводится к тому, чтобы преобразовать вопрос на естественном языке в правильную комбинацию метрик и измерений. Для самой генерации запросов dbt Semantic Layer использует движок MetricFlow, который выполняет её детерминированно. Это означает, что LLM не может создать неправильное соединение или некорректную агрегацию: если она выберет правильную метрику и измерения, корректность запроса гарантирована. Возможно, ещё важнее то, что она не может выдавать правдоподобные числа, которые незаметно различаются от запуска к запуску: логика формализована и детерминирована. Компромисс здесь — охват: Semantic Layer может отвечать только на вопросы, которые укладываются в рамки построенной модели данных.
У каждого метода есть своё применение. Но в каких именно задачах каждый из них проявляет себя лучше всего, а где даёт сбой? Мы это проверили.
Бенчмарк
Мы провели эксперимент на бенчмарке ACME Insurance, изначально созданном Хуаном Секедой и его коллегами из data.world. Это набор данных умеренной сложности, предназначенный для имитации реальных аналитических задач. 11 вопросов, каждый из которых задавался по 20 раз нескольким LLM.
Мы протестировали четыре конфигурации:
- Text-to-SQL: агент получает информацию о схеме и пишет запросы с нуля.
- Минимальный Semantic Layer: dbt-проект с минимальными изменениями поверх исходных (сильно нормализованных) таблиц.
- Semantic Layer с проработанной моделью данных: переработанный проект с корректным моделированием в соответствии с лучшими практиками dbt.
- Text-to-SQL поверх смоделированных данных: агенту предлагают создавать запросы с нуля, но теперь у него есть доступ к тем же новым моделям, которые были созданы для предыдущего сценария.
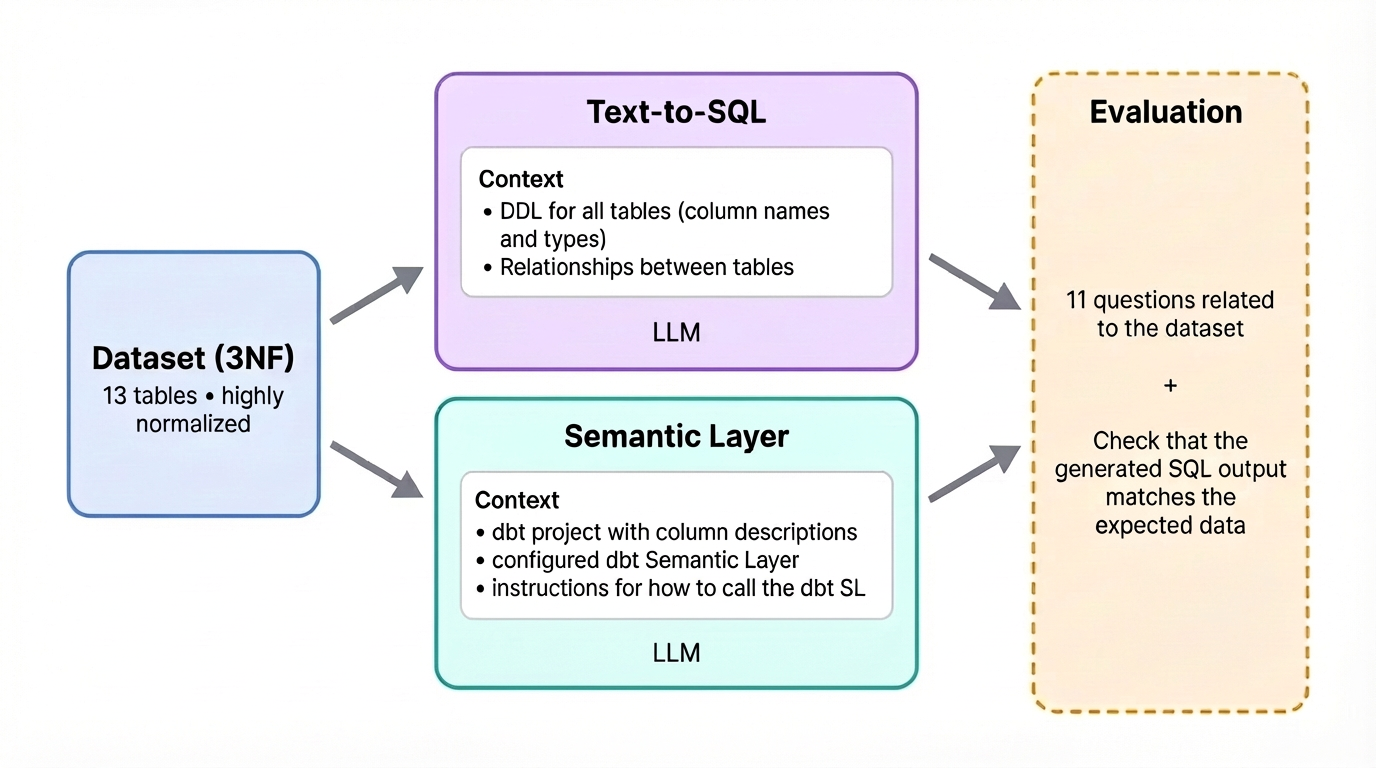
Для пользователей dbt наиболее приближено к реальности сравнение Text-to-SQL и Semantic Layer на проекте с проработанной моделью данных. Важная оговорка: чтобы Text-to-SQL работал, мы загрузили всю схему в контекст, что непрактично для более крупных наборов данных. Учитывайте это при изучении результатов.
Какую модель выбрать? (Это менее важно, чем кажется)
Перед запуском полного бенчмарка мы хотели выяснить: существенно ли влияют на результат выбор модели и уровень интенсивности рассуждений?
Мы протестировали Opus 4.6, Sonnet 4.6, GPT-5.3 Codex и GPT-5.2 (GPT-5.4 тогда ещё не была доступна через API) на нескольких уровнях интенсивности рассуждений: от low до max у Anthropic и от none до xhigh у OpenAI. Вот как выглядели 16 комбинаций для вопросов, на которые можно ответить через Semantic Layer:
| Модель | Уровень рассуждений | Точность SL, % | Точность Text-to-SQL, % | Преимущество SL (п. п.) |
|---|---|---|---|---|
| gpt-5.3-codex | none | 100.0 | 50.0 | 50.0 |
| gpt-5.2-2025-12-11 | medium | 100.0 | 52.5 | 47.5 |
| gpt-5.3-codex | low | 100.0 | 52.5 | 47.5 |
| gpt-5.3-codex | medium | 100.0 | 52.5 | 47.5 |
| gpt-5.2-2025-12-11 | none | 95.0 | 50.0 | 45.0 |
| gpt-5.2-2025-12-11 | low | 100.0 | 55.0 | 45.0 |
| gpt-5.2-2025-12-11 | high | 100.0 | 55.0 | 45.0 |
| claude-sonnet-4-6 | low | 100.0 | 62.5 | 37.5 |
| claude-sonnet-4-6 | medium | 100.0 | 62.5 | 37.5 |
| claude-sonnet-4-6 | max | 100.0 | 62.5 | 37.5 |
| gpt-5.3-codex | high | 97.5 | 60.0 | 37.5 |
| claude-sonnet-4-6 | high | 97.5 | 62.5 | 35.0 |
| gpt-5.2-2025-12-11 | xhigh | 100.0 | 65.0 | 35.0 |
| gpt-5.3-codex | xhigh | 100.0 | 65.0 | 35.0 |
| claude-opus-4-6 | low | 87.5 | 62.5 | 25.0 |
| claude-opus-4-6 | max | 87.5 | 62.5 | 25.0 |
| claude-opus-4-6 | medium | 87.2 | 62.5 | 24.7 |
| claude-opus-4-6 | high | 87.2 | 62.5 | 24.7 |
Короткий ответ: для запросов к Semantic Layer это почти не имеет значения. Большинство моделей достигают точности 100% или близкой к ней независимо от интенсивности рассуждений. Задача достаточно конкретна, а контекст достаточно ясен, поэтому выделение дополнительных токенов на рассуждения не помогает.
Что действительно меняется при увеличении интенсивности рассуждений, так это скорость — и не в лучшую сторону. У моделей GPT на уровне xhigh выполнение одного запроса занимало в среднем более 20 секунд против 8 секунд на уровне high, без существенного повышения точности. У моделей Anthropic интенсивность рассуждений не влияла ни на результаты, ни на задержку.
Несколько неожиданных результатов:
- Sonnet 4.6 превзошла Opus 4.6 в нашем сценарии
- GPT-5.3 Codex и GPT-5.2 показали схожие результаты
- Самая большая модель не всегда оказывается лучшей для задач со структурированными данными
Исходя из этого, мы провели полный бенчмарк на Sonnet 4.6 и GPT-5.3 Codex с уровнями рассуждений по умолчанию.
Главное сравнение: 2023 и 2026 годы
Итак, действительно ли LLM стали лучше отвечать на вопросы по данным, чем два года назад?
Да. Значительно. Мы задали те же 11 вопросов по 20 раз каждый, сравнив GPT-4 (ноябрь 2023 года) с GPT-5.3 Codex и Sonnet 4.6 (февраль/март 2026 года). Теперь оба метода отвечают правильно в 100% случаев на большее число вопросов, в том числе на те, которые всего два года назад давали нестабильные результаты.
Ниже приведена разбивка в зависимости от того, требует ли вопрос слишком большого для MetricFlow числа переходов между сущностями:
| Слишком много переходов | Text-to-SQL 2023 | Text-to-SQL Sonnet 4.6 | Text-to-SQL GPT-5.3 Codex | SL 2023 | SL Sonnet 4.6 | SL GPT-5.3 Codex |
|---|---|---|---|---|---|---|
| Нет | 26.9% | 62.5% | 51.2% | 83.1% | 100.0% | 100.0% |
| Да | 48.3% | 70.0% | 100.0% | 0.0% | 0.0% | 0.0% |
| Все | 32.7% | 64.5% | 64.5% | 60.5% | 72.7% | 72.7% |
Что сразу бросается в глаза:
- Точность Text-to-SQL почти удвоилась: с 32.7% до 64.5% на полном наборе вопросов. Это огромный прогресс.
- Sonnet 4.6 и GPT-5.3 Codex показывают почти одинаковые результаты в обоих методах: одинаковая точность SL и одинаковая общая точность Text-to-SQL (64.5% у обеих моделей).
- На вопросы в пределах возможностей Semantic Layer обе модели теперь отвечают правильно в 100% случаев. В предыдущих итерациях мы иногда видели 1–2 неверных ответа: данные были правильными, но модель выбирала не те измерения, которые ожидались. Теперь этого больше нет.
- На вопросы, на которые Semantic Layer не мог ответить в 2023 году, он по-прежнему не может ответить сегодня без дополнительного моделирования. Но есть принципиальная разница: Semantic Layer сообщает, что не может ответить. Он никогда не возвращает некорректные данные. А Text-to-SQL охотно выдаст вам неверное число.
Именно это различие важнее всего в промышленной эксплуатации. При использовании Text-to-SQL ошибка выглядит как правдоподобный, но неверный ответ. При использовании Semantic Layer ошибка выглядит как сообщение об ошибке. Для любых данных, которые попадут в презентацию для совета директоров, к аудитору или на корпоративный дашборд KPI, эта разница имеет решающее значение.
Что произойдёт, если добавить хотя бы минимальное моделирование?
На некоторые вопросы нельзя было ответить через Semantic Layer, поскольку исходная схема, находившаяся в третьей нормальной форме и чрезвычайно сильно нормализованная, требовала слишком большого числа переходов между сущностями для MetricFlow. Поэтому мы задались вопросом: какой минимальный объём моделирования нужен, чтобы устранить этот пробел?
Мы попросили LLM создать как можно меньше моделей dbt, чтобы ответить на все 11 вопросов через Semantic Layer. Она создала 3 новые модели, объединив несколько таблиц и создав соответствующие семантические модели, — нам не пришлось писать никакого кода.
Мы отправили изменения в git, Semantic Layer обновился автоматически, и мы повторно запустили бенчмарк. Для теста Text-to-SQL мы также обновили DDL-контекст, добавив новые таблицы и связи.
Результаты говорят сами за себя. Всего с 3 дополнительными моделями Semantic Layer теперь может ответить на каждый вопрос бенчмарка. Результаты Text-to-SQL тоже улучшились, что подтверждает: более качественное моделирование помогает обоим подходам.
| Модель | Метод | Точность, % |
|---|---|---|
| claude-sonnet-4-6 | Text-to-SQL | 90.0% |
| claude-sonnet-4-6 | Semantic Layer | 98.2% |
| gpt-5.3-codex | Text-to-SQL | 84.1% |
| gpt-5.3-codex | Semantic Layer | 100.0% |
(Мы также провели этот тест на GPT-5.2, но результаты оказались заметно слабее: точность Text-to-SQL составила 68% против 84.1% у GPT-5.3 Codex.)
Что выбрать?
Ответ не в выборе между Text-to-SQL и Semantic Layer. Используйте оба подхода, но для разных задач.
Когда задействовано несколько таблиц (в нашем бенчмарке их 15), наличие Semantic Layer обеспечивает детерминированность и значительно повышает точность. Если Semantic Layer может ответить на вопрос, он отвечает правильно. Если не может — сообщает об этом. Он никогда не возвращает неверные данные без предупреждения.
Text-to-SQL более гибок: он может попытаться ответить на любой вопрос, если нужные данные существуют. Но за эту гибкость приходится платить: иногда он будет выдавать правдоподобные, но неверные ответы. А добавление моделирования поверх исходных таблиц улучшило результаты обоих подходов.
Вот как мы предлагаем действовать:
- Когда важна точность (данные для совета директоров, аудиторы, OKR, KPI, еженедельные отчёты): настройте Semantic Layer и подключите к нему свою LLM.
- Для разовых исследований (единичные вопросы, изучение данных, прототипирование): сначала проверьте, может ли Semantic Layer ответить на вопрос. Если нет, проверьте, поможет ли небольшое изменение модели данных. В противном случае переходите к Text-to-SQL, предоставив как можно более полный контекст схемы.
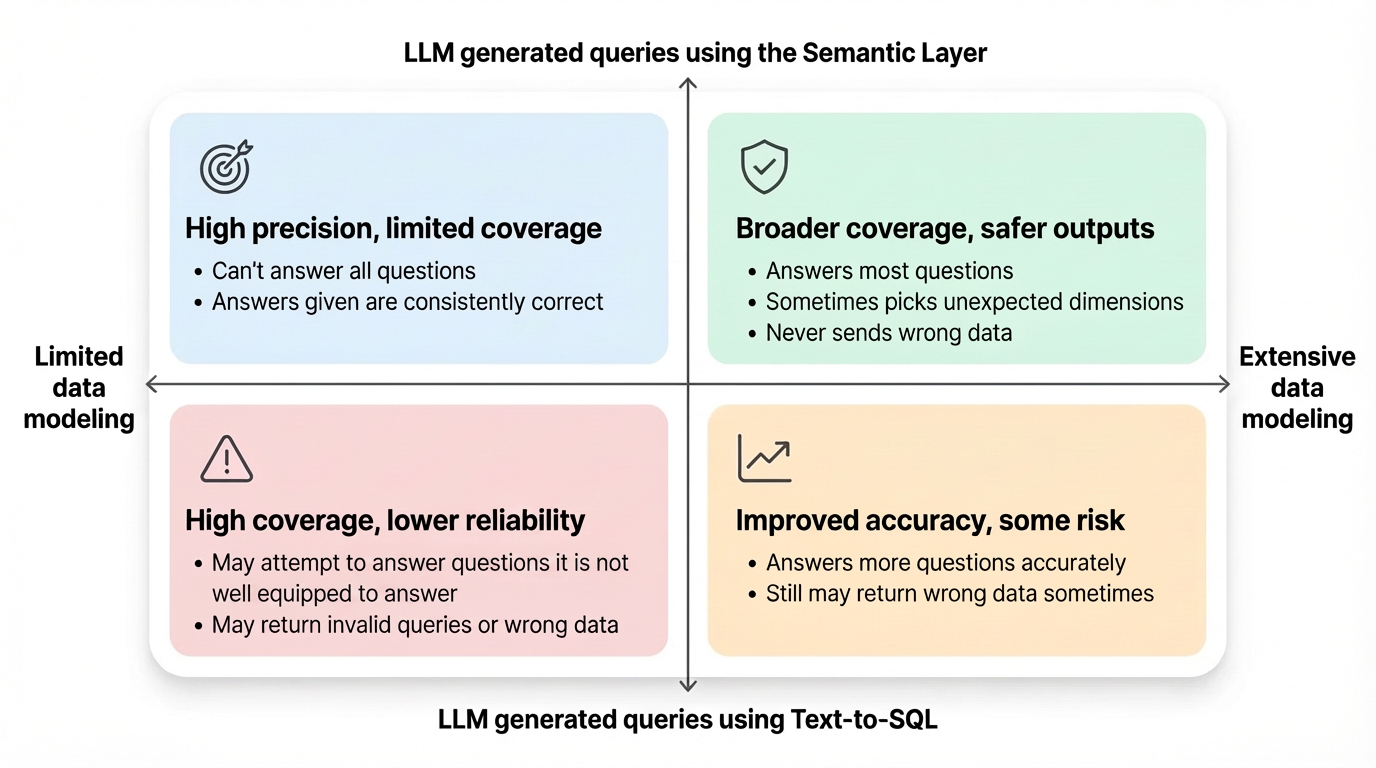
Именно такой подход мы рекомендуем в нашем навыке агента для ответов на вопросы на естественном языке с помощью dbt.
Попробуйте сами и изучите данные
Полный бенчмарк имеет открытый исходный код и воспроизводим. Мы перешли от исходного подхода с блокнотами и CSV-файлами к Python-библиотеке, использующей Pydantic AI для взаимодействия с LLM и DuckDB для хранения результатов.
- Запустите бенчмарк на собственных данных: dbt-labs/dbt-llm-sl-bench
- Изучите затраты и задержки: полные данные бенчмарка
- Настройте собственный Semantic Layer: используйте навыки агента dbt, чтобы ИИ помог вам создать и настроить его
- Есть вопросы или интересные результаты? Поделитесь ими с нами в канале #tools-dbt-mcp в Slack-сообществе dbt