Как мы создали согласованные метрики запуска продукта с помощью семантического слоя dbt
Нет ничего лучше, чем запуск нового продукта. В день запуска эмоции могут варьироваться от волнения до страха и чувства достижения в течение одного часа. Как только пыль уляжется и продукт окажется в дикой природе, следующая задача команды — отслеживать, как продукт себя проявляет. Сколько у нас пользователей? Как выглядит производительность? Какие функции используют клиенты? Как часто? Ответы на эти вопросы жизненно важны для понимания успеха любого запуска продукта.
В dbt мы недавно сделали семантический слой общедоступным. Семантический слой позволяет командам централизованно определять бизнес-метрики в dbt и получать к ним доступ в различных аналитических инструментах через наши API семантического слоя. Я являюсь менеджером продукта в команде семантического слоя, и запуск семантического слоя поставил нашу команду в интересное, несколько "мета", положение: нам нужно понять, как проходит запуск продукта, и продукт, который мы только что запустили, предназначен для того, чтобы сделать определение и использование метрик гораздо более эффективным. Это идеальная возможность испытать семантический слой в аналитике продукта. Этот пост в блоге описывает сквозной процесс, который мы использовали для настройки аналитики продукта для семантического слоя dbt с использованием самого семантического слоя dbt.
Подготовка данных для метрик
Первые шаги по созданию конвейера аналитики продукта с семантическим слоем выглядят так же, как и при использовании dbt - все дело в трансформации данных. Шаги, которые мы выполнили, были в целом следующими:
- Работать с инженерами, чтобы понять источники данных. В нашем случае это экспорт базы данных с сервера семантического слоя.
- Загрузить данные в наш хранилище. Мы используем Fivetran и Snowflake.
- Преобразовать данные в нормализованные таблицы с помощью dbt. Этот шаг классический. Основная задача dbt. Вы, вероятно, уже знаете, как это делается.
Существует множество других отличных ресурсов о том, как выполнить вышеуказанные шаги, я пропущу это в этом посте и сосредоточусь на том, как мы построили бизнес-метрики с использованием семантического слоя. Как только данные загружены и моделирование завершено, наш DAG для данных семантического слоя выглядит следующим образом:
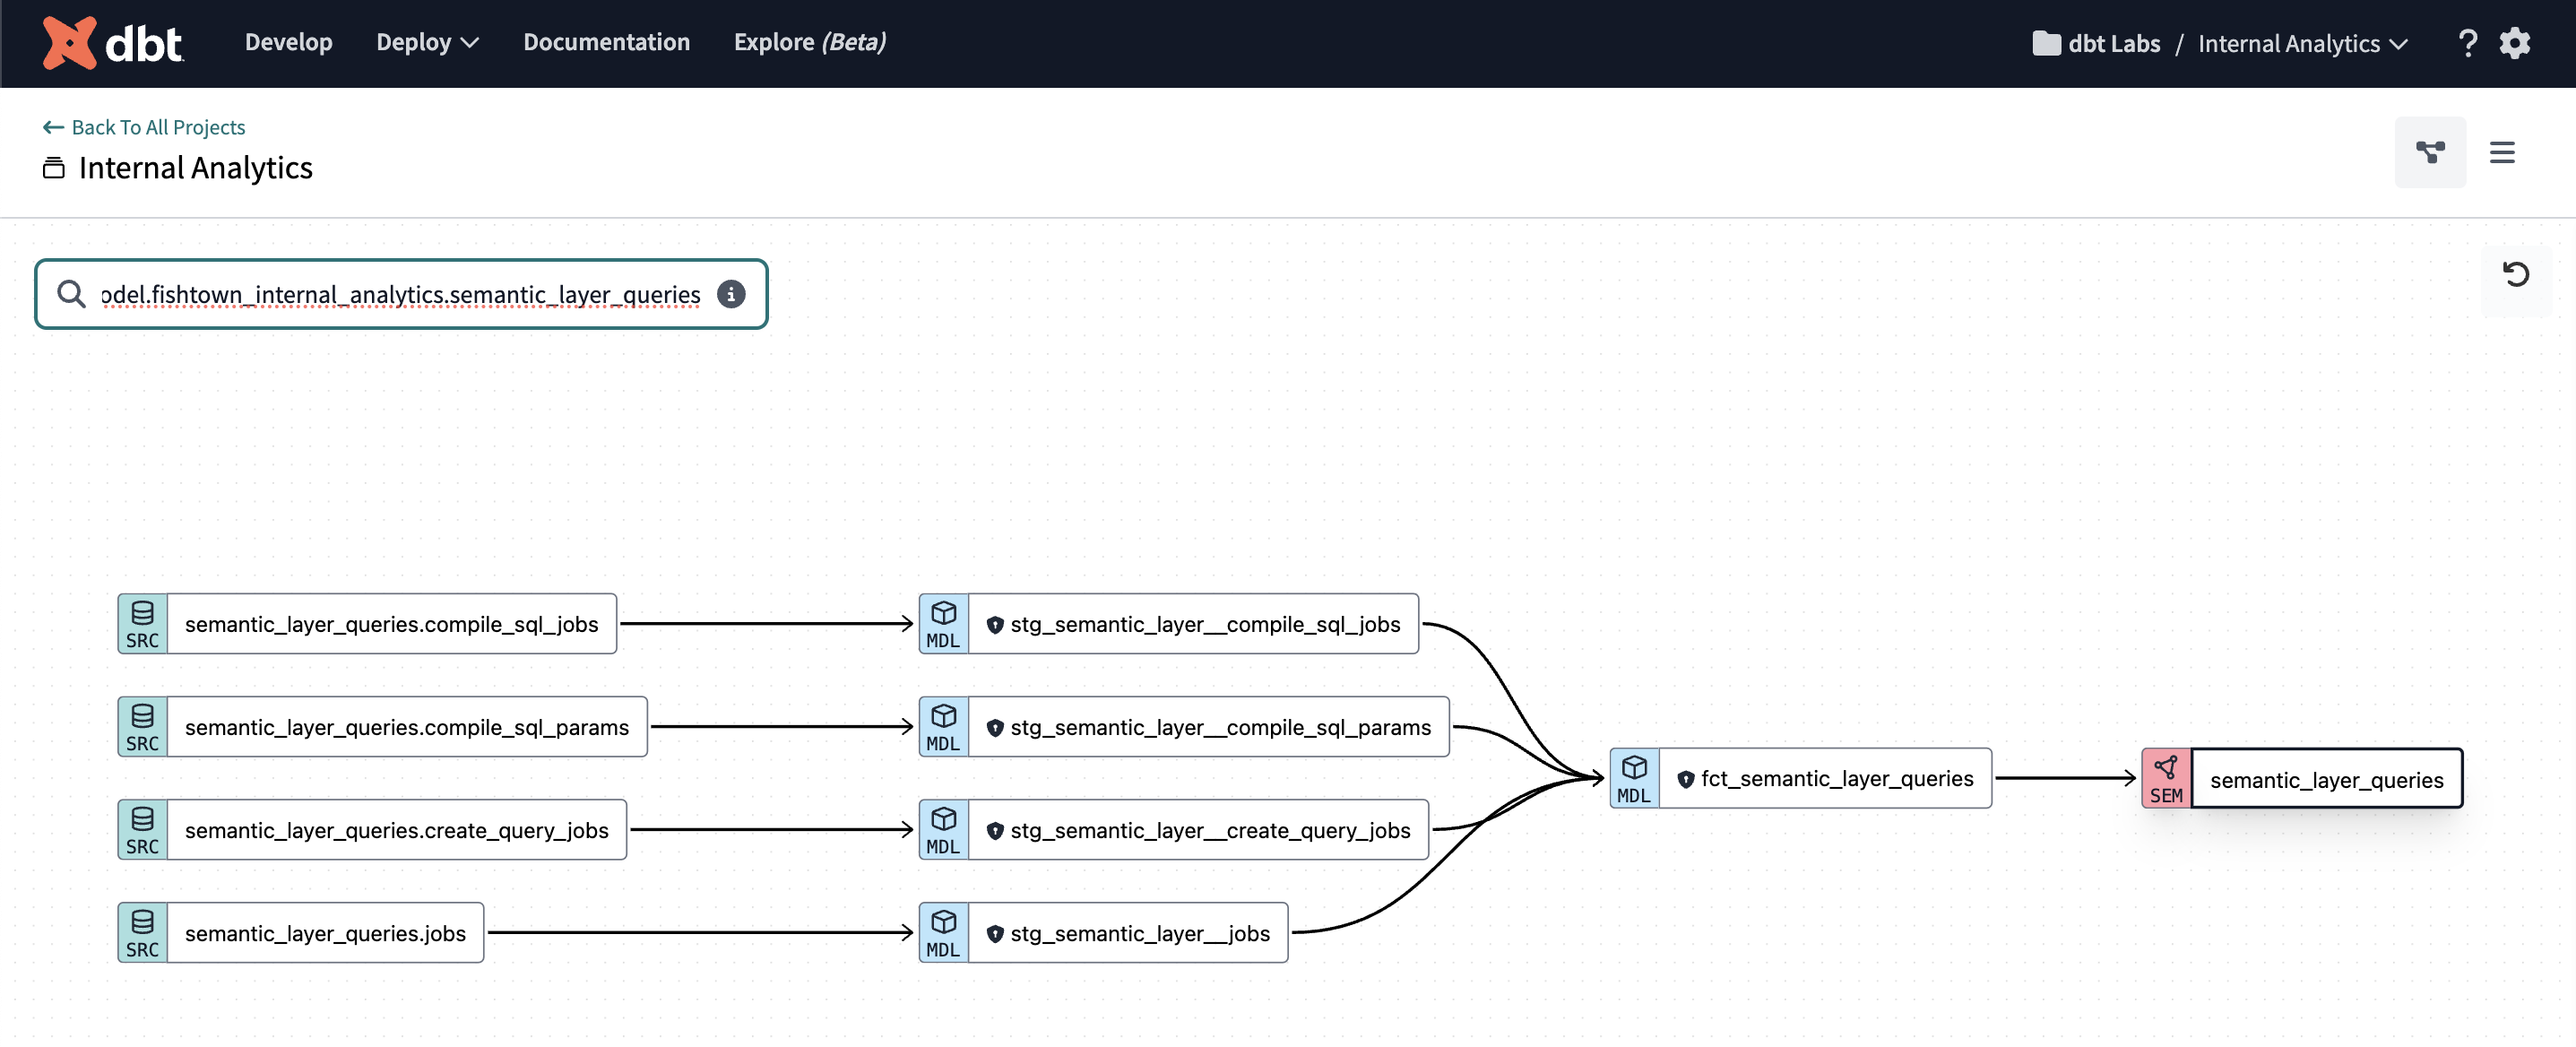 DAG семантического слоя в dbt Explorer
Давайте пройдемся по DAG слева направо: сначала у нас есть сырые таблицы с сервера семантического слоя, загруженные в наше хранилище, затем у нас есть модели стадий, где мы применяем бизнес-логику, и, наконец, чистая, нормализованная модель fct_semantic_layer_queries. В конце концов, мы построили семантическую модель под названием semantic_layer_queries на основе нашей нормализованной фактологической модели. Это типичный DAG для проекта dbt, который содержит семантические объекты. Теперь давайте увеличим масштаб секции DAG, содержащей наши объекты семантического слоя, и рассмотрим подробнее, как мы определили наши метрики продукта семантического слоя.
Как мы строим семантические модели и метрики
Что такое семантическая модель? Проще говоря, семантические модели содержат компоненты, необходимые для построения метрик. Семантические модели — это YAML-файлы, которые хранятся в вашем dbt‑проекте. Они содержат метаданные о ваших dbt‑моделях в формате, который понимает MetricFlow — конструктор запросов, лежащий в основе семантического слоя. Диаграмма DAG ниже в dbt Explorer показывает метрики, которые мы построили на основе semantic_layer_queries.
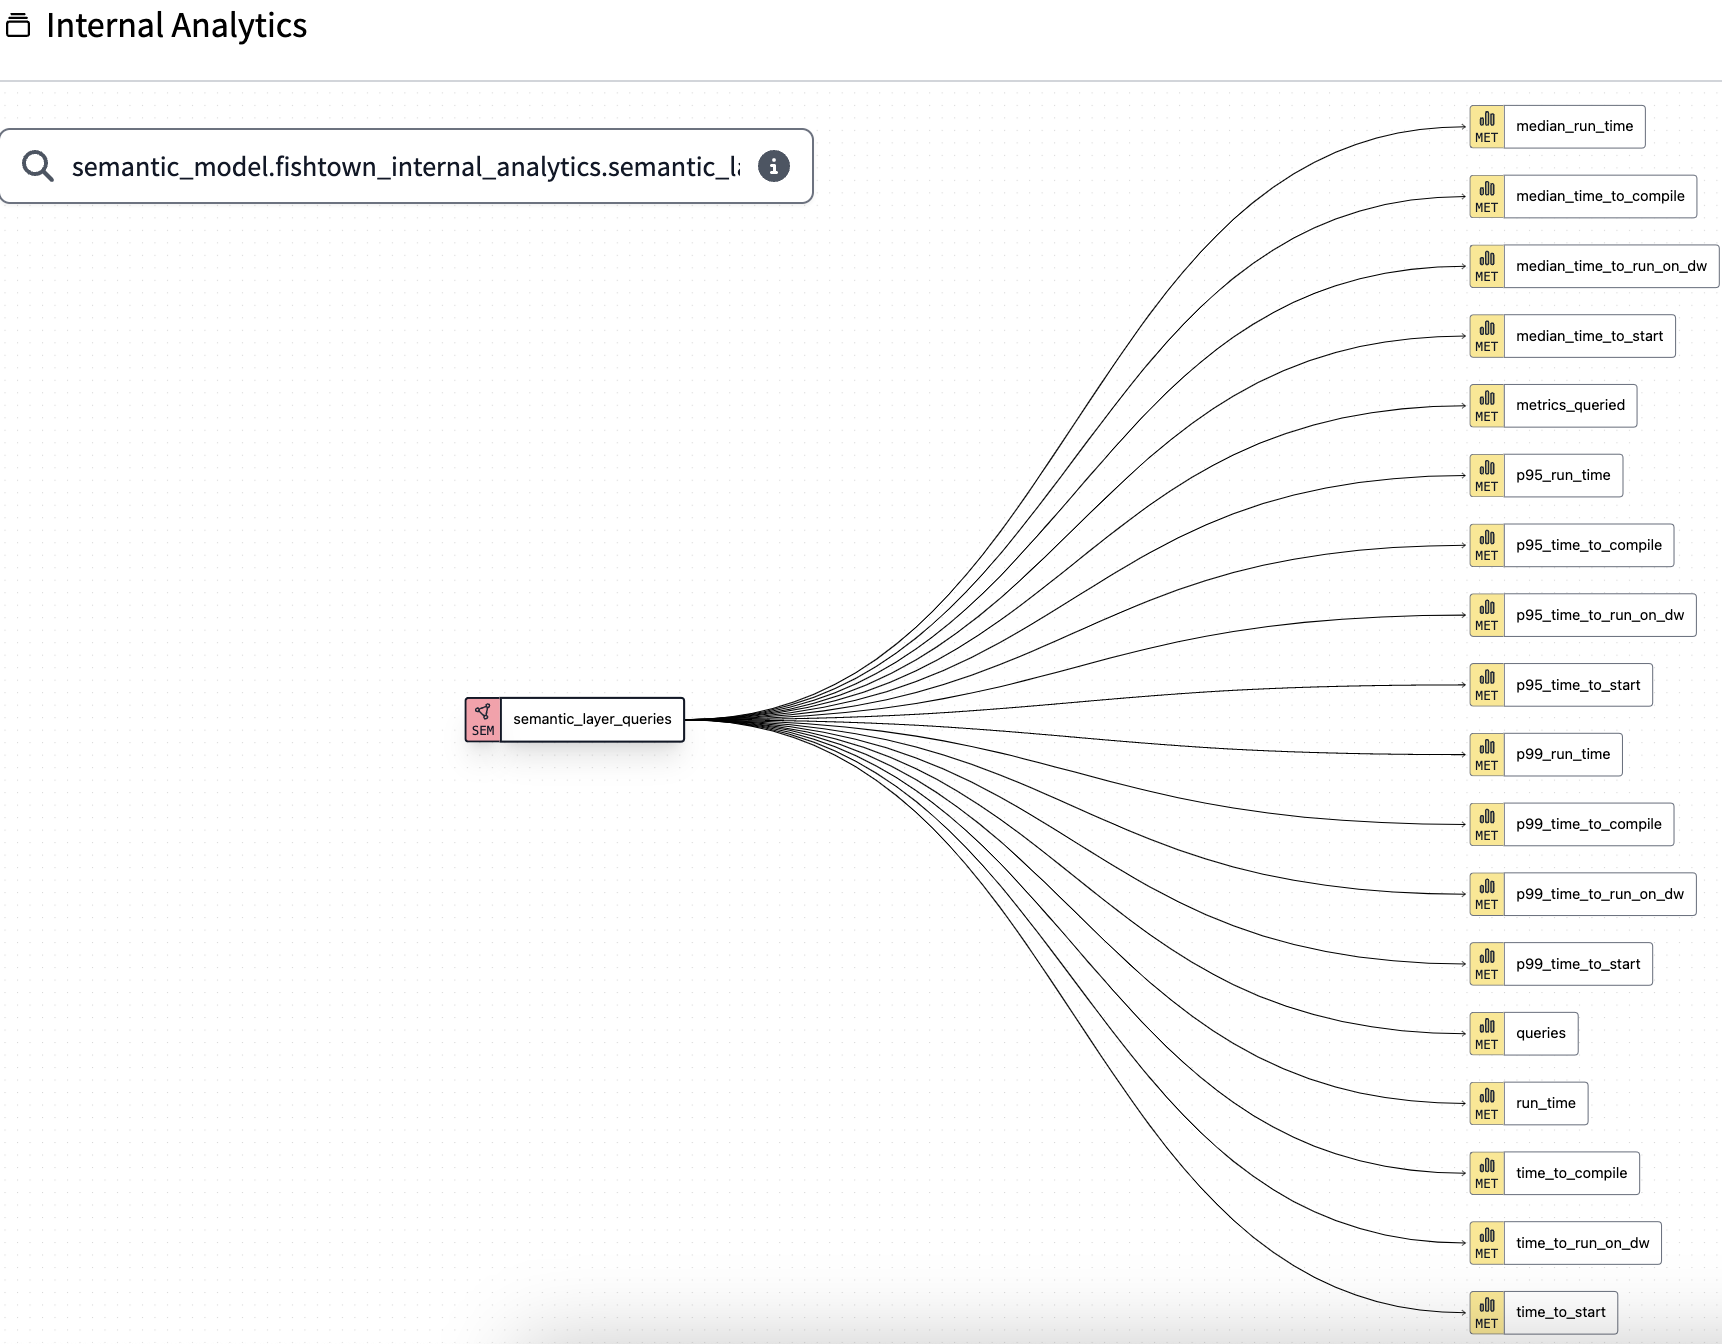 DAG семантического слоя в dbt Explorer
Давайте чуть глубже разберемся с semantic models и metrics и объясним некоторые решения по моделированию данных, которые мы приняли. Сначала нам нужно было решить, какую модель использовать в качестве основы для нашей semantic model. Мы решили использовать запросы fct_semantic_layer в качестве базовой модели, потому что определение semantic model поверх нормализованной fact-таблицы дает нам максимальную гибкость для join с другими таблицами. Это увеличило число доступных dimensions, а значит — мы можем отвечать на большее количество вопросов.
Возможно, вы спросите: почему бы не строить метрики прямо поверх raw-таблиц и не позволить MetricFlow разобраться со всем остальным? Реальность такова, что вам почти всегда потребуется выполнить какое-то моделирование данных, чтобы создать датасет, на основе которого вы хотите строить метрики. Задача MetricFlow — не делать data modeling. Шаг трансформации выполняется в dbt.
Вы можете задаться вопросом: почему бы просто не построить метрики на основе необработанных таблиц и не предоставить MetricFlow разобраться с остальным? На практике вам почти всегда потребуется в той или иной форме смоделировать данные, чтобы создать набор данных, на основе которого вы будете строить метрики. Моделирование данных — не задача MetricFlow. Этап преобразования выполняется с помощью dbt.
- Dimensions: Мы включили в semantic model все релевантные измерения (dimensions), которые могут понадобиться стейкхолдерам — например, время создания запроса, статус запроса и булевы поля, показывающие, содержит ли запрос определенные элементы, такие как where-фильтр или несколько метрик.
- Entities: Мы добавили в semantic model entities, например dbt cloud environment id. Entities работают как ключи для join в semantic models, то есть любые другие semantic models, у которых есть joinable entity, можно использовать при запросах к метрикам.
- Measures: Затем мы добавили measures. Measures задают агрегацию, которую вы хотите выполнить над данными. Я воспринимаю measures как «примитив» метрики: мы будем использовать их для построения метрик и сможем переиспользовать, чтобы поддерживать код DRY.
Наконец, мы ссылаемся на measures, определенные в semantic model, чтобы создать metrics. Наш первоначальный набор usage-метрик — это довольно простые агрегации. Например, общее количество выполненных запросов.
## Пример определения метрики
metrics:
  - name: queries
    description: Общее количество выполненных запросов
    type: simple
    label: Semantic Layer Queries
    type_params:
      measure: queries
Наличие метрик в семантическом слое дает ряд существенных преимуществ.
Во‑первых, определения метрик и сгенерированный SQL централизованы и находятся в нашем dbt‑проекте, а не разбросаны по BI‑инструментам или SQL‑клиентам.
Во‑вторых, типы запросов, которые я могу выполнять, становятся динамичными и гибкими. Традиционно мне пришлось бы материализовывать cube или rollup‑таблицу, в которой заранее должны быть учтены все возможные размерности (dimensional slices), которые могут заинтересовать пользователей. Теперь же пользователи могут соединять таблицы и добавлять размерности к своим запросам метрик «на лету», во время выполнения запроса. Это экономит время команды данных, избавляя от постоянного обновления rollup‑таблиц и добавления в них новых полей.
Для выполнения запросов к Semantic Layer есть два способа: запрашивать метрики напрямую через API Semantic Layer или использовать одну из наших первоклассных интеграций. Наши команды аналитики и разработки продуктов активно используют Hex, а команды операционной деятельности и финансов не представляют своей работы без Google Sheets, поэтому для нас важно, чтобы в обоих инструментах были доступны одни и те же определения метрик.
Теперь, когда мы выполнили работу по созданию конвейера для настройки наших метрик для запуска семантического слоя, мы готовы анализировать, как прошел запуск!
Наши команды по финансам, операциям и GTM смотрят на одни и те же метрики 😊
Чтобы выполнить запрос к семантическому слою, у вас есть два пути: вы можете запрашивать метрики напрямую через API семантического слоя или использовать одну из наших первоклассных интеграций. Наша аналитическая команда и команды продукта активно используют Hex, в то время как наши команды по операциям и финансам живут и дышат Google Sheets, поэтому для нас важно иметь одни и те же определения метрик, доступные в обоих инструментах.
Основная работа по созданию нашего конвейера и определению метрик уже выполнена, что делает потребление на последнем этапе гораздо проще. Сначала мы настроили панель запуска в Hex как источник истины для метрик продукта семантического слоя. Этот инструмент используется кросс-функциональными партнерами, такими как маркетинг, продажи и исполнительная команда, чтобы легко проверять метрики продукта и использования, такие как общее количество запросов семантического слоя или еженедельные активные пользователи семантического слоя. Чтобы настроить наше подключение к Hex, мы просто вводим несколько деталей из нашей среды dbt Cloud, и затем мы можем работать с метриками напрямую в блокнотах Hex. Мы можем использовать интерфейс JDBC или использовать конструктор метрик GUI Hex для создания отчетов. Мы запускаем все наши WBR с этой панели, что позволяет нам выявлять тенденции в потреблении и быстро реагировать на изменения в нашем бизнесе.
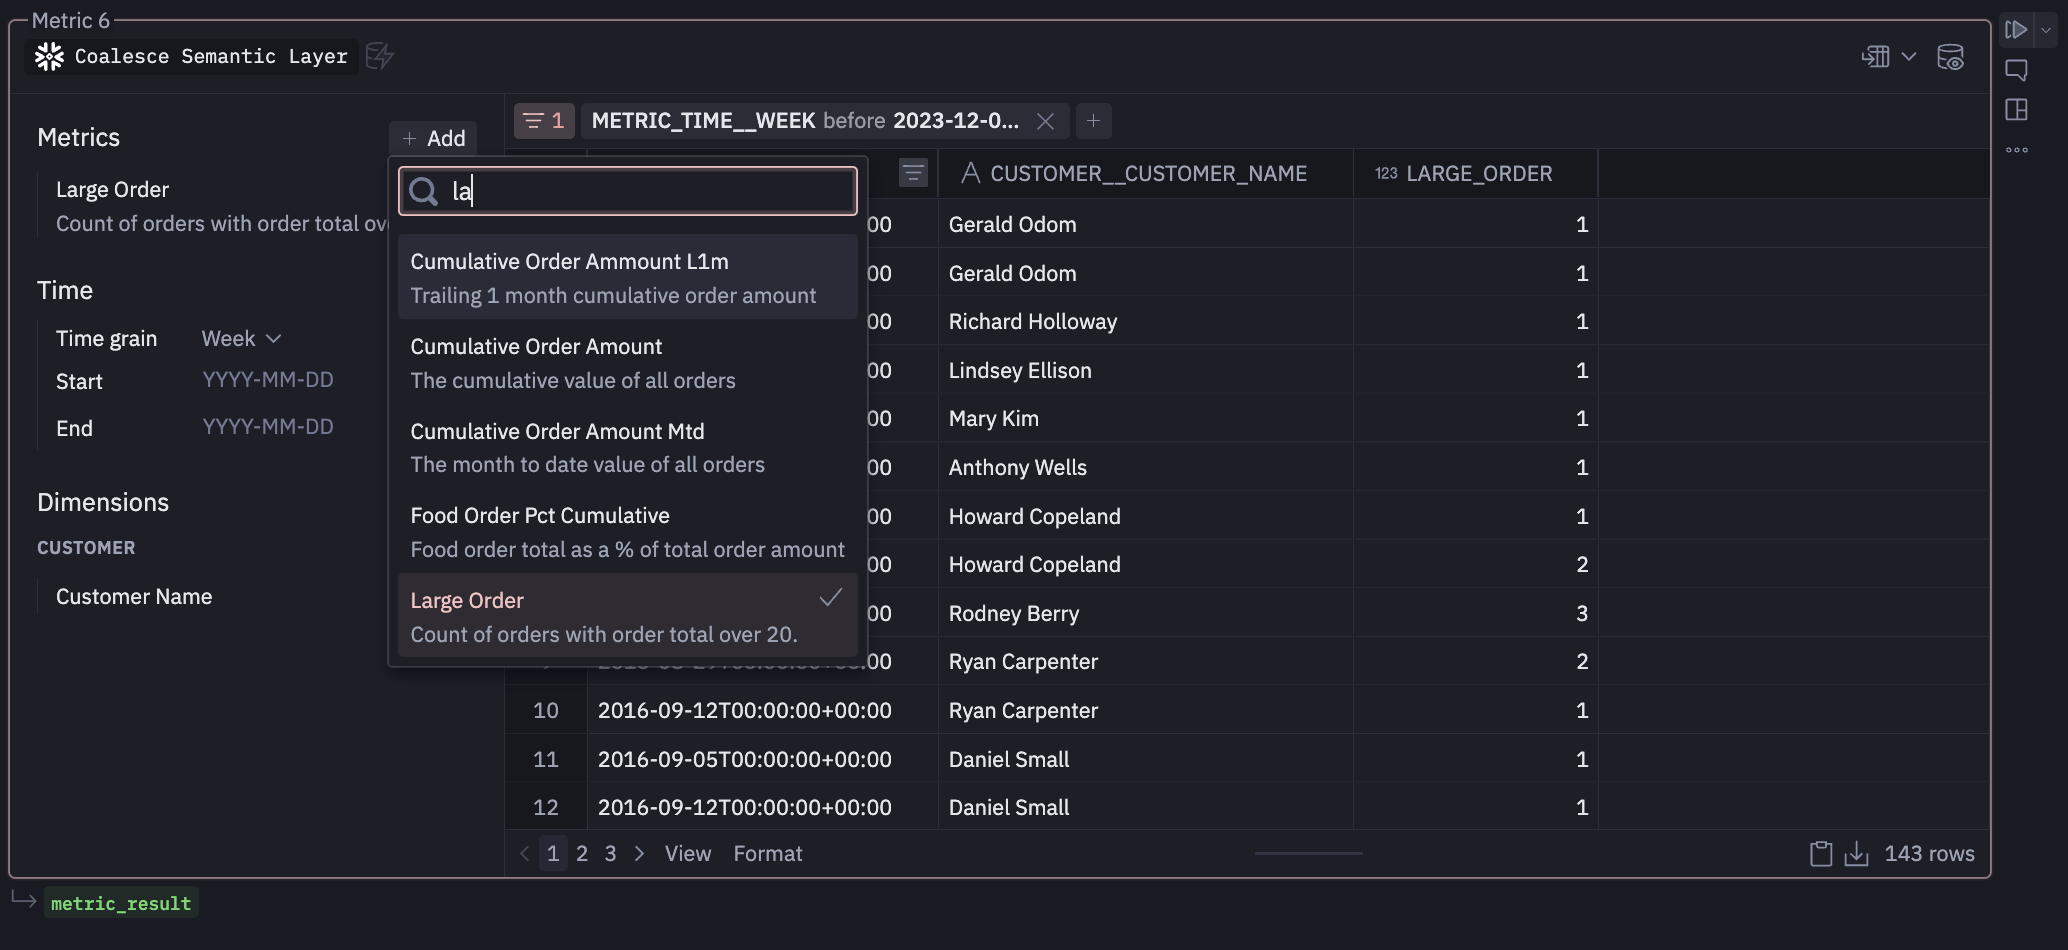 Конструктор запросов семантического слоя в Hex
Со стороны финансов и операций данные о использовании продукта имеют решающее значение для принятия обоснованных решений о ценообразовании. Все наши модели ценообразования создаются в электронных таблицах, поэтому мы используем интеграцию с Google Sheets, чтобы предоставить этим командам доступ к согласованным наборам данных без необходимости загружать CSV-файлы с панели Hex. Это позволяет команде по ценообразованию добавлять срезы измерений, такие как уровень и размер компании, к данным в режиме самообслуживания без необходимости запрашивать ресурсы команды данных для генерации этих инсайтов. Это позволяет нашей финансовой команде итеративно строить финансовые модели и быть более самостоятельными в извлечении данных, вместо того чтобы полагаться на ресурсы команды данных.
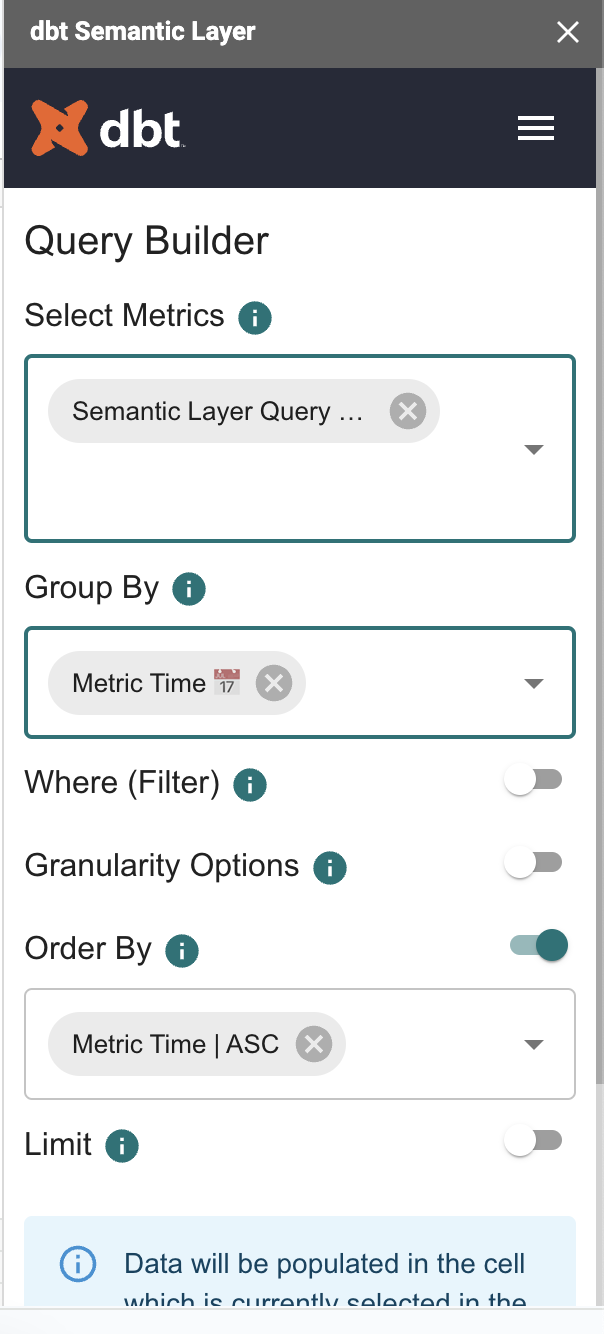 Конструктор запросов семантического слоя в Google Sheets
Как бывший дата-сайентист и инженер данных, я лично считаю, что это огромное улучшение по сравнению с подходом, который я бы использовал без семантического слоя. Мой старый подход заключался бы в материализации одной большой таблицы со всеми числовыми и категориальными столбцами, которые мне нужны для анализа. Затем я бы написал кучу SQL в Hex или различных блокнотах, чтобы создать отчеты для заинтересованных сторон. Неизбежно я подписываюсь на большее количество циклов разработки, чтобы обновить конвейер всякий раз, когда нужно добавить новое измерение или данные нужно агрегировать немного по-другому. С точки зрения управления командой данных, использование центрального семантического слоя экономит циклы аналитиков данных, так как пользователи могут легче самообслуживаться. В каждой компании, в которой я когда-либо работал, аналитики данных всегда пользуются высоким спросом, с большим количеством запросов, чем они могут разумно выполнить. Это означает, что всякий раз, когда заинтересованная сторона может самообслуживаться своими данными без нашего участия, это огромная победа.
Результат: Согласованные управляемые метрики
И вот так у нас есть сквозной конвейер для аналитики продукта на семантическом слое dbt с использованием самого семантического слоя dbt 🤯. Часть основополагающей работы по созданию этого конвейера будет вам знакома, например, создание нормализованной фактологической таблицы с использованием dbt. Надеюсь, что прохождение следующего шага добавления семантических моделей и метрик поверх этих моделей dbt помогло вам получить идеи о том, как вы можете использовать семантический слой для вашей команды. Наличие метрик запуска, определенных в dbt, значительно упростило поддержание всей организации в курсе принятия и производительности продукта. Вместо таблицы свертки или статических материализованных кубов мы добавили гибкие метрики без переписывания логики в SQL или добавления дополнительных таблиц в конец нашего DAG.
Результат — доступ к согласованным и управляемым метрикам в инструменте, который наши заинтересованные стороны уже используют для выполнения своей работы. Мы можем поддерживать согласованность всей организации и предоставлять им доступ к точным данным, которые им нужны, чтобы внести свой вклад в успех продукта семантического слоя. Спасибо за чтение! Если вы думаете об использовании семантического слоя или у вас есть вопросы, мы всегда рады продолжить разговор в сообществе dbt в Slack. Оставьте нам сообщение в #dbt-cloud-semantic-layer. Мы будем рады вас услышать!