Как на самом деле работает dbt State и помогает снизить затраты на вычисления
При создании проекта dbt вы начинаете с самой простой стратегии и добавляете сложность, только когда требуется повысить скорость или снизить затраты. На уровне отдельных моделей это переход от материализации view к table, а затем к incremental. На уровне всего проекта оптимизации раньше требовали куда большей сложности: чтобы перестраивать только нужные части проекта, приходилось тратить немало умственных усилий на комбинирование селекторов вроде state:modified, source_status:fresher или config.materialized:view и следить за тем, чтобы актуальные JSON-артефакты были доступны всем в организации.
dbt State одновременно повышает скорость, снижает затраты и упрощает работу. Он работает везде, где работаете вы: в dbt Core или Fusion, локально или в любом выбранном вами оркестраторе. Поскольку в его основе лежит новый платный сервис с бесплатным пробным периодом на 30 дней, вам не нужно переходить на всю платформу dbt, чтобы получить эту экономию. dbt State приходит на смену оркестрации с учетом состояния, для которой требовались подписка на платформу dbt и переход на Fusion.
Самая интересная с технической точки зрения часть — процесс нормализации запросов1, благодаря которому запуск новой команды dbt lint не приводит сразу к полной пересборке. Но прежде чем углубляться в синтаксические деревья, давайте вспомним, что именно dbt State делает для конечного пользователя.
Базовый рабочий процесс dbt State
При запуске dbt проверяет на сервере dbt State, выполняется ли для модели одно из условий:
- она уже существует в целевой схеме и может быть использована повторно;
- она уже существует в другой схеме и может быть использована повторно;
- ее необходимо построить с нуля.
Повторное использование эквивалентных объектов
В этом примере команда dbt build в пустой среде dev_joel клонирует все объекты, для которых доказано отсутствие изменений, из другой среды с эквивалентными данными, а также повторно использует результаты тестов для этих узлов.
Пропуск несущественных изменений
«Доказанное отсутствие изменений» не обязательно означает, что файл полностью совпадает с предыдущей версией. Благодаря пониманию SQL dbt State игнорирует несущественные изменения, например добавление комментария или изменение пробельных символов (скажем, при запуске dbt lint --fix).
Выборочная пересборка
Когда файл действительно меняется (или изменяется родительский узел выше по графу либо в нем появляются новые данные), модель перестраивается, как и ожидается. Но, в отличие от state:modified+, зависимые модели ниже по графу можно пропустить, если dbt State определит, что изменение на них не влияет. В этом примере представление customers явно перечисляет используемые столбцы, поэтому добавление нового столбца в orders не вызывает ненужной пересборки.
Повторное использование из любой подходящей схемы
При поиске объектов для повторного использования dbt State не ограничивается одной средой. Если Тоби переключится на ветку, работа над которой еще идет, и запустит построение той же модели, он клонирует таблицу из среды разработки, а не построит ее с нуля, хотя в производственной среде она еще не создавалась. Стоит отметить еще один момент: определение нового теста неверно, поэтому тест завершается неудачно. Хотя тест не выполняется повторно, предупреждение о нем все равно отображается.
Подробнее о внутренней работе
Давайте чуть подробнее рассмотрим, как dbt State решает, что делать с каждым узлом в DAG. Вот три главных вопроса:
- Изменилась ли логика узла или любого из его родительских узлов?
- Появились ли свежие данные, из-за которых превышен настроенный предел
lag_tolerance? - Изменилась ли конфигурация узла?
Нормализация запросов
Обычный селектор dbt state:modified вычисляет хеш содержимого файла. dbt State действует точнее: он преобразует запрос в синтаксическое дерево, а затем вычисляет хеш запроса. Поэтому изменения, сохраняющие эквивалентность запроса, например удаление пробельных символов, добавление комментария или изменение псевдонима таблицы, не приводят к пересборке.
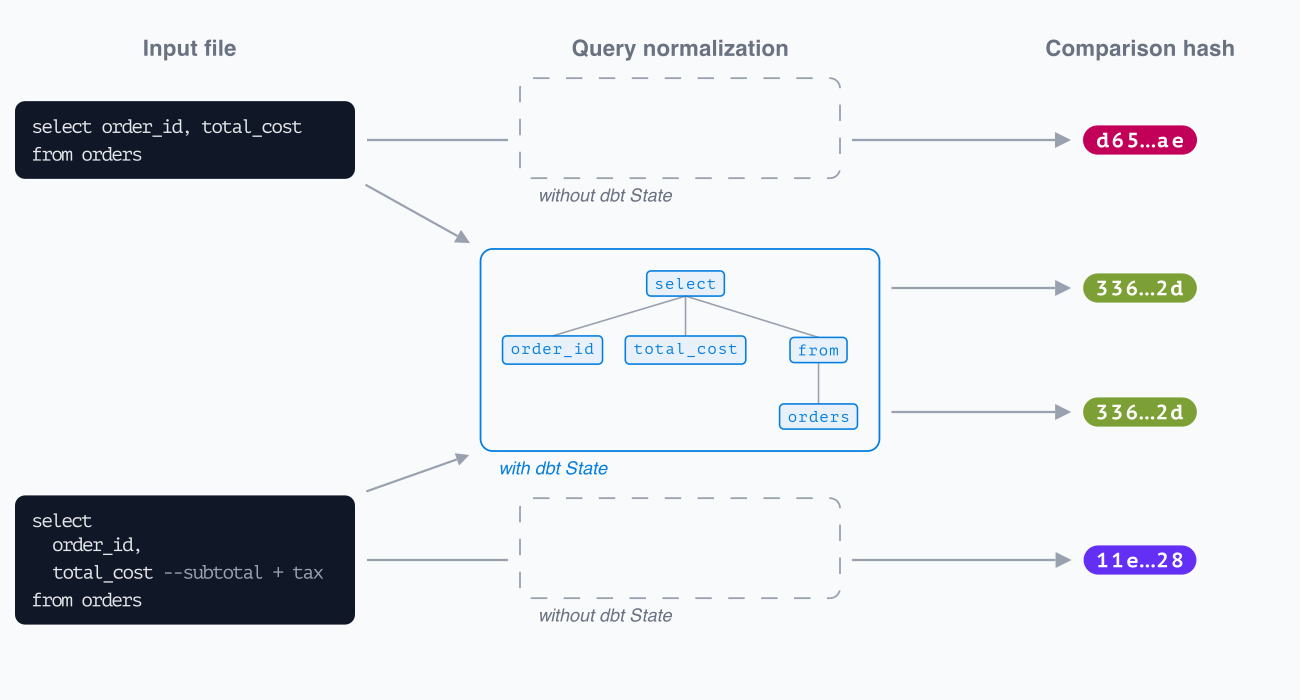 dbt State считает запросы эквивалентными, несмотря на косметические различия
Цель этой нормализации — обеспечить пересборку модели только при изменении ее логики или данных. Здесь есть один нюанс: SQL-функции с изменчивым результатом, такие как current_timestamp() или random(). Считать ли их логикой, как и любой другой код? Или они сами являются данными, и при изменении их результата модель теряет актуальность и должна быть перестроена?
По умолчанию такие SQL-функции считаются логикой. Хеш вычисляется на основе имени функции, а не возвращаемого ею значения. Обычно это правильный выбор: иначе ни одну модель, использующую getdate() (и ни одну из ее зависимых моделей), вообще нельзя было бы использовать повторно! Но если в вашей модели хеш должен меняться при изменении результата функции, есть два варианта:
- Используйте функцию Jinja: разбор и нормализация выполняются после рендеринга Jinja, поэтому
{{ modules.datetime.datetime.now() }}каждый раз будет давать другой результат. - Установите для параметра
evaluate_volatile_sqlв модели значение true.
Из этих вариантов обычно лучше выбрать настройку параметра: она применяется сразу ко всем функциям в модели и может наследоваться, как и любая другая настройка. Когда этот параметр включен, dbt State эмулирует значение функции и включает его в хеш SQL.
Проверки свежести данных
dbt State получает время последнего изменения для каждого объекта Relation в запросе. Для эффективности по умолчанию используются метаданные хранилища, но вы также можете указать loaded_at_field/loaded_at_query.
Если какой-либо из входных объектов Relation является представлением без заданного loaded_at_field/loaded_at_query, State продолжает обход вверх по графу зависимостей, пока не найдет физическую таблицу, и использует ее временную метку.
Он отправляет сведения о свежести данных и текст запроса на сервер dbt State, чтобы определить, возможно ли повторное использование и каким способом (после завершения работы сервера текст запроса удаляется).
lag_tolerance
В среде разработки вам, скорее всего, не нужно повторно клонировать объекты из другой среды при каждом поступлении свежих данных. Хотя клонировать модель быстрее и дешевле, чем строить ее с нуля, еще быстрее и дешевле — вообще ничего не делать.
Иными словами, вы готовы допускать определенное отставание данных, причем для разных сред оно различается. Этот предел lag_tolerance можно задать в конфигурации модели в зависимости от среды:
# dbt_project.yml

models:
  +state:
    lag_tolerance: "{{ '4h' if target.name == 'prod' else '7d' }}"
При такой настройке dbt State не будет рассматривать клонирование моделей, пока где-то еще не появятся свежие данные и возраст текущих данных не достигнет 7 дней. Модель в пределах допустимого отставания по-прежнему будет учитываться как DATT, если вы выберете ее для выполнения и ее можно будет использовать повторно, поэтому мы рекомендуем продолжать использовать селекторы при разработке.
Изменения конфигурации
Некоторые настройки модели, например meta или tags, ничего не меняют в ее представлении в базе данных. Другие, такие как on_schema_change, severity или materialization, при изменении напрямую влияют на процесс построения модели. dbt State учитывает только значимые настройки. Если у вас есть пользовательский post-hook, который обновляет таблицы на основе игнорируемых полей (как здесь), установите для execute_hooks_on_any_reuse значение true.
Советы по настройке dbt State
Внедрите использование во всей команде
Чем больше людей в вашей команде повторно используют модели благодаря dbt State, тем больше будет выгода по сравнению с построением этих моделей с нуля при каждом запуске.
Обычно сначала один-два опытных пользователя в команде пробуют dbt State в работе. На этом этапе экспериментов используйте флаг --manage-state, переменную окружения DBT_ENGINE_MANAGE_STATE или файл ~/.dbt/user_settings.yml, чтобы включить State только для себя (это произойдет автоматически при запуске dbt login).
Когда вы будете готовы к более широкому внедрению, обновите файл dbt_project.yml и сохраните его в системе контроля версий. При следующем запуске dbt вашим коллегам, использующим современную версию dbt, будет предложено войти в систему. Помните, что для версий 1.11 и ниже сначала нужно явно выполнить pip install dbt-state.
# dbt_project.yml
flags:
  manage_state: true
Помогите определить дальнейшее развитие dbt State
Использование dbt State очень похоже на привычную разработку с dbt, но при этом требует нового взгляда на работу. Лучше всего начать с руководства по настройке dbt State. А затем, если захотите обсудить свой опыт, поделиться отзывами или задать вопросы, присоединяйтесь к нам в канале #dbt-state в Slack.
Footnotes
-
На втором месте по интересности — два имени в списке авторов этой статьи. Добро пожаловать в блог для разработчиков, Тоби! ↩