Ваш контрольный список для проекта dbt
Если вы используете dbt более года, ваш проект устарел. Это естественно.
Появились новые функции. Изменяются хранилища данных. Обновляются лучшие практики. За последний год я и другие члены команды Fishtown Analytics (теперь dbt Labs!) провели семь аудитов для клиентов, которые использовали dbt минимум 2 месяца.
В каждом аудите мы находили возможности для:
- Улучшения производительности
- Повышения удобства сопровождения
- Упрощения для новых участников проекта
Этот пост — контрольный список, который я создал для руководства нашей внутренней работой, и я делюсь им здесь, чтобы вы могли использовать его для очистки вашего собственного проекта dbt. Думайте об этом контрольном списке как о книге Где Уолдо?: вам все равно придется его искать, но с этим списком вы хотя бы будете знать, что искать.
✅ dbt_project.yml
- Соглашения об именовании проектов
- Как называется ваш проект?
- Вы оставили название ‘my_new_project’, заданное при инициализации проекта, или переименовали его во что-то более осмысленное?
- Мы рекомендуем называть проект в честь вашей компании, например ‘fishtown_analytics’.
- Если у вас несколько проектов dbt, более подходящим может быть название вроде ‘fishtown_analytics_marketing’.
- Как называется ваш проект?
- Есть ли у вас избыточные настройки, такие как materialized: представление?
- По умолчанию модели dbt материализуются как представления («views»). Поэтому явно указывать материализацию view для моделей не требуется.
- Если все модели в папке — это таблицы, задайте материализация в файле dbt_project.yml, а не в файле модели. Это избавит файл модели от лишних настроек.
- Осталось ли у вас множество шаблонных комментариев, созданных командой init?
- Они лишь загромождают файлы.
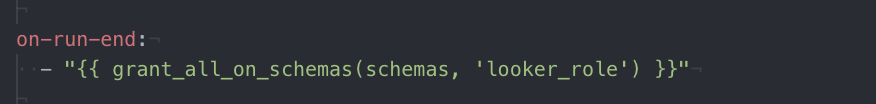
- Используете ли вы post-hooks для предоставления прав доступа другим специалистам по преобразованию данных и пользователям BI?
- Если нет, стоит начать! Это обеспечит вашим коллегам доступ к результатам любых изменений и позволит использовать их на уровне BI.
 По завершении выполнения
- Если нет, стоит начать! Это обеспечит вашим коллегам доступ к результатам любых изменений и позволит использовать их на уровне BI.
- Используете ли вы теги в проекте?
- У большинства моделей вашего проекта не должно быть тегов. Используйте теги для моделей и тестов, с которыми нужно работать иначе, чем с остальными. Например, имеет смысл пометить тегом ‘nightly’ модели, запускаемые по ночам, но также помечать все остальные модели тегом ‘hourly’ необязательно — можно просто исключить модели с тегом ‘nightly’!
- Проверьте, не лучше ли здесь использовать селектор узлов вместо тегов.
- Задаёте ли вы теги для отдельных моделей в блоках config?
- Во многих случаях можно использовать селекторы папок, чтобы не назначать теги каждой модели в папке.
- Используете ли вы YAML-селекторы?
- Они позволяют выполнять сложный многоуровневый выбор моделей, избавляют от необходимости в сложных механизмах назначения тегов и делают конфигурацию проекта более понятной.
Полезные ссылки:
✅ Управление пакетами
- Насколько актуальны версии ваших dbt пакетов?
- Вы можете проверить это, посмотрев на ваш файл packages.yml и сравнив его с страницей пакетов на hub.
- Установлен ли у вас пакет dbt_utils?
- Это, безусловно, наш самый популярный и необходимый пакет. Пакет содержит умные макросы для улучшения вашего проекта dbt. После его внедрения у вас будет доступ к макросам (нет необходимости копировать их в ваш проект).
Полезные ссылки
✅ Стиль кода
- Есть ли у вас четко определенный стиль кода?
- Строго ли вы его придерживаетесь?
- Оптимизируете ли вы ваш SQL?
- Используете ли вы оконные функции и агрегации?
Полезные ссылки
✅ Структура проекта
- Если вы используете dimensional modeling техники, есть ли у вас модели для стадий и витрин?
- Используют ли они префиксы таблиц, такие как ‘fct_’ и ‘dim_’?
- Является ли код модульным? Это одна трансформация на одну модель?
- Фильтруете ли вы как можно раньше?
- Одна из самых распространенных ошибок, которые мы обнаружили, это недостаточно раннее фильтрование или трансформация. Это приводит к тому, что несколько моделей ниже по потоку имеют одну и ту же повторяющуюся логику (т.е. мокрый код) и делает обновление бизнес-логики более трудоемким.
- Являются ли CTE модульными с одной трансформацией на CTE?
- Если у вас есть файлы макросов, называете ли вы их так, чтобы они четко представляли макрос(ы), содержащиеся в файле?
Полезные ссылки
- Как Fishtown структурирует наш проект dbt
- Почему руководство по стилю SQL Fishtown использует так много CTE
✅ dbt
-
Какую версию dbt вы используете?
- Чем сильнее ваша версия отстаёт от последнего релиза, тем выше вероятность, что в ней остаются старые ошибки, а обновление становится всё сложнее.
-
Что происходит при выполнении
dbt run?- Какие модели выполняются дольше всего?
- Не пора ли пересмотреть стратегию моделирования?
- Стоит ли сделать модель инкрементальной?
- Если она уже инкрементальная, стоит ли скорректировать стратегию инкрементального обновления?
- Сколько времени занимает выполнение всего проекта dbt?
- Все ли модели выполняются? (Это не шутка.)
- Если нет, то почему?
- Есть ли у вас циклические ссылки между моделями?
- Какие модели выполняются дольше всего?
-
Используете ли вы источники?
- Если да, используете ли вы проверки актуальности источников?
-
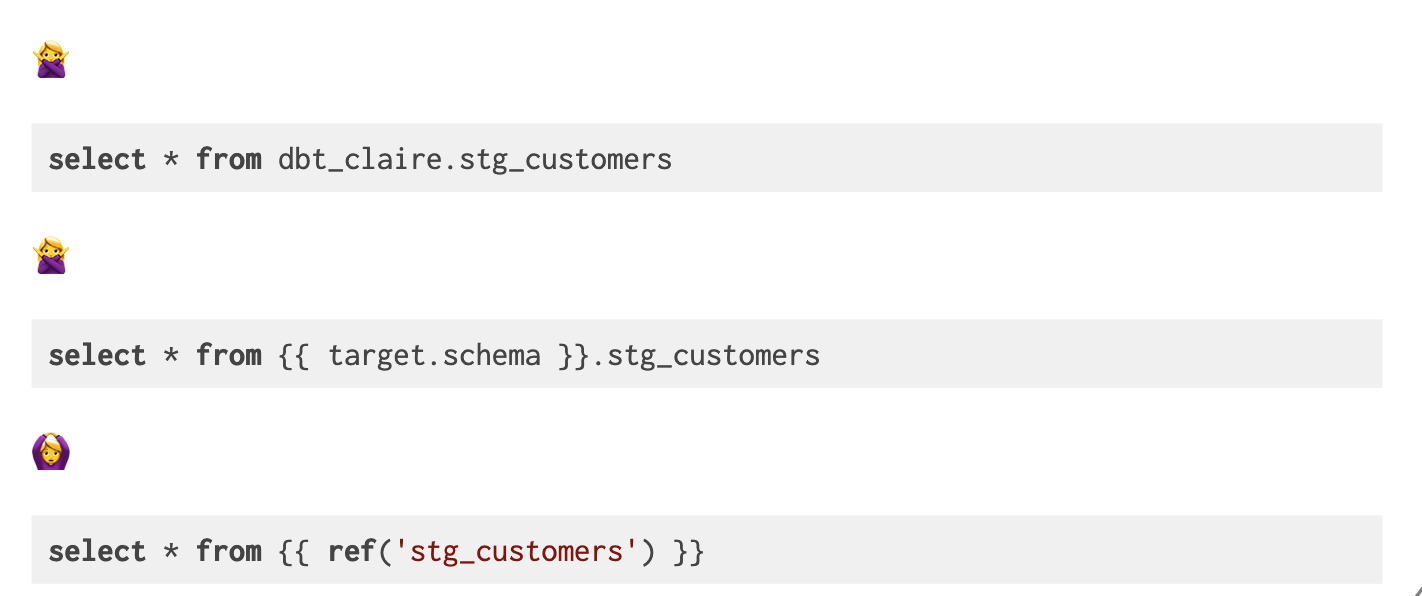
Используете ли вы
refиsourceдля всех ссылок на модели и источники?- Убедитесь, что нигде нет прямых запросов к таблицам с необработанными данными и т. п.
 Без прямых запросов к таблицам с необработанными данными
- Убедитесь, что нигде нет прямых запросов к таблицам с необработанными данными и т. п.
-
Регулярно ли вы запускаете
dbt testкак часть вашего рабочего процесса и производственных заданий? -
Используете ли вы Jinja и макросы для повторяющегося кода?
- Если да, соблюден ли баланс, чтобы это не использовалось чрезмерно до такой степени, что код становится нечитаемым?
- Легко ли читается ваш Jinja?
- Разместили ли вы все ваши
setоператоры в начале файлов моделей? - Форматировали ли вы код для читаемости Jinja или только для скомпилированного SQL?
- Изменяете ли вы пробелы?
- Пример:
{{ this }}а не{{this}}
- Пример:
- Разместили ли вы все ваши
- Сделали ли вы сложные макросы максимально доступными?
- Способы сделать это: предоставление имен аргументов и встроенная документация с использованием
{# <вставьте текст> #}
- Способы сделать это: предоставление имен аргументов и встроенная документация с использованием
-
Если у вас есть инкрементные модели, используют ли они уникальные ключи и макрос is_incremental()?
-
Если у вас есть теги, имеют ли они смысл? Используются ли они?
Полезные ссылки
✅ Тестирование и непрерывная интеграция
- Есть ли у ваших моделей тесты?
- Идеальный проект имеет 100% покрытие тестами всех своих моделей. Хотя есть случаи, когда это не имеет смысла, наше правило заключается в том, что модели должны иметь хотя бы тест на not_null/unique на первичный ключ.
- Что вы тестируете? Имеет ли это смысл?
- Какие предположения вы должны тестировать?
- Подумайте о вашей основной бизнес-логике, а также о вашем понимании ваших источников.
- Используете ли вы pull-запросы/другие формы управления версиями?
- Насколько легко понять, что делает изменение кода и намерение за изменением кода?
- Есть ли у вас обязательные проверки PR перед слиянием кода в ваш проект dbt или слой BI?
- Используете ли вы шаблон PR?
Полезные ссылки
✅ Документация
- Используете ли вы документацию?
- Есть ли описания для каждой модели?
- Объяснены ли сложные трансформации и бизнес-логика в легкодоступном месте?
- Используют ли ваши заинтересованные стороны вашу документацию?
- Если нет, то почему?
- Есть ли у вас readme и регулярно ли вы его обновляете?
- Насколько легко было бы ввести кого-то в ваш проект?
- Если у вас есть описания на уровне столбцов, используете ли вы блоки документации?
Полезные ссылки
✅ Специфика dbt Cloud
- Какую версию dbt используют задания?
- Большинство из них наследуют от окружения, чтобы упростить обновление?
- Как выглядят ваши задания? Имеют ли они смысл?
- Как организованы ваши проекты в dbt cloud?
- Есть ли у вас неиспользуемые проекты?
- Выбрали ли вы наиболее подходящее задание для документации уровня вашего аккаунта?
- Синхронизируется ли количество запусков с тем, как часто обновляются и просматриваются ваши сырые данные?
- Если ваши данные не обновляются так часто, как происходят запуски, это просто ничего не делает.
- Есть ли у вас полное обновление производственных данных?
- Запускаете ли вы тесты на периодической основе?
- Какие задания выполняются дольше всего?
- Есть ли у вас задание для непрерывной интеграции? (Только для Github)
Используете ли вы IDE и если да, то насколько хорошо?
- Мы обнаружили, что IDE помогло в решении проблем с поддержанием обновленной версии dbt.
- Есть ли у dbt cloud свой пользователь в их хранилище? Какое хранилище/роль по умолчанию?
- Получаете ли вы уведомления о неудачных заданиях? Настроили ли вы уведомления в Slack?
Полезные ссылки
✅ Аудит DAG
Примечание: диаграммы в этом разделе показывают, чего НЕ следует делать!
- Есть ли в вашем DAG какие-либо распространенные ошибки моделирования?
-
Есть ли прямые соединения из источников в промежуточную модель?
-
Все источники должны иметь соответствующую модель стадии для очистки и стандартизации структуры данных. Они не должны выглядеть как изображение ниже.
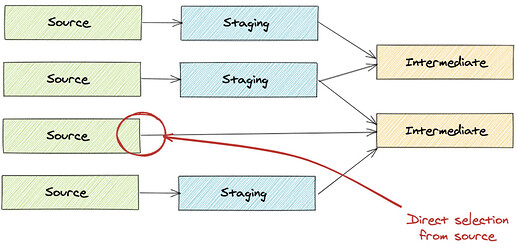 Пример неудачного графа зависимостей
-
-
Соединяются ли источники напрямую друг с другом?
-
Все источники должны иметь соответствующую модель стадии для очистки и стандартизации структуры данных. Они не должны выглядеть как изображение ниже.
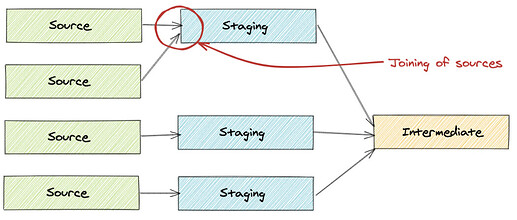 Пример неудачного графа зависимостей 2
-
-
Есть ли повторное соединение концепций верхнего уровня?
- Это может указывать на:
-
модель может нуждаться в расширении, чтобы все необходимые данные были доступны ниже по потоку
-
необходима новая промежуточная модель для соединения концепций для использования в обоих местах
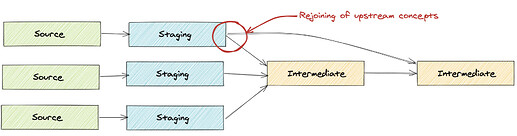 Пример неудачного графа зависимостей 2
-
- Это может указывать на:
-
Есть ли "изгибающиеся соединения"?
-
Зависимы ли модели в одном слое друг от друга?
-
Это может указывать на необходимость изменения именования или модель должна ссылаться на модели выше по потоку
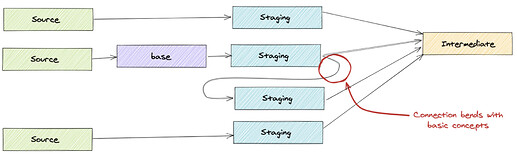 Пример неудачного графа зависимостей 3
-
-
Есть ли разветвления моделей промежуточных/измерений/фактов?
-
Это может указывать на то, что некоторые трансформации следует перенести на уровень BI или трансформации следует переместить выше по потоку
-
Ваш проект dbt нуждается в определенной конечной точке!
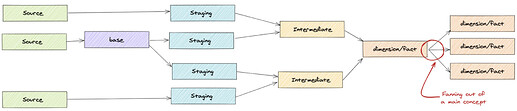 Пример неудачного графа зависимостей 4
-
-
Есть ли повторяющаяся логика в нескольких моделях?
- Это указывает на возможность переместить логику в модели выше по потоку или создать конкретные промежуточные модели, чтобы сделать эту логику повторно используемой
- Одно из распространенных мест для поиска этого — сложная логика соединения. Например, если вы проверяете несколько полей на определенные значения в соединении, их можно, вероятно, свести к одному полю в модели выше по потоку, чтобы создать чистое, простое соединение.
-
Благодарим Кристину Бергер за ее диаграммы DAG!
Полезные ссылки
- Как мы структурируем наш проект dbt
- Доклад об аудите DAG на Coalesce
- Техника модульного моделирования данных
- Понимание потоков
Это краткий обзор вещей, о которых стоит подумать в вашем проекте. Мы будем обновлять этот пост по мере продолжения совершенствования наших лучших практик! Удачного моделирования!