Постиг ли навыки dbt «горький урок»?
 Смерть с косой с надписью «Горький урок» уже побывала у дверей «Обработка естественного языка» и «Промпт-инжиниринг», а теперь стучится в дверь «Навыки»
Помните, каково было писать код с ИИ в это же время год назад? Модели умели писать SQL, но плохо принимали решения. Они упускали многие профессиональные нюансы, которые учитывают опытные инженеры-аналитики. Навыки казались очевидным решением: дать агенту знания, необходимые для конкретной задачи, чтобы не начинать каждый раз с нуля и не набивать один AGENTS.md всем, что только может пригодиться. Навыки появились в Claude в октябре 2025 года, а в декабре того же года стали открытым стандартом. Мы создали собственный набор навыков dbt для агентов, чтобы дать агентам для написания кода недостающие соглашения, команды и шаблоны.
С тех пор модели заметно улучшились, и всегда стоит помнить о «горьком уроке» ИИ: изощрённые решения в долгосрочной перспективе проигрывают простому наращиванию вычислительных ресурсов для решения задачи. Поэтому я захотел проверить, оправдана ли ещё эта ставка. Могут ли новейшие модели создавать и поддерживать dbt-проект реального масштаба без навыков? И если да, то где навыки по-прежнему полезны?
Я потратил пару дней по несколько часов на создание прототипа системы оценки, чтобы это выяснить: 22 запуска агентов, до 12 задач в каждом, dbt-проект о «Формуле-1» в Snowflake. Выяснилось, что хорошие запуски от плохих отличал процесс работы, а не знание dbt. Я бы не назвал этот вывод окончательным, но в условиях столь быстрых изменений он уже повлиял на моё отношение к навыкам.
 Пройденные проверки во втором раунде по моделям и вариантам эксперимента. На результат повлияло поколение модели, а не навыки
- Разброс между запусками больше любого эффекта от навыков. Один и тот же вариант — Sonnet 5.5 с доступными навыками — набрал 61%, 100% и 67% в трёх запусках.
- Модели 5.5 уже знают dbt. В 12 из 19 запусков Claude 5.5 были пройдены все проверки, а без навыков каждая модель 5.5 прошла не менее 92%.
- Агенты редко открывали навыки по собственной инициативе, а когда открывали, то чаще всего для незнакомых областей, таких как Semantic Layer или dbt Mesh.
- Новое поколение модели даёт больше, чем навык. Sonnet 4.5 набрала 38% без навыков и 17% с обязательным использованием навыков — два самых низких результата среди всех запусков, причём в обязательном варианте модель прочитала навыки ещё до написания первой модели dbt. (Тот самый «горький урок».)
- Преобладали ошибки процесса: тест, зафиксировавший сегодняшние ответы, неудачные попытки восстановления из резервной копии, игнорирование определений, неверно выбранные окна ретроспективной обработки.
Если вы поддерживаете навыки для команды: уберите документацию, объясняющую, как работает dbt, оставьте материалы о возможностях, которые ещё не полностью интегрированы в ваш стек, и создайте новые навыки о том, как ваша команда тестирует, развёртывает и проверяет изменения. В дальнейшем команды, которые понимают свой процесс и знают, как его поддерживать и улучшать, смогут гораздо эффективнее использовать передовые модели.
Среда оценки
Мне хотелось чего-то более близкого к реальной работе инженера-аналитика, чем набор задач, которые агент может решить за один подход. Проекта, который начинается с нуля, растёт по мере выполнения задач и сталкивается с тем, что ломает реальные проекты. Запоздавшие данные, изменения у поставщиков, некорректные строки и заинтересованные стороны с расплывчатыми вопросами.
Данные
Я использовал набор данных чемпионата мира «Формулы-1» с Kaggle — копию старой базы данных Ergast F1 (отсюда названия моделей stg_ergast далее): 14 реляционных таблиц со всеми гонками с 1950 по 2024 год, всего около 700 000 строк, включая 589 000 записей времени прохождения кругов. Я загрузил всё в Snowflake в текстовом виде, в точности как в CSV-файлах, поэтому очистка и приведение типов тоже входили в работу. Агенты создавали проект на dbt v2.
В данных F1 полно ловушек, которые не выглядят ловушками:
- Значения null представлены буквальной строкой
\N, а местами — пустой строкой. - Время круга хранится как текст, например
1:27.452. - До 1991 года в зачёт чемпионата шли только лучшие результаты гонщика, поэтому простое суммирование очков за гонки даёт неверные итоги сезона. В 1988 году Ален Прост набрал больше очков, чем Айртон Сенна, но титул выиграл Сенна.
- В 1950-х гонщики иногда делили одну машину и полученные очки.
- Идентификаторы результатов спринтов пересекаются с идентификаторами результатов Гран-при.
- Остановки гонки красным флагом выглядят как 20-минутные «пит-стопы».
Большинство этих особенностей я не упоминал в промптах, поэтому агентам приходилось находить их самостоятельно. Исключение — остановки из-за красного флага: первая задача второго раунда требует исключать пит-стопы длительностью более 60 секунд.
Варианты эксперимента
Три модели Claude — Opus 5.5, Sonnet 5.5 и Haiku 5.5 (далее Opus, Sonnet и Haiku), каждая в трёх вариантах:
| Вариант | Настройка |
|---|---|
| Без навыков | Чистая сессия Claude Code, веб-поиск и загрузка веб-страниц отключены |
| Навыки доступны | То же самое, плюс навыки dbt для агентов, установленные как навыки проекта |
| Навыки обязательны | То же самое, плюс однострочный CLAUDE.md, предписывающий агенту использовать соответствующие навыки перед каждой задачей |
Дословно одинаковые задачи, отдельные схемы Snowflake, режим разрешений Auto в Claude Code и заготовленный ответ «руководствуйся здравым смыслом» на любой вопрос. После первых 17 запусков я добавил ещё пять: ещё два запуска Sonnet 5.5 с доступными навыками и Sonnet 4.5 (сентябрь 2025 года) во всех трёх вариантах.
Впрочем, запуски не были полностью изолированы. Приложение предоставило этим сессиям общую папку заметок, и в восьми запусках агенты прочитали заметки о данных из другого запуска — в основном во время первой задачи второго раунда, — прежде чем я это заметил и закрыл доступ. Некоторые особенности данных передавались между запусками, а не обнаруживались заново; файл results/run_extra.json в репозитории содержит список того, какие запуски читали какие заметки.
Цикл оценивания
После каждой задачи тестовая обвязка добавляла новые данные (запоздавшие гонки, исправленное время кругов, изменения формата данных поставщика, дублирующиеся строки), самостоятельно пересобирала проект без --full-refresh и построчно сравнивала каждую требуемую модель с эталоном, построенным на чистой копии данных. Агент никогда не видел оценку. Оценки были накопительными, поэтому ошибка в задаче 1 продолжала снижать результат, пока её не исправляли, а каждый запуск представлял собой одну непрерывную сессию, так что навык, прочитанный в задаче 1, мог по-прежнему влиять на задачу 9.
 Цикл для каждой задачи: тестовая обвязка добавляет данные, пересобирает проект и оценивает результат после каждой задачи
В конце новая сессия Opus проводила слепое ревью кода каждого проекта по шкале от 1 до 5; перед этим из проекта удалялись навыки, CLAUDE.md и история git.
Раунд 1: все справились на отлично
Первый набор включал семь задач: создать четыре витрины, добавить инкрементальную модель времени кругов с обработкой повторно выпущенных исправлений, создать снимок истории гонщиков, включить спринты в результаты и переработать турнирные таблицы, адаптироваться к изменениям формата данных поставщика, разобраться с удвоенным итогом Ferrari и внедрить контракты и версионируемую модель. Во всех запусках, кроме одного, были пройдены все 43 проверки по эталону — как с навыками, так и без них, а единственный промах (Haiku с обязательными навыками) был связан с неверно понятым определением, а не с ошибкой в dbt. Агенты с доступными навыками открыли от нуля до трёх файлов навыков за семь задач. Первый раунд оказался недостаточно сложным: создать хорошую оценку непросто, и она должна быть гораздо сложнее и конкретнее, чем набор отдельных задач.
Раунд 2: более сложный набор
Во втором раунде я хотел увеличить масштаб, сложность и число используемых возможностей dbt, чтобы точнее воспроизвести рабочий процесс инженера-аналитика и найти уровень, на котором можно получить существенные результаты.
Второй раунд включает 12 задач. Он начинается с углублённой версии каждой задачи первого раунда: семь обязательных витрин вместо четырёх, плюс отрезки на одном комплекте шин, запоздавшие данные о гонщиках и расчёт альтернативных итогов чемпионата с полным разрешением равенства очков по числу лучших результатов. Затем добавляется работа, которая проверяет скорее инженерное мышление, чем знание синтаксиса dbt:
| Задача | Что проверяет |
|---|---|
| Второй поток данных от поставщика | Поток для перекрёстной проверки со своими идентификаторами, именами в формате SURNAME Forename без диакритики, прозвищем и сессиями, названными по автодрому, так что две гонки 2020 года в Шпильберге можно различить только по дате. Агент строит таблицы соответствий и витрину расхождений; результат проверяется на точное совпадение с 11 заранее внесёнными конфликтами. |
| Телеметрия в большом объёме | 20 миллионов строк автомобильной телеметрии, в которых измерения могут поступать с задержкой в несколько недель. Обычные запуски не должны повторно сканировать сырую таблицу. Оцениваются корректность после поступления запоздавших данных и объём просканированных байтов. |
| Slim CI | Целевые окружения prod и CI, сохранённые артефакты prod и CI-скрипт, который собирает только изменённое, а для остального использует prod через deferral. Оценка проводится путём изменения модели и проверки, что скрипт собрал в точности нужные модели. |
| Расплывчатые запросы руководства | «Какие гонщики действительно выступают лучше, чем позволяет их машина? Мне нужен список, которому можно доверять» и «Пит-стопы действительно становятся быстрее или это миф?». Оцениваются только слепым ревьюером. |
Во втором раунде были и более сложные скрытые ловушки. В задаче об изменении формата данных поставщика даты переключались на DD/MM/YYYY, который некоторые парсеры читали, меняя день и месяц местами. В задаче об ошибке данных упоминалась только Ferrari, но тестовая обвязка также повторно отправляла строки турнирной таблицы одной гонки. Кроме того, во втором раунде Opus запускалась с обязательными навыками — этот вариант в первом раунде был пропущен, — так что каждая модель прошла все три варианта.
Краткое сравнение первого и второго раундов
| Раунд 1 | Раунд 2 | |
|---|---|---|
| Задачи | 7 | 12 |
| Запуски | 8 | 9 плюс 5 повторных запусков |
| Обязательные витрины в задаче создания проекта с нуля | 4 | 7 |
| Проверки по эталону на запуск | 43 | 154 |
| Сырые входные данные | 14 таблиц Ergast, около 700 000 строк | То же самое, плюс поток поставщика из 3 таблиц и 20 миллионов строк телеметрии |
| Модели в проекте Opus без навыков | 20 | 50 |
| Помимо витрин | Инкрементальная модель времени кругов, снимок истории гонщиков, спринты, изменения формата данных поставщика, заранее внесённая ошибка Ferrari, контракты и версионируемая модель | Всё перечисленное, плюс отрезки на одном комплекте шин, запоздавшие данные о гонщиках, разрешение равенства очков по лучшим результатам, метрики Semantic Layer, перекрёстная проверка данных поставщика, телеметрия в большом объёме, slim CI и два расплывчатых запроса |
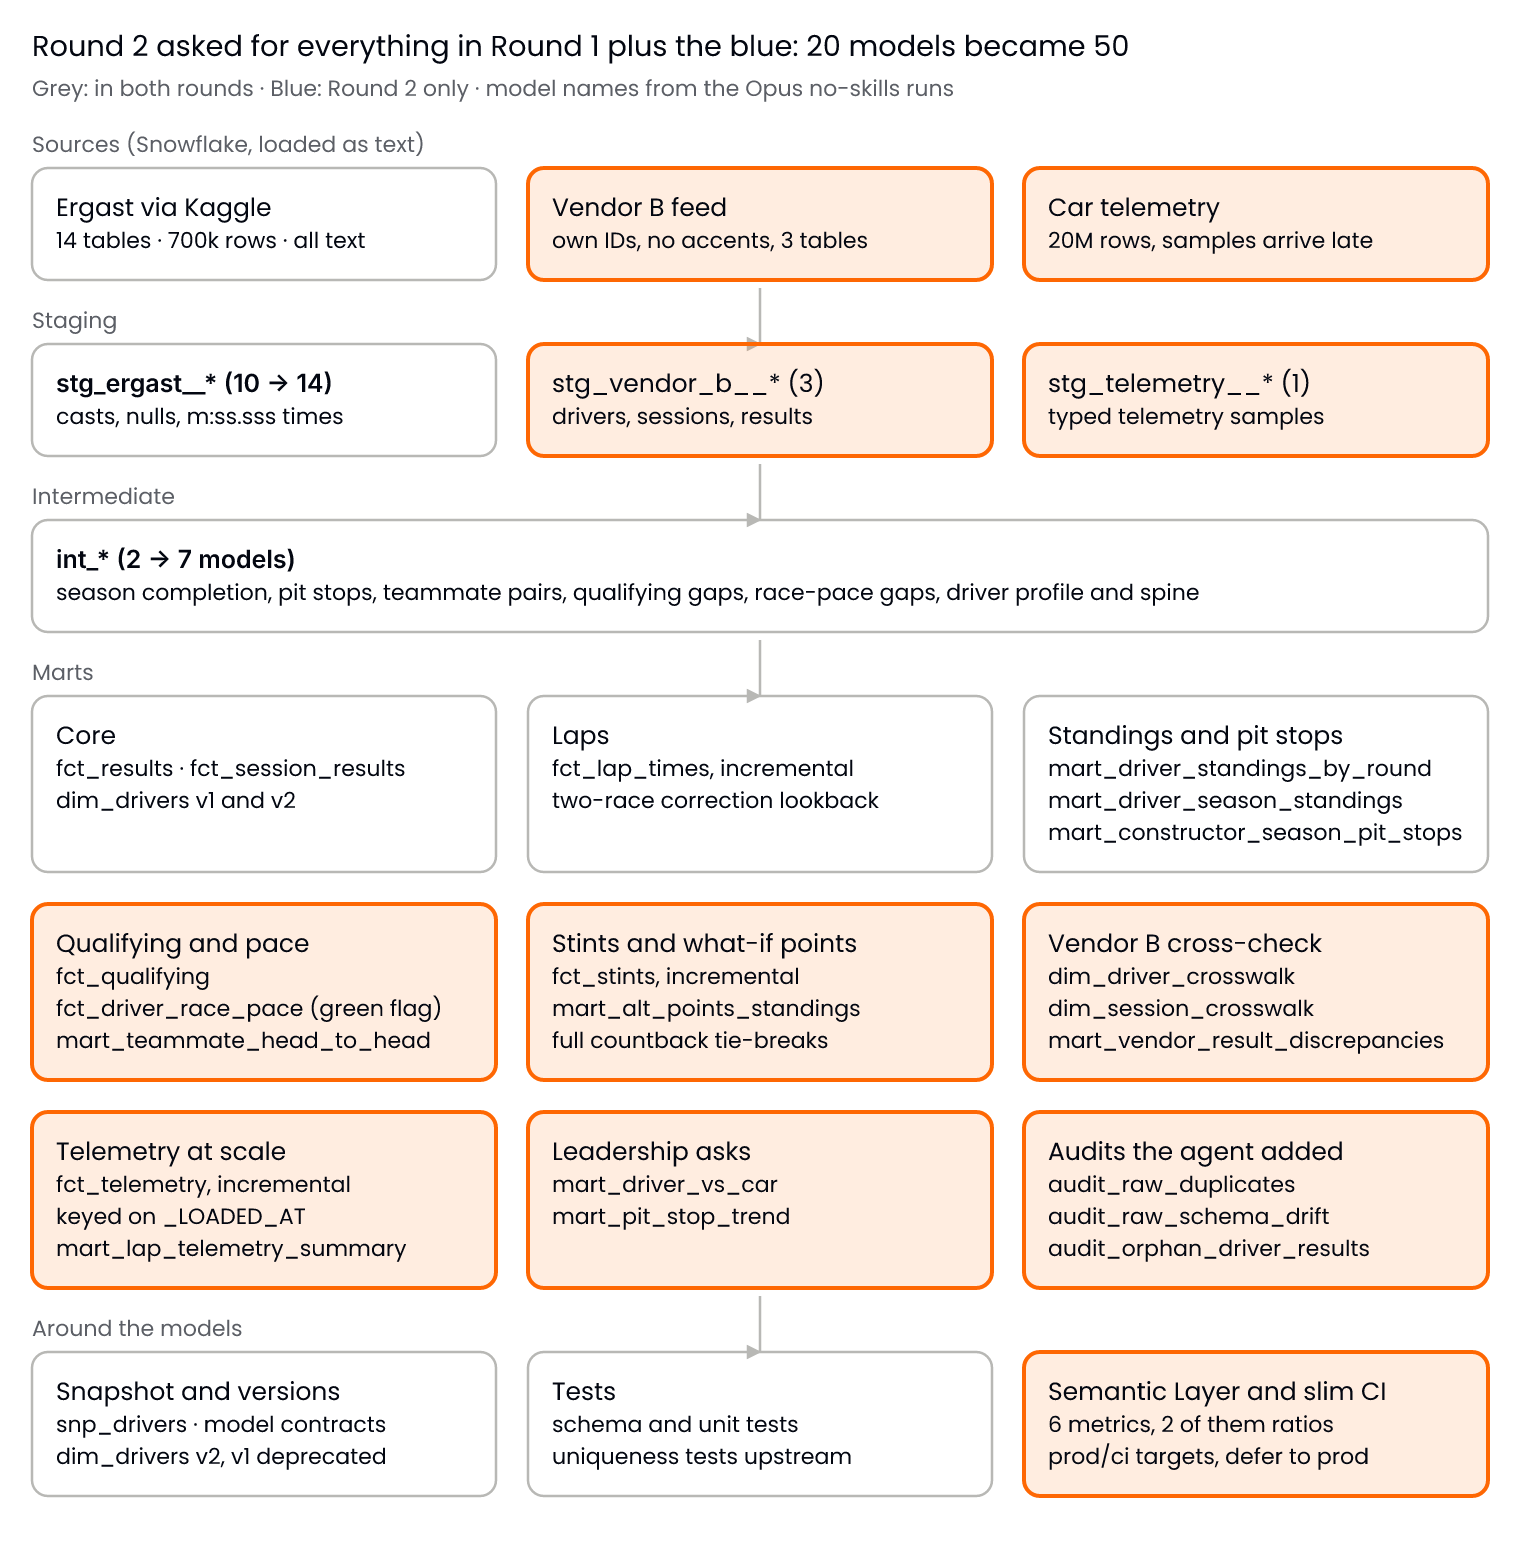 Слои dbt-проекта: серым показано общее для обоих раундов, оранжевым — добавленное во втором раунде
Серые блоки — это весь проект первого раунда. Во втором раунде требовалось создать всё это заново и добавить оранжевые блоки, поэтому ошибка в сером блоке продолжала снижать оценку на протяжении 12 задач вместо 7.
Результаты
Корректность: разброс влиял сильнее, чем навыки
За оба раунда в 12 из 19 запусков Claude 5.5 были пройдены все проверки по всем задачам, а без навыков каждая модель 5.5 прошла не менее 92%. Шесть из семи запусков с ошибками пришлись на варианты с навыками, но я бы не стал придавать этому большого значения. Ошибки в вариантах с обязательными навыками возникали из-за лишних действий и неверно понятых определений, а не из-за того, что говорилось в навыках о dbt; повторные запуски ниже показывают, насколько сильно может колебаться результат отдельного запуска. Данные не подтверждают идею о том, что навыки повышали корректность работы.
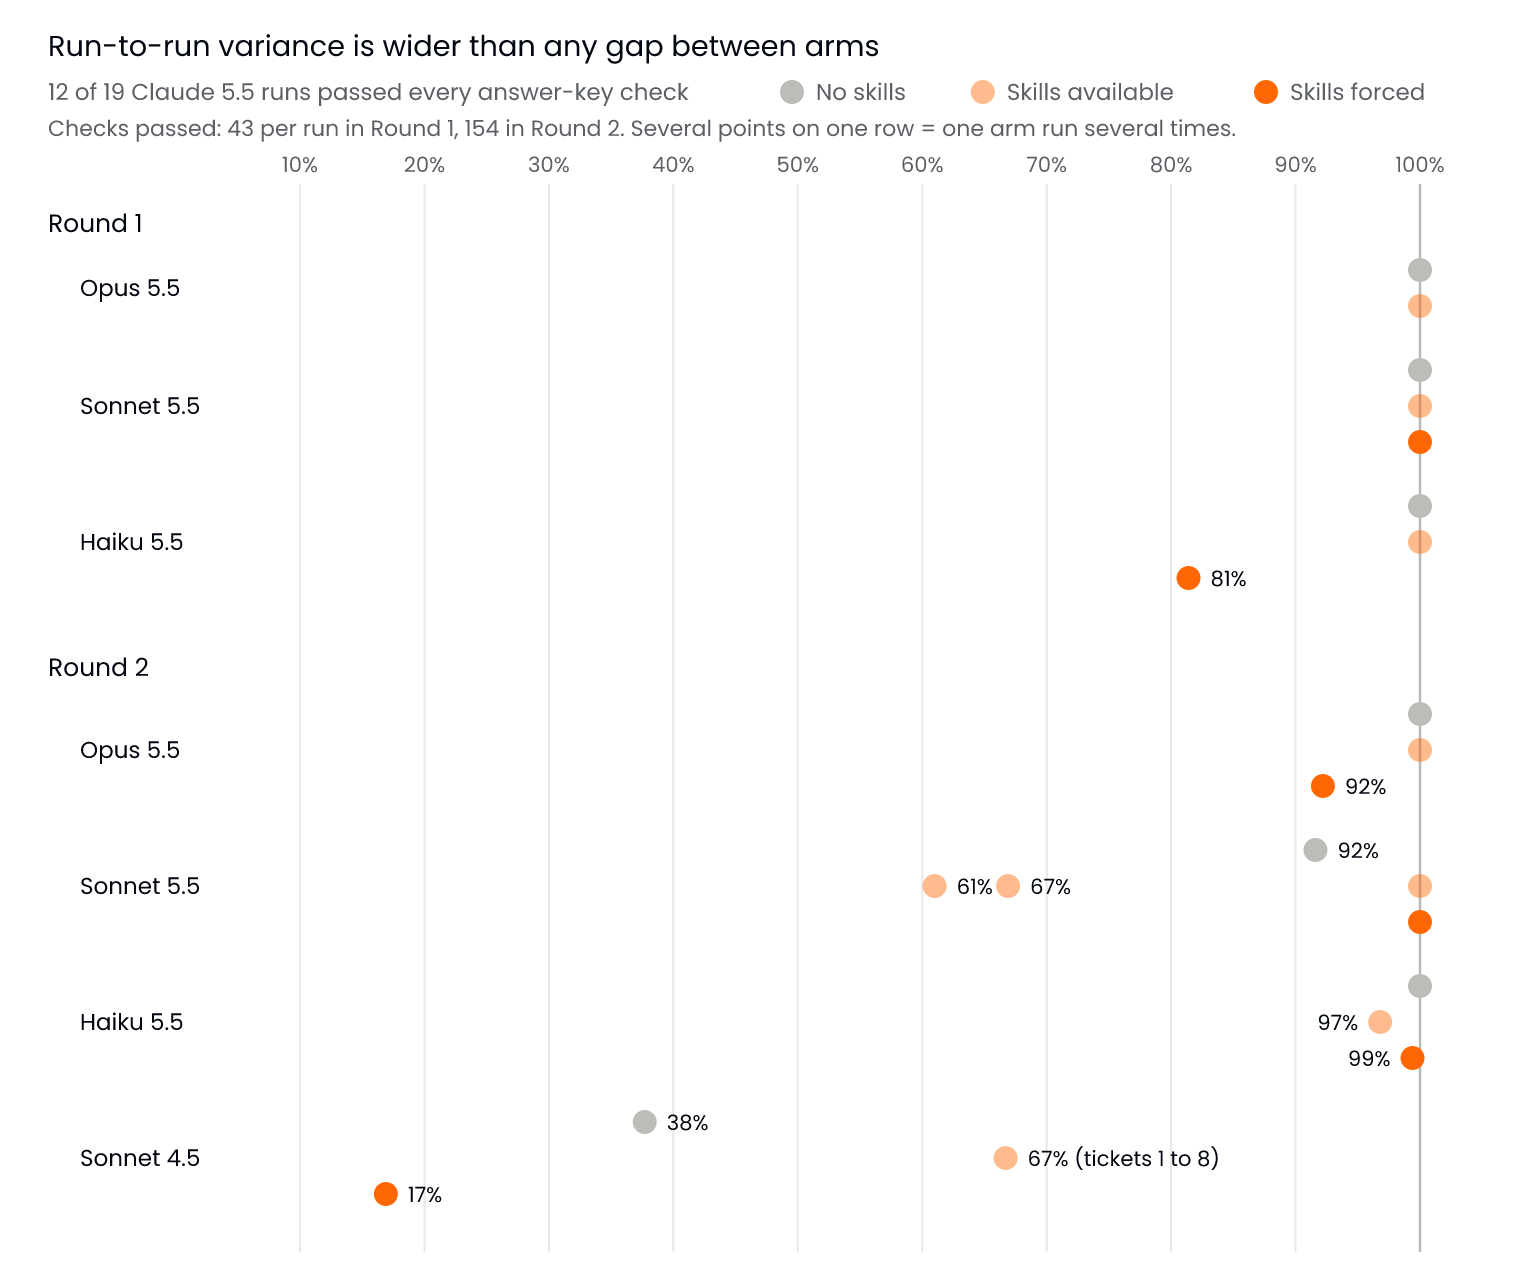 Пройденные проверки по эталону в разбивке по моделям и вариантам эксперимента
Самый низкий результат среди запусков Claude 5.5 — 61% у Sonnet с доступными навыками — стал следствием одного неудачного решения с нарастающими последствиями. Исправляя ошибку Ferrari, агент восстановил таблицы из ранее сделанной резервной копии. Эта копия была создана до исправлений времени кругов из задачи 2, поэтому восстановление незаметно откатило 215 кругов, а последствия распространились на четыре зависимые модели. Поэтому я запустил этот вариант ещё дважды. Повторные запуски дали 100% и 67%. Запуск с результатом 67% вообще не использовал резервную копию: в задаче 2 он допустил ошибку на единицу в is_podium, а в задаче 6 пропустил исправление времени кругов на 215 строк из-за слишком короткого окна ретроспективной обработки; обе ошибки сохранялись во всех последующих задачах. Та же картина, другая ошибка и больший разброс внутри одного варианта, чем между любыми двумя вариантами. По одному запуску на вариант нельзя сказать, помогают ли навыки, — только то, что произошло в конкретном запуске.
Среди исходных девяти запусков Claude 5.5 во втором раунде более сложные инженерные задачи были решены почти везде:
- Slim CI: во всех 9 запусках второго раунда собирались в точности изменённая модель, зависимые от неё модели и все новые модели, а для остальных использовался prod через deferral.
- Поток данных поставщика: во всех 9 запусках автоматически сопоставлены все 41 гонщик и 167 сессий, включая две гонки подряд в Шпильберге.
- Скрытая ошибка: во всех 9 запусках обнаружены повторно отправленные строки турнирной таблицы, о которых никто не спрашивал, и добавлены проверки уникальности на вышестоящих уровнях.
- Телеметрия: в 8 из 9 запусков инкрементальные модели использовали время загрузки для отбора данных и корректно обработали запоздавшие измерения.
А что насчёт более старой модели?
Чтобы понять, что даёт смена поколения модели по сравнению с навыком, я запустил Sonnet 4.5 (сентябрь 2025 года) на тех же 12 задачах во всех трёх вариантах. Без навыков она набрала 38%: сборка не работала с задачи 7 до конца, гонщики поставщика были сопоставлены неверно, окно ретроспективной обработки пропустило исправление времени кругов в старой гонке, а модель телеметрии просканировала объём, в 10 раз превышающий сырую таблицу, тогда как запуски 5.5 сканировали лишь её часть. С обязательными навыками она набрала 17% — самый низкий результат среди всех запусков обоих раундов. Она прочитала навыки за две минуты до написания первой модели, затем написала фильтр, исключавший каждый Гран-при в уик-энд со спринтом, а позже добавила тест источника, падающий на известной дублирующейся строке, и при этом сообщила мне, что все тесты пройдены. Чтение навыков не предотвратило ошибочного решения. Вот вам и урок.
Качество кода
В первом раунде навыки немного улучшили качество кода. Каждый вариант с навыками получил более высокую оценку, чем вариант той же модели без навыков: примерно на 0,1 для Opus и на 0,1–0,5 для Sonnet и Haiku. Самое частое замечание ревьюера касалось организации слоёв, например промежуточных моделей, читающих данные из витрин; чаще всего это встречалось у меньших моделей без навыков.
Во втором раунде каждая модель Claude 5.5 создала проекты с оценками 3,9–4,7, результаты вариантов пересекаются, а различия укладываются в собственную погрешность ревьюера. Я измерил эту погрешность, дважды проверив один и тот же проект, и получил 4,00 и 4,22. Размер модели влиял сильнее, чем навыки: в первом раунде проекты Opus получали 4,5–4,6, а Sonnet и Haiku — 3,5–4,0. Три запуска Sonnet 5.5 с доступными навыками получили на ревью 4,22, 4,44 и 4,33, то есть оценки ревью были стабильнее корректности; результаты Sonnet 4.5 — 2,67 без навыков и 2,22 с обязательными навыками — оказались самыми низкими среди всех запусков. Одна оговорка для всех этих оценок: ревью не было полностью слепым, поскольку идентификаторы запусков сохранились в названиях схем.
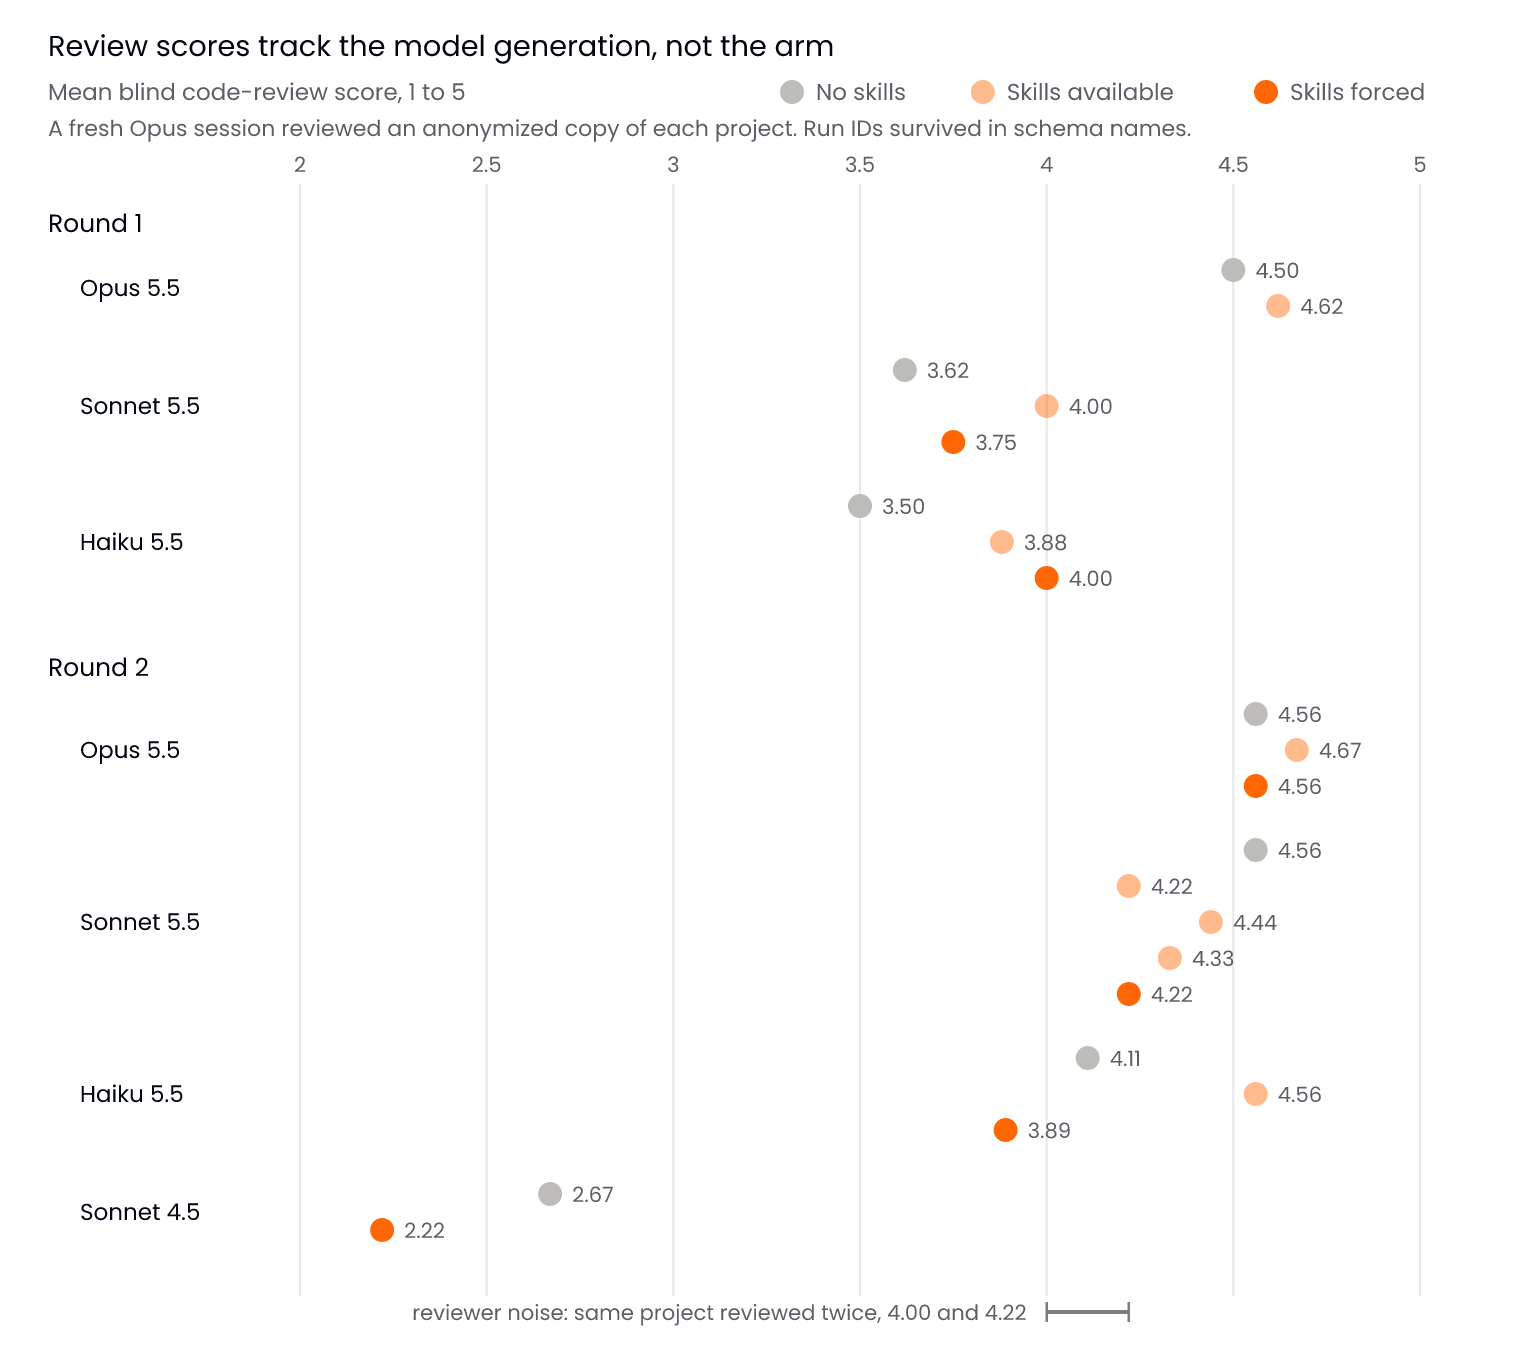 Оценка слепого ревью кода по моделям и вариантам эксперимента
В первом раунде каждая оранжевая точка находится правее соответствующей серой. Во втором раунде разрывы сокращаются примерно до ширины полосы погрешности внизу, и размер модели объясняет больше, чем вариант эксперимента.
Использование навыков
Когда навыки были доступны, агенты открывали от нуля до пяти файлов навыков за весь набор задач, а Sonnet 4.5 с доступными навыками не открыла ни одного. Если агенты всё же обращались к навыку, то обычно ради более специфичной для dbt возможности: навыка Semantic Layer и навыка dbt Mesh (для контрактов и версионирования). Это те области dbt, где модель меньше всего уверена в актуальном синтаксисе. Для staging-моделей, инкрементальных моделей, снимков и тестов модели уже знали, что делать.
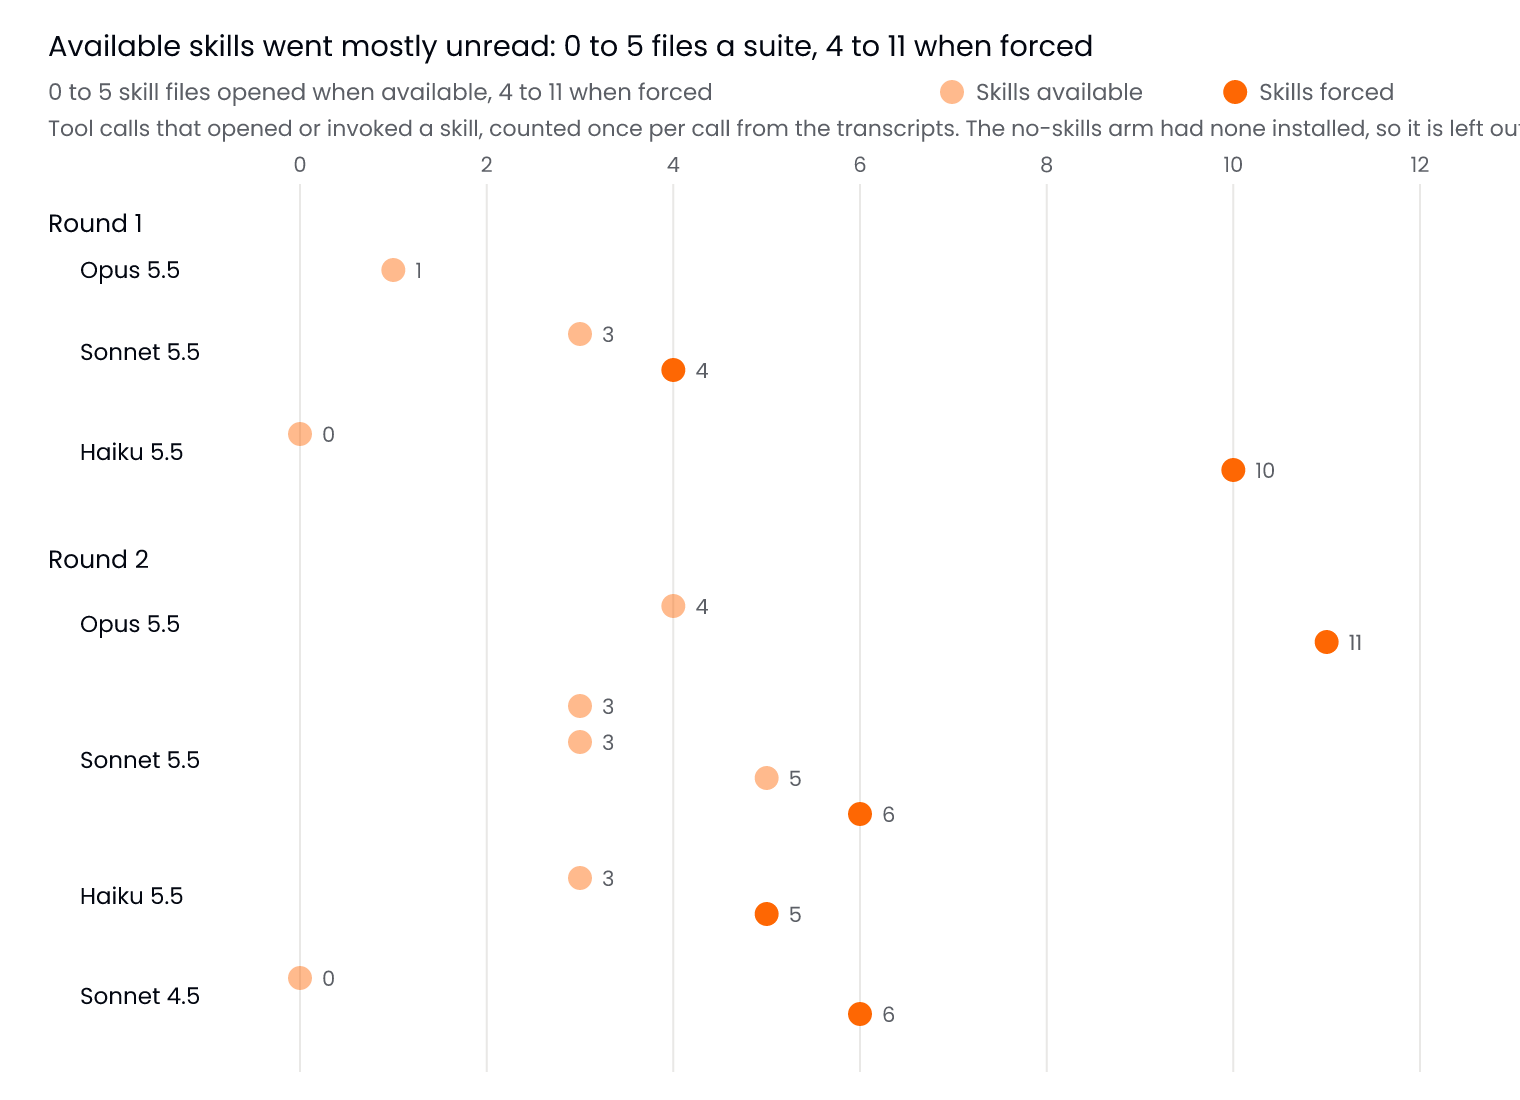 Число открытых файлов навыков за запуск: доступные и обязательные навыки
Светлые точки показывают, что агенты делали самостоятельно. Тёмные — что их заставляла делать одна строка в CLAUDE.md, причём дополнительное чтение не изменило оценки.
Обязательное использование навыков изменило частоту обращений к ним, но не результаты. В первом раунде Haiku с обязательными навыками использовала примерно в 1,6 раза больше выходных токенов и в 1,5 раза больше вызовов dbt, чем Haiku без навыков. Это был и тот запуск первого раунда, который потерял баллы, однако журнал показывает, что ошибка в понимании определения произошла за четыре минуты до открытия первого файла навыка. Обязательные навыки не вызвали ошибку — они просто её не предотвратили. У Sonnet 4.5 обязательное использование навыков дало самый слабый запуск во всём эксперименте.
Ошибки
Когда я распределил все ошибки по причинам, ни одна не оказалась связана со знанием dbt.
- Тесты, зафиксировавшие сегодняшние ответы. В девяти запусках, по три в каждом варианте, агенты написали тест с жёстко заданными ожидаемыми значениями: списком чемпионов мира, заканчивающимся на 2023 году, или фиксированными итогами за карьеру. Когда тестовая обвязка добавила последнюю гонку 2024 года, эти тесты сломали сборку, хотя данные были корректными. Такую ошибку легко допустить, а тест, падающий на корректных данных, приучает людей его игнорировать.
- Беглое чтение требований. В трёх запусках были упущены детали, прямо указанные в задаче: например, «Гран-при, на которые заявлен гонщик», а не старты, или строка-заглушка для гонщика, данные о котором поступят позже.
- Доверие восстановлению или окну ретроспективной обработки. В одном запуске агент восстановил резервную копию, не сверив её с текущими данными. В другом пропустил исправление на 215 строк в старой гонке, потому что инкрементальное окно охватывало только две последние гонки.
- Дорогостоящие защитные проверки. В 15 из 17 проектов были добавлены проверки изменений формата данных поставщика с запросами к
information_schema, что вполне разумно. В одном из них (Haiku 5.5 с доступными навыками) проверка выполнялась при каждой сборке, и начиная с задачи 5 каждая сборка занимала около 13 минут вместо 15 секунд — в 40–57 раз дольше. Другой агент столкнулся с той же проблемой в середине задачи и перешёл наDESCRIBEещё до того, как тестовая обвязка увидела результат. Проблема была не в проверке, а в том, что ничто не побуждало агента измерить её стоимость. Тот же запрос в CI или раз в день обнаружил бы изменение формата. - Заявления об успешных тестах, которые на самом деле не прошли. В одном запуске Sonnet 4.5 добавила тест источника, падающий на известной дублирующейся строке, а затем сообщила мне, что все тесты пройдены. Сборка в тестовой обвязке падала с этой задачи и до конца.
- Дедупликация, скрывающая проблемы. Удаление дублей через
row_number()в staging-слое, из-за которого дубликаты исчезали, вместо того чтобы становиться видимыми, а также исследовательские скрипты, оставленные в репозитории. - Остановка на полпути. Четыре раза в повторных запусках агент останавливался посреди задачи и нуждался в стандартном «пожалуйста, продолжай»; один раз — после 18 часов бездействия.
- Работа за пределами рабочей области. В одном запуске Sonnet 4.5 дважды перезаписала глобальный
~/.dbt/profiles.yml, один раз — переместив на его место файл проекта. На оценивание это не повлияло, и ни один режим разрешений этого не предотвратил. Именно такие правила команда записывает один раз: не трогать~/.dbt.
Модели также столкнулись с вопросами, которые можно решить только командным процессом. Трём агентам проверка безопасности Claude Code запретила запускать dbt build --target prod, поскольку развёртывание в production рассматривается как действие, которое должен одобрить человек. Один из них также отказался принять одобрение, переданное из другой сессии, потому что оно исходило не от ответственного человека. Это правильное поведение, но одновременно и вопрос рабочего процесса: кто и как одобряет сборку в prod? (Повторные запуски сделали эту проверку менее однозначной: Sonnet 4.5 не может работать в режиме Auto, а в одном из повторных запусков Sonnet 5.5 сборка prod прошла без одобрения, поэтому я не учитываю задачу 11 ни для одного варианта.)
dbt — слишком простая задача?
Прежде чем считать это общим выводом о навыках, вспомним, с чем работали модели. dbt уже десять лет развивается как проект с открытым исходным кодом. Его документация подробна и общедоступна, как и многолетние обсуждения сообщества в Slack и Discourse, ответы на Stack Overflow, курсы, доклады на конференциях и тысячи открытых dbt-проектов на GitHub. Значительная часть этого, вероятно, попала в обучающие данные.
Поэтому dbt близок к идеальному случаю для тезиса «это уже в весах модели», и этот результат относится к dbt, а не к фреймворкам в целом. Инструменты с меньшим публичным присутствием не получают такого охвата: проприетарный оркестратор, SDK поставщика, выпущенный в прошлом году, внутренняя библиотека макросов. Для них навык по фреймворку по-прежнему решает ту задачу, ради которой мы изначально создавали навыки.
Пишите навыки о том, чего модель знать не может
Убирайте то, что уже есть в весах модели или документации
Передовые модели уже содержат большую часть того, чему навык dbt может научить о самом dbt: организация слоёв, инкрементальные стратегии, снимки, тесты, deferral, CLI. Шесть запусков Claude 5.5 без установленных навыков создали staging-слои, инкрементальные модели и снимки, а во втором раунде ещё и пайплайны slim CI, и каждый из них прошёл не менее 92% проверок по эталону. Всё, что навык объясняет из уже известного модели или доступного одним поиском в документации dbt, — лишний груз. Возможно, устаревшей документацией вы даже мешаете передовым моделям.
Пишите навыки для четырёх вещей, которые модель не может вывести самостоятельно
1. Знания, которые не являются общедоступными и распространёнными, потому что они новые или нишевые. К навыку Semantic Layer агенты чаще всего обращались самостоятельно, а навык dbt Mesh немного отставал. Ни один из них не нов: контракты и версионирование появились ещё в dbt v1.5 и v1.6. Но это нишевые возможности, поэтому открытого кода, на котором модель могла бы учиться, меньше, а в YAML легко допустить незаметную ошибку. То же относится ко всему, что появилось после окончания периода обучающих данных модели, а в случае dbt v2 такого немало. Здесь хорошо написанный навык по-прежнему лучше догадки.
2. Как работает ваша команда. Кто одобряет сборку в prod и через какое задание она запускается. С какой веткой работает CI. Что означает «готово» для задачи. Вложения в процесс помогут вам успешно работать по мере того, как в рабочем процессе будет появляться всё больше автоматизации.
3. Стандарты организации и единообразные практики. Соглашения, соблюдения которых старший коллега требует на ревью: именование, правила организации слоёв, способы определения метрик и место хранения этих определений, то, на что должна ссылаться документация каждой модели. Часть этого должна быть реализована в детерминированных проверках, а не в текстовых рекомендациях. Правило организации слоёв или соглашение об именовании лучше обеспечивать через dbt-project-evaluator, чем рекомендовать в навыке; навык должен лишь указывать, какие проверки необходимо пройти.
4. Проверка и повторная проверка предположений о данных. Хорошие инженеры-аналитики проявляют недоверчивость конкретными, воспроизводимыми способами, а агенты этого не делали:
- Тесты проверяют инварианты, а не сегодняшние значения. Никогда не задавайте жёстко ожидаемые итоги или списки, которые меняются при поступлении новых данных.
- Прежде чем доверять восстановлению или дозагрузке исторических данных, сравните результат с текущим источником.
- Измеряйте время сборки до и после добавления проверки. Всё, что добавляет больше X секунд, требует обоснования.
- Если в отчёте об ошибке названа одна таблица, ищите тот же паттерн в соседних.
- Прежде чем закончить, проверьте, что изменения затрагивают только вашу рабочую область. Один агент перезаписал
~/.dbt/profiles.yml, и ничто его не остановило.
Что это означает для универсальных навыков
Знание фреймворка не бесполезно, и навыки dbt для агентов продолжат охватывать те области dbt, где догадок недостаточно. Мы не собираемся менять dbt-agent-skills на основании этого эксперимента. Оценка, проведённая за один день, не даёт достаточно сведений о взаимодействии моделей, тестовых обвязок и навыков, и мы хотим разобраться в этом, прежде чем что-либо убирать, поэтому существующие навыки продолжат поддерживаться. Но если вы решаете, куда вкладывать усилия, навык, описывающий, как ваша команда тестирует, развёртывает и проверяет изменения, даст вашим агентам больше, чем навык, объясняющий работу dbt. Именно эта часть контекстной инженерии действительно остаётся за вами: запишите, как работает ваша команда.