dbt v2.0 выходит в общедоступный релиз
После 18 месяцев разработки, обратной разработки, разбора и повторной сборки движок dbt Fusion вышел в общедоступный релиз под новым именем: dbt. (Подробнее об этом читайте здесь). Эта полностью переписанная версия dbt решает ряд давних проблем реализации dbt v1 и закладывает основу для следующего десятилетия развития. Раньше:
- dbt не понимал SQL, который генерировал, поэтому не мог предупреждать о некорректном коде без его выполнения и расходования вычислительных ресурсов.
- В крупных проектах разбор проекта в dbt мог занимать до 20 минут, прежде чем можно было приступить к выполнению.
- Артефакты dbt затрудняли взаимодействие между инструментами: единственным способом передачи данных из одного продукта в другой были огромные JSON-файлы.
- Многие команды не могли пользоваться dbt docs из-за проблем с масштабированием и производительностью.
Новый dbt v2:
- Глубоко понимает SQL и позволяет обнаруживать ошибки в коде до его отправки в хранилище, экономя время и деньги разработчиков и обеспечивая агентам циклы работы с проверяемыми результатами.
- Создан с упором на скорость во всех аспектах благодаря переходу на оптимизированный исполняемый файл на Rust и использованию современных технологий, таких как ADBC. Мы видели проекты, разбор которых раньше занимал 20 минут, а теперь завершается менее чем за минуту. Проекты более типичного размера тоже получат значительное ускорение в повседневной работе (например, компиляция станет быстрее в 2 раза или более).
- Представляет dbt Information Schema, которая описывает весь проект в виде стандартных файлов Parquet. Это позволяет уменьшить размер файлов более чем в 10 раз, при этом предоставляя более полные данные, и обеспечивает быстрое выполнение запросов через
dbt show --info, внешние инструменты, такие как DuckDB, и совершенно новую функцию checks. - Включает совершенно новую версию dbt docs, которая гораздо лучше масштабируется.
Главные новые возможности
Находите свои ошибки (и ошибки ваших агентов) быстрее
Благодаря агентным инструментам программирования код генерируется быстрее, чем когда-либо. Несмотря на совершенствование передовых моделей, я по-прежнему вижу, как агенты пишут SQL, который, по их представлениям, должен работать, вместо того чтобы с самого начала опираться на реальные условия. В отличие от таких языков, как TypeScript или Rust, где компилятор обнаруживает ошибки сразу после написания кода, единственный способ найти ошибку в SQL — выполнить его в хранилище и посмотреть, сработает ли он.
Или, по крайней мере, это раньше было единственным способом найти ошибку. dbt v2 впервые добавляет локальный компилятор для SQL. По сути, это способ снизить ущерб: если уж вы собираетесь выдумать имя столбца, то хотя бы узнать о своей ошибке вы должны бесплатно.
dbt заблаговременно находит такие ошибки, эмулируя поведение вашей конкретной базы данных. Он учитывает все источники, UDF, seeds и специфичные для поставщика функции, из которых состоит ваш проект, и проверяет, что произошло бы при выполнении модели.
В частности, dbt строит логический план (точно такой же, какой ваша база данных подготавливает перед выполнением запроса): если построить логический план не удаётся, значит, с запросом что-то не так. Если вы ещё не знакомы с основами понимания SQL, лежащими в его основе технологиями или тем, какие возможности для пользователей открывает анализ логического плана, прочитайте прошлогодние статьи по этим ссылкам.
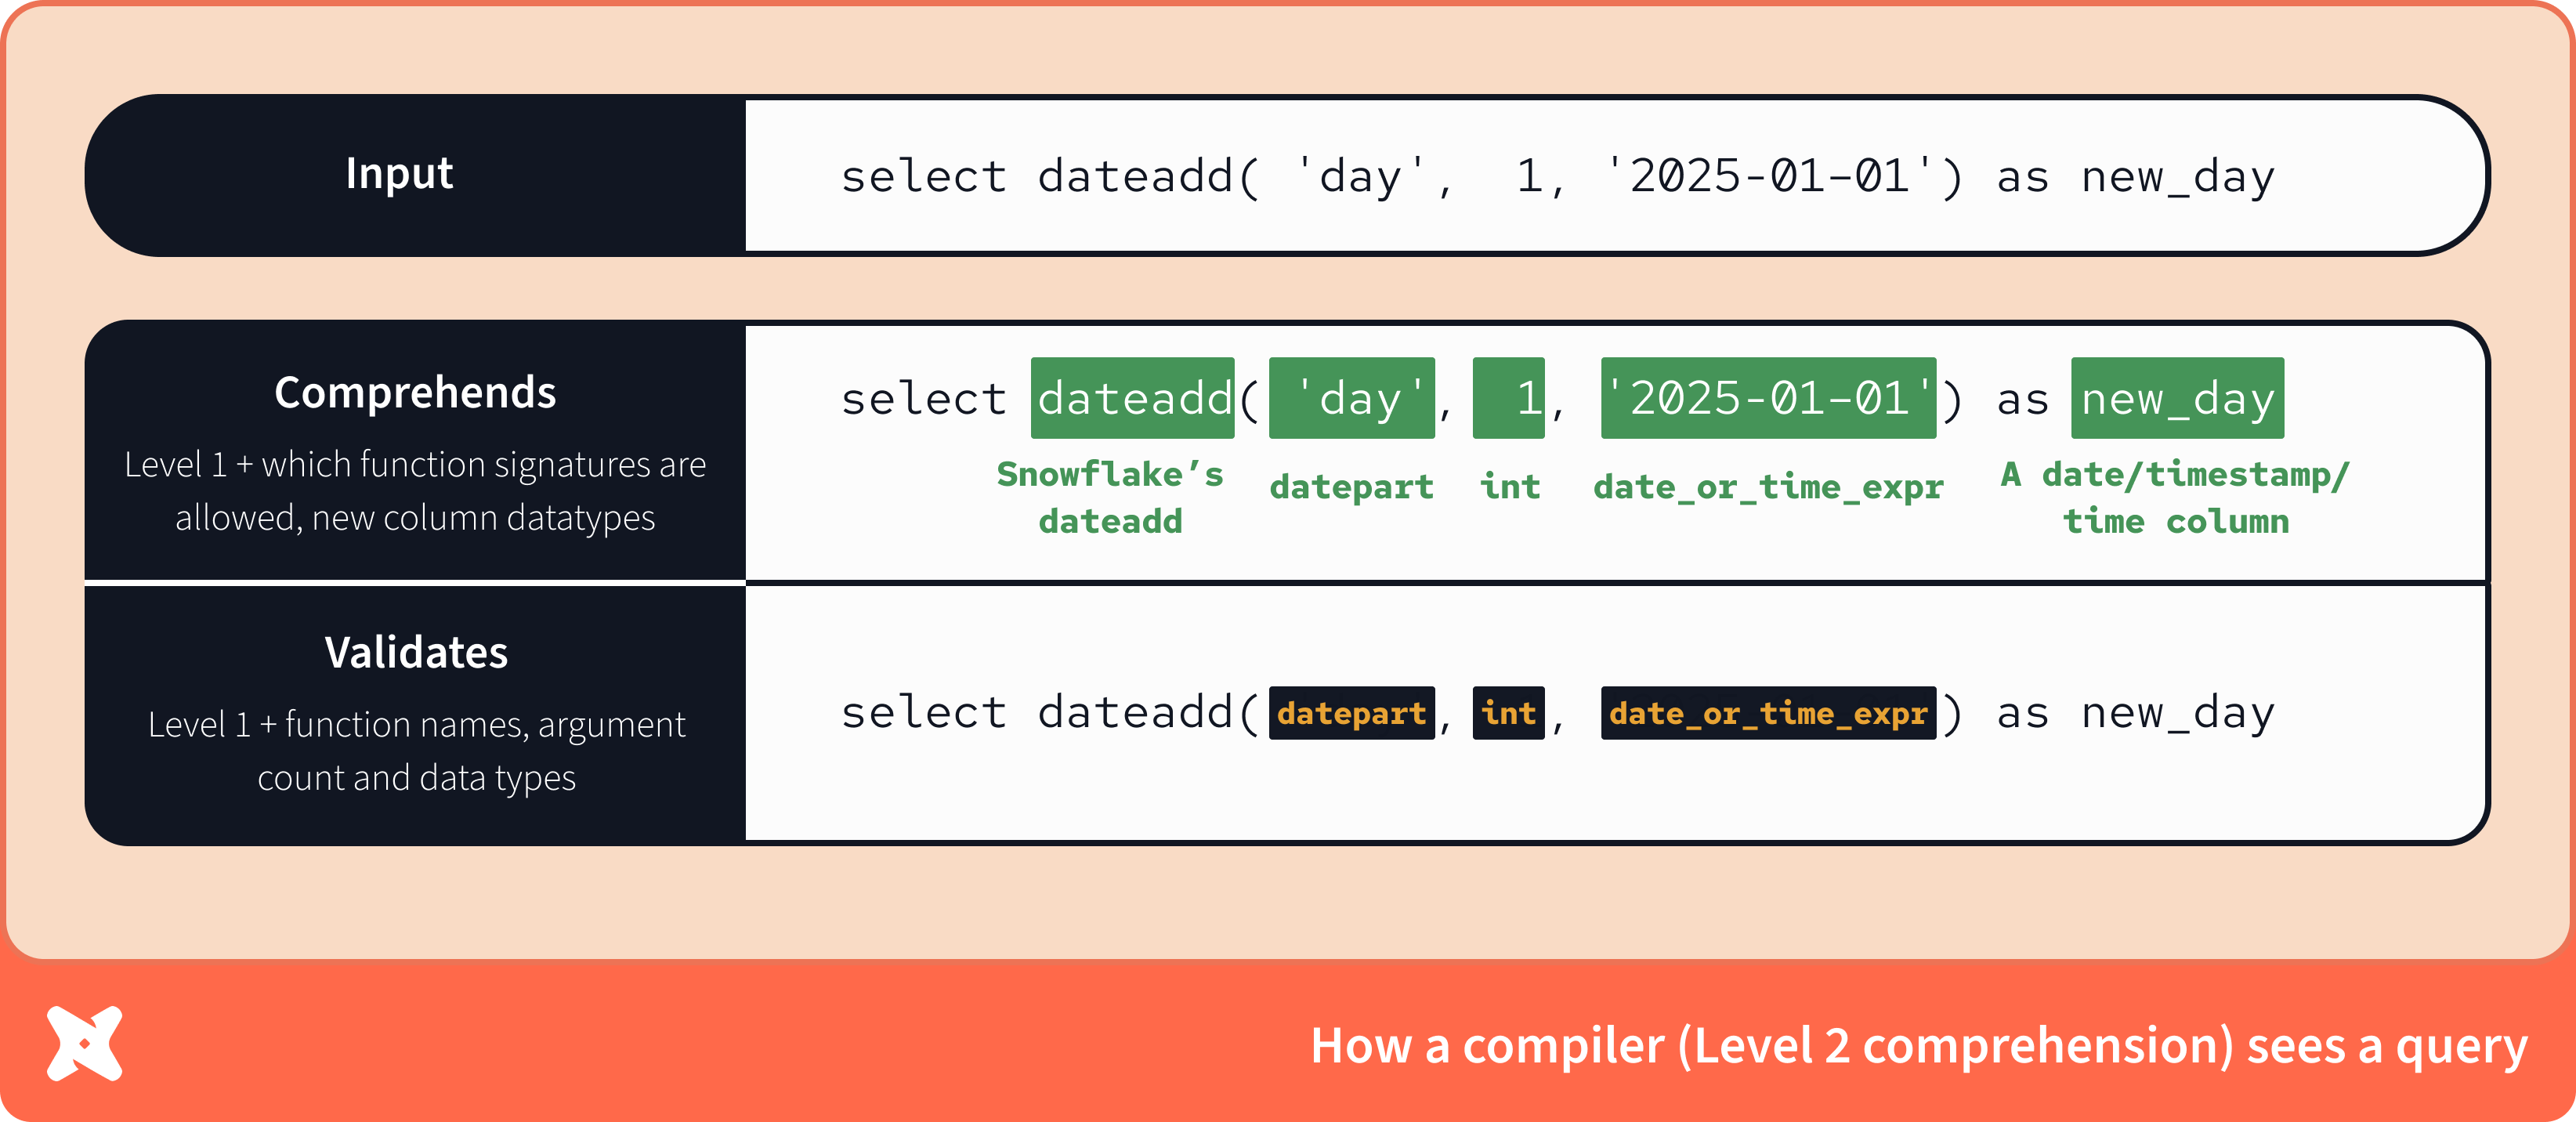 Как компилятор (уровень понимания 2) видит запрос
В некоторых отношениях статический анализ dbt даже превосходит встроенные средства самого хранилища. В каждый момент времени хранилище может оценивать только один переданный ему запрос; dbt же знает, что, хотя после удаления столбца сам запрос останется корректным, при развёртывании это сломает 4 зависимые модели ниже по цепочке.
Если вы переходите с большого существующего проекта dbt, режим baseline (включённый по умолчанию) позволяет легко начать пользоваться этими возможностями статического анализа. Перейдите на статический анализ в режиме strict, чтобы получить максимум возможностей и наиболее строгие гарантии качества.
Скорость
Для команд с крупными, глубоко настроенными проектами dbt медленный разбор проекта может серьёзно мешать погружению в работу. dbt v2 предлагает несколько новых способов повысить производительность:
- Он быстрее сам по себе благодаря реализации на Rust. Мой тестовый проект с 10 тысячами узлов компилируется за 70 секунд в dbt 1.12.0 и всего за 17 секунд в dbt v2.
- Одна из самых медленных частей запуска dbt — запись JSON в конце задания. Добавьте
--no-write-jsonк своим командам (или используйте переменную окруженияDBT_ENGINE_WRITE_JSON=0) и перейдите на файлы Parquet (--write-index), чтобы получать более полные данные в файлах меньшего размера. - Искать причины проблем с производительностью стало проще благодаря журналам OTel (агенты для программирования их про-о-осто обожают). Например, мы сократили время избыточной компиляции моделей в нашем внутреннем аналитическом проекте на 3 минуты, убрав из некоторых моделей чрезмерную интроспекцию.
Конечно, самое быстрое выполнение — то, которого удалось избежать, и здесь на помощь приходит dbt State. Он отслеживает, существует ли уже выполняемая модель в целевой схеме (тогда её можно пропустить) или в другой схеме (тогда её можно клонировать вместо повторного выполнения с нуля). dbt v2 полностью интегрирован с dbt State — активируйте бесплатный пробный период командой dbt build --manage-state.
Основа, готовая к масштабированию в эпоху агентов
Любой инструмент отражает контекст, в котором он развивался. Изначально dbt был небольшим проектом, созданным подручными средствами, а его основа (Python, Jinja, JSON и интуиция) отлично подходила для внутреннего инструмента консалтинговой компании, которая стремилась упростить свою работу. Создавая новую версию dbt, мы знали, что её будут использовать для Серьёзной Работы с Данными в Значительных Масштабах. Поэтому мы сделали другой, более ориентированный на будущее выбор:
- ADBC и экосистема Arrow — современный способ подключения к базам данных и передачи данных.
- Файлы Parquet позволяют представить ту же информацию, что и manifest.json, занимая лишь малую долю его размера, и дают возможность читать часть файла вместо разбора его целиком.
- Rust менее снисходителен, чем Python с его вольным подходом к типам, но взамен вы получаете феноменальную производительность и ошибки компилятора, которые помогают не допускать ошибок в самом dbt.
- И главное — принципиально важно встроить SQL-компилятор в самое ядро dbt. Он даёт новые фундаментальные возможности, которые мы уже используем интересными способами (отслеживание происхождения данных на уровне столбцов, строгий статический анализ и проверка функций с учётом типов), и которые сможем применять для других функций в будущем.
Выполняйте запросы к самому проекту
Выше я упомянул, что мы делаем ставку на формат файлов Parquet. Он используется внутри системы для обеспечения строгого статического анализа, но гораздо более важная новость в том, что мы также представляем новый интерфейс с формально определённым контрактом для доступа к метаданным вашего проекта dbt — dbt Information Schema, которая сама представляет собой набор файлов Parquet.
Когда у вас есть информация о проекте dbt и возможность выполнять к ней запросы, вы оказываетесь в родной стихии аналитической инженерии. Подключайтесь через DuckDB, используйте dbt show --info или совершенно новую встроенную функцию checks — и вы сможете реализовать всё, что только придёт в голову:
- Выявлять модели с неиспользуемыми столбцами или модели слоёв staging/intermediate, которые нигде не используются на последующих слоях
- Находить модели с наименьшим покрытием тестами
- Контролировать соблюдение соглашений об именовании, владельцах и материализациях с помощью кода
- Позволять агенту мгновенно получать сведения о происхождении данных модели, истории выполнения или области влияния предлагаемого изменения
Современный интерфейс dbt docs
Изначально dbt docs был классным, затем устарел, а теперь (почти) прошёл полный круг и стал винтажным. Мне нравится представлять, что где-то есть группа людей, которые собираются субботним утром, чтобы похвастаться своими заботливо поддерживаемыми index.html или доведёнными до совершенства файлами catalog.json.
Но для всех остальных у нас есть новый сайт документации, построенный на dbt Information Schema, который масштабируется до проектов сколь угодно большого размера и запускается так же, как раньше: dbt docs generate && dbt docs serve.
Мы встроили WASM-версию DuckDB, чтобы по запросу извлекать нужные фрагменты метаданных проекта из артефактов Parquet. Именно это обеспечивает высокую производительность, а заодно позволяет развёртывать документацию как статический сайт (точно так же, как старую версию dbt docs).
Инструкции по установке
Официально, если вы переходите с dbt v1, мне следует рекомендовать вам установку через pip. Её легко встроить в существующий рабочий процесс (вместо pip install dbt-<adapter> просто выполните pip install dbt). Это хороший вариант, если наряду с dbt вы используете несколько других инструментов для работы с данными на Python и хотите держать всё в изолированной среде. Новый исполняемый файл dbt будет надёжно размещён внутри вашего виртуального окружения. Вот документация по этому способу установки.
Но новый dbt на самом деле не является проектом на Python! Нам больше не нужно возиться с виртуальными окружениями! Поэтому лично я рекомендую по возможности использовать менеджер пакетов (brew, winget) или установку через curl. На это есть две веские причины:
- dbt всегда будет доступен из командной строки без предварительной активации виртуального окружения. Это упрощает интеграцию с другими инструментами, которым нужен dbt, например с расширением VS Code или выбранным вами ИИ-агентом.
- Обновления становятся независимыми от других инструментов: просто выполните
dbt system update, и вы автоматически получите последние улучшения (только при установке через curl).
Что дальше ждёт dbt?
Несколько лет назад мы думали, что dbt приближается к функциональной завершённости. С тех пор две большие «AI» встряхнули экосистему данных:
- Artificial Intelligence (искусственный интеллект) повысил спрос на надёжные данные, понятные машинам.
- Apache Iceberg позволил командам по работе с данными контролировать своё будущее в большей степени, чем когда-либо прежде.
Учитывая оба этих направления, мы создаём и продвигаем открытую инфраструктуру данных — Open Data Infrastructure. Обязательно посмотрите сегодняшний основной доклад dbt Summit и завтрашний основной доклад сообщества, чтобы узнать, что это значит для вас. Появляются новые интересные задачи, и специалисты по dbt исключительно хорошо подготовлены к их решению (вы когда-нибудь замечали, что у контекстной инженерии и аналитической инженерии очень много общего?)
dbt продолжит расти и развиваться, а вы можете влиять на это развитие теми же способами, что и прежде: создавая issues, обсуждения или pull requests на GitHub и делясь полученными знаниями с остальным сообществом.