dbt_context_engineering: моделирование контекста, который читают ваши ИИ-агенты
Сейчас каждая компания пытается применить ИИ к собственным данным, и большинство сталкивается с одной и той же проблемой: самое сложное — не модель. Качество ответа агента всегда ограничено качеством стоящего за ним контекста, а в большинстве организаций этот контекст никогда не моделировали для машинного чтения.
Традиционно перед нашим сообществом ставили задачу создавать аналитические системы, с помощью которых команды могли бы оценивать измеримые результаты своей работы, и эта работа уже приносит пользу ИИ: сегодня агент может получить управляемую, протестированную метрику через семантический слой. Но причины, стоящие за цифрами, скрыты в расшифровках звонков, обсуждениях с поддержкой и договорах, до которых аналитические инструменты раньше не могли добраться. У подготовки этих данных к тому, чтобы ИИ мог их находить, доверять им и ссылаться на них, есть название: инженерия контекста. Мы считаем, что сообщество dbt обладает уникальными возможностями, чтобы возглавить развитие этой практики.
В основе этого убеждения — наблюдение: инженерия контекста не новая дисциплина, которую нужно осваивать с нуля. Это аналитическая инженерия, ориентированная на нового потребителя. Практики, которые сделали ваши метрики надежными (контроль версий, тестирование, документирование, отслеживание происхождения данных), — именно то, чего сегодня не хватает контексту для ИИ. Поэтому мы выпускаем dbt_context_engineering — пакет с открытым исходным кодом, который переносит первый набор паттернов инженерии контекста в уже знакомый вам фреймворк. В этой статье мы расскажем, что входит в пакет, какие возможности он открывает и почему остальные подходы мы хотим вырабатывать вместе с сообществом.
Почему dbt и почему сейчас?
Если вы уже создавали слой метрик или золотой слой на своей платформе данных, у вас уже есть многие навыки, необходимые для инженерии контекста. Достаточно направить те же навыки преобразования, отбора и обогащения данных на новую цель: неструктурированный текст, который читает ИИ-агент.
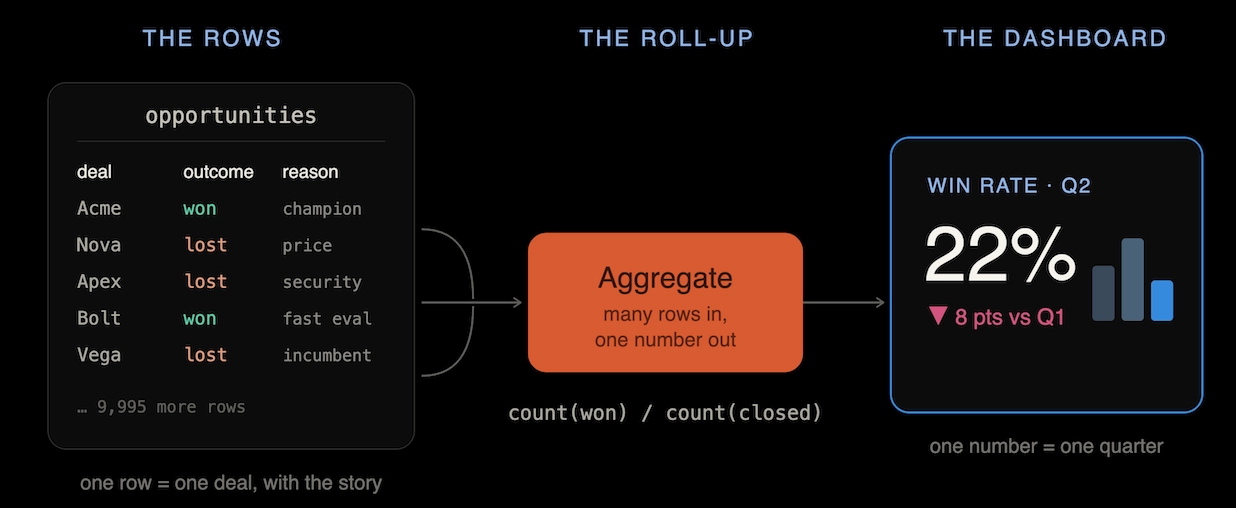
Давайте рассмотрим слой метрик и то, что он дает уже сегодня:
- Все согласны с тем, что означает показатель и как его определять
- Команда по работе с данными моделирует его, тестирует, а затем развертывает, чтобы он стал доступен всем
- Когда кто-то спрашивает об этом показателе (например, «выручка за прошлый квартал»), он всегда получает тот же ответ, что и следующий человек с таким же вопросом. Оба получают единый, управляемый и надежный ответ
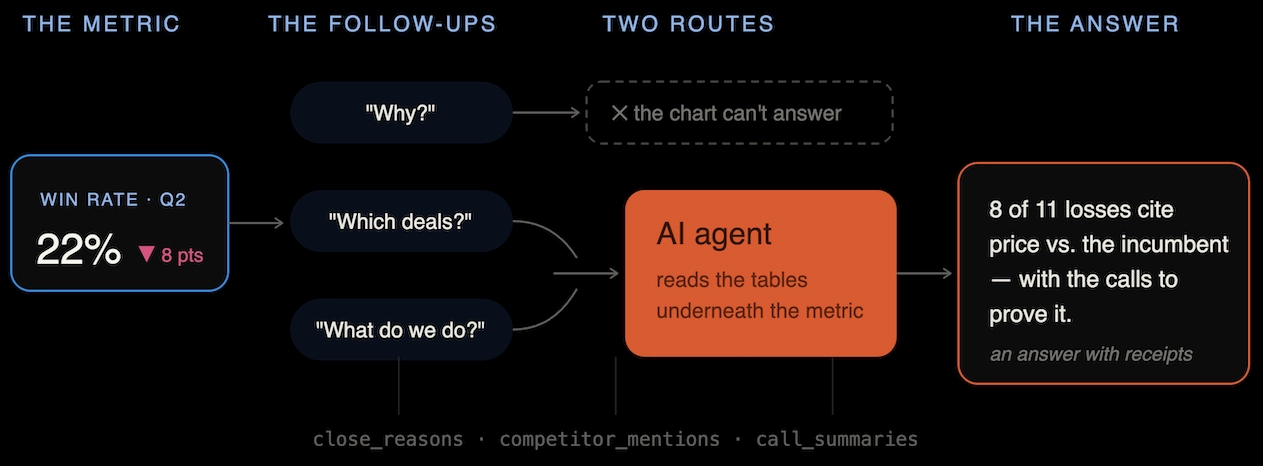
Мы можем спросить, например, почему упала выручка, и LLM попытается собрать ответ из любых других доступных ей источников вне хранилища данных, но управляемого слоя, который предоставлял бы эту информацию агенту, нет. Нужный ему контекст разбросан по всей организации: расшифровки звонков, обсуждения с поддержкой, договоры, диспетчерские заметки и многое другое.
Эти неструктурированные данные в виде свободного текста существуют давно, но в повседневной работе с данными использовались мало. Причина в том, что аналитические инструменты рассчитаны на детерминированные результаты — именно это и упрощает управление метриками. Чтобы понять, вызвано ли падение выручки системной проблемой в воронке продаж, серьезной ошибкой или отсутствующей функцией, аналитическая команда сегодня могла бы начать с показателей закрытия обращений, их статусов и категорий. Но возможности такого подхода ограничены. Чтобы определить, какие именно причины влияют на результат, нужны творческое мышление и зачастую трудоемкий качественный анализ, а аналитические функции вроде sum и count сами по себе с этим не справляются. Поэтому аналитики в итоге используют такие измерения, как статус обращения, метки и категории, или ненадежные регулярные выражения для поиска по перепискам.
ИИ на платформе данных меняет ситуацию. Теперь у нас под рукой есть не вполне детерминированные, но не менее ценные функции, которые могут анализировать переписку, связанную с обращением (или группой похожих обращений), и помогать выяснить, что на самом деле влияет на показатель. Это и есть инженерия контекста — практика моделирования данных, которые читают ИИ-агенты.
Что вообще считать надежным ответом?
Если результат работы ИИ не детерминирован, то есть он не возвращает одну и ту же строку каждый раз, как он может быть надежным? Разве надежность — не главная цель управляемого слоя?
Ответ в том, что надежность в этом случае не означает получение идентичной строки. Она означает получение той информации, которую вы сочли важной. Рассмотрим три разных ответа, которые агент мог бы дать на вопрос «почему выручка упала в прошлом квартале?»:
- «Резкий рост оттока крупных корпоративных клиентов из-за жалоб на ошибку в выставлении счетов».
- «Крупные корпоративные клиенты ушли из-за проблем с выставлением счетов».
- «Ушли около 12 крупных корпоративных клиентов (примерно 60% недобора выручки за квартал), которые при звонках по поводу расторжения договоров ссылались на мартовскую ошибку в выставлении счетов».
Все три ответа передают одну и ту же мысль. Но то, насколько они надежны, полностью зависит от ваших потребностей. Если ответ должен включать масштаб влияния и конкретную причину, чтобы на его основе можно было действовать, требованиям соответствует только третий. Если вам было достаточно узнать, что падение вызвано оттоком клиентов, первый ответ вполне надежен.
В конечном счете определение «надежности» задает инженер, который создает контекст, а не модель — и это ничем не отличается от того, как всегда работали метрики. «Надежная выручка» уже означает в вашей организации нечто конкретное и осознанно выбранное: например, какие подписки учитывать, как обрабатывать возвраты и когда признавать выручку. Каждая организация, а нередко и каждая команда внутри нее, проводит эту границу по-своему. Инженерия контекста — та же дисциплина, примененная к новым формам данных, таким как неструктурированный текст: нужно определить, что должен содержать хороший ответ, и подготовить данные так, чтобы агент находил эту информацию каждый раз.
Где заканчиваются возможности соединений, регулярных выражений и классического SQL
Почему же инструменты, которые уже есть в вашем хранилище данных, не могут полностью решить эту задачу? Проблема в том, что традиционный SQL работает с символами, а не со смыслом. Попросите команду по работе с данными «найти всех клиентов, которые высказывали опасения по поводу конкурента», и первым побуждением будет написать LIKE '%competitor%' — неплохая отправная точка. Такой поиск находит буквальные упоминания, но пропускает перефразированные высказывания, сарказм и предложения, в которых конкурент подразумевается, но не называется. Попросите стандартный SQL связать обсуждение в Slack с клиентом, о котором идет речь, — и у соединения не окажется ключа, за который можно зацепиться. Сигнал есть, и человек, читающий текст, скорее всего, легко его заметит, но он скрыт в свободном тексте, до которого соединения и регулярные выражения не добираются.
На этом пределе возможностей и начинается инженерия контекста. Вместо сопоставления символов вы представляете текст в виде векторов, чтобы ИИ мог находить его по смыслу, сохраняя при этом метку, сведения о происхождении данных и ссылку на источник.
Большинство базовых возможностей для этого уже есть в вашем хранилище данных. Snowflake, Databricks и BigQuery уже предоставляют ИИ-функции для создания эмбеддингов, классификации, извлечения и генерации — непосредственно рядом с вашими данными. Чего пока нет, так это системного подхода к их использованию: как вызывать их единообразно на разных платформах, как версионировать используемые промпты, как не допустить перерасхода бюджета при выполнении задания и как проверить, что ответ опирается на исходный текст. Именно для того, чтобы превратить базовые возможности в управляемую практику, и создавался dbt, и именно этот пробел закрывает пакет. Каждый его элемент — обычный объект dbt, поэтому развертывать что-то новое не нужно.
Мы сознательно выпускаем первую версию именно в таком виде. Один паттерн мы проверили от начала до конца, остальные находятся на более ранних стадиях, и мы предпочитаем передать эту работу сообществу, пока практика еще формируется, а не продолжать совершенствовать ее за закрытыми дверями. Аналитическая инженерия стала общим ремеслом благодаря тому, что это сообщество обсуждало и оспаривало работающий код, пока паттерны не доказывали свою состоятельность, и мы хотим, чтобы инженерия контекста начиналась так же.
Что входит в пакет
Все реализовано в виде макросов, которые вы вызываете из модели:
- Разбиение текста на фрагменты с учетом количества токенов, без разрыва предложений.
- Вызовы ИИ для создания эмбеддингов, классификации, извлечения и генерации с механизмами контроля, обеспечивающими единообразие входных и выходных данных во всех трех хранилищах.
- Промпты и схемы, которые хранятся в репозитории, имеют имена и версии.
- Ограничение расходов и журнал выполнения для каждого вызова ИИ.
- Векторный поиск, не требующий индекса, и база знаний, объединяющая несколько источников.
- Тесты на обоснованность и точность, которые не обращаются к хранилищу данных и не расходуют токены.
Попробуйте за пять минут
Добавьте пакет в packages.yml и выполните dbt deps:
packages:
  - package: dbt-labs/dbt_context_engineering
    version: 0.1.0
Разбиение на фрагменты выполняется обычным SQL и не требует затрат на ИИ, поэтому с него проще всего начать. Подумайте, какой неструктурированный текст уже есть в вашем хранилище данных. Расшифровки звонков, электронные письма, сообщения Slack, поля со сводками — любой из этих источников можно использовать для разбиения на фрагменты.
{{ dbt_context_engineering.chunk(
  relation = ref('stg_gong__transcripts'), id_column = 'utterance_id',
  order_column = 'turn_index', text_column = 'utterance_text',
  partition_column = 'call_id', label_column = 'speaker'
) }}
Создайте эмбеддинги этих фрагментов и настройте поиск по ним — и у вас будет рабочий корпус текстов. Полная версия приведена в подробном примере ниже.
Первый паттерн: семантический поиск
Паттерн, которому мы доверяем больше всего и с которого рекомендовали бы начать команде, — семантический поиск. Три модели выполняются в простом DAG:
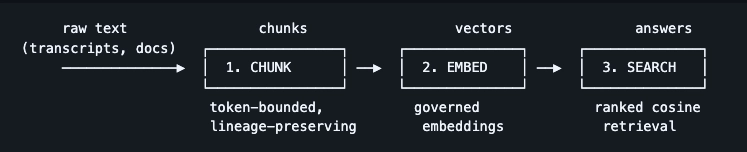
Chunk разбивает длинный текст на фрагменты, сохраняя ссылки на строки, из которых они получены. Embed превращает каждый фрагмент в вектор. Search принимает запрос, ранжирует текст по сходству и возвращает наиболее близкие фрагменты вместе со ссылками на источники. Три модели dbt, построенные с помощью трех макросов.
На выходе получается корпус текстов, на основе которого агент может отвечать и указывать источник: почему в прошлом квартале задерживались поставки и кого это затронуло, какие именно обязательства на вас накладывает договор, что говорится в инструкции по эксплуатации о конкретном процессе.
Когда «похожий» не значит «релевантный»
Нам хотелось бы сказать, что все просто работает, но это было бы не совсем верно. Чтобы добиться уровня точности, необходимого командам, нужно больше. В ходе собственных исследований мы выявили ограничения и провели дополнительную инженерную работу, чтобы достичь нужного нам порога качества.
Для начала мы запустили семантический поиск по jaffle-logistics, нашему демонстрационному корпусу текстов, который содержит историю одного клиента из восьми систем, с запросом «задержки поставок и их причины». Лучший результат состоял из шести токенов. Вот первая десятка:
| позиция | фрагмент | оценка | что это на самом деле |
|---|---|---|---|
| 1 | IR-9001::3 | 0.754 | случайный обрывок в конце текста: «Рассмотрено с диспетчерской службой». |
| 2, 3, 5 | IR-70xx::2 | от 0.57 до 0.66 | шаблонные строки о мерах по устранению последствий из несвязанных инцидентов |
| 4, 6, с 8 по 10 | TKT-2000xx | от 0.55 до 0.58 | стандартные заметки вида «можете подтвердить интервал доставки» |
| 7 | CT-99021::2 | 0.565 | единственный полезный фрагмент на всей странице |
А квартальные обзоры, которые действительно объясняют первопричину? Их на первой странице вообще не оказалось. Это распространенная проблема векторного поиска: короткий шаблонный текст располагается близко к центру пространства эмбеддингов и оказывается немного похожим практически на любой запрос. Поиск по сходству сработал как ожидалось. Релевантность — нет.
Проблему решила метка. classify() присваивает каждому фрагменту одну категорию из заданной вами таксономии — например, оценка ситуации у клиента, погодные помехи, ошибка при обработке или обычное обновление статуса, — после чего вы фильтруете результаты поиска по категории, к которой относится вопрос, еще до ранжирования.
select
  chunk_id,
  {{ dbt_context_engineering.classify('chunk_text',
     dbt_context_engineering.prompt('signal_classify', 'v3'),
     dbt_context_engineering.schema_def('signal_classify', 'v3')) }} as classification
from {{ ref('stg_chunks') }}
Когда мы повторили поиск с подходящим фильтром, то получили релевантный контекст по клиенту!
В этом пакете промпт и таксономия — версионируемые макросы, поэтому их изменение оформляется как pull request, который можно отследить и проверить, а расходы на вызов учитываются и сам вызов журналируется, как и остальные. Мы бы назвали классификацию дополнением к паттерну, а не обязательным четвертым шагом, хотя, как показывает демонстрация, именно она превращает поиск по сходству в релевантную выдачу, когда текст короткий и шаблонный. Самый быстрый способ понять, зачем она нужна, — запустить поиск без нее.
Тестирование результатов
Метрики заслужили доверие благодаря тестированию, и контекст должен соответствовать тому же стандарту. Распространенный подход «спросить у более крупной модели, выглядит ли ответ правильным» этому стандарту не соответствует: это платное мнение, а не надежный тест. Поэтому проверки здесь детерминированы и не требуют затрат на выполнение. Мы добавили несколько первых тестов, которые проверяют корректность ссылок на исходный текст и точность модели, и ожидаем, что этот набор будет быстро расти.
columns:
  - name: evidence
    data_tests:
      - dbt_context_engineering.grounded:
          source_text_column: chunk_text
Принципы, на которых мы строим работу
Наш подход к инженерии контекста опирается на несколько руководящих принципов. Каждый из них основан на практике, уже признанной в экосистеме ИИ, а наша позиция касается того, как ее следует применять при работе в управляемом хранилище данных. Это принципы, на которых построен пакет и которые мы предлагаем сообществу развивать. Новая возможность уместна в пакете, если она развивает один из них.
- Разбиение на фрагменты. Текст нужно делить на связные единицы ограниченного размера, а не разрезать в произвольных местах по числу символов.
- Поиск и RAG. Для фрагментов должны создаваться эмбеддинги, а сами фрагменты должны быть доступны для поиска по смыслу в виде обычных моделей, которые можно исследовать, а не стороннего черного ящика.
- Происхождение данных и ссылки на источники. Каждая производная строка должна сохранять идентификаторы своих источников при прохождении через DAG, чтобы каждый ответ мог точно ссылаться на свое происхождение.
- Структурированные результаты. Результат работы ИИ должен соответствовать контракту в виде объявленной схемы, чтобы его структура оставалась согласованной, пригодной для соединений и тестирования.
- Промпты как код. Промпты и схемы выходных данных должны храниться в системе контроля версий, с возможностью сравнения изменений и явным указанием версий. Ни один промпт не должен существовать только в пользовательском интерфейсе.
- Управление затратами. Ни один вызов ИИ не должен попадать в эксплуатацию без мониторинга затрат и защитного механизма, который может остановить выполнение до перерасхода бюджета.
- Обоснованность и оценка. Результаты работы ИИ должны поддаваться тестированию, как и любой другой ресурс данных: опираться на исходный текст, соответствовать своей схеме и оцениваться по эталонному набору.
Это лишь первоначальный набор: мы ожидаем, что он будет расширяться по мере того, как мы продолжим осваивать практику целенаправленной инженерии контекста.
Что еще есть в пакете
Остальная часть пакета охватывает возможности, которые, на наш взгляд, нужны инженерии контекста. Некоторые из них проверены на всех трех основных платформах хранилищ данных, другие пока находятся в бета-версии:
- Генерация и извлечение для задач, в которых одной метки недостаточно: например, составление сводок, переформулирование или извлечение структурированных полей из документа.
- Анализ на уровне группы: целой расшифровки или всей истории обращений клиента за один раз.
- Управляемые векторные индексы для случаев, когда поиск полным перебором перестает масштабироваться.
- Сигнализатор дрейфа, который при каждой сборке повторно выполняет фиксированный набор проверочных запросов и сообщает, если провайдер незаметно заменил используемую модель.
Эти возможности включены в список, потому что они нужны практике. Просто они находятся на более ранней стадии и меньше проверены, а продвигает их вперед реальное использование. Полный обзор с указанием зрелости каждой возможности приведен в README пакета.
Развивайте это вместе с нами
Мы считаем, что ни один пакет или поставщик не может единолично определять, что такое инженерия контекста. Сообщество, превратившее моделирование данных в общее ремесло, — именно та среда, в которой стоит вырабатывать подходы к превращению данных в контекст. Инженерия контекста требует повторить этот путь. Уже проделанная вами работа над метриками не теряет значения. Она становится надежным фундаментом, на котором строится более широкий набор возможностей.
Мы продолжим вкладываться в этот пакет, в образовательные материалы для сообщества и во многие другие направления, которые помогают командам по работе с данными освоить следующий этап развития профессии: превращать данные, которыми вы уже управляете, в контекст, на который могут полагаться агенты и ИИ-приложения, — фундамент, действительно необходимый корпоративной стратегии в области ИИ.
Самый быстрый способ повлиять на дальнейшее развитие — попробовать пакет в деле. Какие решения вы уже собрали самостоятельно? Где этот подход сталкивается с трудностями на ваших данных? Что стоит первым вывести из бета-версии?
- Установите пакет и запустите chunk, embed и search на реальных данных.
- Посмотрите подробный пример jaffle-logistics, включая сравнение результатов поиска до и после.
- Прочитайте ADR, если хотите понять обоснование принятых решений.
- Расскажите, где что-то не работает, создавайте issues и PR и предлагайте паттерны, которые хотели бы увидеть следующими.