Перейти к основному содержимому
Joel Labes
Staff Developer Experience Advocate at dbt Labs
View All Authors

В чём разница между dbt и dbt OSS?
· 10 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

В рамках выпуска общедоступной версии dbt v2 мы переименовали два дистрибутива, чтобы отразить их место в экосистеме. Движок dbt Fusion теперь называется просто dbt, а dbt Core v2 теперь называется dbt OSS. Мы ожидаем, что большинство пользователей, переходящих на dbt v2, выберут основной дистрибутив dbt, который можно бесплатно использовать и устанавливать локально.

Изменение названий не меняет нашей приверженности открытому исходному коду: полностью открытая реализация стандарта dbt существует и будет существовать всегда. Весь код, который мы перевели с ELv2 или проприетарных лицензий на Apache 2.0 в июне, остаётся под этой лицензией, а переход на общую основу (вместо сохранения dbt Core на устаревшем движке Python) делает версию dbt с открытым исходным кодом сильнее.

Переход к двум свободно используемым дистрибутивам с общей основой — главный источник путаницы, с которым мы столкнулись во время бета-тестирования v2. Эта статья поможет объяснить различия между dbt и dbt OSS и подскажет, какой дистрибутив вам стоит выбрать.
dbt v2.0 выходит в общедоступный релиз

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

После 18 месяцев разработки, обратной разработки, разбора и повторной сборки движок dbt Fusion вышел в общедоступный релиз под новым именем: dbt. (Подробнее об этом читайте здесь). Эта полностью переписанная версия dbt решает ряд давних проблем реализации dbt v1 и закладывает основу для следующего десятилетия развития. Раньше:

  • dbt не понимал SQL, который генерировал, поэтому не мог предупреждать о некорректном коде без его выполнения и расходования вычислительных ресурсов.
  • В крупных проектах разбор проекта в dbt мог занимать до 20 минут, прежде чем можно было приступить к выполнению.
  • Артефакты dbt затрудняли взаимодействие между инструментами: единственным способом передачи данных из одного продукта в другой были огромные JSON-файлы.
  • Многие команды не могли пользоваться dbt docs из-за проблем с масштабированием и производительностью.

Новый dbt v2:

  • Глубоко понимает SQL и позволяет обнаруживать ошибки в коде до его отправки в хранилище, экономя время и деньги разработчиков и обеспечивая агентам циклы работы с проверяемыми результатами.
  • Создан с упором на скорость во всех аспектах благодаря переходу на оптимизированный исполняемый файл на Rust и использованию современных технологий, таких как ADBC. Мы видели проекты, разбор которых раньше занимал 20 минут, а теперь завершается менее чем за минуту. Проекты более типичного размера тоже получат значительное ускорение в повседневной работе (например, компиляция станет быстрее в 2 раза или более).
  • Представляет dbt Information Schema, которая описывает весь проект в виде стандартных файлов Parquet. Это позволяет уменьшить размер файлов более чем в 10 раз, при этом предоставляя более полные данные, и обеспечивает быстрое выполнение запросов через dbt show --info, внешние инструменты, такие как DuckDB, и совершенно новую функцию checks.
  • Включает совершенно новую версию dbt docs, которая гораздо лучше масштабируется.

Как на самом деле работает dbt State и помогает снизить затраты на вычисления

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Toby Mao
Director, Engineering at Fivetran

При создании проекта dbt вы начинаете с самой простой стратегии и добавляете сложность, только когда требуется повысить скорость или снизить затраты. На уровне отдельных моделей это переход от материализации view к table, а затем к incremental. На уровне всего проекта оптимизации раньше требовали куда большей сложности: чтобы перестраивать только нужные части проекта, приходилось тратить немало умственных усилий на комбинирование селекторов вроде state:modified, source_status:fresher или config.materialized:view и следить за тем, чтобы актуальные JSON-артефакты были доступны всем в организации.

dbt State одновременно повышает скорость, снижает затраты и упрощает работу. Он работает везде, где работаете вы: в dbt Core или Fusion, локально или в любом выбранном вами оркестраторе. Поскольку в его основе лежит новый платный сервис с бесплатным пробным периодом на 30 дней, вам не нужно переходить на всю платформу dbt, чтобы получить эту экономию. dbt State приходит на смену оркестрации с учетом состояния, для которой требовались подписка на платформу dbt и переход на Fusion.

Самая интересная с технической точки зрения часть — процесс нормализации запросов1, благодаря которому запуск новой команды dbt lint не приводит сразу к полной пересборке. Но прежде чем углубляться в синтаксические деревья, давайте вспомним, что именно dbt State делает для конечного пользователя.

Базовый рабочий процесс dbt State​

При запуске dbt проверяет на сервере dbt State, выполняется ли для модели одно из условий:

  • она уже существует в целевой схеме и может быть использована повторно;
  • она уже существует в другой схеме и может быть использована повторно;
  • ее необходимо построить с нуля.

Встречайте dbt Core v2: по-прежнему с открытым исходным кодом, теперь на новой основе для будущего

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Grace Goheen
Product Manager, dbt Core at dbt Labs

Сегодня мы опубликовали первую альфа-версию dbt Core 2.0, подняв планку того, чего пользователи dbt могут ожидать от своего инструмента трансформации данных. Как и прежде, исходный код dbt Core полностью открыт под лицензией Apache 2.0. Этот выпуск особенно важен потому, что dbt Core 2.0 теперь построен на той же основе, что и движок dbt Fusion: мы впервые открыли исходный код значительной части Fusion.

Выпуск dbt Core 2.0 включает ряд важных функциональных улучшений:

  • Значительное сокращение времени разбора, особенно для самых крупных проектов dbt
  • Строго определённая спецификация языка, которая не позволит случайно задать desciptin вместо description и предоставляет всем, кто создаёт интеграции с экосистемой dbt (включая собственную команду разработки dbt!), стабильный интерфейс для разработки.
  • Новые артефакты в формате Parquet как высокопроизводительная альтернатива большим JSON-файлам, к которым можно напрямую обращаться с запросами через DuckDB или агента на ваш выбор
  • Полностью переработанная локальная документация, которая использует новые артефакты и масштабируется для проектов любого размера.
  • Более простой способ создания новых адаптеров на базе ADBC и экосистемы Arrow
  • Упрощённый процесс установки, избавляющий от необходимости бороться с виртуальными окружениями Python

Помогите своему ИИ лучше работать с данными с помощью навыков агентов dbt

· 13 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs

Создание и развитие лучших практик силами сообщества — пожалуй, главная движущая сила роста dbt и аналитической инженерии: рабочие процессы и подходы, которые можно перенимать, позволяют каждому создавать и распространять знания внутри организации. На заре развития dbt файл dbt_style_guide.md от dbt Labs Fishtown Analytics содержал основополагающие рекомендации для всех, кто впервые знакомился с подходом dbt.

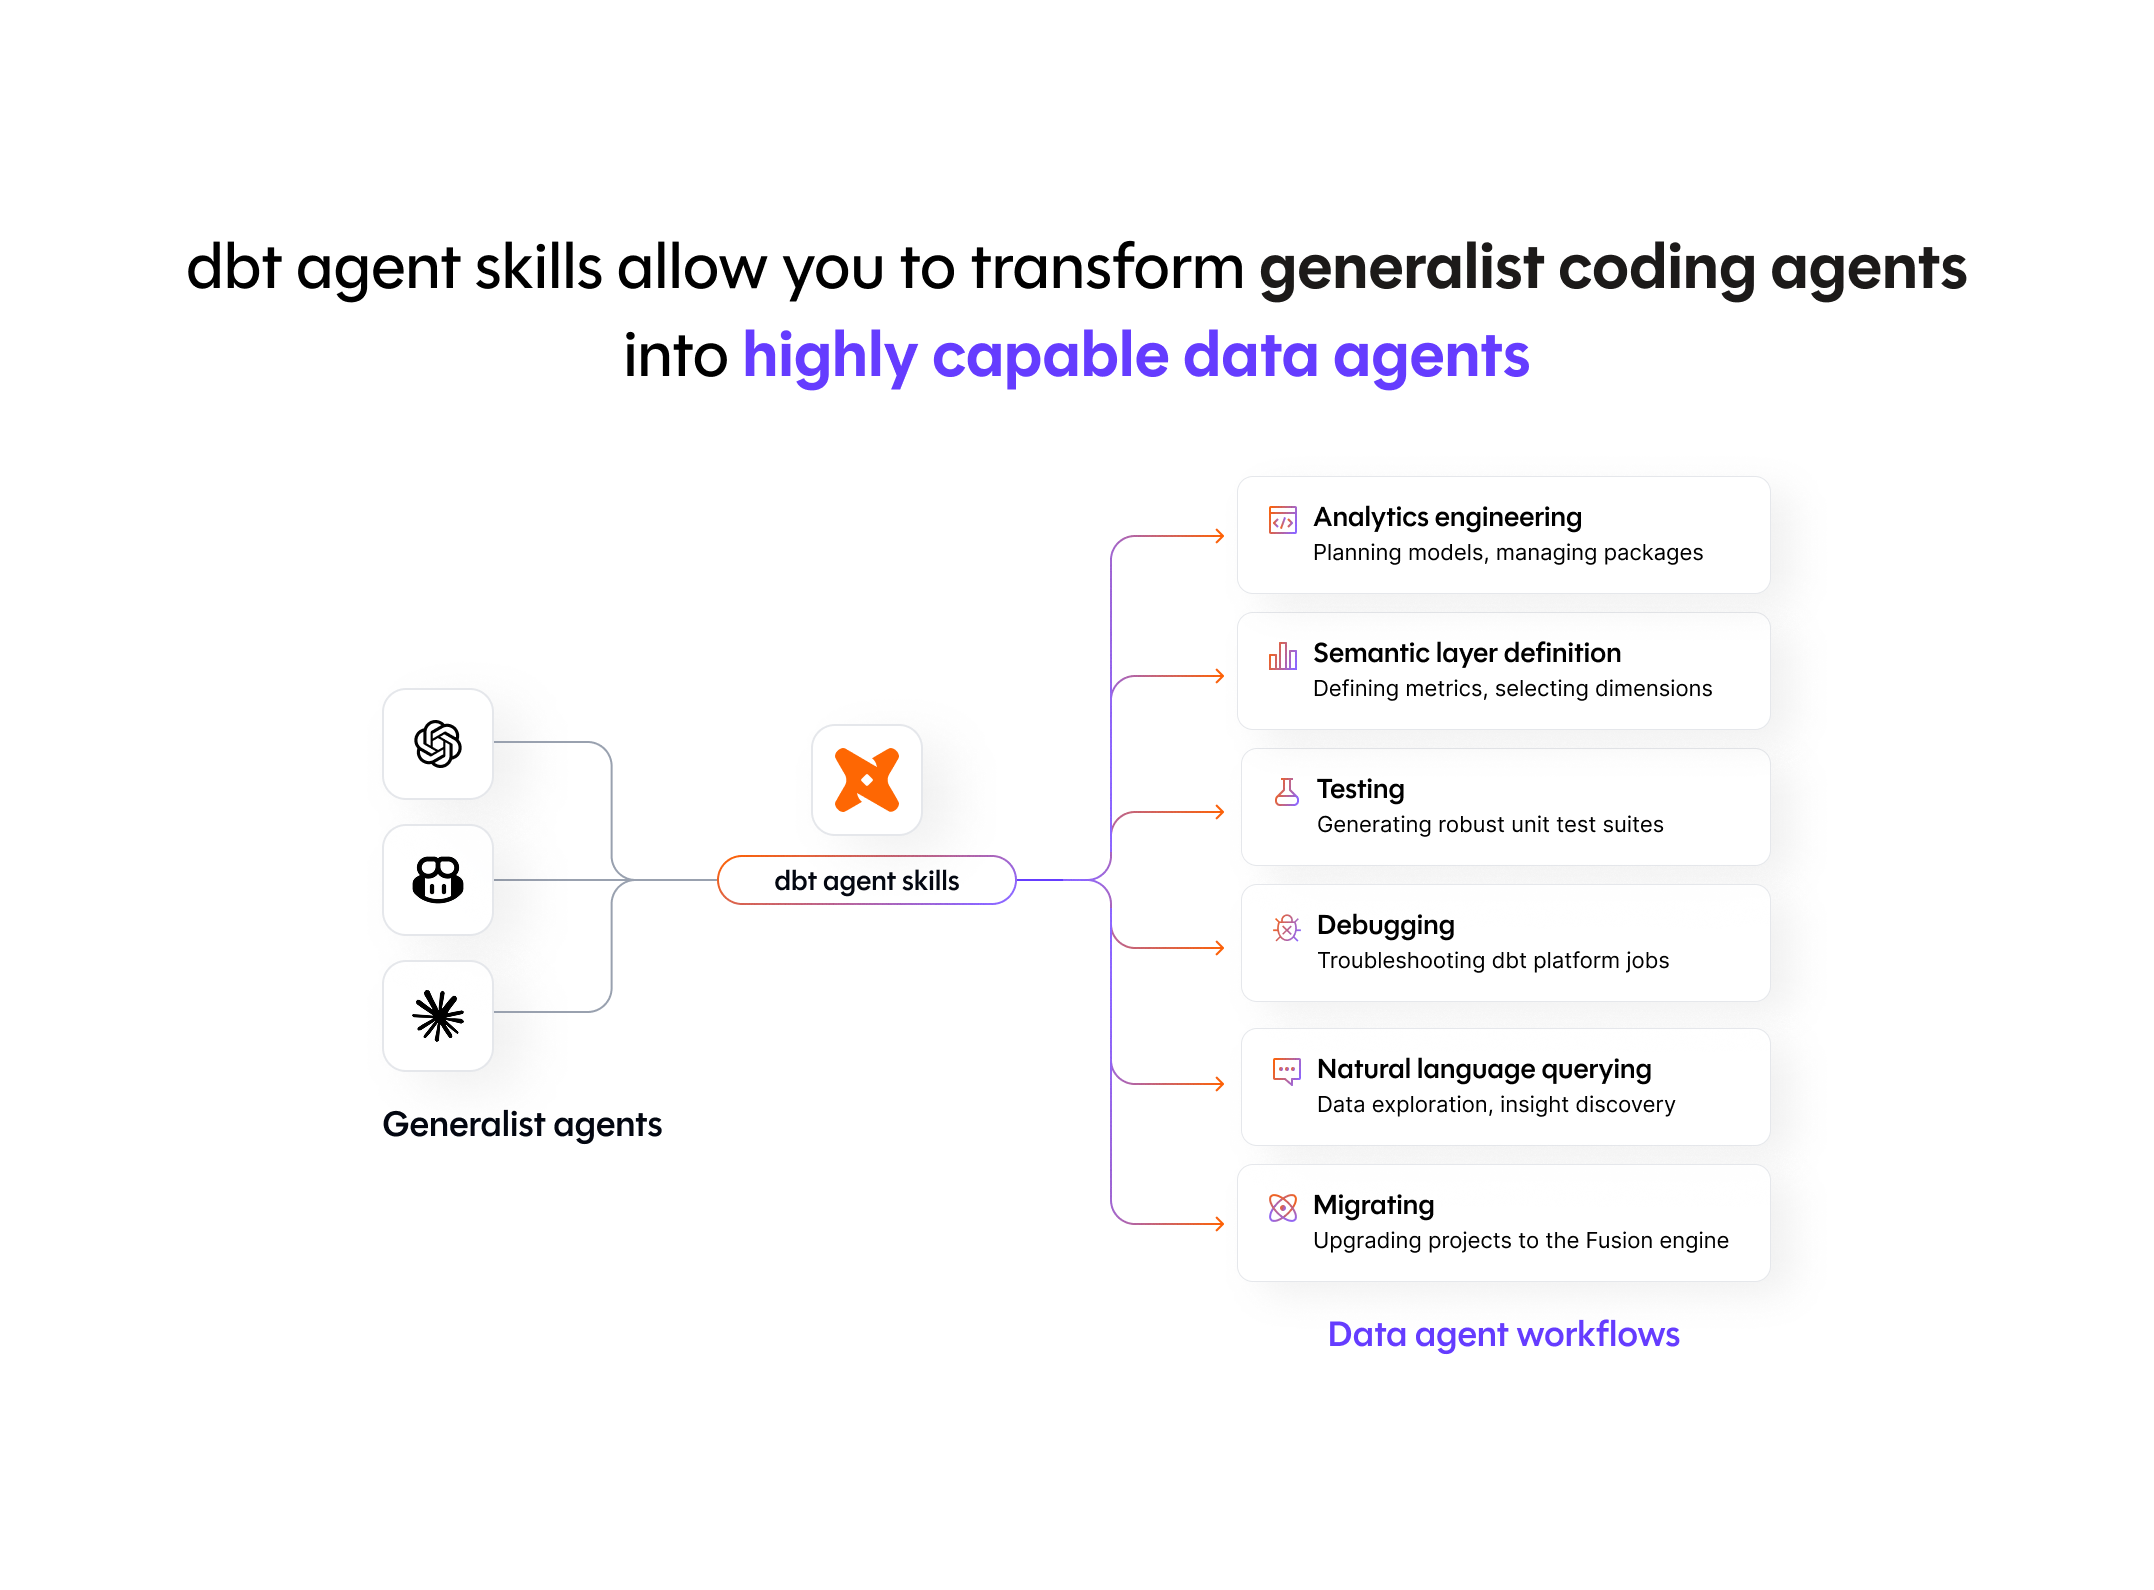
Сегодня мы выпустили набор навыков агентов dbt, чтобы ИИ-агенты (такие как Claude Code, Codex от OpenAI, Cursor, Factory или Kilo Code) могли следовать тем же лучшим практикам dbt, которых вы ожидаете от любого участника, работающего с вашей кодовой базой. Это важно, потому что, расширяя базовые возможности агентов, навыки позволяют превратить универсальных агентов для программирования в высококвалифицированных агентов для работы с данными.

Схема, показывающая, как навыки агентов dbt превращают универсальных агентов для программирования в специализированных агентов для работы с данными, способных заниматься аналитической инженерией, определением семантического слоя, тестированием, отладкой, запросами на естественном языке и миграциейНавыки агентов dbt позволяют превратить универсальных агентов для программирования в высококвалифицированных агентов для работы с данными

Эти навыки объединяют обширные знания, накопленные сообществом dbt и командой Developer Experience в dbt Labs на основе практического опыта. За ними стоят десятки часов целенаправленной работы экспертов dbt, подкреплённые годами использования dbt.

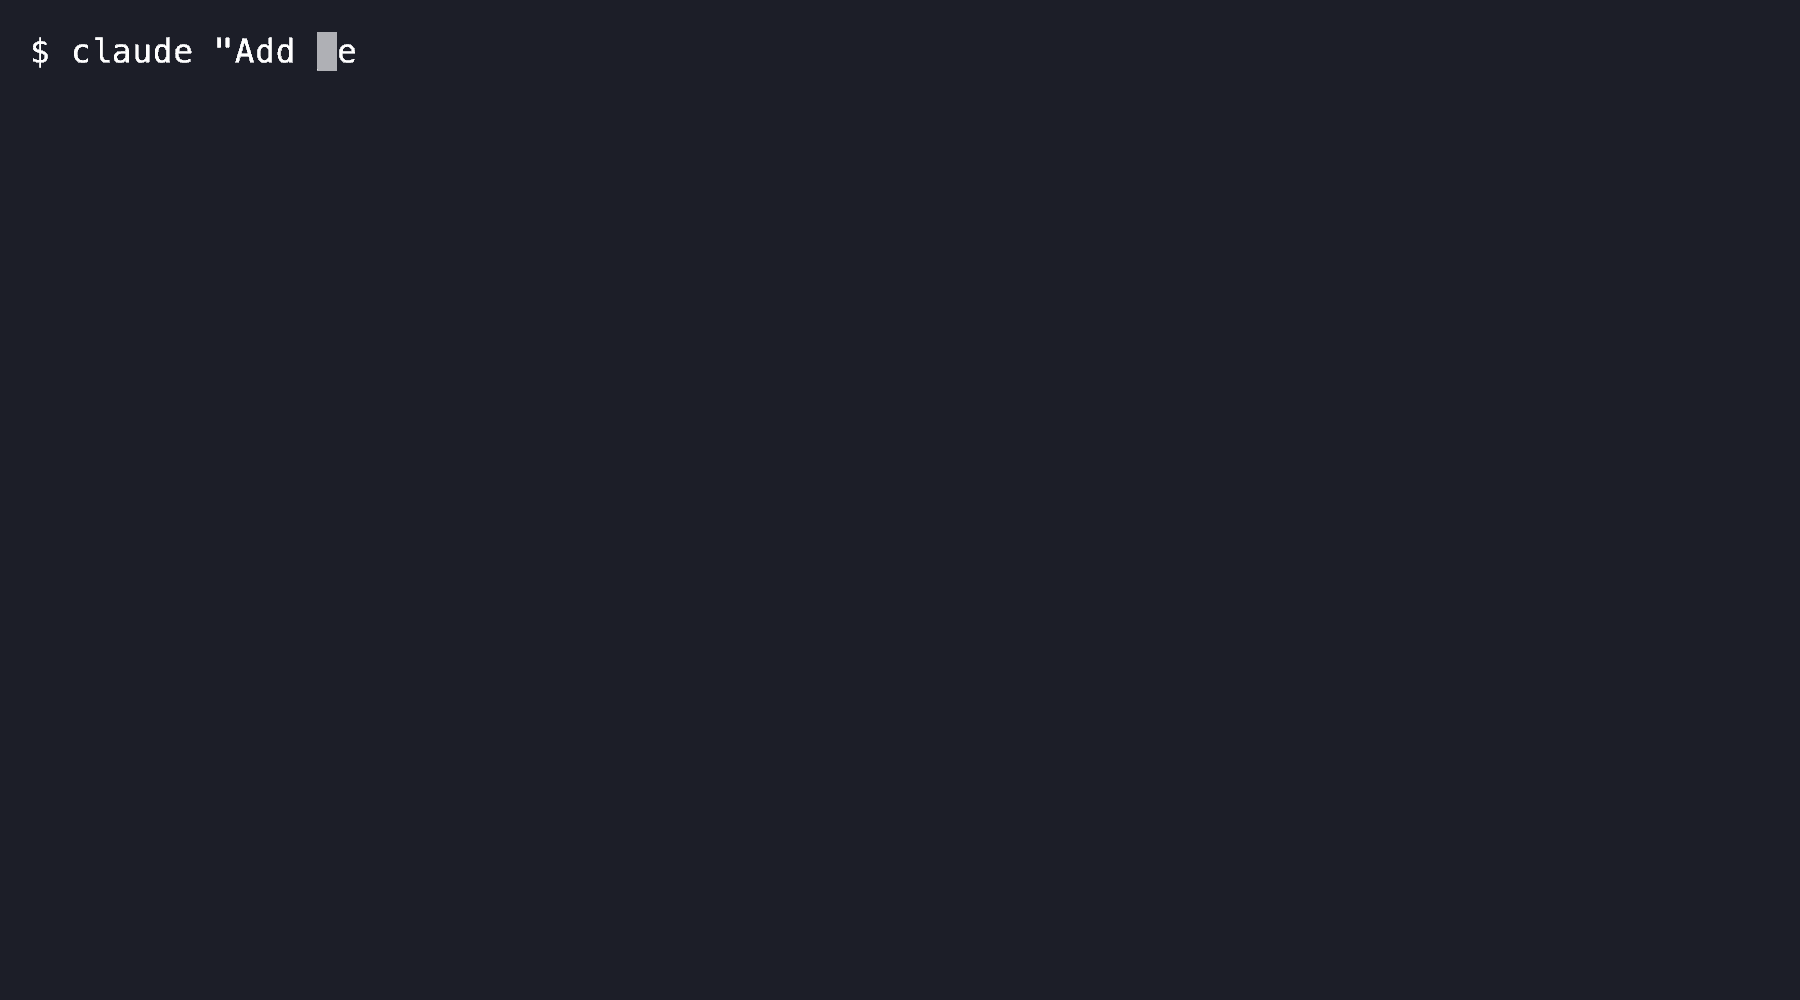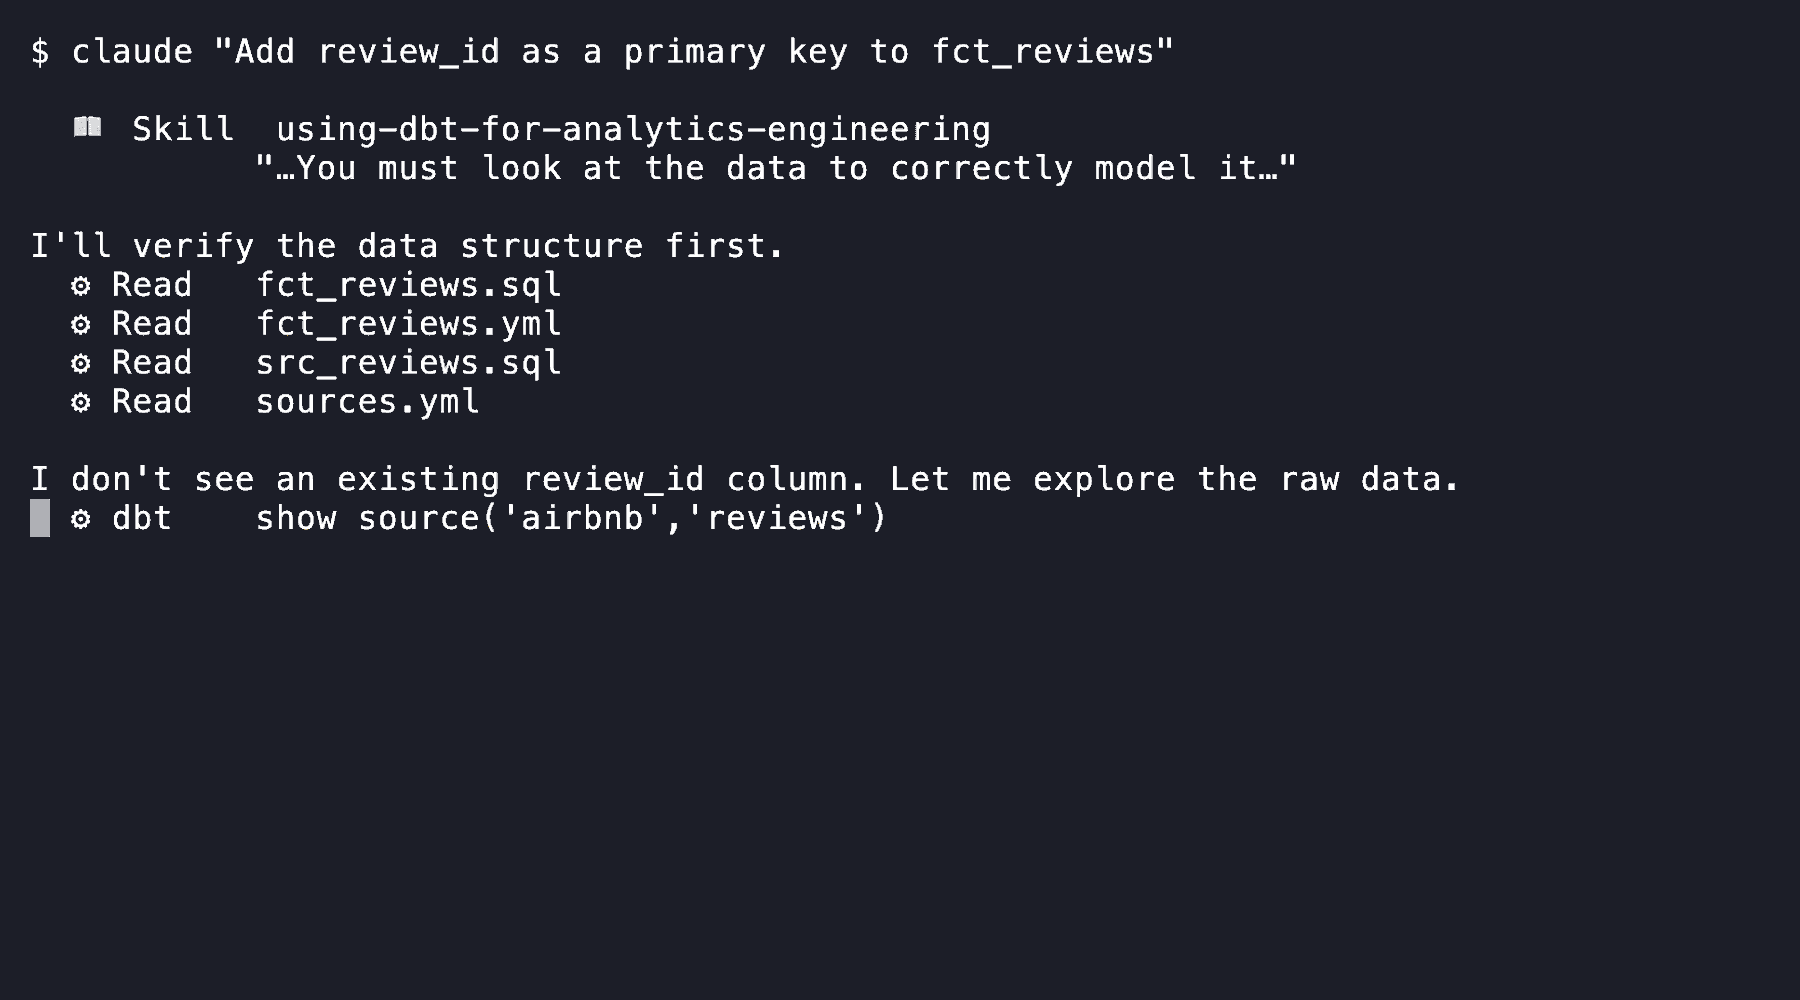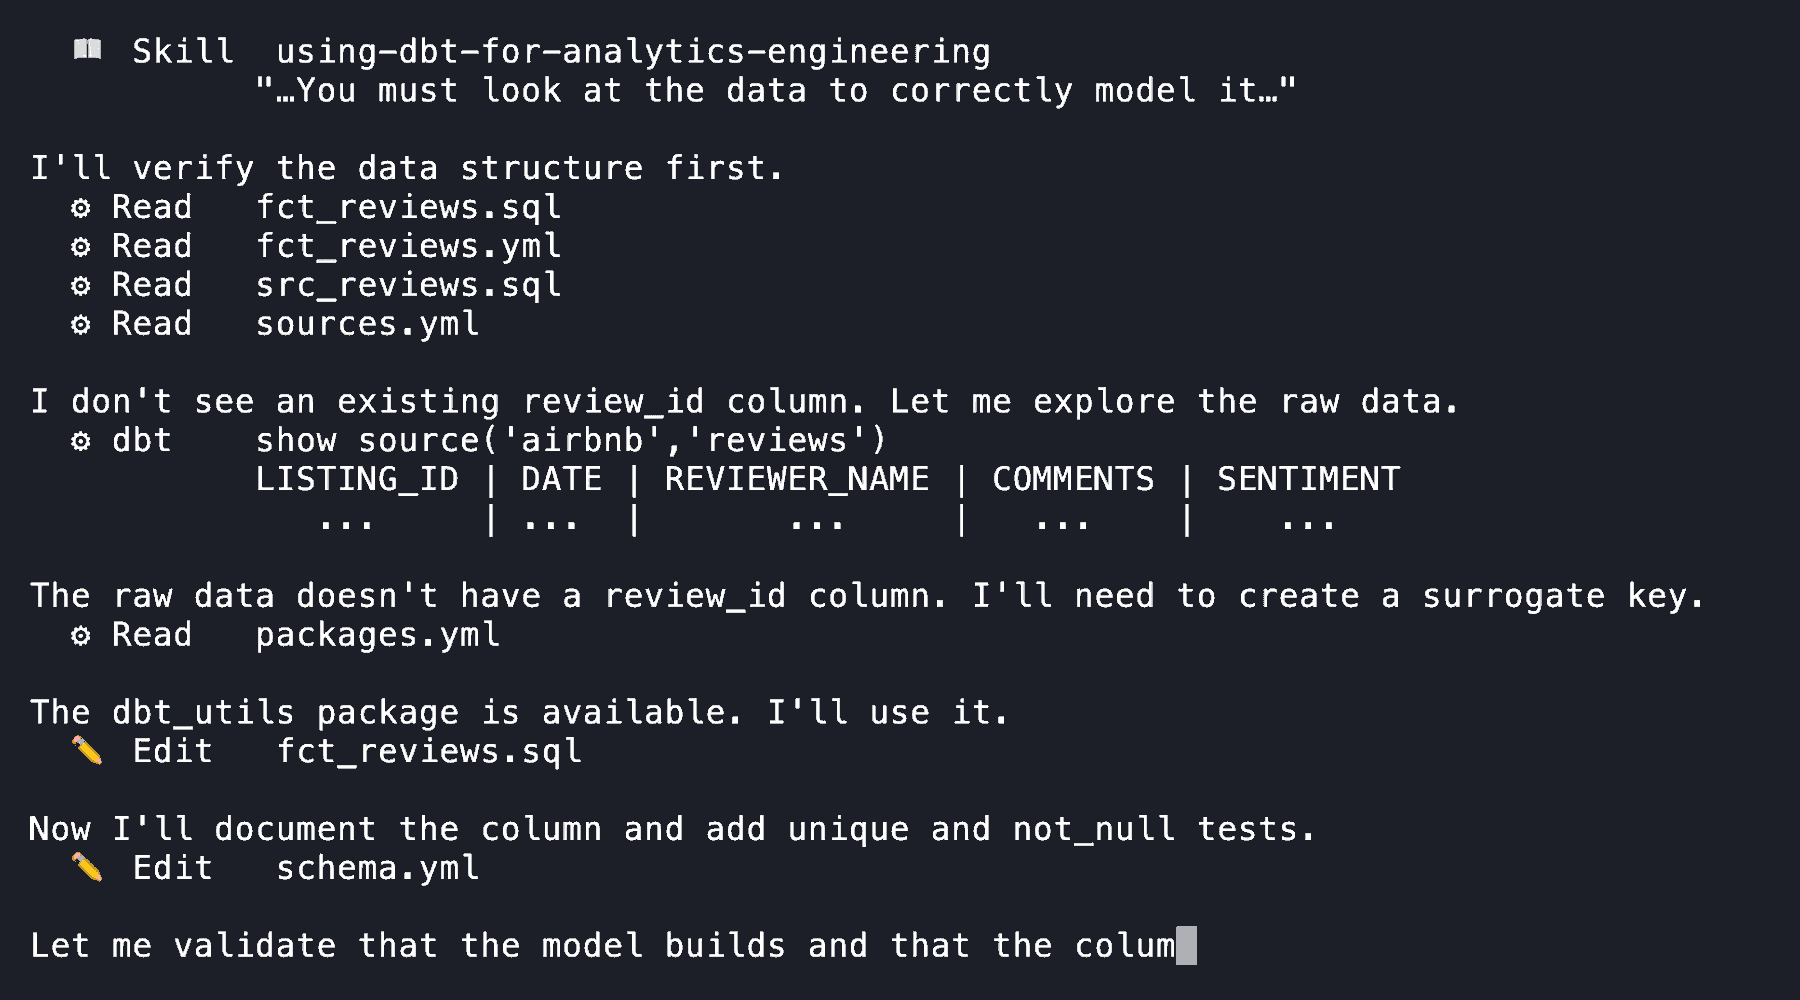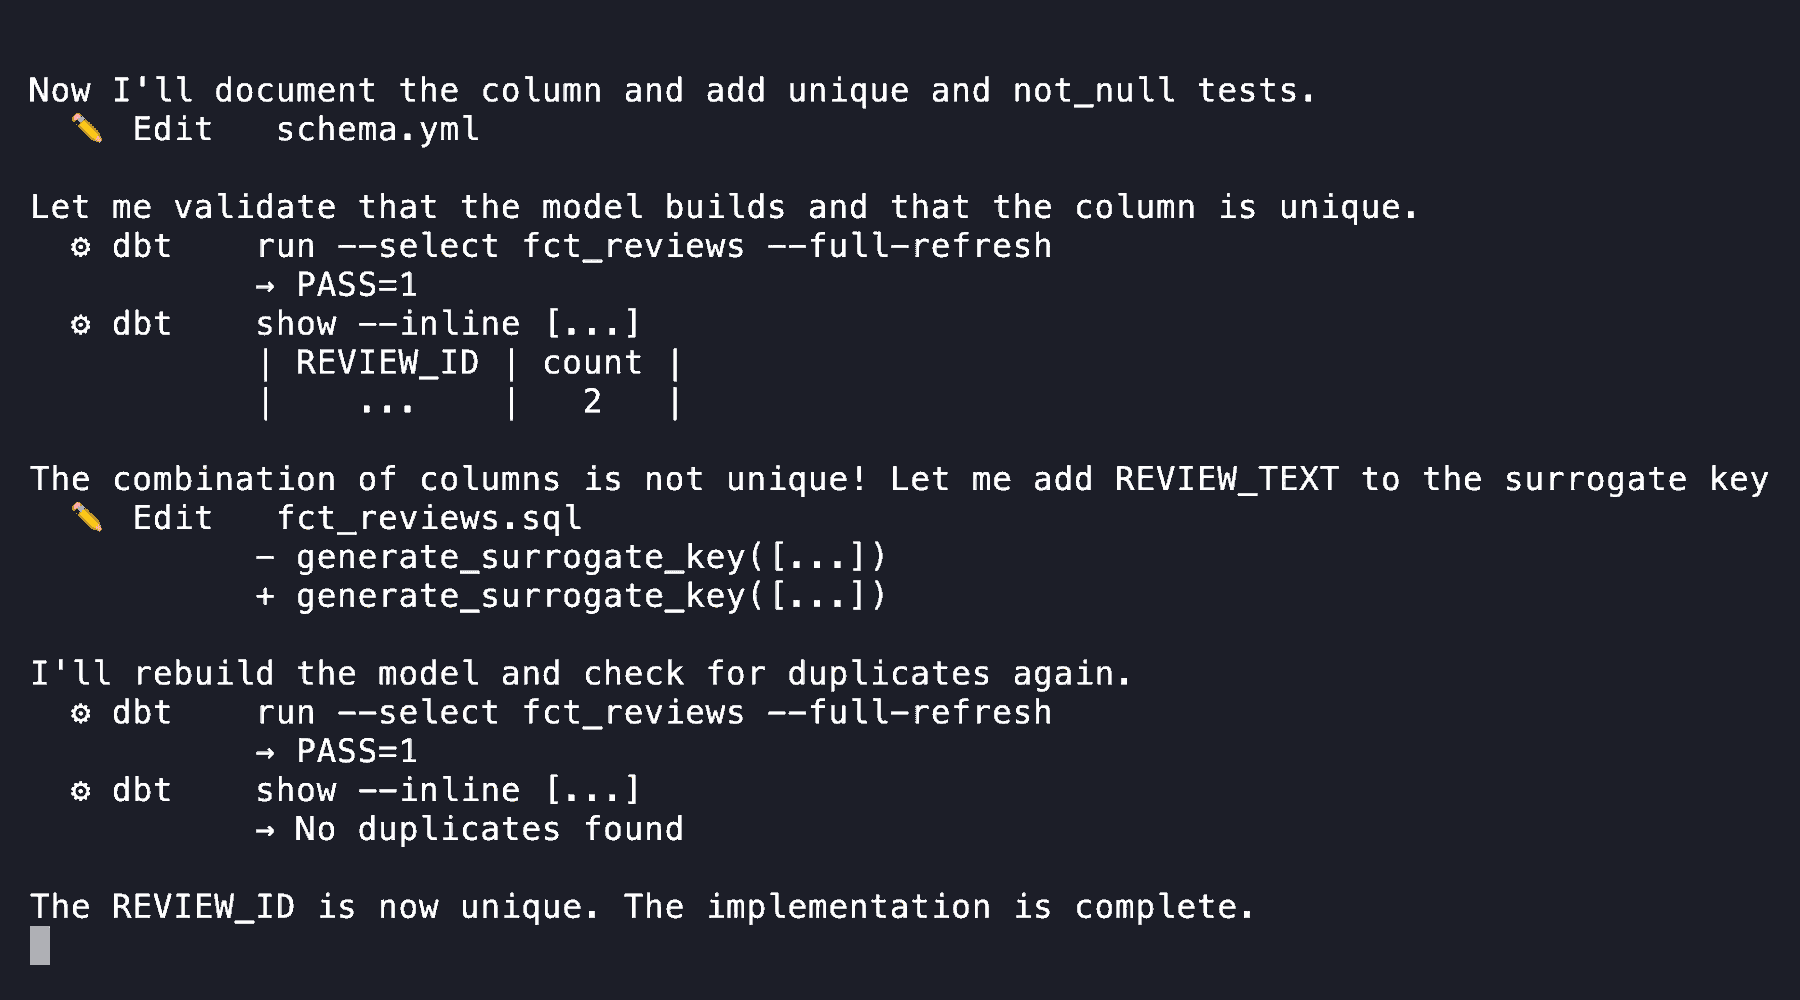
Анимация, показывающая, как Claude использует навык аналитической инженерии для проверки своей работыИмея доступ к навыкам, такие агенты, как Claude, подходят к задачам системно

Компоненты движка dbt Fusion и то, как они сочетаются друг с другом

· 10 мин. чтения
Jason Ganz
Director of Community, Developer Experience & AI at dbt Labs
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Сегодня мы анонсировали движок dbt Fusion.

Fusion — это не какая‑то одна вещь. Это набор взаимосвязанных компонентов, которые вместе обеспечивают работу следующего поколения аналитической инженерии.

В этом посте мы разберём каждый элемент архитектуры Fusion, объясним, как они сочетаются друг с другом, и проясним, что именно доступно вам в зависимости от того, компилируете ли вы Fusion из исходного кода, используете наши готовые бинарные сборки или разрабатываете внутри продукта, построенного на dbt Fusion.

От движка на Rust до расширения VS Code, от новых адаптеров на базе Arrow до базовых технологий под лицензией Apache — мы подробно разберём, что делает каждый компонент, под какой лицензией он распространяется (о причинах см. сопутствующий пост Тристана), а также как вы можете начать использовать Fusion и принять участие уже сегодня.

Путь к GA: как движок dbt Fusion проходит путь от беты к продакшену

· 12 мин. чтения
Jeremy Cohen
Principal Product Manager at dbt Labs
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Сегодня мы объявили, что движок dbt Fusion доступен в бета-версии.

  • Если Fusion уже работает с вашим проектом — отлично! Вас ждёт много приятного 😄
  • Если это ваш первый день с dbt — добро пожаловать! Начинайте сразу с Fusion — вас тоже ждёт приятный опыт.

Сегодня — Launch Day, первый день новой эры: Эпохи Fusion. Мы ожидаем, что многие команды с существующими проектами столкнутся как минимум с одной проблемой, которая помешает использовать движок dbt Fusion в продакшене. И это нормально!

Мы активно работаем над тем, чтобы разблокировать всё больше команд, и берём на себя обязательство, что к моменту достижения Fusion статуса General Availability:

  • Мы будем поддерживать Snowflake, Databricks, BigQuery, Redshift — а также, вероятно, Athena, Postgres, Spark и Trino — с новым паттерном адаптеров Fusion.
  • Мы покроем (практически) весь функционал dbt Core. Некоторые вещи сложно или нецелесообразно воспроизводить вне Python, а некоторые используются настолько редко, что мы будем реагировать на них по мере необходимости. При этом многие существующие поведения dbt Core будут улучшены за счёт уникальных возможностей движка dbt Fusion — таких как скорость и глубокое понимание SQL. Вы увидите обсуждения этого в соответствующих GitHub issues, на многие из которых мы ссылаемся ниже.
  • Репозиторий с открытым исходным кодом dbt-fusion будет содержать больше функциональности, чем доступно в dbt Core сегодня. (Подробнее об этом здесь.)
  • Опыт разработчика станет ещё быстрее и интуитивнее.

Пока что всё это ещё не реализовано — но вы можете видеть, куда мы движемся. Для этого и существуют беты, это путь, по которому мы идём вместе, и именно поэтому мы хотим вовлечь вас всех.

Парсер. Лучше. Быстрее. Сильнее: взгляд на новый движок dbt

· 4 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

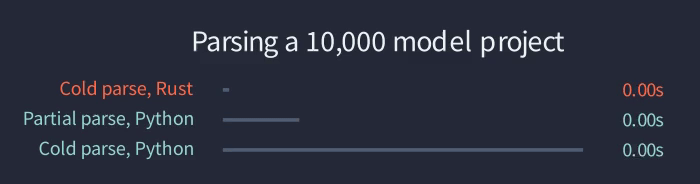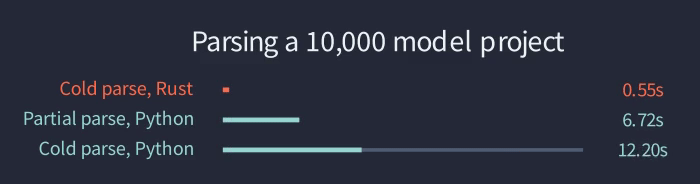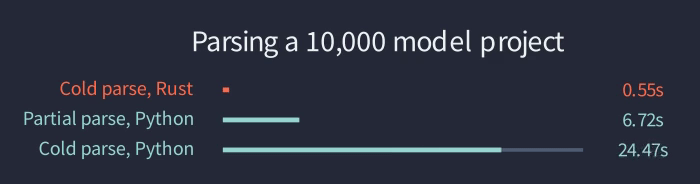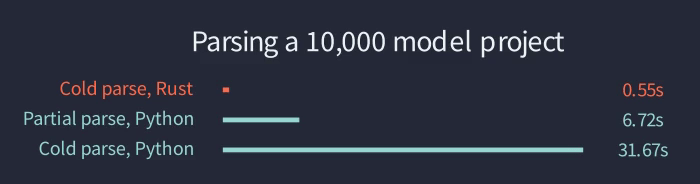
Помните, каким dbt ощущался, когда у вас был небольшой проект? Вы нажимали Enter — и всё начинало происходить практически мгновенно. Мы возвращаем это ощущение.

Совет по бенчмаркингу: всегда старайтесь получать данные, которые достаточно хороши, чтобы вам не пришлось делать по ним статистикуСовет по бенчмаркингу: всегда старайтесь получать данные, которые достаточно хороши, чтобы вам не пришлось делать по ним статистику

После серии подробных разборов, посвящённых внутреннему устройству понимания SQL, давайте немного поговорим о скорости. А именно — об одном из самых раздражающих замедлений по мере роста проекта: парсинге проекта.

Если после запуска dbt вы ждёте несколько секунд или даже минут, прежде чем что-то начнёт происходить, — это потому, что парсинг ещё не завершён. Но в демо SDF от Лукаса на вебинаре в прошлом месяце такого длительного ожидания не было. Почему?

Три уровня понимания SQL: что это такое и почему важно о них знать

· 8 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

С тех пор как dbt Labs на прошлой неделе приобрела SDF Labs, я с головой погрузился в их технологии, пытаясь во всём разобраться. Главным, что я знал на входе, было: «SDF понимает SQL». Фраза короткая и ёмкая, но детали за ней — по-настоящему захватывающие.

Чтобы следующий этап развития Analytics Engineering оказался таким же трансформирующим, как и предыдущий, dbt должен выйти за рамки строкового препроцессора и начать полноценно понимать SQL. Впервые именно SDF предоставляет технологии, которые делают это возможным. Сегодня мы подробно разберёмся, что вообще означает «понимание SQL» и почему это так важно для того, что нас ждёт дальше.

Аналитическая инженерия с поддержкой LLM: Как мы используем ИИ внутри нашего проекта dbt сегодня, без новых инструментов.

· 9 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

Облачные платформы данных открывают новые возможности; dbt помогает внедрить их в производство​

Первый сдвиг парадигмы, который позволил dbt существовать и быть полезным, заключался в переходе баз данных в облако.

Внезапно стало возможным для большего числа людей выполнять более качественную работу с данными, так как огромные препятствия превратились в огромные возможности:

  • Теперь мы могли динамически масштабировать вычисления по требованию, без необходимости обновления до более крупной локальной базы данных.
  • Теперь мы могли хранить и запрашивать огромные наборы данных, такие как данные о кликах, без предварительной агрегации и трансформации.

Сегодня следующая волна инноваций происходит в области ИИ и LLM, и она приходит на облачные платформы данных, которые специалисты dbt уже используют каждый день. Например, Snowflake только что выпустили свои функции Cortex для доступа к инструментам с поддержкой LLM, настроенным для выполнения общих задач с вашими существующими наборами данных. Это открывает перед нами новые возможности:

Почему вам следует указать производственную среду в dbt Cloud

· 5 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Теперь вы можете также указать окружение Staging!

Этот пост в блоге был написан до того, как в dbt Cloud появилась полноценная поддержка окружений Staging. Теперь, когда они существуют, вам следует пометить ваше CI-окружение как Staging. Подробнее читайте в разделе Staging environments.

:::

Основная идея:

Вы должны разделить свои задания по средам в dbt Cloud в зависимости от их назначения (например, Производственная и Стадия/CI) и установить одну из них как Производственную. Это улучшит ваш опыт CI и позволит использовать dbt Explorer.

Сегментация сред всегда была важной частью рабочего процесса аналитической инженерии:

  • При разработке новых моделей вы можете обрабатывать меньший подмножество ваших данных с помощью target.name или переменной окружения.
  • Создавая ваши производственные модели в другой схеме и базе данных, вы можете экспериментировать спокойно, не беспокоясь о том, что ваши изменения случайно повлияют на пользователей ниже по потоку.
  • Использование выделенных учетных данных для производственных запусков, вместо индивидуальных учетных данных аналитического инженера, гарантирует, что ничего не сломается, когда этот давний сотрудник наконец-то завершит свою работу.

Исторически сложилось так, что dbt Cloud требовал отдельной среды для разработки, но не имел строгих требований к конфигурации вашей учетной записи. Это в основном работало – до тех пор, пока у вас не было ничего более сложного, чем CI-задание, смешанное с парой производственных заданий – потому что важные конструкции, такие как отложенные действия в CI и документация, были связаны только с одним заданием.

Но по мере того, как развертывания dbt в компаниях становились более сложными, предположение, что одного задания достаточно, больше не имеет смысла. Нам нужно обменять стратегию, ориентированную на задания, на более зрелый и масштабируемый подход, ориентированный на среду. Для поддержки этого недавнее изменение в dbt Cloud позволяет администраторам проектов отметить одну из своих сред как Производственную среду, так же как это давно возможно для среды разработки.

Явное разделение ваших производственных нагрузок позволяет dbt Cloud быть более умным с метаданными, которые он создает, и особенно важно для двух новых функций: dbt Explorer и пересмотренных рабочих процессов CI.

Как перенести данные из электронных таблиц в ваш хранилище данных

· 10 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs

После того как ваше data warehouse будет построено, подавляющее большинство ваших данных будет поступать из других SaaS-инструментов, внутренних баз данных или платформ данных клиентов (CDP). Но есть еще один незамеченный герой в наборе инструментов аналитической инженерии: скромная электронная таблица.

Электронные таблицы — это швейцарский нож обработки данных. Они могут добавлять дополнительный контекст к иначе непонятным идентификаторам приложений, быть единственным источником истины для уникальных процессов из других подразделений бизнеса или служить слоем перевода между двумя несовместимыми инструментами.

Из-за важности электронных таблиц как связующего звена между многими бизнес-процессами существуют различные инструменты для их загрузки в ваше хранилище данных, и каждый из них имеет свои плюсы и минусы в зависимости от вашего конкретного случая использования.

Как обновить версии dbt (почти) без страха

· 9 мин. чтения
Joel Labes
Staff Developer Experience Advocate at dbt Labs
Обновление на февраль 2024 года

В этом блоге упоминаются версии dbt Core старше v1.0.

С тех пор как dbt Core достиг версии 1.0, прошло уже несколько лет. За это время мы взяли на себя обязательство по возможности не выпускать breaking changes, и обновление версий dbt Core стало значительно проще.

В 2024 году мы идем дальше, обещая:

  • Стабилизация интерфейсов для всех — разработчиков и сопровождающих адаптеров, потребителей метаданных и, конечно, всех, кто пишет код dbt, — как описано в нашем обновлении дорожной карты за ноябрь 2023 года.
  • Внедрение каналов выпуска (ранее известных как Versionless) в dbt Cloud. Больше никаких ручных обновлений и необходимости создавать второй проект-песочницу только для того, чтобы опробовать новые возможности в среде разработки. Подробнее см. в разделе Обновление версии Core в Cloud.

Мы оставляем остальную часть этого поста как есть, чтобы мы все могли вспомнить, как это было раньше. Наслаждайтесь прогулкой по переулку памяти.

По мере приближения к выпуску dbt v1.0 в декабре, это идеальное время, чтобы привести вашу установку в порядок. dbt 1.0 представляет собой кульминацию более чем пяти лет разработки и совершенствования опыта аналитической инженерии — сглаживание острых углов, ускорение рабочих процессов и создание совершенно новых классов работы.

Даже с учетом всех новых возможностей, обновление может быть пугающим — вы полагаетесь на dbt для обеспечения вашего аналитического рабочего процесса и не можете позволить себе изменения, которые могут привести к тому, что ваш ежедневный запуск перестанет работать. Я был в такой ситуации. Это список, который я хотел бы иметь, когда владел проектом dbt в своей последней компании.