Постиг ли навыки dbt «горький урок»?
 Смерть с косой с надписью «Горький урок» уже побывала у дверей «Обработка естественного языка» и «Промпт-инжиниринг», а теперь стучится в дверь «Навыки»
Помните, каково было писать код с ИИ в это же время год назад? Модели умели писать SQL, но плохо принимали решения. Они упускали многие профессиональные нюансы, которые учитывают опытные инженеры-аналитики. Навыки казались очевидным решением: дать агенту знания, необходимые для конкретной задачи, чтобы не начинать каждый раз с нуля и не набивать один AGENTS.md всем, что только может пригодиться. Навыки появились в Claude в октябре 2025 года, а в декабре того же года стали открытым стандартом. Мы создали собственный набор навыков dbt для агентов, чтобы дать агентам для написания кода недостающие соглашения, команды и шаблоны.
С тех пор модели заметно улучшились, и всегда стоит помнить о «горьком уроке» ИИ: изощрённые решения в долгосрочной перспективе проигрывают простому наращиванию вычислительных ресурсов для решения задачи. Поэтому я захотел проверить, оправдана ли ещё эта ставка. Могут ли новейшие модели создавать и поддерживать dbt-проект реального масштаба без навыков? И если да, то где навыки по-прежнему полезны?
Я потратил пару дней по несколько часов на создание прототипа системы оценки, чтобы это выяснить: 22 запуска агентов, до 12 задач в каждом, dbt-проект о «Формуле-1» в Snowflake. Выяснилось, что хорошие запуски от плохих отличал процесс работы, а не знание dbt. Я бы не назвал этот вывод окончательным, но в условиях столь быстрых изменений он уже повлиял на моё отношение к навыкам.
 Пройденные проверки во втором раунде по моделям и вариантам эксперимента. На результат повлияло поколение модели, а не навыки
- Разброс между запусками больше любого эффекта от навыков. Один и тот же вариант — Sonnet 5.5 с доступными навыками — набрал 61%, 100% и 67% в трёх запусках.
- Модели 5.5 уже знают dbt. В 12 из 19 запусков Claude 5.5 были пройдены все проверки, а без навыков каждая модель 5.5 прошла не менее 92%.
- Агенты редко открывали навыки по собственной инициативе, а когда открывали, то чаще всего для незнакомых областей, таких как Semantic Layer или dbt Mesh.
- Новое поколение модели даёт больше, чем навык. Sonnet 4.5 набрала 38% без навыков и 17% с обязательным использованием навыков — два самых низких результата среди всех запусков, причём в обязательном варианте модель прочитала навыки ещё до написания первой модели dbt. (Тот самый «горький урок».)
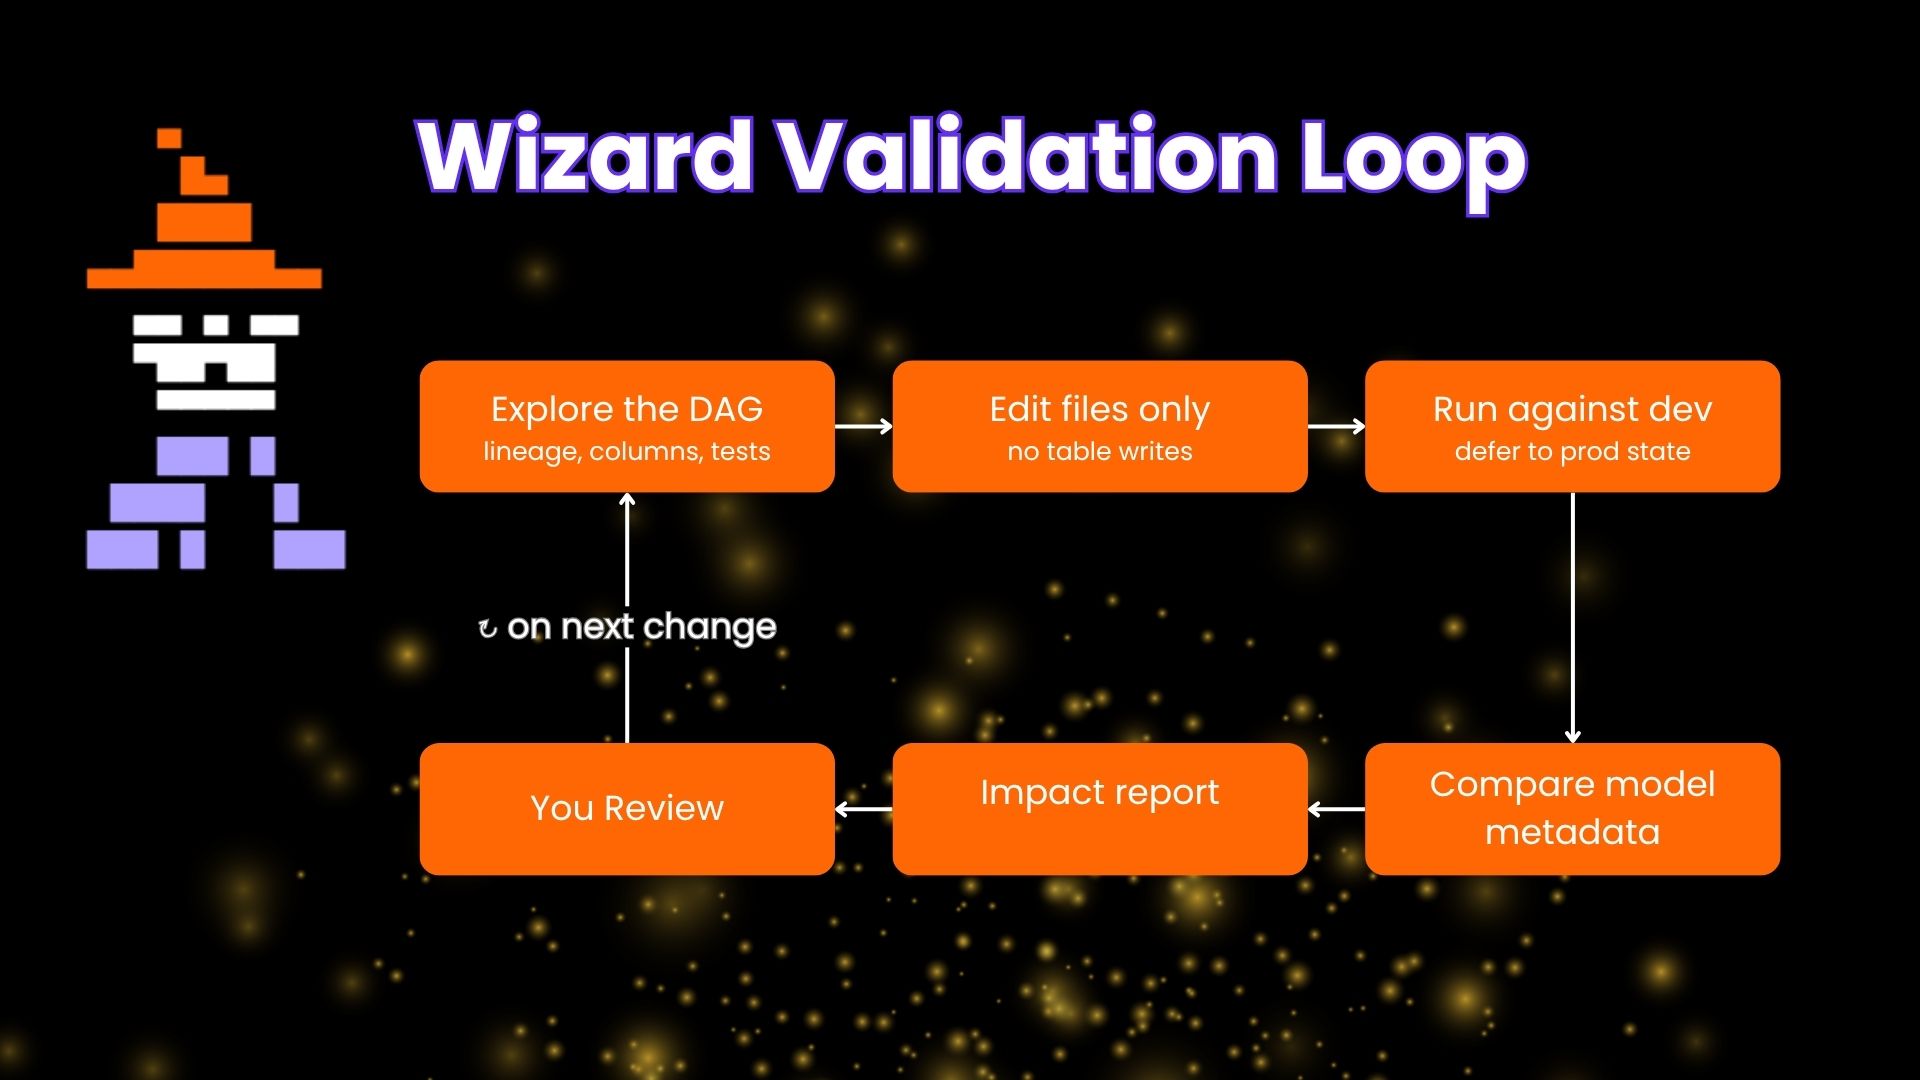
- Преобладали ошибки процесса: тест, зафиксировавший сегодняшние ответы, неудачные попытки восстановления из резервной копии, игнорирование определений, неверно выбранные окна ретроспективной обработки.
Если вы поддерживаете навыки для команды: уберите документацию, объясняющую, как работает dbt, оставьте материалы о возможностях, которые ещё не полностью интегрированы в ваш стек, и создайте новые навыки о том, как ваша команда тестирует, развёртывает и проверяет изменения. В дальнейшем команды, которые понимают свой процесс и знают, как его поддерживать и улучшать, смогут гораздо эффективнее использовать передовые модели.