Лучшие практики для материализаций
Сначала рассмотрим некоторые свойства различных уровней нашего проекта dbt и материализаций.
- 🔍 Представления (Views) возвращают самую свежую, актуальную информацию о своих входных данных при запросе, что делает их идеальными строительными блоками для более крупных моделей.
- 🧶 Когда мы создаем модель, которая объединяет множество других моделей, мы не хотим беспокоиться о том, что все эти модели имеют разную степень свежести, потому что они были построены в таблицы в разное время. Мы хотим, чтобы все эти входные данные предоставляли нам все доступные исходные данные.
- 🤏 Представления (Views) также отлично подходят для небольших наборов данных с минимально интенсивной логикой, к которым мы хотим иметь доступ почти в реальном времени.
- 🛠️ Таблицы (Tables) являются наиболее производительной материализацией, так как они просто возвращают преобразованные данные при запросе, без необходимости их повторной обработки.
- 📊 Это делает таблицы отличными для вещей, с которыми работают конечные пользователи, например, для витрины данных, обслуживающей популярную панель мониторинга.
- 💪 Таблицы также идеальны для часто используемых, вычислительно интенсивных преобразований. Создание таблицы позволяет нам «заморозить» эти преобразования.
- 📚 Инкрементальные модели полезны для тех же целей, что и таблицы, они просто позволяют нам строить их на больших наборах данных, чтобы они могли быть построены и доступны производительным образом.
Конфигурация на уровне проекта
Имея в виду эти принципы, мы можем применять эти материализации в проекте. Ранее мы рассмотрели, как настраивать материализацию для отдельной модели. Однако на практике мы будем задавать материализации на уровне папок, а при необходимости использовать конфигурацию отдельных моделей, чтобы переопределять эти настройки. Это позволит сохранить код DRY и избежать повторения одних и тех же блоков конфигурации в каждой модели.
- 📂 В
dbt_project.ymlу нас есть разделmodels:(по умолчанию внизу файла), который мы можем использовать для определения различных конфигураций для целых директорий. - ⚙️ Это те же конфигурации, которые передаются в блок
{{ config() }}для отдельных моделей, но они устанавливаются для каждой модели в этой директории и любых поддиректориях, вложенных в нее. - ➕ Мы разделяем имя папки и конфигурацию, используя
+, так чтоmarketing,paid_adsиgoogleниже — это имена папок, тогда как+materialized— это конфигурация, применяемая к этим папкам и всем вложенным в них папкам. - ⛲ Конфигурации, установленные таким образом, каскадируют, более специфичная область будет установлена.
- 👇🏻 В примере ниже все модели в папках
marketingиpaid_adsбудут представлениями, но подкаталогgoogleбудет таблицами.
models:
  jaffle_shop:
    marketing:
      +materialized: view
      paid_ads:
        google:
          +materialized: table
Представления для этапов
Начнем с простых моделей для этапов. Рассмотрим некоторые аспекты моделей для этапов, чтобы определить идеальную стратегию материализации:
- 🙅♀️ Модели для этапов редко доступны напрямую нашими конечными пользователями.
- 🧱 Они должны быть всегда актуальными и синхронизированными с нашими исходными данными как строительные блоки для последующих моделей.
- 🔍 Очевидно, что мы захотим сохранить наши модели для этапов как представления (views).
- 👍 Поскольку представления являются материализацией по умолчанию в dbt, нам не нужно выполнять какую-либо специфическую конфигурацию для этого.
- 💎 Тем не менее, для ясности, это хорошая идея — продолжить и указать конфигурацию явно. Мы хотим убедиться, что наш
dbt_project.ymlвыглядит следующим образом:
models:
  jaffle_shop:
    staging:
      +materialized: view
Промежуточные модели в крупных проектах
В примере проекта Jaffle Shop используется схема staging → marts, и папка intermediate/ отсутствует. В крупных проектах промежуточные модели часто располагаются между staging и marts, разбивая сложные преобразования на более простые части:
- 🚫 Конечные пользователи не обращаются к промежуточным моделям напрямую. Эти модели нужны для упрощения логики витрин.
- 🧩 Они служат строительными блоками, на которые ссылаются витрины или другие промежуточные модели.
- 👻 Поэтому они идеально подходят для материализации ephemeral, которая не создает объектов в вашем хранилище данных.
Модели ephemeral встраиваются в виде CTE в модели, которые на них ссылаются. Это помогает поддерживать порядок в хранилище данных и не загромождать его моделями, не предназначенными для прямых запросов:
models:
  jaffle_shop:
    staging:
      +materialized: view
    intermediate:
      +materialized: ephemeral
    marts:
      +materialized: table
Модели ephemeral могут затруднять поиск и устранение неполадок, поскольку они не существуют как объекты, к которым можно выполнять запросы. Если во время разработки вам нужно проверять промежуточные результаты, рассмотрите возможность материализовать эти модели как представления в отдельной схеме с ограниченными правами доступа. Это позволит просматривать их содержимое, сохраняя их отдельно от моделей производственной среды.
Подробнее о подходах к организации промежуточных моделей читайте в разделе Как мы организуем наши проекты dbt: промежуточные модели.
Витрины с табличной и инкрементальной материализацией
Как мы узнали, представления хранят только логику преобразования в хранилище, поэтому наши запуски занимают всего несколько секунд на модель (или меньше). Что происходит, когда мы запрашиваем данные?
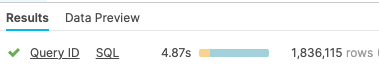 Длительное время выполнения запроса в Snowflake
Наши витрины медленно запрашиваются!
Давайте сравним те же аспекты витрин, которые мы рассматривали для моделей для этапов, чтобы оценить лучшую стратегию материализации:
- 📊 Витрины часто доступны напрямую нашими конечными пользователями и должны быть производительными.
- ⌛ Часто могут функционировать с периодически обновляемыми данными, принятие решений конечными пользователями во многих областях вполне устраивает данные с часовым или дневным обновлением.
- 🛠️ Учитывая вышеуказанные свойства, у нас есть отличный случай для построения самих данных в хранилище, а не логики. Другими словами, таблица.
- ❓ Единственное решение, которое нам нужно принять с нашими витринами, это можем ли мы обработать всю таблицу сразу или нам нужно делать это по частям, то есть будем ли мы использовать материализацию
tableилиincremental.
🔑 Золотое правило материализаций Начинайте с моделей как представлений, когда они занимают слишком много времени на запрос, делайте их таблицами, когда таблицы занимают слишком много времени на построение, делайте их инкрементальными.
